

python用filter函数过滤数据怎么写
详细讲解 Python 中 filter() 函数的过滤数据编写方法,包含基础语法、函数与 lambda 配合用法、None 快捷过滤、字典数据筛选以及迭代器特性与避坑指南。
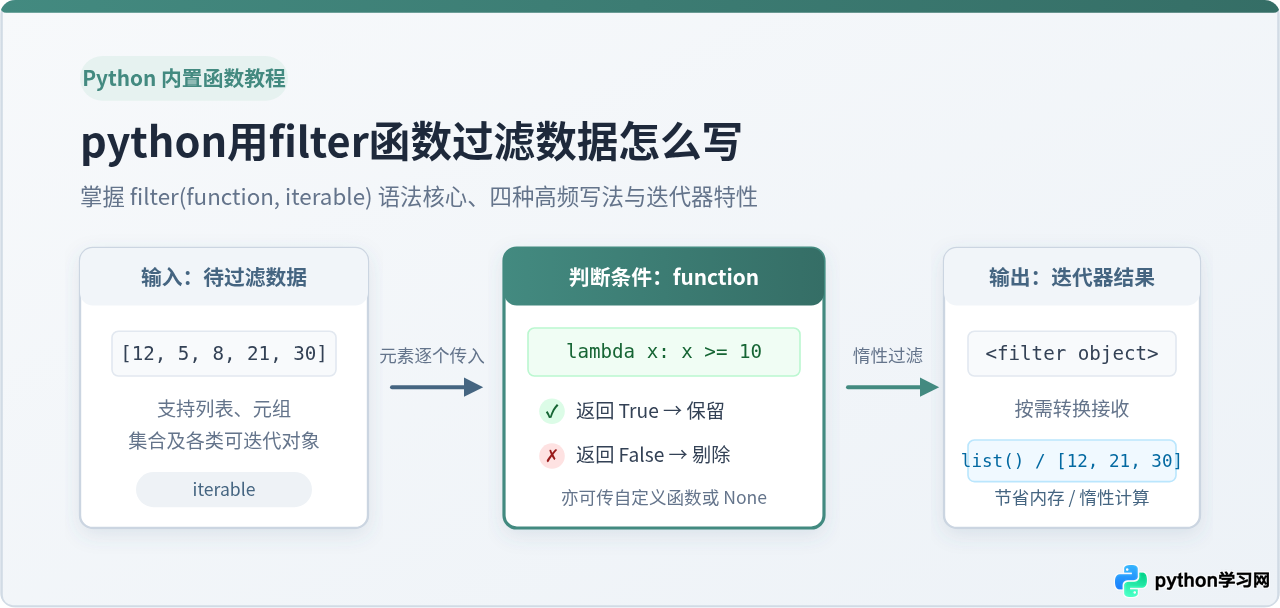
在 Python 中过滤数据时,filter() 函数的核心写法为 filter(function, iterable)。它接收一个判定条件函数和一个可迭代数据序列,自动将序列中的每个元素传入函数进行评估,仅保留返回值为真(True)的元素。由于 filter() 返回的是一个惰性迭代器(filter object),在实际使用时通常配合 list()、tuple() 转换为实体列表或直接放入 for 循环中遍历读取。
一、filter() 函数的核心语法与运作机制
filter() 是 Python 的内置高阶函数,不需要安装第三方库或额外执行 import 即可直接调用。其完整函数签名如下:
filter(function, iterable)function(断言函数):用于对每个元素进行真假判断的函数。它可以是普通函数、匿名lambda函数,或者直接传入None。iterable(待过滤数据):包含待处理元素的可迭代序列,例如list、tuple、set、字典视图或生成器。
与许多初学者预期的不同,filter() 执行后并不会立刻在内存中生成新的完整列表,而是返回一个迭代器对象。这种设计被称为“惰性求值”(Lazy Evaluation),只有当后续代码显式读取下一个元素时,内部才会对对应元素执行判断。对于海量数据处理,这种方式能显著降低内存占用。
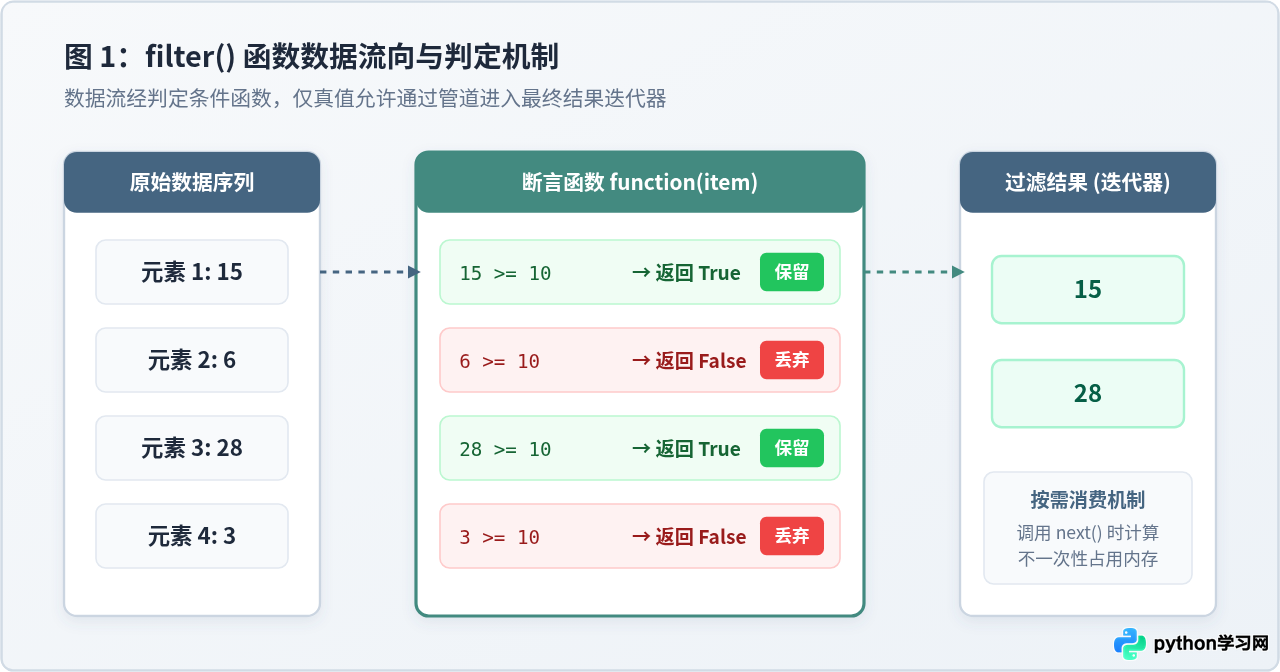
二、使用 filter() 过滤数据的三个标准步骤
编写 filter() 过滤逻辑可以拆分为清晰的三步:确定条件逻辑、调用 filter() 进行绑定,以及对返回结果进行消费接收。
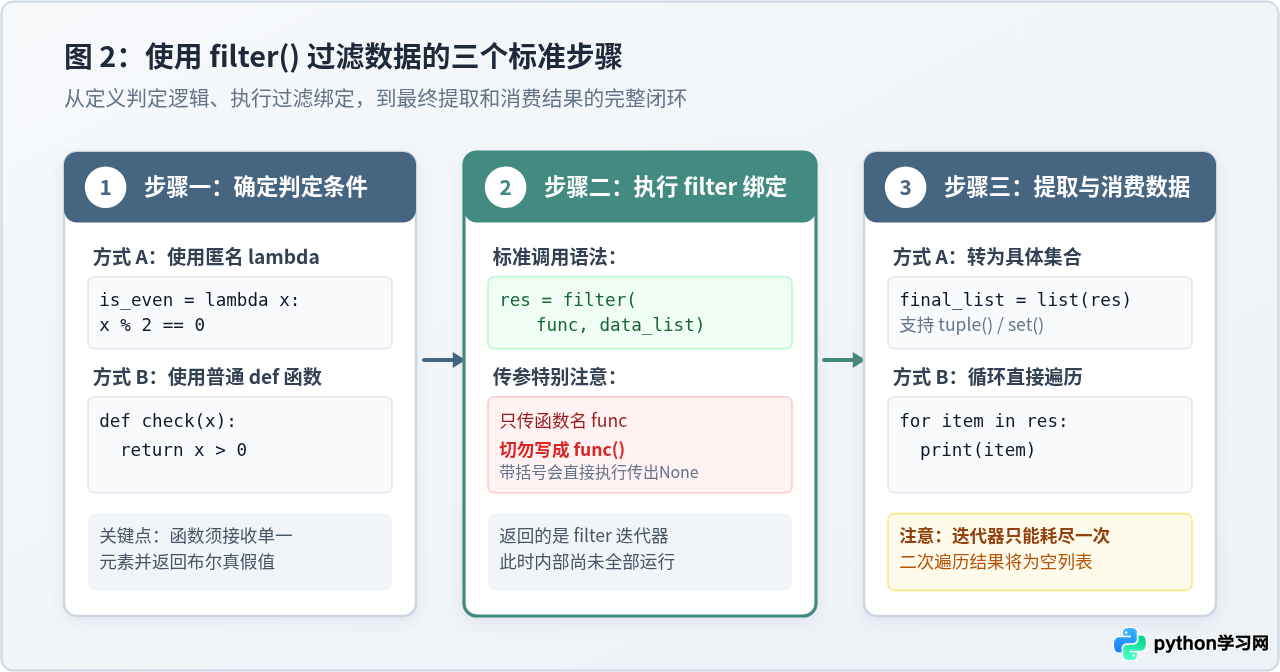
步骤一:定义断言条件
判定函数必须且仅能接收一个参数(即当前正在遍历的元素),并返回一个能够在逻辑判断中代表布尔值的对象(True 或 False)。如果逻辑简单,可以用 lambda 表达式;如果逻辑复杂,建议使用标准 def 函数。
步骤二:调用 filter() 进行绑定
将步骤一中的函数作为第一个参数传给 filter,将原始数据作为第二个参数。这里最容易出现的书写失误是给函数名加上了小括号。请切记传参时仅写函数名,不能写成带有调用括号的形式。
步骤三:转换并消费过滤结果
由于返回值是迭代器,如果直接执行 print(result),屏幕上只会显示类似 <filter object at 0x...> 的内存地址。若需直接查看全部内容或使用索引下标,需要使用 list() 进行转换。
# 完整的三步执行演示
# 1. 准备原始数据与判定条件
numbers = [12, 5, 8, 23, 40, 7, 19]

def is_greater_than_ten(n):
    return n > 10

# 2. 调用 filter 绑定
filtered_iterator = filter(is_greater_than_ten, numbers)

# 3. 消费结果
result = list(filtered_iterator)
print("过滤后结果:", result)三、常见的四种代码编写模式
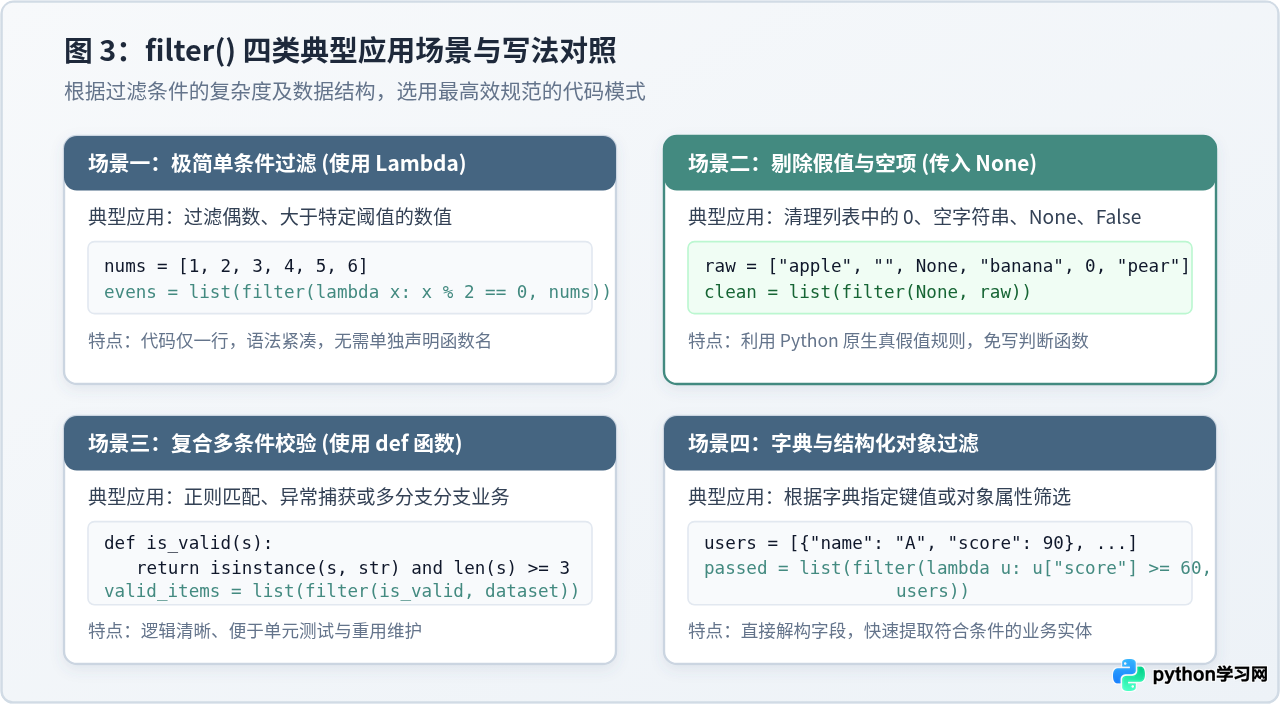
在实际业务开发中,根据数据结构与条件复杂度的差异,通常会使用以下四种编写模式。
1. 结合 lambda 表达式实现单行极简过滤
当过滤规则非常单一(例如判断奇偶、大小比较、字串前缀)时,无需单独使用 def 定义函数,使用匿名函数 lambda 是一行代码完成过滤最常见的方式:
# 过滤出列表中的所有偶数
numbers = [1, 2, 3, 4, 5, 6, 7, 8, 9, 10]
evens = list(filter(lambda x: x % 2 == 0, numbers))
print("偶数列表:", evens)2. 传入 None 快速剔除“假值”与空数据
当 filter() 的第一个参数传为 None 时,它会直接检验序列中元素本身的真值性。Python 中所有的假值(如空字符串 ""、数字 0、False、None 以及空容器)都会被直接过滤掉:
# 清理包含脏数据、空值的用户输入列表
raw_inputs = ["admin", "", None, "guest", 0, "developer", False, "root"]
clean_inputs = list(filter(None, raw_inputs))
print("清理后的有效项:", clean_inputs)3. 结合独立 def 函数处理复合业务规则
如果过滤条件涉及多分支判断、类型检查、正则表达式或异常捕获,应当编写独立的标准函数,这样既便于阅读,又容易编写单元测试:
# 校验手机号字符串:必须是字符串、纯数字且长度为11位
phone_candidates = ["13800138000", "12345", "13912345678", None, "13800abc000", 13700000000]

def is_valid_mobile(item):
    if not isinstance(item, str):
        return False
    return len(item) == 11 and item.isdigit()

valid_phones = list(filter(is_valid_mobile, phone_candidates))
print("合规手机号:", valid_phones)4. 过滤列表中的字典或结构化对象
后端开发和数据分析中经常遇到元素为字典的列表。可以通过在 lambda 中访问字典键来筛选符合条件的记录:
students = [
    {"name": "小明", "score": 85, "active": True},
    {"name": "小红", "score": 58, "active": True},
    {"name": "小刚", "score": 92, "active": False},
    {"name": "小华", "score": 76, "active": True}
]

# 筛选出在读且成绩大于等于 80 分的学生
qualified = list(filter(lambda s: s["active"] and s["score"] >= 80, students))
print("达标学生名单:", [s["name"] for s in qualified])四、filter() 与列表推导式的对比与选型
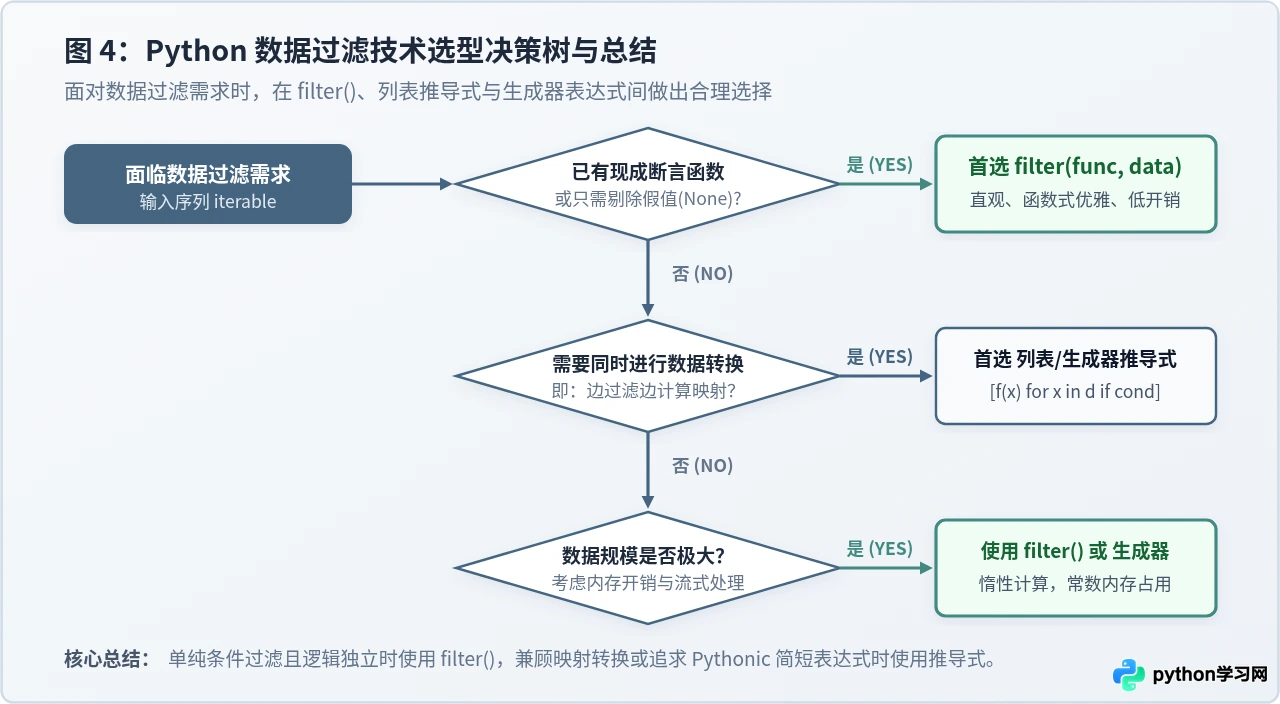
在 Python 中,不仅可以使用 filter() 过滤数据,列表推导式(List Comprehension)同样是广为接受的做法。两者在功能上存在重叠,但在适用场景和编码习惯上各有优势:
| 对比维度 | filter(func, iterable) | 列表推导式 [x for x in data if cond] |
|---|---|---|
| 返回值类型 | 返回 filter 迭代器(按需计算) |
返回全新 list 实体(一次性求值) |
| 内存开销 | 极低(在未转为 list 前常数级内存) | 较高(完整容纳所有符合条件的结果) |
| 现成函数复用 | 极佳,直接传 filter(str.isalnum, list) |
稍显繁琐,需写 [x for x in list if str.isalnum(x)] |
| 同时映射转换 | 较弱,需额外嵌套 map() |
极佳,一行实现 [x * 2 for x in data if x > 0] |
五、编写时的关键细节与常见陷阱
filter() 返回的是迭代器对象,它内部维护着遍历指针。一旦遍历过一次(例如执行了 list(result) 或 for item in result),迭代器内部的数据流就已经结束。若对同一个变量再次执行 list(result),将直接获得一个空列表 []。如果需要多次使用过滤后的数据,务必在首次处理时将其转存为变量或再次调用 filter。
写成
filter(func(), data) 会在传参阶段就提前执行 func(),由于此时没有传入元素参数,代码会直接抛出 TypeError: missing required argument;即使该函数允许无参调用,传给 filter 的也会是函数执行的返回值(通常是 None),从而引发判定逻辑异常。正确写法只能是函数对象名称 filter(func, data)。
None)时,优先使用 filter();而在需要“边过滤边对元素进行算术变形、提取属性”时,优先使用推导式。熟练配合这两者,便能写出既清晰高效又符合规范的 Python 数据过滤代码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









