

Python切片步长为0为什么会抛出异常
深入解析Python序列切片步长为0时抛出ValueError异常的根本原因,从数学推导、CPython底层实现、切片索引机制及防御性编程多个维度进行详尽阐释。
a[::0]),解释器会立即抛出 ValueError: slice step cannot be zero。这一行为的核心原因在于切片的本质是离散数列的有向采样,步长代表单次推进的跨度;步长为 0 意味着索引指针无法移动,既无法确定采样终点,也无法定义结果序列长度,导致循环语义崩溃。Python 解释器在 C 源码层对此进行了前置强校验,杜绝了无限停滞的潜在风险。
一、现象复现与核心报错
在日常开发中,列表、元组或字符串均支持通过 [start:stop:step] 进行切片截取。当显式或通过动态计算将 step 设为 0 时,代码无法正常返回,而是抛出明确的数值异常:
# 示例代码:切片步长为0引发异常
numbers = [10, 20, 30, 40, 50]

# 尝试使用步长 0 截取列表
result = numbers[::0]

# 运行终端抛出:
# Traceback (most recent call last):
#   File "slice_test.py", line 4, in <module>
#     result = numbers[::0]
# ValueError: slice step cannot be zero
该异常不仅发生在普通列表索引中,直接构造内置切片对象 slice(0, 10, 0) 并传递给任何序列类型时,同样会触发相同的拦截机制。
二、数学模型:为什么步长为0在逻辑上不自洽
切片在本质上是构建一个由初项、公差及边界控制的等差数列。设切片序列索引为一系列整数:
索引序号 $k$ 处的元素下标定义为:
index(k) = start + k * step其中 $k \in \{0, 1, 2, \dots, N-1\}$,且 $N$ 为最终切片包含的元素个数。
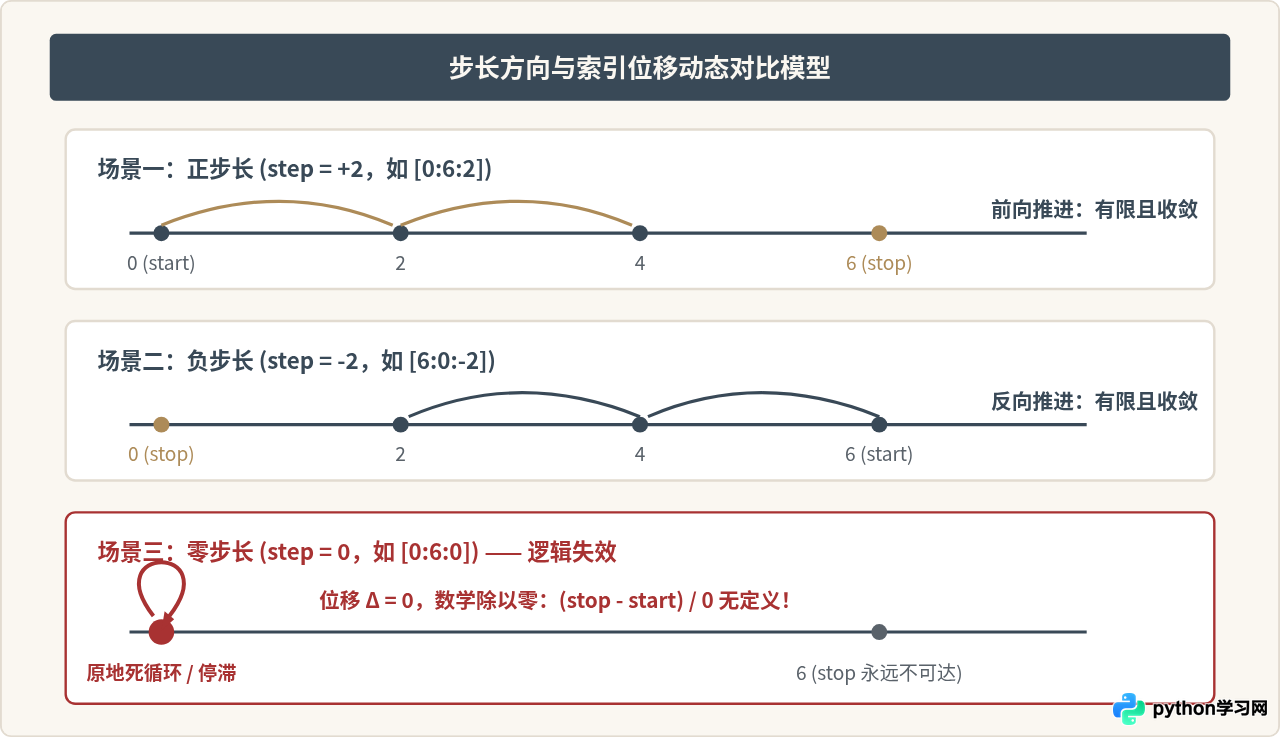
在通常情况下,$step$ 不仅决定了每次递增的步幅大小,还决定了采样的方向性:
- 当 step > 0 时:属于正向递增。停止条件为
index >= stop,只要start < stop,有限次递增后必然满足退出条件,生成确定长度的序列。 - 当 step < 0 时:属于逆向递减。停止条件为
index <= stop,只要start > stop,有限次递减后必然终止。 - 当 step == 0 时:对于任意的整数 $k$,都有
index(k) = start + k * 0 = start。
这意味着无论 $k$ 如何变化,索引值永远停留在 start 处不动。如果此时 start != stop,当前指针永远无法越过或到达 stop,采样步数趋近于无穷大;如果将结果设为无限循环序列,又违背了切片产生固定长度序列的基本规范。
三、CPython 底层实现机制深度剖析
为了从根源上理解这一保护机制,我们可以查看 CPython 解释器的核心实现源码。在 Python 中,所有切片参数的解析最终都会流入 C 语言编写的 sliceobject.c。
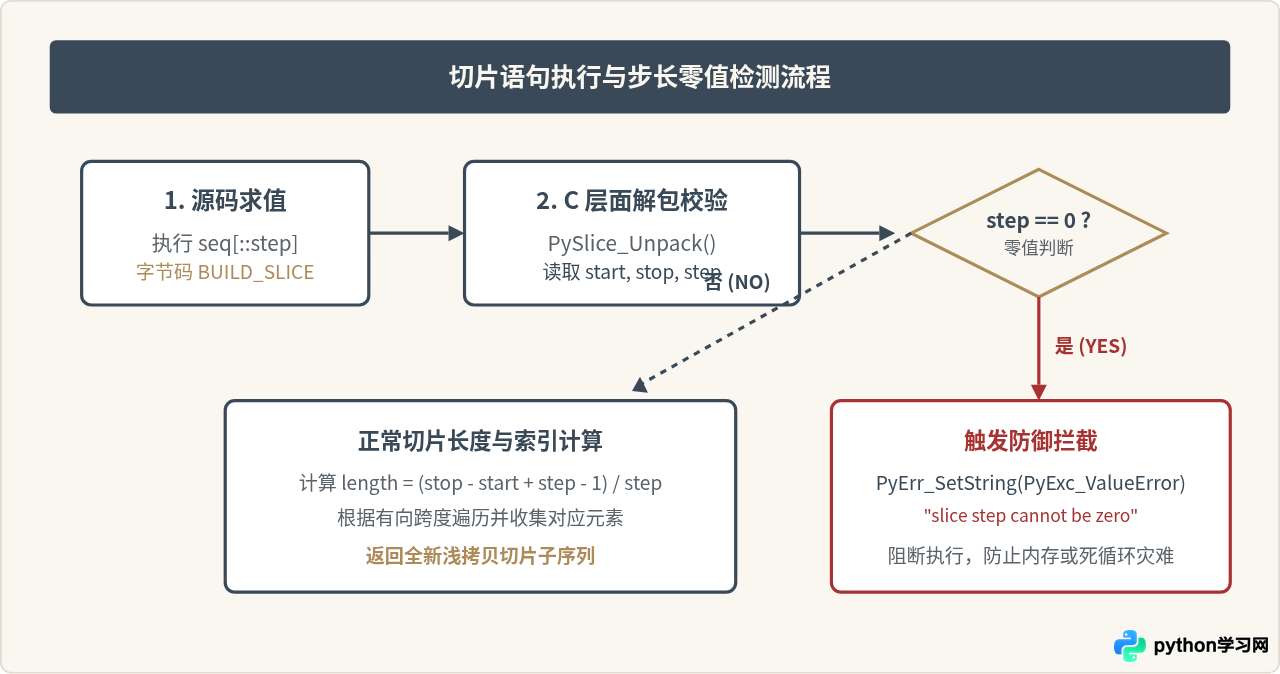
在早期及现代 CPython 源码中,核心函数 PySlice_Unpack() 负责解包切片对象的属性;紧接着调用的 PySlice_GetIndicesEx() 计算实际采样范围。在这两处,均显式对 step == 0 做了强制阻断:
/* 摘自 CPython Objects/sliceobject.c 核心片段 */
int
PySlice_Unpack(PyObject *r, Py_ssize_t *start, Py_ssize_t *stop, Py_ssize_t *step)
{
    /* ...省略部分属性类型判断... */
    if (*step == 0) {
        PyErr_SetString(PyExc_ValueError, "slice step cannot be zero");
        return -1;
    }
    return 0;
}
紧接着在计算切片长度的核心数学公式中:
/* 切片长度公式(当 step > 0 时) */
length = (stop - 1 - start) / step + 1;
在 C 语言中,如果允许 step == 0 传入后续算式,整型除以 0 将导致硬件级别的 SIGFPE(浮点异常/除零异常),甚至直接导致整个 Python 进程崩溃退出。因此,在参数解包的第一时间主动检查并抛出 Python 级别的 ValueError,是保护运行时环境稳定的必然选择。
四、为什么不是返回空序列或单个元素?
初学者可能会产生疑问:当步长超出范围时(例如 [1, 2, 3][10:20]),Python 会宽松地返回空列表 [],为什么步长为 0 不能宽容处理为返回空列表,或者只返回起始位置的单个元素?
这涉及到 Python 语言设计的核心原则——“面对歧义,拒绝猜测”:
| 可能的设计设想 | 潜在的歧义与严重副作用 | 设计结论 |
|---|---|---|
返回空列表 [] |
步长为0与“提取0个元素”没有任何概念联系。返回空列表会隐藏动态参数计算中的潜在逻辑错误,使得 Bug 难以被发觉。 | 否决 |
返回单个元素 [start] |
如果 a[0:10:0] 返回 [a[0]],那么 stop=10 便完全失效,切片退化为单索引,破坏了范围语义。 |
否决 |
| 生成无限重复序列 | 切片契约要求返回确定长度的有界子序列。若产生无穷数据,常规列表求值会导致内存瞬间耗尽(OOM)。 | 否决 |
| 抛出 ValueError | 参数完全超出合法数学定义域,立即暴露问题,责任明确且具备确定性。 | 官方标准 |
五、动态步长场景下的防御性编程步骤
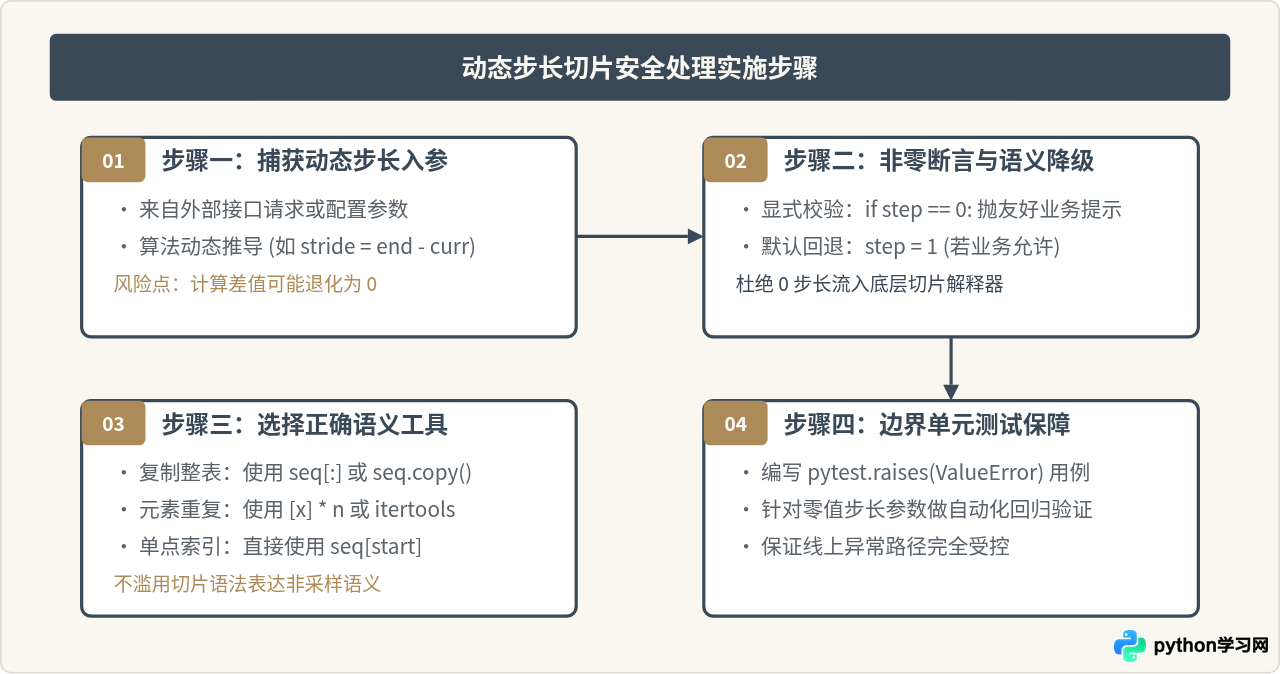
在实际项目中,开发者极少会显式书写 a[::0]。异常通常发生在步长由外部变量计算、用户输入或算法动态衍生的场景下。遵循以下标准化操作步骤,可以彻底规避该异常:
代码示范:构建安全的切片封装函数
# 示例代码:安全的动态步长切片封装
from typing import Sequence, TypeVar, Optional

T = TypeVar("T")

def safe_slice(
    data: Sequence[T],
    start: Optional[int] = None,
    stop: Optional[int] = None,
    step: Optional[int] = None
) -> Sequence[T]:
    """
    对序列进行安全切片,当 step 为 0 时自动进行业务拦截或兜底
    """
    if step == 0:
        raise ValueError("切片计算步长不能为0,请检查上游参数或使用 itertools.repeat 实现元素复制。")

    # 正常调用系统切片
    return data[start:stop:step]

# 正确示例:当确实需要重复采样某个元素时
import itertools

def sample_repeated(data: Sequence[T], index: int, count: int) -> list[T]:
    """若原本企图通过步长为0复制某一个元素,应改用明确的迭代器工具"""
    return list(itertools.repeat(data[index], count))
六、总结与切片设计决策体系
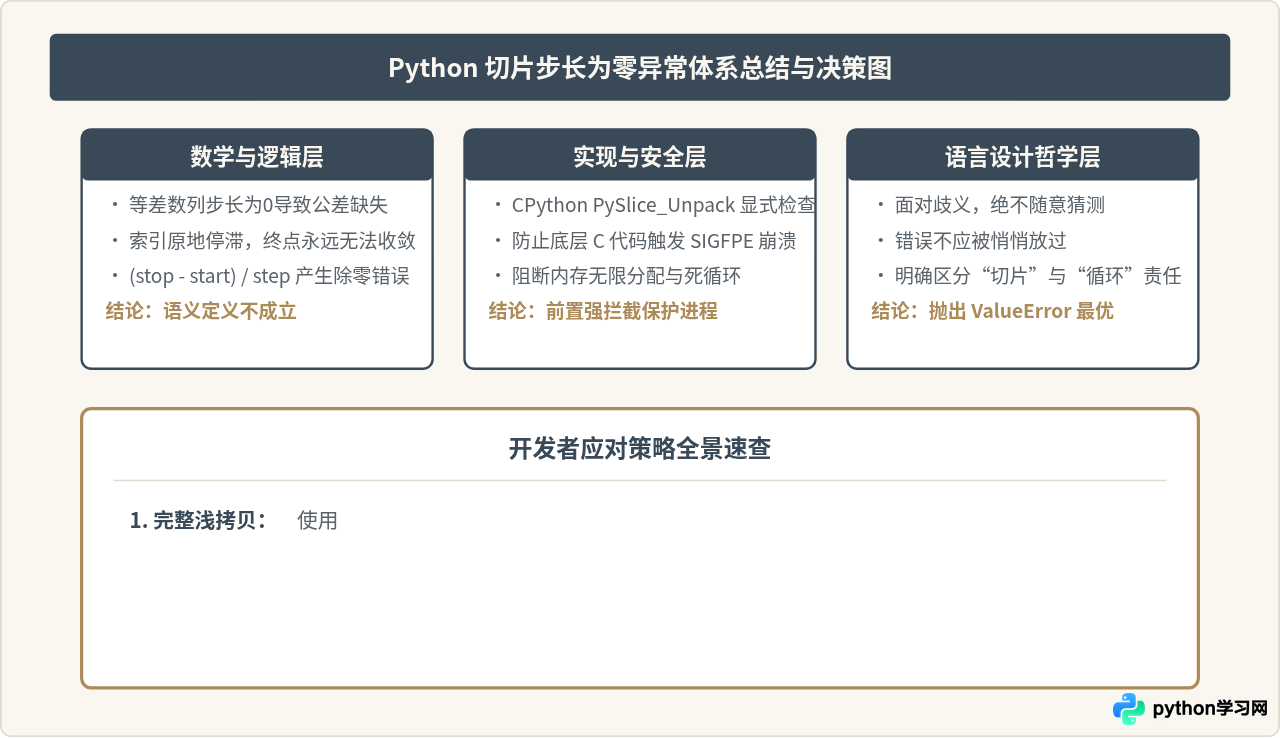
Python 抛出 ValueError: slice step cannot be zero 是数学严格性与系统级软件健壮性的双重体现。它不仅保证了底层 C 代码避免因除以零产生崩溃,也杜绝了高层代码因为陷入无效迭代循环而耗尽算力与内存。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









