

Python能做什么?零基础入门前的Web开发与数据分析场景科普
面向零基础学习者的Python应用场景科普,详细拆解Web后端开发与数据分析两大主流方向的核心工作流、必备工具栈、真实代码示例及选型建议。
初学 Python 时,很多读者容易迷失在抽象的语法细节中。在实际工程与商业落地中,Python 最成熟、岗位需求最集中、最适合新手建立正向反馈的两个应用方向,正是 Web 后端开发 与 数据分析。本文将通过具体的工作场景、代码实例与执行流程,帮助你在写下第一行代码前建立清晰的认知框架。
一、Python 在 Web 开发中具体做什么?
很多零基础读者会产生误解,以为学了 Python 就能直接把网页上的按钮、动效和页面样式画出来。实际上,Web 开发分为前端与后端。前端由浏览器解析运行(核心技术是 HTML、CSS 与 JavaScript),而 Python 在 Web 领域的核心职责是充当服务端的“中枢大脑”——即后端开发。
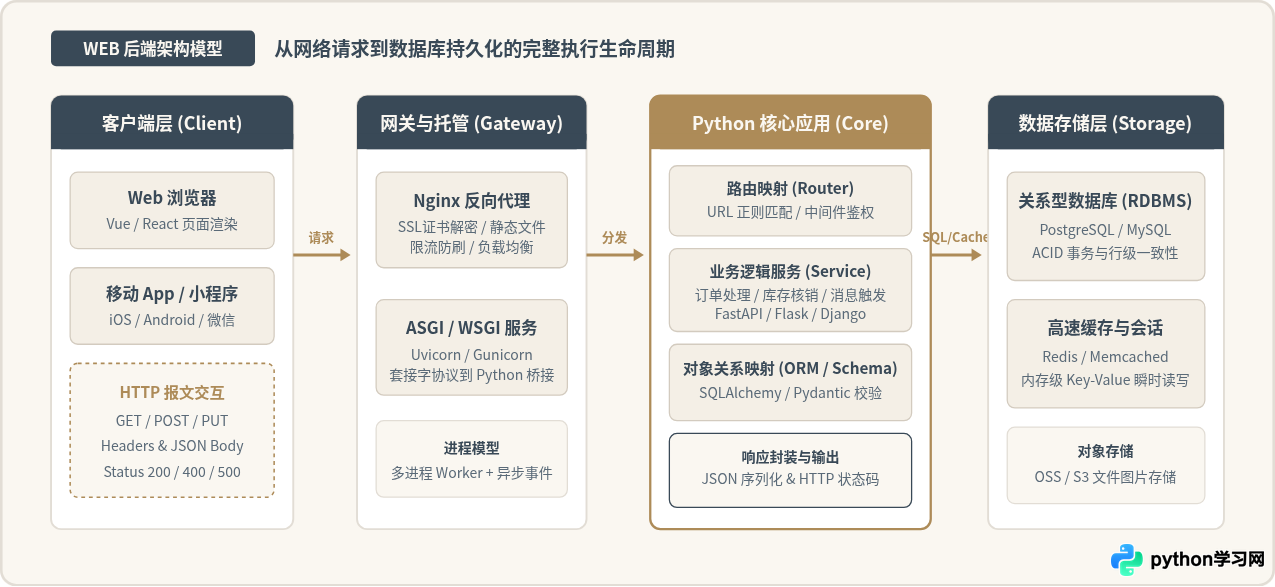
当用户在手机应用或网页上点击“立即购买”、“查询订单”或“提交表单”时,前端会将这笔操作打包成一个网络请求(HTTP Request)发送给服务器。此时 Python 代码所做的工作主要包含:
- 路由分发与入参校验:识别请求路径是查询个人信息还是提交订单,并严格核对前端提交的数据是否完整、格式是否正确。
- 业务规则处理:计算商品折扣、检查当前库存、判定用户是否有权限操作。
- 数据库读写交互:通过 ORM(对象关系映射)或原生 SQL,与 PostgreSQL、MySQL 等数据库交互,完成数据的持久化存储与提取。
- 组装响应结果:将处理后的结果封装为标准 JSON 格式,返回给浏览器或移动端展示。
1. 常见的 Web 开发主流框架
初学者不需要从零手写底层网络协议,而是借助成熟的 Python 框架:
- Django:具备“开箱即用”(Batteries-Included)特性的全栈框架。它自带了一整套完备的数据库 ORM、用户权限系统、自动化管理后台(Admin)与安全防范机制。适合需要快速构建企业管理系统、内部工单平台或内容发布网站的场景。
- FastAPI:近年来增长迅速的现代微服务框架。基于 Python 原生的类型提示(Type Hints)与异步编程(Asyncio),它具有极其优秀的并发性能,并且能自动生成可以直接在网页中测试的交互式 API 文档(Swagger UI)。是目前搭建 RESTful API 和人工智能模型调用接口的首选。
- Flask:微型框架(Micro-framework),核心极其小巧灵活,只提供路由和基本请求上下文,其余数据库和鉴权组件完全由开发者自由搭配。适合写小巧的工具型服务或理解底层机制。
2. 真实开发场景:一段极简的 API 接口代码
下面是一个使用 FastAPI 编写的“创建订单”真实接口示例。你可以直观看到 Python 后端是如何接收数据、进行逻辑判断并返回结果的:
from fastapi import FastAPI, HTTPException
from pydantic import BaseModel

app = FastAPI(title="简易订单服务")

# 1. 定义前端必须提交的数据结构与类型校验
class OrderCreateRequest(BaseModel):
    item_id: int
    quantity: int
    price: float

# 模拟数据库库存
MOCK_STOCK = {101: 50, 102: 0}

# 2. 声明 POST 路由接口
@app.post("/api/v1/orders")
def create_order(order: OrderCreateRequest):
    # 步骤 A:业务规则检查
    stock = MOCK_STOCK.get(order.item_id, 0)
    if stock < order.quantity:
        # 当库存不足时,返回标准的 400 错误
        raise HTTPException(status_code=400, detail="商品库存不足或已售罄")

    # 步骤 B:计算金额并扣减库存
    total_amount = order.quantity * order.price
    MOCK_STOCK[order.item_id] -= order.quantity

    # 步骤 C:返回 JSON 响应给前端
    return {
        "status": "success",
        "order_id": 98231,
        "item_id": order.item_id,
        "total_amount": round(total_amount, 2),
        "message": "订单创建成功"
    }
二、Python 在数据分析中具体做什么?
如果说 Web 开发解决的是“如何让系统稳定对外提供服务”,那么 数据分析解决的则是“如何从已有业务数据中提炼规律,辅助经营决策”。
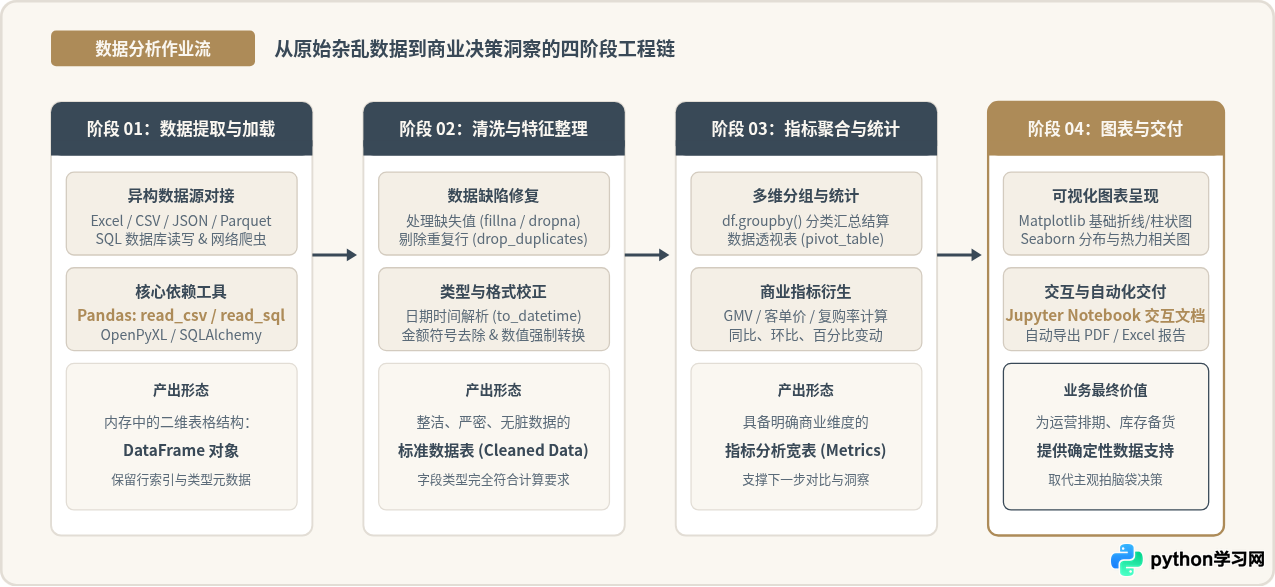
在企业中,日常运营积累了海量的订单流水、用户点击日志、库存变动明细。这些数据通常分布在 CSV 文件、Excel 表格或关系型数据库中,往往充斥着缺失值、错误格式和冗余信息。Python 在数据分析中扮演的核心角色,就是一套标准化、可复现的自动化数据处理生产线。
1. 核心工具链与职责划分
- Pandas:数据分析事实上的核心库。它将文件抽象为行列清晰的表格(DataFrame),提供了强大的缺失值填充、多表合并、条件过滤与透视聚合功能,彻底解放了手工点按 Excel 的重复劳作。
- NumPy:底层科学计算基础,提供超高执行效率的 C 语言级多维数组运算与矢量化计算支持。
- Matplotlib & Seaborn:数据可视化库。Matplotlib 胜在精确控制图表的每一个像素与坐标刻度;Seaborn 则在此基础上封装了更加现代优雅的统计配色方案与图表类型。
- Jupyter Notebook:数据分析专用的交互式开发环境。它允许开发者把代码拆成一个个小单元(Cell),逐段运行、当场看到图表和表格输出,并允许在代码之间插入详细的说明文字。
2. 真实数据分析场景:一段清洗与统计代码
以下示例展示了从一个原始包含缺失值与格式杂乱的销售数据列表中,清洗并计算各品类销售总额的典型过程:
import pandas as pd

# 1. 模拟从外部文件加载的原始脏数据
raw_data = {
    "order_id": [1001, 1002, 1003, 1004, 1005],
    "category": ["办公用品", "数码外设", None, "数码外设", "办公用品"],
    "sales": ["120.5元", "350.0", "80.0", "420.0元", None],
    "channel": ["线上", "线下", "线上", "线下", "线上"]
}

df = pd.DataFrame(raw_data)

# 2. 步骤 A:清洗缺失数据与格式校正
# 将品类中的缺失值标记为“未知”
df["category"] = df["category"].fillna("未知品类")

# 去除金额中的“元”字,并转换为标准的浮点数值;缺失金额填补为 0
df["sales_clean"] = (
    df["sales"]
    .str.replace("元", "", regex=False)
    .astype(float)
    .fillna(0.0)
)

# 3. 步骤 B:按品类分组汇总总销售额与订单数
summary = (
    df.groupby("category")
    .agg(
        total_sales=("sales_clean", "sum"),
        order_count=("order_id", "count")
    )
    .reset_index()
)

print(summary)
# 输出结果(明确为控制台示例输出):
#    category  total_sales  order_count
# 0  未知品类         80.0            1
# 1  办公用品        120.5            2
# 2  数码外设        770.0            2
三、两者的核心差异:我该如何理解与对比?
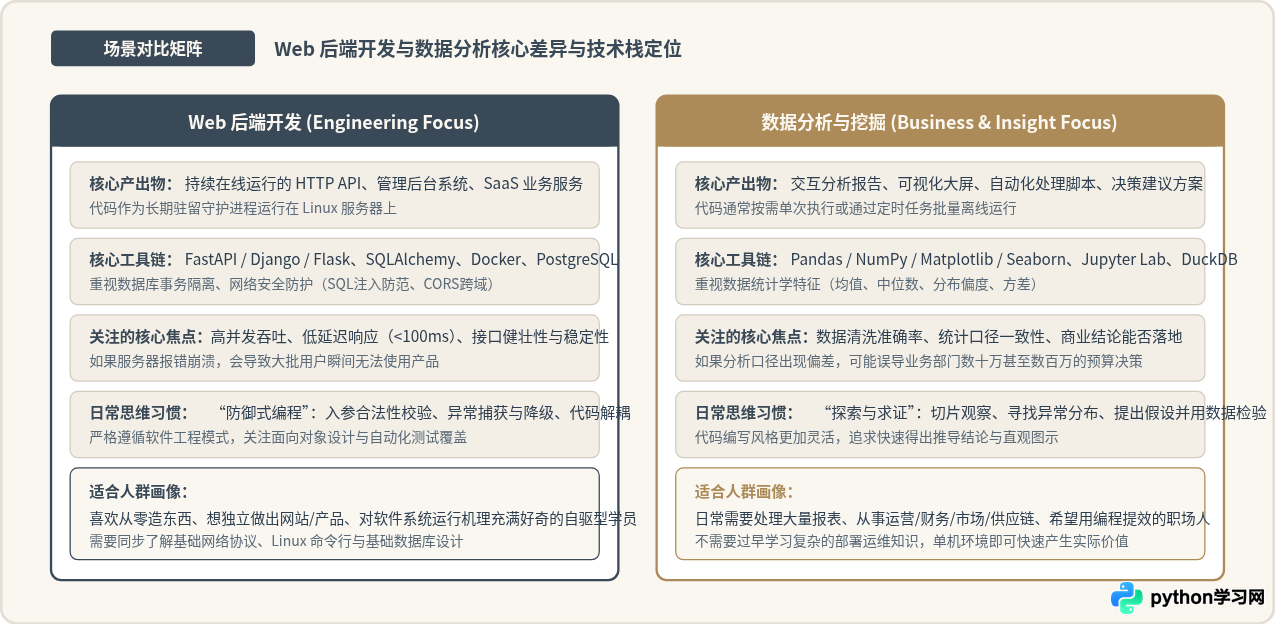
为了帮助零基础学员建立直观判断,我们可以从代码运行机制、核心交付物、日常思维模式等多个维度对比 Web 后端开发与数据分析:
四、零基础入门规划:如何选择与分步起步?
对于完全零基础的初学者,不要一开始就试图“既学建站又学机器学习”。正确的学习路径是:先打牢共同的语言基础,再根据自己的现实需求进行分支专精。
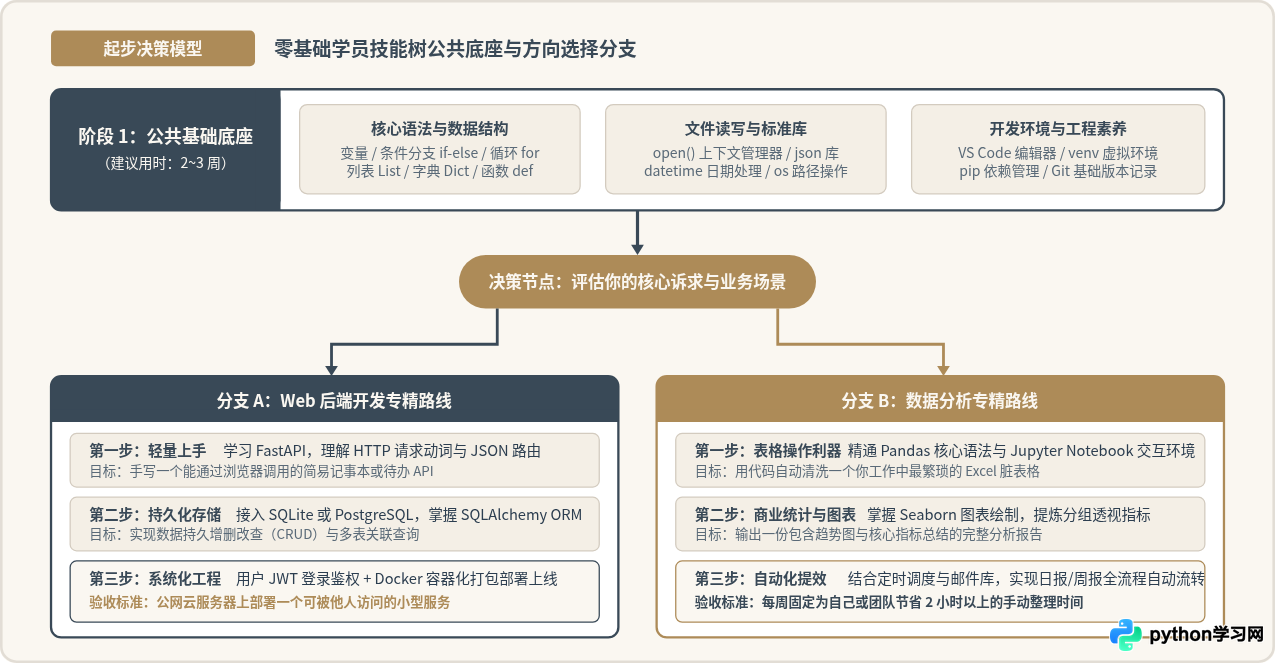
给零基础入门者的三个避坑提醒
- 不要脱离场景死背语法:变量类型、循环条件、列表推导式在纯理论阶段极其枯燥。在学完基本语法后,立即找一个微型目标——例如“写一个脚本读取桌面上的 5 个账单文件并自动汇总金额”,在解决真实问题的过程中理解语法的用途。
- 必须使用虚拟环境(venv):初学者容易在一个全局环境中安装所有第三方库。当不同项目依赖的 Pandas 或 FastAPI 版本冲突时,极易导致环境彻底损坏。养成每个项目独立建立
python -m venv .venv的习惯,能避免绝大多数运行报错。 - 明确界定技术边界:Python 虽然生态极广,但不必试图一口吃成胖子。对于普通开发者,只要在“Web 服务化”或“数据自动化”中任意精通一条主线,就足以解决绝大多数工程与业务问题。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









