

Python字符串匹配中特殊字符转义与r前缀的正确用法
深入解析Python字符串匹配中的双层转义机制,详解r前缀(原生字符串)的作用边界、正则表达式特殊字符转义规则、常见报错排查及实用决策指南。
re.error: bad escape)而困惑。本文直接聚焦核心症结:Python正则匹配中存在字符串字面量解析与正则表达式引擎解析两道转义关卡;r 前缀(原生字符串)的作用是彻底关闭第一道转义中反斜杠的特殊转义行为,但它并不替代第二道正则引擎本身的元字符转义语法。掌握这两者的分工与协作,是写出稳定匹配逻辑的关键。
一、开场场景:一个常见的 Windows 路径匹配陷阱
假设我们正在开发一个日志分析或自动化备份脚本,需要从文本中提取形如 C:\new_folder\data.txt 的 Windows 本地路径。很多初学者会自然地写出以下匹配代码:
import re

text = r"Backup path: C:\new_folder\data.txt"
# 错误示范:直觉写出的正则模式
pattern = "C:\new_folder\data.txt"

match = re.search(pattern, text)
print("匹配结果:", match)
运行这段代码,可能直接触发语法警告或匹配失败。原因在于字符串 "C:\new_folder\data.txt" 在进入 re.search 之前,已经被 Python 词法解释器先解析了一遍。其中的 \n 被转换成了 ASCII 换行符(LF),而 \d 在某些旧版本或严格语法下会提示无效转义警告。结果传给正则引擎的根本不是字面量字符 \ 和 n,而是换行符与数字元字符,自然无法匹配目标文件路径。
要彻底解决这类问题,我们必须清晰剖析 Python 处理字符串匹配时的“两层转义”运作机制。
二、核心原理解析:两层转义的完整生命周期
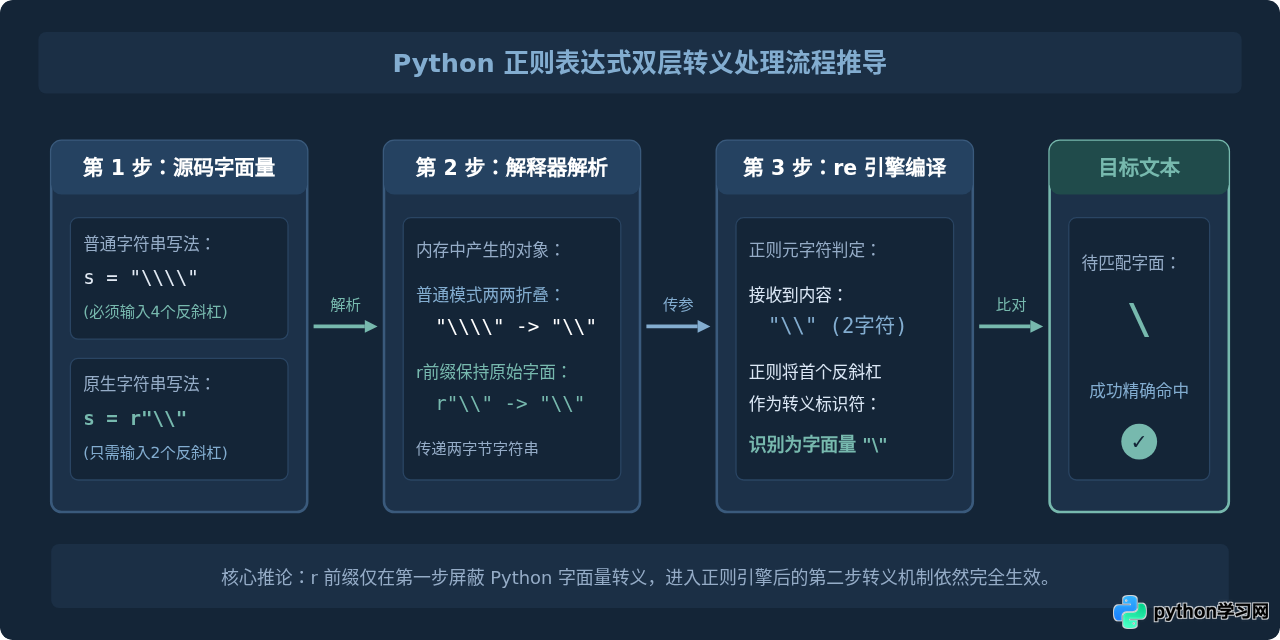
字符串在 Python 中的正则匹配并不是“一步到位”的。从你在代码编辑器中输入一行代码,到最终完成文本比对,数据严格经历了两道独立的转义处理流程:
- 第一层:Python 解释器的字面量转义阶段。当 Python 编译并加载代码时,首先解析双引号或单引号包围的字符串字面量。反斜杠
\充当字符转义引导符,用来表示特殊字符(如\n表示换行、\t表示制表符、\\表示一个普通反斜杠)。 - 第二层:re 正则引擎的元字符转义阶段。第一层解析完毕后,Python 得到一段内存中的标准字符串,并将其作为模式传递给
re.compile或re.search。正则引擎接收到这段字符流后,会按照正则表达式的语法规则展开第二轮解析,此时反斜杠再次充当转义符(如\.表示匹配字面量点号,\d表示匹配任意数字,\\表示匹配字面量反斜杠)。
如果我们要匹配文本中的一个单个反斜杠 \:在未使用 r 前缀的情况下,正则引擎需要拿到 \\ 才能识别为匹配反斜杠字符;而为了让 Python 解释器在第一阶段输出两个反斜杠,源代码中必须写出四个反斜杠 "\\\\"。这就是臭名昭著的“反斜杠灾难”。
三、r 前缀的本质与作用边界
r 是 Python 中用于表示“原生字符串”(Raw String)的前缀标识符。当你在字符串前加上 r 或 R 时,Python 词法解析器就会改变对反斜杠的处理策略:反斜杠不再与后面的字符组合成转义字符,而是作为字面量字符原样保存在字符串中。
1. 普通字符串 vs 原生字符串代码比对
# 普通字符串:\n 被解释为 ASCII 10 (换行)
s_normal = "a\nb"
print("普通字符串长度:", len(s_normal))  # 输出 3 (字符 'a', 换行符, 字符 'b')
print("repr 结果:", repr(s_normal))      # 输出 'a\nb'

# 原生字符串:\ 和 n 保持两个独立字符
s_raw = r"a\nb"
print("原生字符串长度:", len(s_raw))      # 输出 4 (字符 'a', '\', 'n', 'b')
print("repr 结果:", repr(s_raw))          # 输出 'a\\nb'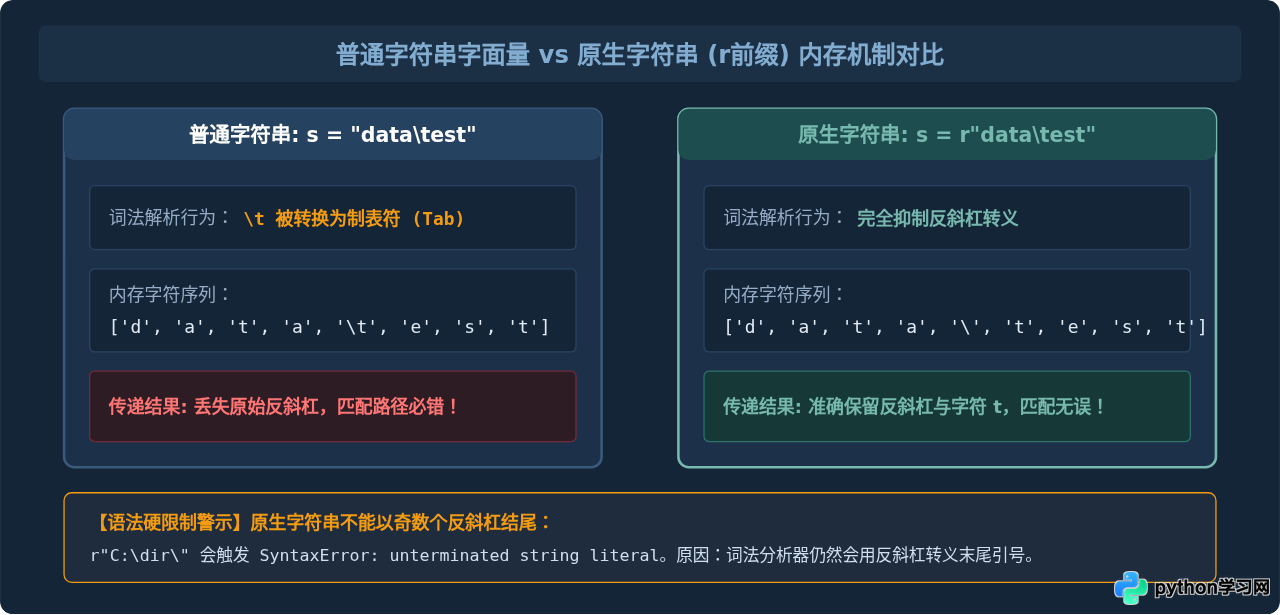
2. r 前缀并非万能:两大关键限制
虽然
r"..." 会保留反斜杠的字面值,但在 Python 词法分析中,反斜杠对紧随其后的引号仍然具有转义抑制作用。因此像 r"folder\" 这样的写法,反斜杠会转义末尾的双引号,导致字符串无法正常闭合,抛出 SyntaxError: unterminated string literal。解决方法:
# 正确方案 A:末尾拼接
path = r"C:\folder" + "\\"

# 正确方案 B:使用双反斜杠截取
path = r"C:\folder\\"[:-1]

# 正确方案 C:路径操作直接优先使用 pathlib
from pathlib import Path
path = Path(r"C:\folder")很多开发者容易产生误解,以为加了
r 就不需要转义任何字符了。例如写出 r"1+1=2" 去匹配算式 1+1=2。但实际上加号 + 是正则引擎的量词元字符(匹配1次或多次),r 仅仅保证了 Python 解释器不转义它,而正则引擎依然会把 + 当作量词解析。因此要匹配字面量加号,必须在正则层面添加反斜杠:r"1\+1=2"。
四、实战详解:字符串匹配中特殊字符的分类转义
为了在实际编写正则模式时不混淆、不遗漏,我们将 Python 字符串匹配中的字符归纳为三类处理体系:
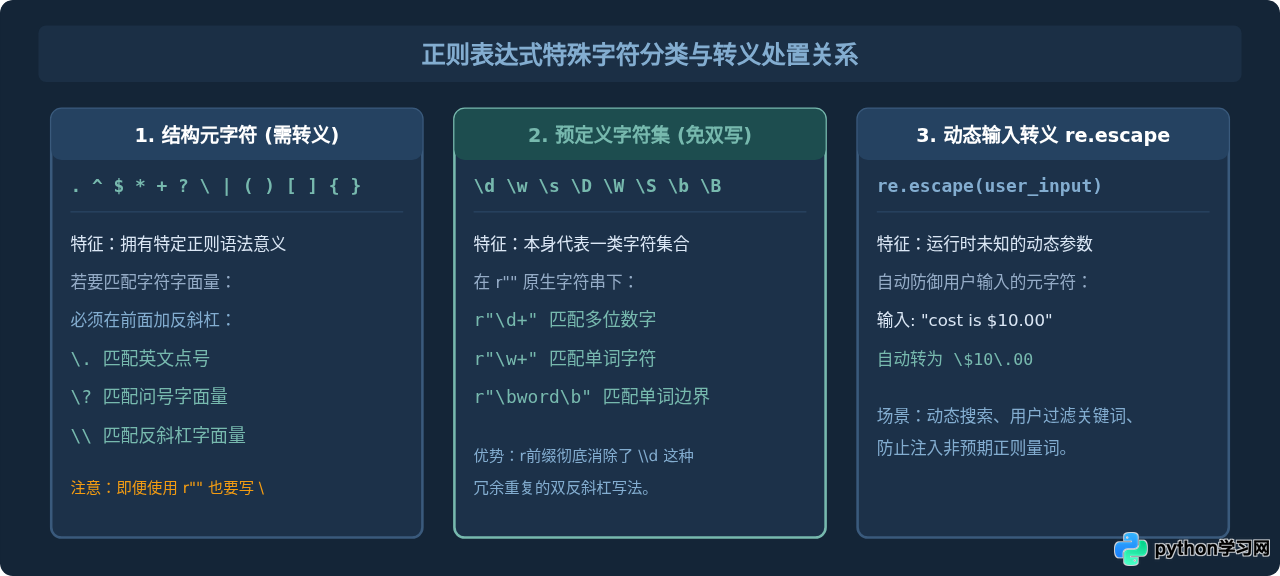
1. 正则元字符的转义处理示例
如果目标字符串包含价格符号、域名或数学算式,例如 https://example.com/item?id=100&price=$5.5,我们需要将具有特殊语法的符号进行反斜杠转义:
import re

text = "Item link: https://example.com/item?id=100&price=$5.5"

# 需要转义 . ? $ 等符号
# 搭配 r 前缀,书写最清晰自然
pattern = r"https://example\.com/item\?id=\d+&price=\$5\.5"

match = re.search(pattern, text)
if match:
    print("成功匹配完整 URL:", match.group(0))
# 输出示例: 成功匹配完整 URL: https://example.com/item?id=100&price=$5.5
2. 动态用户输入的防崩溃利器:re.escape()
当我们要匹配的内容不是硬编码的静态模式,而是由用户在前端输入、或者从配置文件中读取的动态变量时,绝不能直接将其用 f"{query}" 拼接进正则。如果用户输入了包含 *、[、( 的内容,轻则匹配错误,重则抛出 re.error: missing ), unterminated subpattern。
import re

user_query = "c++ (standard library)"  # 包含正则元字符 + 和 ()

# 错误做法:直接 f-string 拼接,正则引擎会把 (standard library) 认作捕获组,把 ++ 当作双重量词报错
# pattern = rf"keyword:\s+{user_query}"  # 极易抛出 re.error

# 正确做法:使用 re.escape() 自动转义所有保留元字符
safe_query = re.escape(user_query)
pattern = rf"keyword:\s+{safe_query}"

content = "Article keyword: c++ (standard library) - deep dive"
match = re.search(pattern, content)
print("动态安全匹配结果:", match.group(0) if match else "未找到")
# 输出示例: 动态安全匹配结果: keyword: c++ (standard library)
五、深度排错:三大隐藏的转义与r前缀雷区
雷区一:re.sub 替换字符串中的反斜杠再次转义
很多开发者只注意到了 re.search 中模式(pattern)的转义,却忽略了 re.sub(pattern, repl, string) 中的替换字符串 repl 同样会进行一次反斜杠解析!在 repl 中,\1、\g<name> 代表反向引用分组,因此如果替换内容需要输出一个反斜杠,也必须进行保护:
import re

text = "path/to/resource"

# 目标:将正斜杠替换为 Windows 风格的反斜杠 '\'
# 错误示范:repl 传 "\\" 或 r"\"
# print(re.sub(r"/", r"\", text))  # 语法报错:原生字符串末尾不能是单反斜杠

# 常见误区:以为 repl=r"\\" 就可以输出单个反斜杠
# 结果会报:re.error: bad escape \ at position 0
# 因为正则替换引擎会对 repl 解析一次转义

# 正确解决方案 1:在 repl 中写出 4 个反斜杠或用 r"\\\\"
res1 = re.sub(r"/", r"\\", text)  # 输出 path\to\resource

# 正确解决方案 2(更直观推荐):使用函数作为替换回调
res2 = re.sub(r"/", lambda m: "\\", text)
print("替换结果:", res2)  # 输出示例: path\to\resource
雷区二:str 基础方法与 re 模块的混用混淆
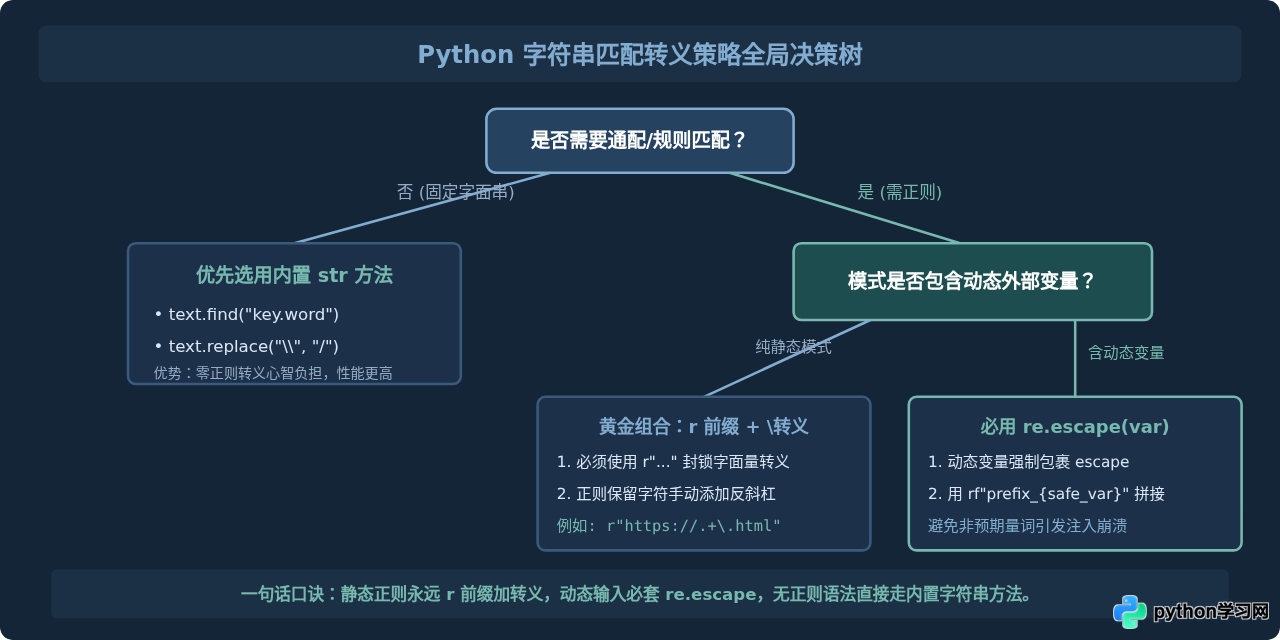
如果不需要复杂的模式规则(如不需要量词、字符类匹配),仅仅是精确查找或替换某个固定子串,请直接使用 Python 内置的 str 方法(如 str.replace、str.find、in 操作符)。
str.replace("a.b", "x") 不受正则表达式规则影响,它只寻找字面量 a.b,这里的点号 . 绝对不需要转义。若盲目给其加 \.,反而会导致无法匹配。
雷区三:字符集方括号 [] 内部的转义特异性
在方括号字符类 [...] 内部,正则表达式的大多数元字符会退化为普通字符:
- 在字符集内部,
.、*、+、?、$、(、)自动视为普通字面量,无需反斜杠转义。例如r"[.*+]"就能精准匹配点、星号或加号。 - 但有两个字符仍然特殊:
-(连字符):若不在开头或结尾,表示区间(如[a-z])。如果要匹配字符-本身,必须转义[\-]或放在首尾[-a]。^(脱字符):若在方括号首位,表示取反。要匹配^本身,需转义[\^]或不放在首位。](右方括号):需要转义[\]],否则会提前闭合字符集。
六、实践决策指南与排错速查表
为了让日常开发中的决策路径清晰直观,我们在下表中梳理了常见匹配场景的推荐标准写法:
| 场景需求 | 推荐写法示范 | 关键注意事项 |
|---|---|---|
| 静态正则表达式 | re.search(r"\d+\.\d+", text) |
永远前置 r,元字符前加反斜杠 |
匹配字面量反斜杠 \ |
re.search(r"\\", text) |
r"\\" 代表两个字符,被正则引擎解析为单个 \ |
| 动态变量精确嵌入正则 | re.search(rf"prefix_{re.escape(var)}", text) |
必须用 re.escape() 过滤未知元字符 |
| 跨平台文件路径匹配 | re.search(r"[\\/]", path) |
同时包容 Windows \ 与 POSIX / |
| 固定纯文本子串替换 | text.replace("c:\\dir", "new_dir") |
直接用原生 str.replace,勿滥用 re.sub |
七、总结
理解 Python 字符串匹配中特殊字符转义与 r 前缀的根本,在于区分语言级别与引擎级别的分层设计:
- Python 解释器在编译代码阶段,将未加
r前缀字符串中的反斜杠用于自身转义(如\n变为换行符),容易导致传给后续模块的内容发生非预期突变。 r前缀(原生字符串)的作用是向 Python 解释器声明“不要处理反斜杠”,从而完整、原汁原味地将包含反斜杠的字符序列传递给下游。- 正则表达式引擎在接收到字符串后,拥有独立的元字符转义语法。因此即便加了
r,对于.、*、+、?、$、\等正则保留字符,依然必须在正则语法层面通过反斜杠进行转义。 - 在面对未知用户输入时,善用
re.escape();在面对固定文本查找时,优先选用内置str方法,能够最大程度简化代码并消除潜在隐患。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









