

除了Pandas和Requests,还有哪些提升效率的Python小众库?
除了Pandas和Requests,介绍四个轻量且极其实用的Python小众库:Glom、Tenacity、Loguru与Pendulum,分别解决嵌套数据提取、网络请求弹性重试、极简工程日志与现代时间时区计算问题。
一、深层嵌套数据解析与提取:Glom
处理第三方 API 响应、微服务接口或爬虫解析得到的嵌套 JSON 时,常规写法往往受制于层层防御。如果直接使用连续中括号索引,一旦某一中间键缺失便会引发 KeyError;若改用标准库的 dict.get(),代码中则会充斥着嵌套调用和繁琐的兜底默认值。
Glom 提供了一种声明式的数据提取范式。它将深层数据的取值逻辑转化为类似路径访问的规范(Spec),不仅支持用点号分隔的连续访问,还能在指定节点缺失时优雅回退,甚至直接完成数据结构的塑形转换。
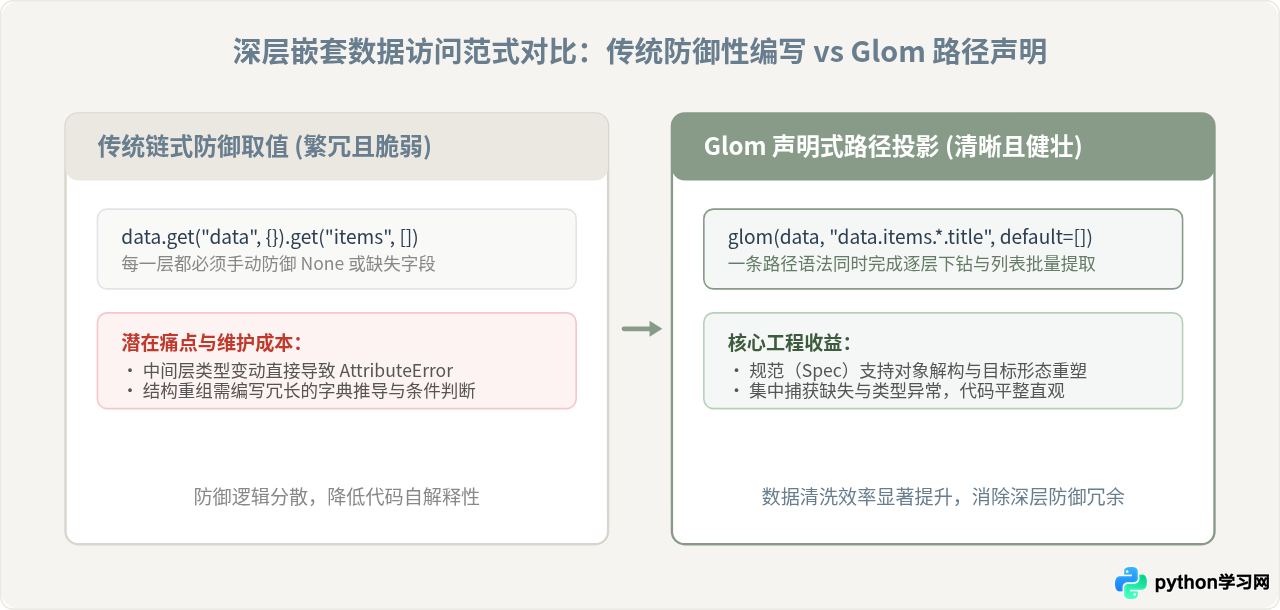
实践示例:使用 Glom 清洗复杂结构
# 安装方式:pip install glom
from glom import glom, Coalesce

# 模拟第三方服务返回的异构数据
payload = {
    "system": "trade_center",
    "result": {
        "orders": [
            {"id": "A101", "buyer": {"name": "张三", "contact": {"phone": "13800000000"}}},
            {"id": "A102", "buyer": {"name": "李四", "contact": None}},
            {"id": "A103", "buyer": {"name": "王五"}}
        ]
    }
}

# 目标:安全提取所有订单中买家的手机号,缺失时使用占位符
spec = ("result.orders", [{"order_id": "id", "phone": Coalesce("buyer.contact.phone", default="无预留") }])
cleaned_orders = glom(payload, spec)

print(cleaned_orders)
# 示例输出:
# [{'order_id': 'A101', 'phone': '13800000000'},
#  {'order_id': 'A102', 'phone': '无预留'},
#  {'order_id': 'A103', 'phone': '无预留'}]
二、API 弹性调用与网络重试:Tenacity
虽然 Requests 封装了 HTTP 请求细节,但网络抖动、DNS 解析超时或服务端限流是分布式环境中必然面对的常态。许多开发者在处理网络波动时,习惯在请求外层套用 while retry_count < 3,并配合 time.sleep()。这种方式不仅难以处理复杂的退避间隔,还容易导致异常吞没或无法精确控制退出时机。
Tenacity 是一个专注于重试策略的现代 Python 库。它通过装饰器为任意可调用对象赋予重试能力,提供了开箱即用的指数退避(Exponential Backoff)、抖动(Jitter)、条件重试、统计回调等完备机制,避免了网络波动演变为系统级崩溃。
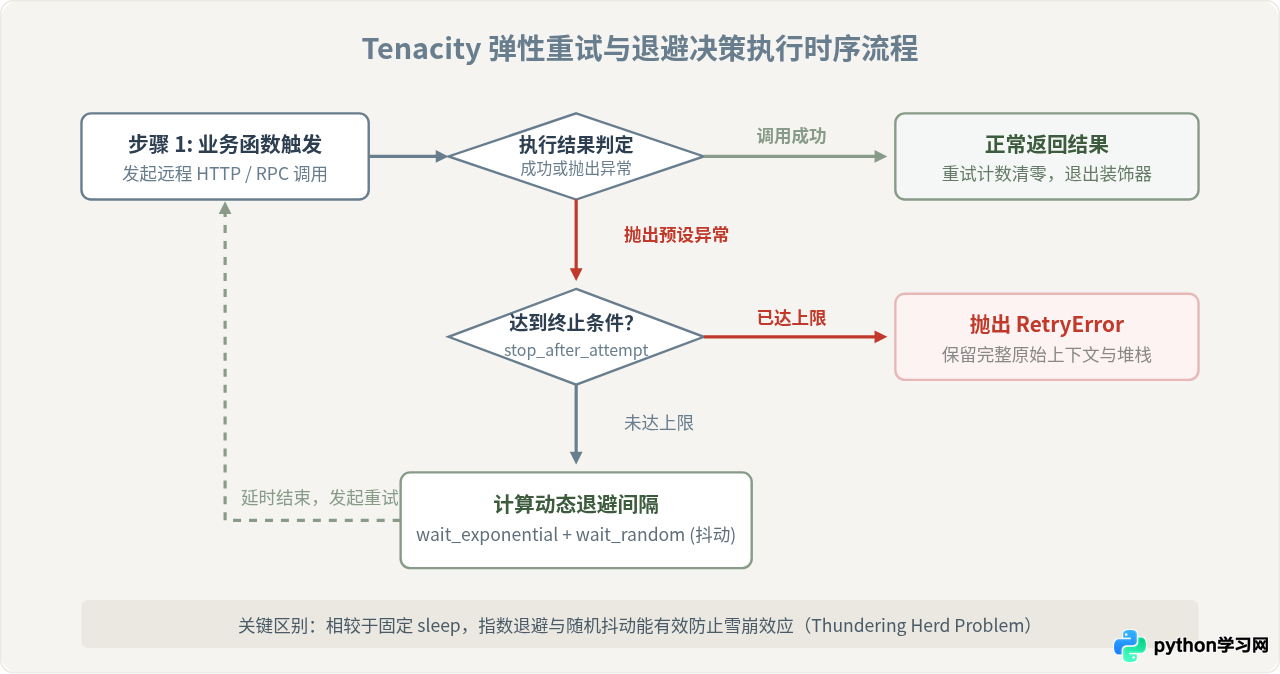
实践示例:搭配 Requests 实现高弹性网络请求
# 安装方式:pip install tenacity requests
import requests
from tenacity import retry, stop_after_attempt, wait_exponential_jitter, retry_if_exception_type

# 仅在遇到特定网络异常或连接超时时触发重试
@retry(
    stop=stop_after_attempt(3), # 最大重试3次
    wait=wait_exponential_jitter(initial=1, max=10), # 初始1秒,随次数指数递增并附带随机扰动
    retry=retry_if_exception_type((requests.exceptions.Timeout, requests.exceptions.ConnectionError)),
    reraise=True # 重试耗尽后直接抛出原本异常,便于上层定位
)
def fetch_user_profile(user_id: int) -> dict:
    url = f"https://api.example.com/v1/users/{user_id}"
    response = requests.get(url, timeout=3.0)
    response.raise_for_status()
    return response.json()
三、全流程极简工程日志:Loguru
标准库 logging 架构完备,但配置门槛高。若要实现按文件大小分割、多线程安全落盘、按格式染色以及堆栈捕获,通常需要定义多个 Handler、Formatter 与 Filter。繁琐的模板代码经常导致开发者在脚本中妥协使用 print(),丧失了在生产环境排查问题的能力。
Loguru 的核心思想是“开箱即用”。它默认配置了具有色彩渲染的标准输出 logger,无需创建命名空间对象即可直接导入使用。通过单个 logger.add() 方法,就能直接控制日志轮转、归档压缩与异步写入。
实践示例:Loguru 文件分割与异常捕获
# 安装方式:pip install loguru
from loguru import logger
import sys

# 1. 移除默认标准输出,配置持久化日志:每日轮转、保留10天、压缩归档
logger.remove()
logger.add(sys.stdout, colorize=True, format="<green>{time:YYYY-MM-DD HH:mm:ss}</green> | <level>{level: <8}</level> | <cyan>{name}</cyan>:<cyan>{function}</cyan> - <level>{message}</level>")
logger.add("logs/app_{time:YYYY-MM-DD}.log", rotation="500 MB", retention="10 days", compression="zip", enqueue=True)

# 2. 核心特性:使用 @logger.catch 装饰函数,自动记录导致崩溃的局部变量值
@logger.catch
def calculate_metrics(items: list):
    logger.info(f"开始计算指标,输入条数: {len(items)}")
    result = sum(items) / len(items) # 若 items 为空列表,将自动打印出除零异常时的所有上下文
    return result
四、自然时间与跨时区计算:Pendulum
标准库的 datetime 在处理单纯的本地时间时表现尚可,但在处理复杂的时区转换(特别是历史夏令时变动)、自然语言表达(如“3小时前”)或日期间隔平移时,代码很容易变得晦涩难懂。例如,标准库计算月份增加需要额外借助 dateutil.relativedelta,而时区绑定常因 tzinfo 的行为不一致引发隐蔽的偏移错误。
Pendulum 是 Python 标准 datetime 的直接子类扩展,这意味着它可以作为无缝替代品直接传入接受标准 datetime 的函数。它彻底重构了时区管理逻辑,默认基于 IANA 时区数据库,并原生提供了极其丰富的流式操作接口。
dt.replace(tzinfo=...) 并不会折算时间,而只是单纯覆盖标记;而使用 Pendulum 的 in_timezone() 则会按真实地理时区进行严谨的时间线换算。
实践示例:Pendulum 链式操作与时区换算
# 安装方式:pip install pendulum
import pendulum

# 1. 创建指定时区时间,并智能解析 ISO 8601 字符串
beijing_time = pendulum.now("Asia/Shanghai")
tokyo_time = beijing_time.in_timezone("Asia/Tokyo")

print(f"北京时间: {beijing_time.to_datetime_string()}")
print(f"东京时间: {tokyo_time.to_datetime_string()}")

# 2. 直观的流式计算:下周一的起始点、增加工作日
next_week_start = beijing_time.next(pendulum.MONDAY).start_of("day")
print(f"下周一零点: {next_week_start}")

# 3. 人性化时间差表达
past_event = beijing_time.subtract(minutes=45)
print(past_event.diff_for_humans()) # 示例输出: "45 minutes ago"
五、工具选型矩阵与核心场景全景
在工程实践中,盲目引入外部依赖会增加维护负担,但如果标准库在特定场景下的实现成本显著高于收益,选用经过社区验证的小众专用库则是性价比极高的选择。以下表格梳理了四个库的选型依据:
| 库名称 | 核心目标领域 | 传统替代方案痛点 | 关键特性优势 | 适用典型场景 |
|---|---|---|---|---|
| Glom | 嵌套字典与对象提取 | 多层 .get() 繁琐脆弱,易引发 KeyError |
声明式路径、缺省兜底、数据形态直接重塑 | 复杂 JSON 清洗、第三方 API 报文解析 |
| Tenacity | 重试策略与网络韧性 | 手写循环与 sleep 易引发重试风暴或吞没异常 | 指数退避、随机扰动、条件捕获、装饰器集成 | RPC/微服务请求、数据库瞬态重连、消息消费 |
| Loguru | 工程级日志记录 | 标准 logging 模块样板代码冗长,配置成本高 | 开箱即用、一键滚动与压缩、全自动堆栈变量追踪 | 数据脚本、Web 应用日志、长驻任务排障 |
| Pendulum | 日期时间与时区计算 | datetime 的 tzinfo 行为隐晦,跨月跨年计算繁琐 | 继承标准库 datetime、人性化自然时间、可靠 IANA 时区 | 跨国跨境业务、定时任务调度、报表周期统计 |
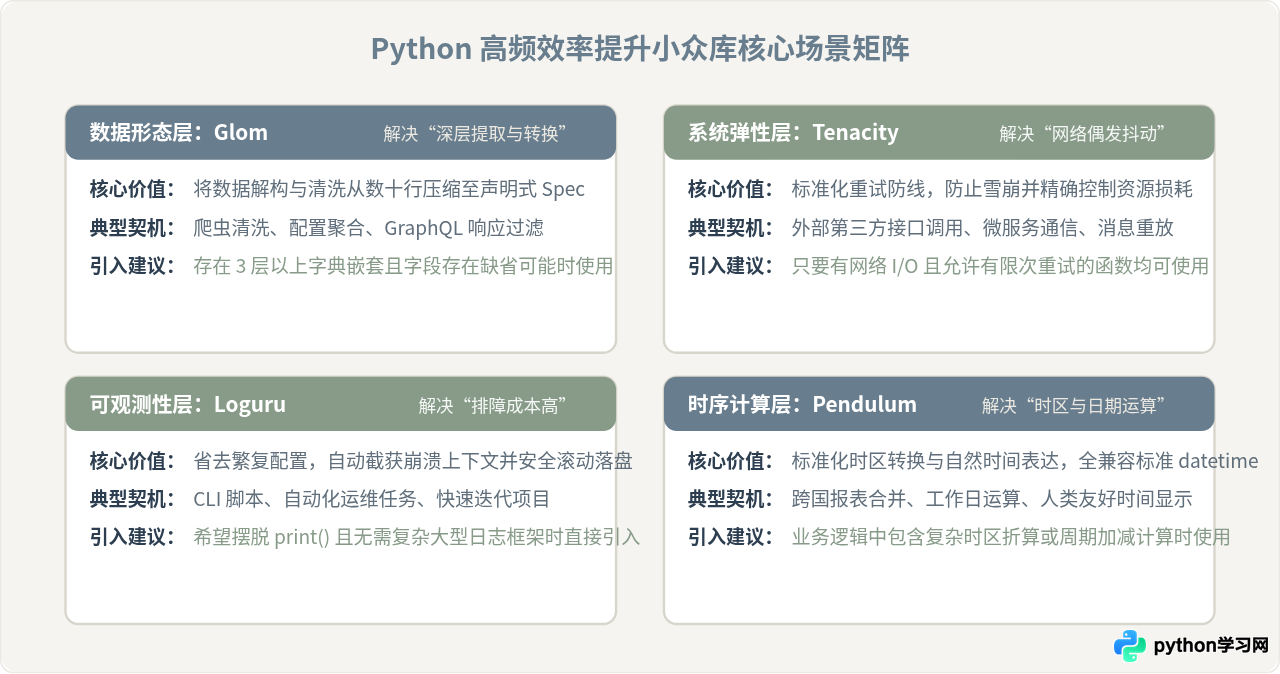
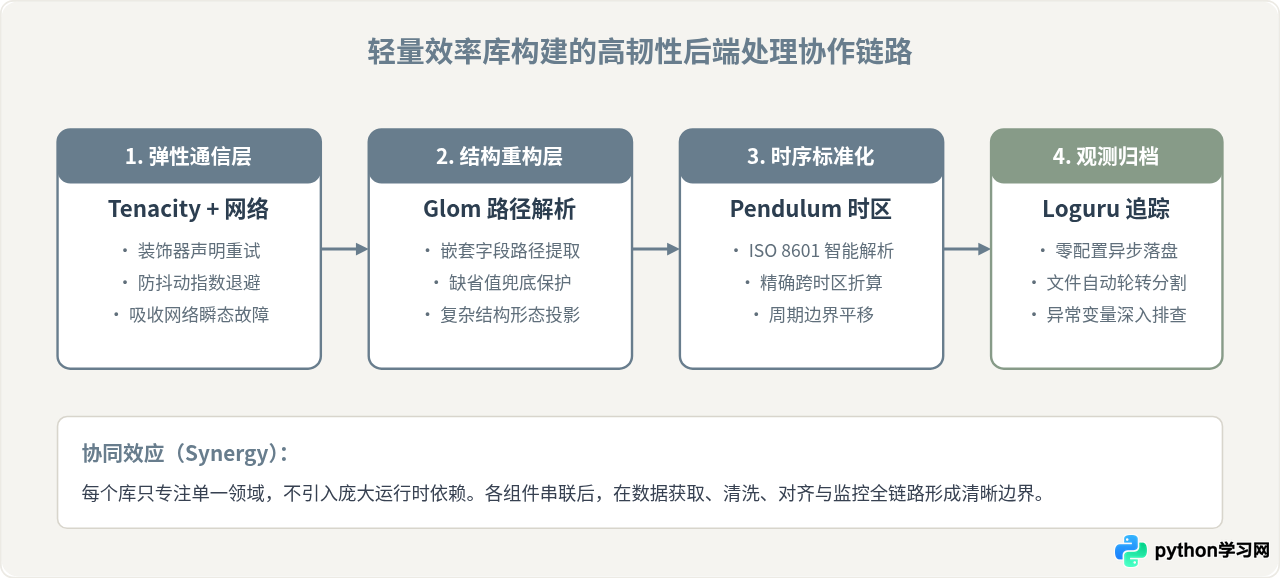
日常工程中,提升效率不仅体现在“写代码的速度”,更体现在“排障、防御与维护的成本”。上述四个库体量小、无沉重外部侵入,却能在各自专注的细分场景中替代大量样板代码。根据项目遇到的实际瓶颈按需采纳,往往能在不增加架构复杂度的前提下,显著改善代码的健壮度与可读性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









