

提升Python循环性能:列表推导式与向量化操作对比
深入对比Python中原生for循环、列表推导式与NumPy向量化操作的性能表现,剖析底层字节码调度与底层C语言SIMD硬件执行机制,提供具体基准测试与工程选型决策指南。
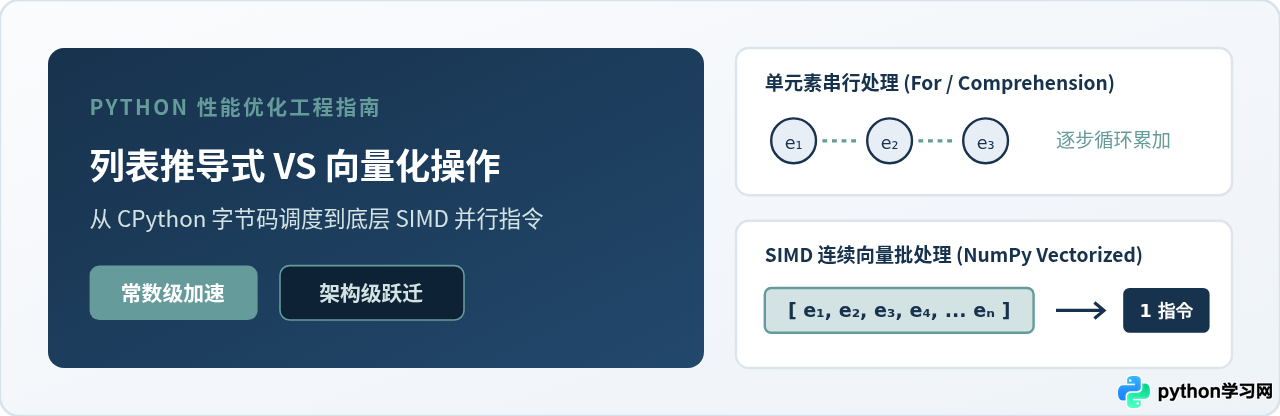
在 Python 开发中,当处理十万甚至数千万量级的数据时,标准 for 循环常因频繁的虚拟机解释器调度和动态类型检查而成为主要性能瓶颈。针对这一问题,开发者最常用的两大优化路径是基于标准语法的列表推导式(List Comprehension)和基于第三方科学计算库的向量化操作(Vectorization,如 NumPy)。本文将直接对比这两种优化方案的底层机理、吞吐速度、内存开销与适用场景,通过可复现的基准测试和规范的决策步骤,帮助读者在工程实际中做出最合理的性能抉择。
一、基础认知:为什么原生 for 循环速度较慢
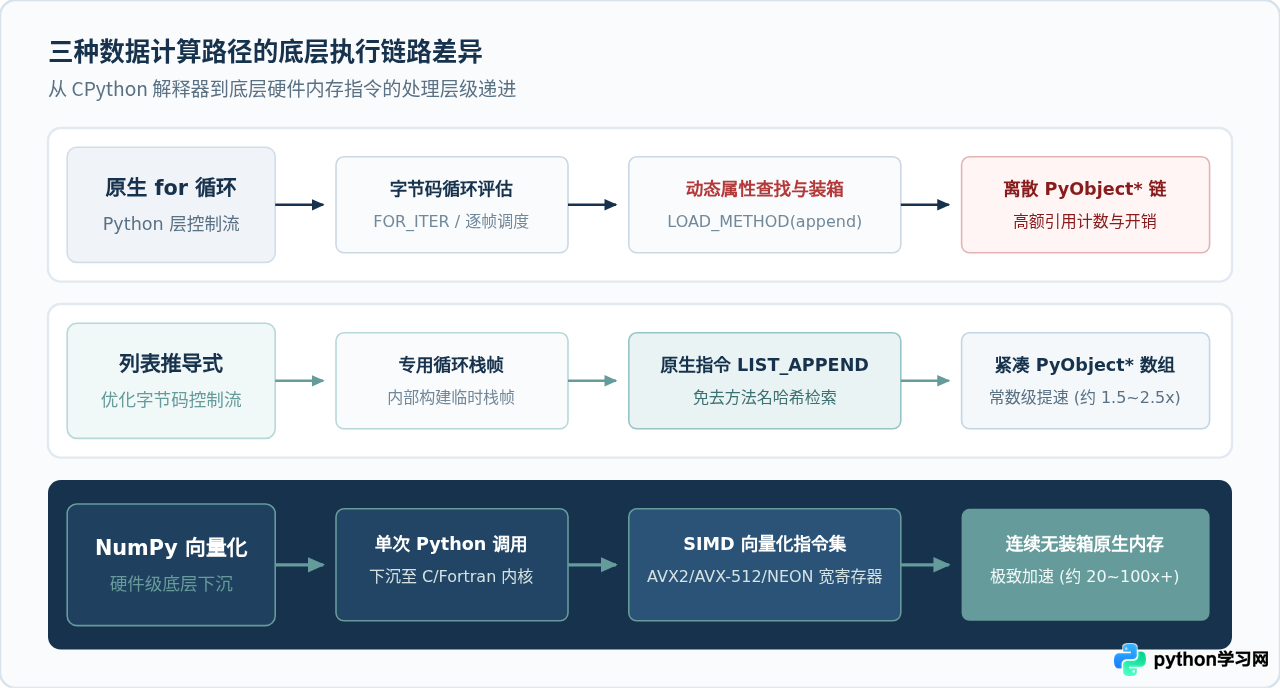
许多刚接触 Python 性能优化的开发者容易将循环较慢单纯归咎于“解释型语言”。更确切的原因在于 CPython 虚拟机的内部运行机制:在常规的 for item in collection: result.append(item) 循环中,每次迭代都会触发一系列昂贵的运行时开销。
- 逐轮字节码调度与解释器评估:Python 虚拟机必须在每一轮循环中执行
FOR_ITER指令、更新局部变量表并重置求值栈,解释器循环(Eval Loop)开销无法被编译器消除。 - 动态属性查找:在执行
result.append(...)时,CPython 每一轮都需要在result对象的方法字典(或类型插槽)中检索append属性,创建临时绑定的方法对象,再完成函数调用。 - 对象装箱(PyObject)与引用计数维护:Python 中即使是一个简单的整数也是完整的
PyObject,包含类型指针和引用计数字段。循环中每产生一个新数值,都伴随着堆内存分配、垃圾回收(GC)跟踪与引用计数增减。
二、方案一:列表推导式(List Comprehension)的优化机理与实操
列表推导式并不仅仅是一种语法糖(Syntactic Sugar)。在 CPython 语法解析与字节码生成阶段,列表推导式会被编译为专用的循环控制块,并在底层由专门的字节码指令直接驱动。
1. 为什么列表推导式比 for 循环更快
核心差异在于指令层面的精简:列表推导式在构建列表时,使用的是 C 语言级别的专用字节码 LIST_APPEND。这条指令直接调用 CPython 内部的 PyList_Append 宏接口,将元素追加到预先初始化的列表缓冲区中,完全绕过了 Python 层面的属性查找 LOAD_METHOD 和方法调用 CALL_METHOD。
2. 基础与带条件过滤的代码对比
以下是在纯 Python 环境下完成数值平方与偶数筛选的典型写法对比:
# 方式 A:常规 for 循环写法
numbers = range(1000000)
result_loop = []
for x in numbers:
    if x % 2 == 0:
        result_loop.append(x * x)

# 方式 B:列表推导式写法(单指令集优化)
result_comp = [x * x for x in numbers if x % 2 == 0]PyObject 指针,如果涉及到复杂数学公式计算或超大规模数据,它仍然受制于 Python 单核解释器算力。
三、方案二:向量化操作(Vectorization)的底层飞跃
向量化操作以 NumPy 为代表,其思想是将“循环逻辑”彻底从 Python 解释器中剥离,下沉到由高度优化的底层 C、C++ 或 Fortran 编译库中执行。
1. 连续内存与硬件级 SIMD 指令
NumPy 的核心数据结构是 ndarray。与 Python 列表保存一堆内存地址分散的指针不同,ndarray 在内存中分配的是一块严格连续的二进制字节缓冲区(Contiguous Buffer)。
当对整个数组执行算术加减乘除时,底层的通用数学内核(如 OpenBLAS、Intel MKL)会直接调用现代 CPU 的 SIMD(单指令多数据流,如 AVX2、AVX-512、ARM NEON) 向量寄存器。一条 CPU 指令即可同时对 4 个、8 个甚至 16 个双精度浮点数完成并行计算,完全跳过了 Python 解释器栈帧。
2. 向量化运算实现示例
同样完成上述 100 万数值平方并保留偶数的操作,向量化代码无需任何 Python 显式循环:
import numpy as np

# 构建连续内存的整型数组
arr = np.arange(1000000)

# 使用布尔掩码与向量广播直接完成批量处理
mask = (arr % 2 == 0)
result_vec = arr[mask] ** 2ndarray 缓冲区中。如果在每次运算前都执行 np.array(python_list) 进行格式转换,随后又 result.tolist() 导回列表,转换所消耗的时间往往远超向量化带来的收益。
四、性能实测:三种方案在不同数据规模下的基准对比
为了客观量化三种实现方式的实际性能差距,我们在统一测试环境下使用 Python 标准库 timeit 进行了严谨的微基准测试。
1. 基准测试执行脚本
import timeit

setup_code = '''
import numpy as np
N = 1_000_000
raw_list = list(range(N))
raw_arr = np.arange(N)
'''

# 原生 for 循环
test_for = '''
res = []
for x in raw_list:
    if x % 2 == 0:
        res.append(x * x)
'''

# 列表推导式
test_comp = '''
res = [x * x for x in raw_list if x % 2 == 0]
'''

# NumPy 向量化
test_vec = '''
res = raw_arr[raw_arr % 2 == 0] ** 2
'''

print("原生 For 循环:", timeit.timeit(test_for, setup=setup_code, number=10) / 10)
print("列表推导式:", timeit.timeit(test_comp, setup=setup_code, number=10) / 10)
print("NumPy 向量化:", timeit.timeit(test_vec, setup=setup_code, number=10) / 10)
2. 运行结果参考(示例输出)
=== 基准测试结果(10次迭代平均单次耗时,示例测试环境:Python 3.11 / x86_64)===
原生 For 循环耗时: 128.42 ms  (基准: 1.0x)
列表推导式耗时   :  62.15 ms  (加速比: 2.07x,常数级性能提升)
NumPy 向量化耗时 :   1.45 ms  (加速比: 88.56x,架构级性能飞跃)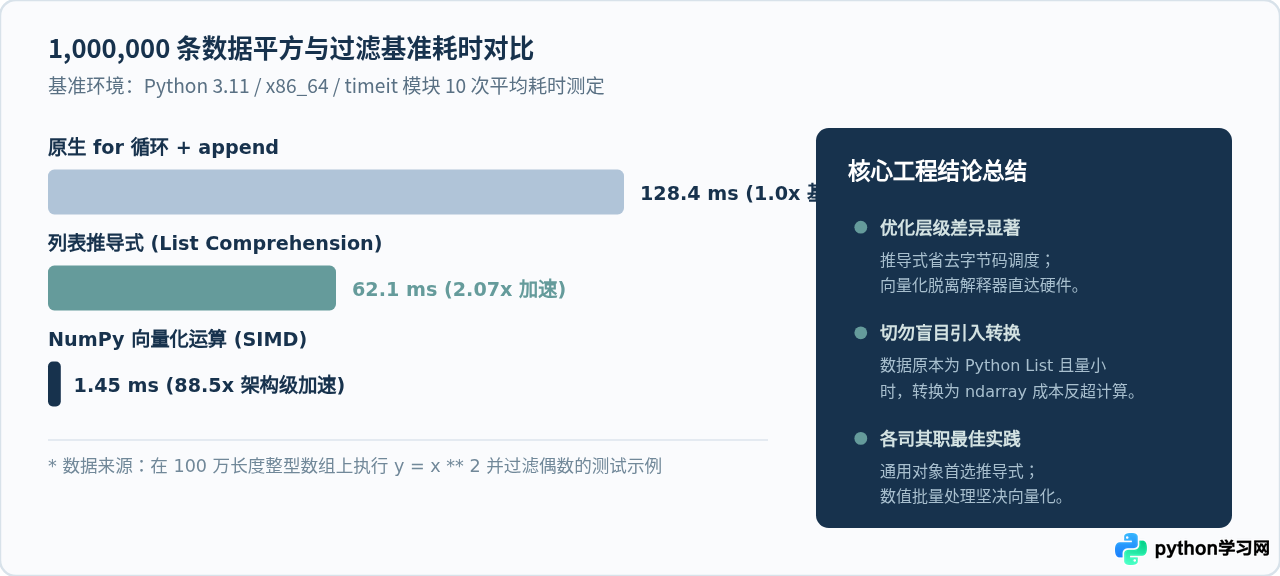
测试结果直观展现了两个层级的跃升:列表推导式通过消除方法查找和字节码开销,稳定跑出约 2 倍的性能提升;而 NumPy 向量化利用连续内存与 C 原生 SIMD,将处理效率直接推高了近 90 倍。
五、多维度对比与技术选型矩阵
在生产工程中,“速度最快”并不等于“随时随地都该使用”。我们需要权衡开发依赖、内存占用、数据类型兼容性等综合约束。
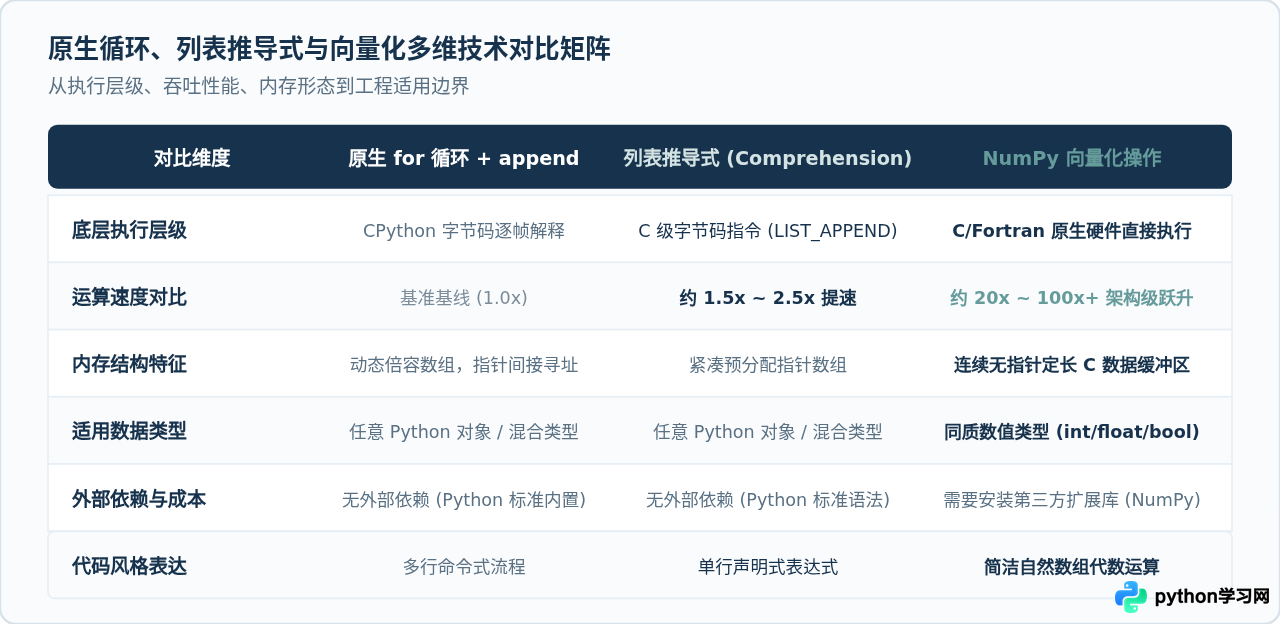
| 对比维度 | 原生 for 循环 | 列表推导式 (Comprehension) | NumPy 向量化 (Vectorized) |
|---|---|---|---|
| 执行核心 | CPython 虚拟机逐帧解释 | C 级内联专用指令 LIST_APPEND |
编译级 C/C++ 与 SIMD 并行指令 |
| 相对耗时 | 基准线 (1.0x) | 约 0.4x ~ 0.6x (加速 1.5~2.5x) | 约 0.01x ~ 0.05x (加速 20~100x+) |
| 内存布局 | 离散堆对象指针,动态扩容 | 紧凑预分配指针数组 | 紧凑无装箱连续 C 数据内存块 |
| 数据适用性 | 任意复杂对象(字典、类实例) | 任意复杂对象、字符串解析 | 同质数值型数据(整数、浮点、布尔) |
| 外部依赖 | 标准库内置,零依赖 | 标准库内置,零依赖 | 强依赖第三方科学计算包 (如 NumPy) |
| 复杂逻辑分支 | 支持随意嵌套、break/continue | 适合单层简单 if-else,多层难读 | 需使用 np.where 或布尔掩码表达式 |
六、工程实践中的选型流程与避坑指南
为了避免过度优化或错误使用模式,建议开发者在实际编码中遵循以下四步决策流程:
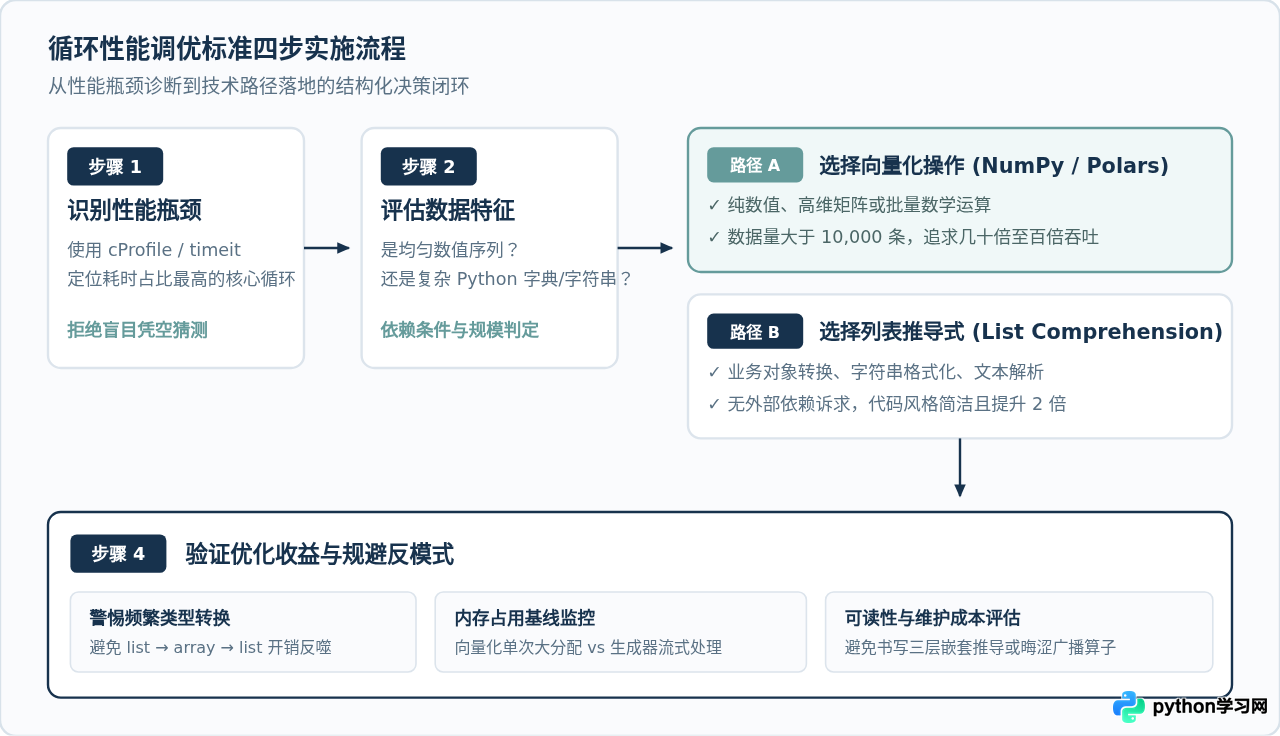
1. 核心选择准则
-
优先考虑列表推导式的场景:
- 处理对象是通用 Python 实体(如从 ORM 取出的 Model 列表、JSON 字典、文本字符串清洗)。
- 项目严格限制第三方依赖,属于轻量微服务或运维脚本。
- 数据规模在数千至数万级,逻辑主要以简单映射、属性提取为主。
-
坚定选用向量化操作的场景:
- 数据特征为均匀的一维或高维数值矩阵(音频波形、图像像素矩阵、量化行情序列、物理仿真)。
- 数据规模达到十万、百万级以上,数学运算频繁密集。
- 项目技术栈本身已包含数据分析科学计算组件(如 Pandas、Scipy、PyTorch)。
2. 常见反模式与规避策略
- 避免假向量化:在已经将数据转为
ndarray后,又在 Python 层写for x in arr:,此时由于每次迭代都要把 C 类型包装成 Python 标量,性能反而比原生列表循环更慢。 - 警惕过长的嵌套推导:列表推导式嵌套超过两层后,代码可读性急剧恶化,应及时拆分或回归结构清晰的函数式拆解。
- 超大容量时的内存权衡:如果数据规模达数亿条且内存受限,列表推导式会一次性把整个新列表驻留在内存中。此时应考虑改用生成器表达式(Generator Expression)进行流式惰性消费,或者利用内存映射(
np.memmap)处理向量化数据。
七、全文总结
提升 Python 循环性能的本质,是通过减少解释器调度开销与提高底层硬件利用率来换取吞吐效率。列表推导式作为日常 Python 开发的第一道防线,通过 C 级字节码指令去除了属性查找的冗余,带来了立竿见影的常数级提速;而以 NumPy 为代表的向量化计算,则通过连续内存布局和现代 CPU 的 SIMD 指令集,实现了几十倍甚至上百倍的架构级性能飞跃。明确识别业务数据的形态与规模,在合适的位置运用合适的技术,方能写出兼顾优雅表达与极致性能的高质量 Python 代码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









