

怎么向面试官解释Python3.14子解释器并发模型?
系统梳理向面试官解释Python 3.14子解释器并发模型的核心逻辑,涵盖Per-Interpreter GIL架构原理、四大多任务模型对比、标准库实操代码及高频追问攻防策略。
一、破题定性:子解释器并发模型的架构本质
在技术面试中,面试官抛出这个问题,通常是为了考察候选人对 CPython 运行时底层机制的理解深度,以及对 Python 3.12 到 3.14 核心并发演进的跟踪程度。回答时切忌直接背诵零散代码,应先从运行时架构的物理与逻辑边界切入。
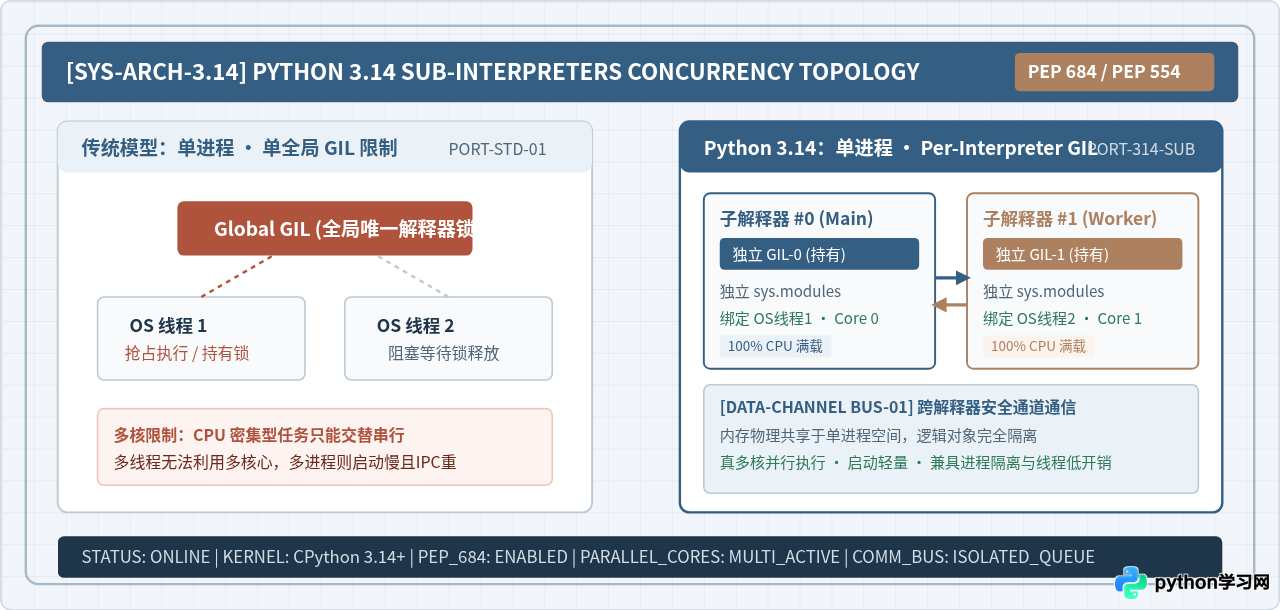
Python 3.14 中的子解释器并不是全新的概念(早在 Python 1.5 就有雏形),但过去几十年来,所有子解释器必须强行共享一把进程级的全局解释器锁(Global GIL)。这意味着即使在 C 语言层面创建了多个子解释器,同一时刻也只有一个解释器能执行 Python 字节码,完全无法发挥多核算力。
这一困局在 Python 3.12 引入 PEP 684 后迎来根本转折,并在 Python 3.14 完成了完整的标准库高层封装。向面试官解释时,需要重点强调以下三项关键内部特征:
- 独立 GIL 实例(Per-Interpreter GIL):每个子解释器拥有属于自己的独立 GIL 互斥体(
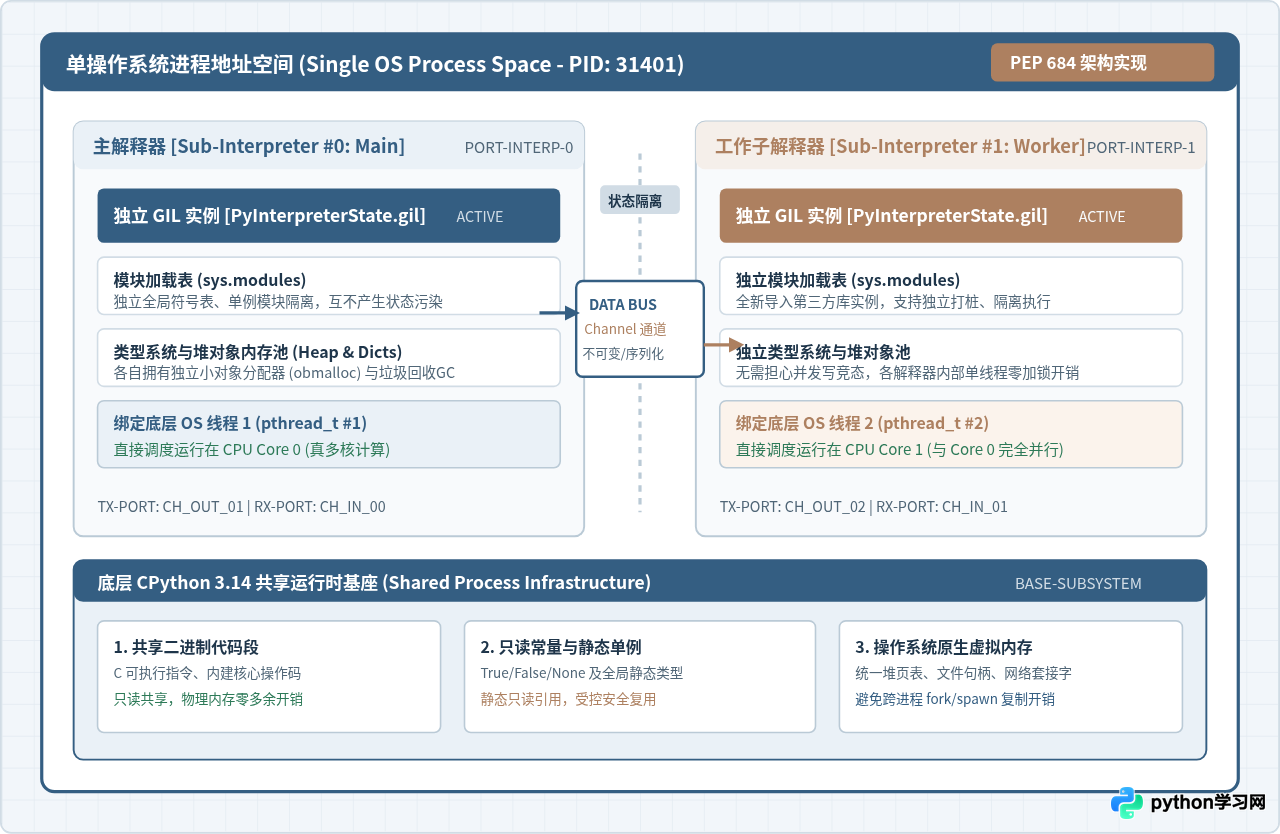
PyInterpreterState.gil)。当子解释器绑定到独立的操作系统原生线程(OS Thread)时,能够在不同的物理 CPU 核心上实现真正的线性并行执行,CPU 利用率可达 100%。 - 逻辑堆与模块状态完全隔离:每个子解释器拥有独立的
sys.modules符号表、内置类型字典、执行栈帧以及独立的小对象内存分配池(obmalloc)与垃圾回收器(GC)。一个解释器内部修改全局变量或重载模块,对其他解释器毫无污染。 - 单进程物理地址空间复用:所有子解释器驻留在同一个操作系统进程内(相同 PID)。它们共享只读的底层 C 代码段、全局只读单例常量(如
True、False、None)与系统级文件描述符,消除了操作系统多进程 fork 或 spawn 的庞大内存页表复制开销。
二、技术横评:与多线程、多进程、自由线程的四方对决
资深面试官往往会在你定性之后,顺势提问:“既然已经有多进程和多线程,为什么 Python 还要折腾子解释器?它和 3.13/3.14 推出的 Free-threaded(No-GIL)又有什么关系?”
面对这类横向对比问题,最专业的方法是围绕“GIL 控制粒度、内存状态隔离度、启动开销、跨实体通信成本、CPU密集型多核加速”五个工程指标进行矩阵化剖析:
| 并发模型 | GIL 控制粒度 | 内存与状态隔离 | 启动与资源开销 | 跨实体通信方式 | CPU 密集型真多核 |
|---|---|---|---|---|---|
| 传统多线程 (threading) | 单进程单全局锁 | 零隔离(共享所有堆) | 极低(微秒级) | 直接内存读写(需手动加锁防竞态) | 否(0% 提速,严重串行争抢) |
| 传统多进程 (multiprocessing) | 每进程独立一锁 | 完全物理隔离 | 高(毫秒至数十毫秒,需复制页表) | IPC(管道/套接字,重度依赖 pickle 序列化) | 是(多核线性加速) |
| 自由线程 (PEP 703 No-GIL) | 彻底消除 GIL | 零隔离(多线程共享全局堆) | 极低(原生线程级) | 直接共享内存(依赖底层偏向锁与原子操作) | 是(但代码需重构排查竞态,单线程有轻微吞吐损耗) |
| 子解释器 (PEP 684/554) | 每个解释器独占一把 GIL | 单进程内逻辑完全隔离 | 中低(毫秒级,共享代码段与只读底座) | 跨解释器通道(Channel,传递不可变对象或字节) | 是(多核真并行,且单线程内部免并发锁重构) |
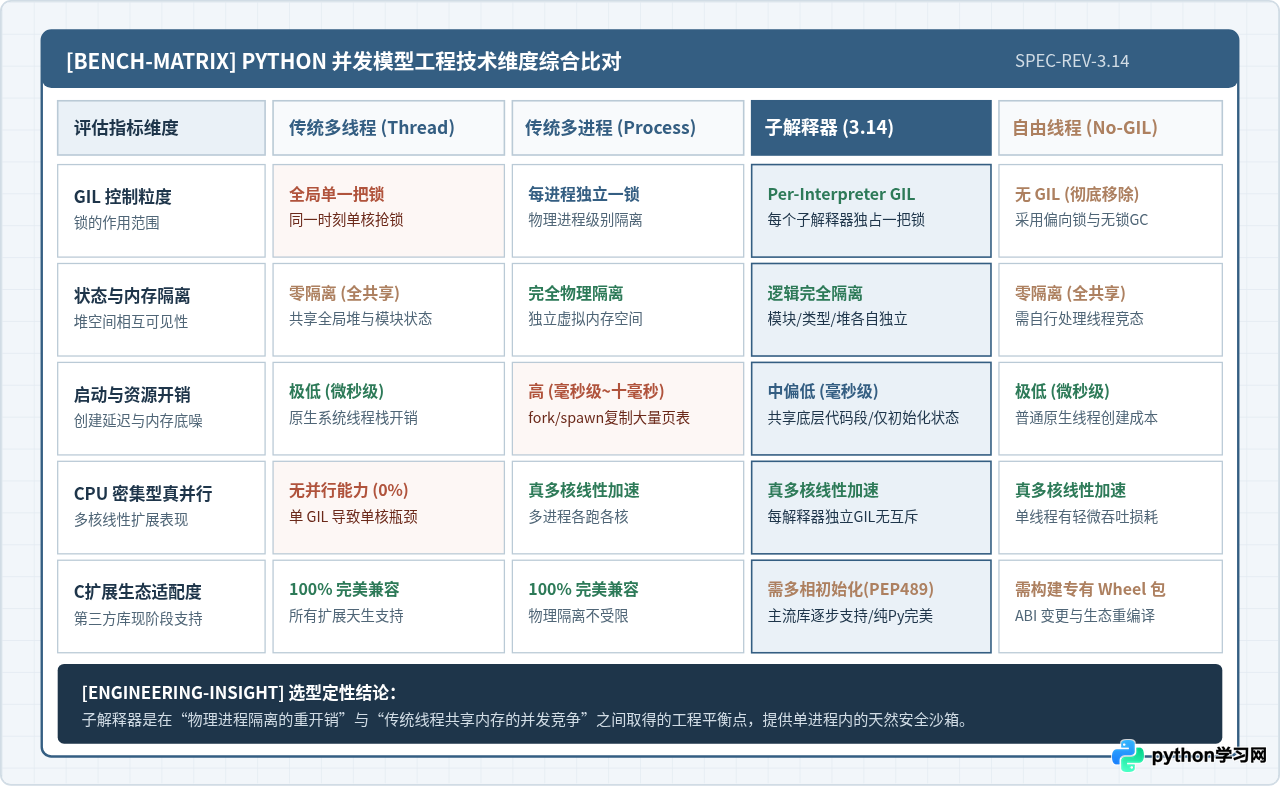
向面试官总结四者区别的黄金话术是:“多线程是‘共享内存但受制于单锁’;多进程是‘避开锁但隔离太重’;自由线程是‘拆掉锁让大家直接共享内存,但要自行防范数据竞态’;而子解释器是‘在单进程内划分独立沙箱,既有独立锁实现多核加速,又靠隔离彻底免除多线程死锁风险’。”
三、面试应答演练:结构化输出的黄金四步法
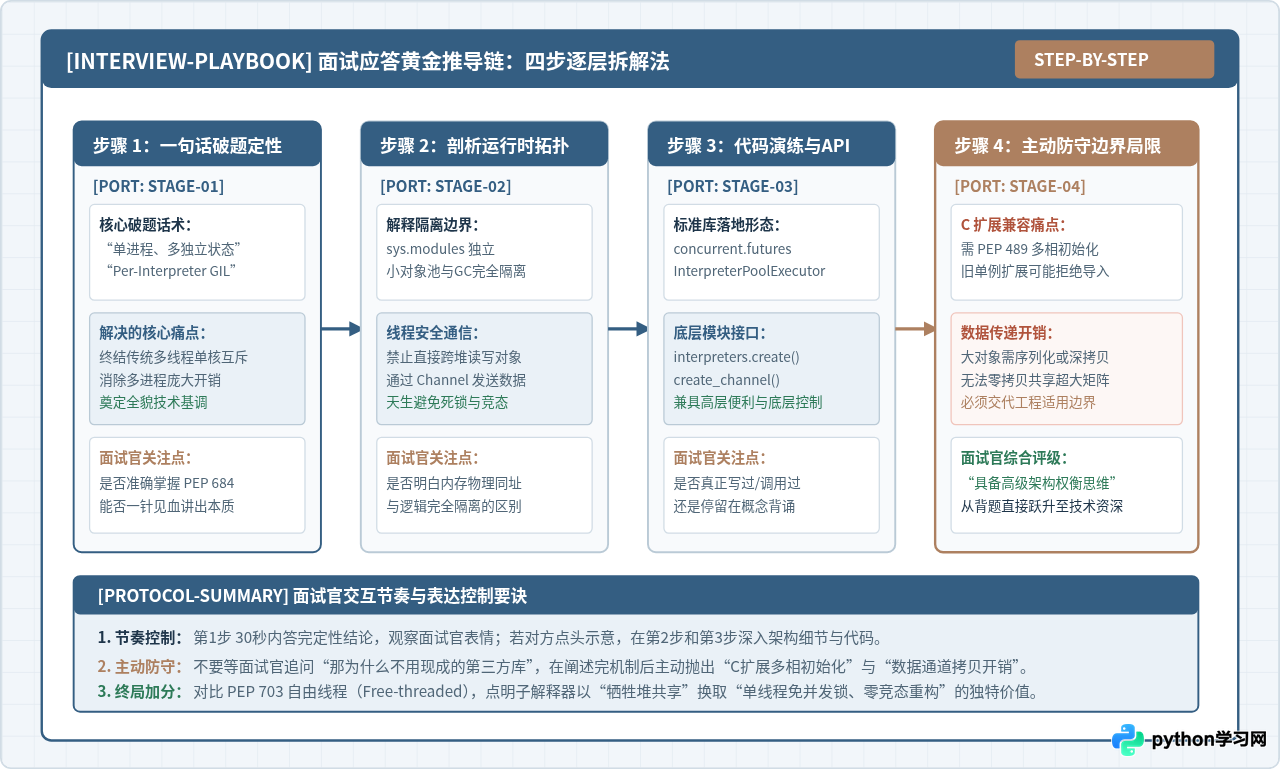
为了防止在面试中思路发散或回答过于零碎,建议在头脑中建立清晰的四步推导链。每一步层层递进,既回答概念,又给出事实依据和防御预案。
-
步骤一:一句话结论先行(时长约 30 秒)
直接点出 PEP 684(Per-Interpreter GIL)与 PEP 554(标准库 API)。明确说明子解释器允许在一个 OS 进程里运行多个拥有独立 GIL 的 Python 解释器实例,分别绑定到不同线程,实现纯多核真并行。 -
步骤二:拆解运行时隔离机制与通信拓扑(时长约 60 秒)
讲清两个隔离和一个连接:隔离的是sys.modules符号表与堆对象,互不污染全局状态;隔离的是小对象内存池与垃圾回收,单解释器内部执行无需跨线程加锁;连接的是受限的Channel(数据通道),采用无锁或序列化安全管道传输,从根源上杜绝了死锁与内存竞态。 -
步骤三:给出 Python 3.14 标准库的具体代码模式(时长约 60 秒)
向面试官展示 Python 3.14 提供的上层concurrent.futures.InterpreterPoolExecutor以及底层的interpreters模块 API,说明它如何无缝替代现有的线程池与进程池。 -
步骤四:主动指出适用边界与工程限制(时长约 45 秒)
不要等面试官追问缺点,主动指出当前 C 扩展对 PEP 489 多相初始化(Multi-phase initialization)的依赖,以及跨解释器无法直接零拷贝共享超大可变对象的开销。这一步通常是区分普通开发者与高级架构师的关键加分项。
四、代码实战:Python 3.14 标准库 API 与数据传递范式
在白板或线上编程环节,面试官可能会要求你写出子解释器的调用示例。Python 3.14 在标准库中提供了两种使用方式:面向业务的高层线程池模型,以及面向精细控制的底层通道模型。
1. 高层 API:使用 InterpreterPoolExecutor 进行多核计算
在 Python 3.14 中,concurrent.futures 新增了 InterpreterPoolExecutor。其接口与 ThreadPoolExecutor 和 ProcessPoolExecutor 完全统一,是生产环境中最推荐的高层接入方式。
# 环境要求: CPython 3.14+ (需开启 Per-Interpreter GIL 特性)
import math
import time
from concurrent.futures import InterpreterPoolExecutor

def cpu_heavy_task(n: int) -> int:
    """CPU 密集型计算任务:计算素数累加和"""
    count = 0
    for i in range(2, n):
        is_prime = True
        for j in range(2, int(math.isqrt(i)) + 1):
            if i % j == 0:
                is_prime = False
                break
        if is_prime:
            count += 1
    return count

def main():
    task_args = [100000, 120000, 140000, 160000]
    start_time = time.perf_counter()

    # 创建拥有 4 个独立子解释器的执行池,各自独享独立 GIL 并绑定独立 OS 线程
    with InterpreterPoolExecutor(max_workers=4) as executor:
        results = list(executor.map(cpu_heavy_task, task_args))

    elapsed = time.perf_counter() - start_time
    print(f"[示例执行输出] 任务结果: {results}")
    print(f"[示例执行输出] 4核子解释器并发总耗时: {elapsed:.3f} 秒")

if __name__ == "__main__":
main()ThreadPoolExecutor 中运行上述纯 CPU 计算代码,即使分配了 4 个线程,4 个核心也会因抢占单一把 GIL 而排队,总耗时与单线程几乎无异;而在 InterpreterPoolExecutor 中,观察系统监控可以看到 4 个 CPU 核心同时达到 100% 满载,耗时呈线性缩短。
2. 底层 API:使用 interpreters 与 Channels 精细交互
如果需要更细粒度的控制,如在子解释器中常驻后台服务并持续监听外部事件,可以直接调用标准库的 interpreters(PEP 554 提案落地)模块。
# 环境要求: CPython 3.14+
import interpreters

def run_worker_subinterpreter():
    # 1. 创建两个双向数据通道 (FIFO 通道)
    in_chan = interpreters.create_channel()
    out_chan = interpreters.create_channel()

    # 2. 创建全新的独立子解释器实例
    worker = interpreters.create()

    # 3. 在子解释器中执行初始化脚本并绑定通道端口
    worker_code = f"""
import interpreters

in_chan = interpreters.Channel({in_chan.id})
out_chan = interpreters.Channel({out_chan.id})

# 监听来自主解释器的数据
data = in_chan.recv()
result = f"[Worker Processed] {data.upper()}"

# 将处理完毕的结果发回主解释器
out_chan.send(result)
"""
    # 4. 在独立线程中异步拉起子解释器运行
    worker.exec_async(worker_code)

    # 5. 主解释器通过通道发送只读/不可变消息
    in_chan.send("sub-interpreter architecture verified")

    # 6. 等待并接收回传结果
    response = out_chan.recv()
    print(f"[示例输出] 主解释器收到回传: {response}")

    # 7. 清理通道与解释器资源
    in_chan.close()
    out_chan.close()
    worker.destroy()

if __name__ == "__main__":
run_worker_subinterpreter()interpreters.ChannelError 或反序列化异常。
五、深度攻防:面试官可能挖的三个深水区陷阱
在高级职位面试中,面试官往往会追问极具挑战性的架构权衡问题。提前准备好针对这些问题的防守策略,能够直接体现出候选人的技术深度。
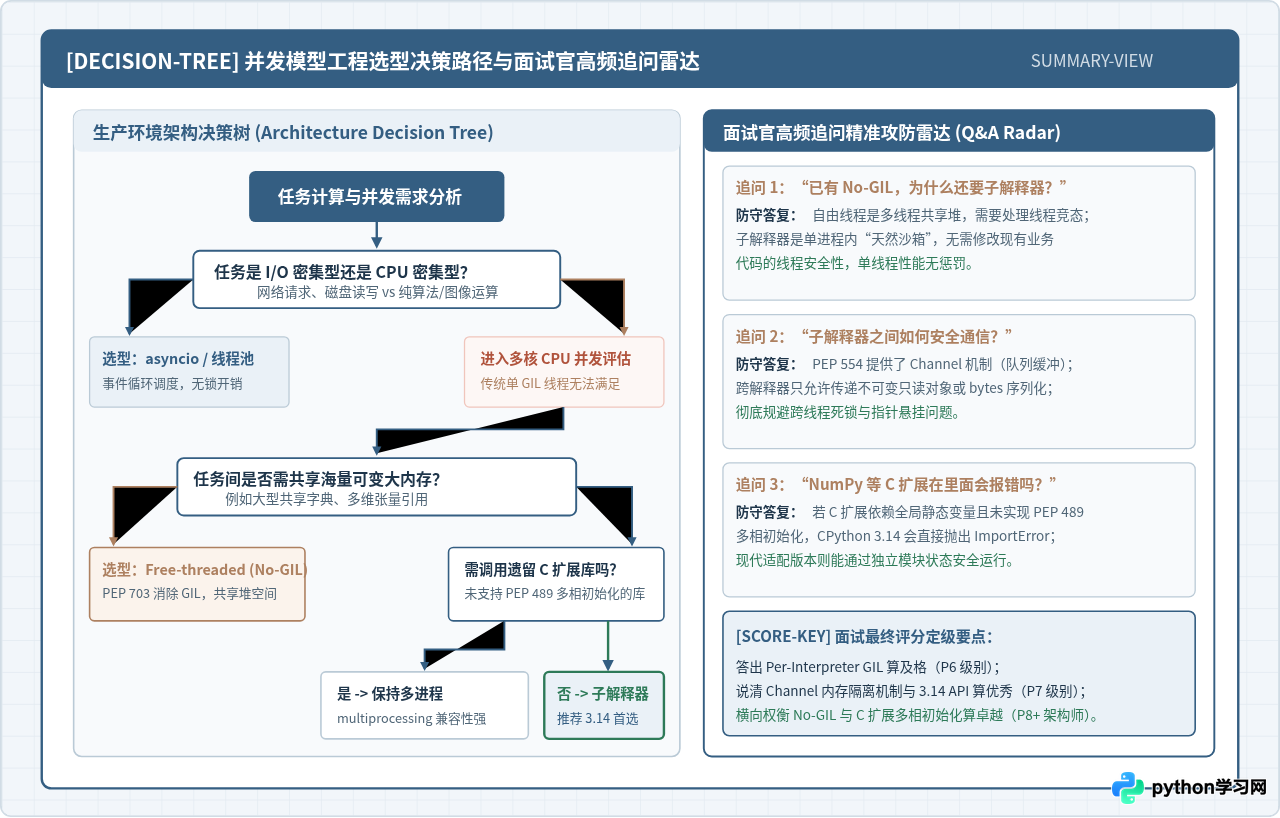
追问 1:“既然 Python 3.13/3.14 已经有 Free-threaded(No-GIL / PEP 703),为什么还要保留子解释器?”
核心答题要点:自由线程与子解释器解决的是完全不同维度的工程问题,二者是互补而非替代关系:
- 共享状态 vs 隔离状态:Free-threaded 是彻底砸掉 GIL,让所有线程在同一个全局堆中自由竞争。这非常适合科学计算中巨量矩阵的高并发切片,但付出的代价是应用层代码必须自行处理数据竞态(Race Conditions)和死锁风险。而子解释器追求的是单进程内的天然安全沙箱,非常适合微服务插件隔离、多租户代码执行、任务隔离流水线等场景。
- 单线程性能损耗:Free-threaded 为了保证多线程读写的内存安全,在底层引入了偏向引用计数(Biased Reference Counting)与无锁 GC,导致单线程执行速度有 5%~10% 的固有损耗;而子解释器内部依然保留独立 GIL,单个解释器内部的代码享有传统 CPython 顶级的单线程性能与 JIT 优化。
追问 2:“子解释器之间真的完全独立吗?底层的 CPython 到底共享了什么?”
核心答题要点:切忌简单回答“完全独立”。精确的工程事实是:逻辑对象完全隔离,但共享底层操作系统的虚拟进程空间与只读不可变基座:
- 不共享的内容:
sys.modules、全局符号字典、堆上的绝大多数 Python 对象(如新创建的 list、dict)、GC 垃圾回收跟踪链表、GIL 锁实例。 - 共享的内容:底层 CPython 的可执行机器代码段(.text 段)、部分只读单例常量(如
None、True、False、小整数对象缓存)、平台级的标准文件描述符(stdin/stdout/socket)。通过复用这些底层基础设施,子解释器省去了多进程必须经历的完整物理地址空间初始化。
追问 3:“现有的第三方 C 扩展(如 NumPy、Pandas)能在子解释器中直接无脑运行吗?”
核心答题要点:不能无脑运行,存在明确的兼容性前提条件:
传统的 C 扩展库通常采用单阶段初始化(Single-phase initialization),在 C 代码中大量使用 C 静态全局变量(static PyObject* cache)。当多个子解释器同时加载该扩展时,这些 C 静态变量会被多个解释器并发读写,瞬间导致内存越界崩溃(SIGSEGV)。
为了在子解释器中安全运行,C 扩展必须按照 PEP 489 实现多相初始化(Multi-phase initialization),并将模块状态封装在 PyModuleDef.m_size 分配的独立结构体中,声明支持 Py_mod_multiple_interpreters。如果一个扩展库尚未完成该改造,CPython 3.14 在子解释器中尝试 import 时会抛出明确的 ImportError 阻断加载,从而保证内存安全。
六、总结:面试官视角的最终评分要点
向面试官讲解完上述技术脉络后,可以用一句话做精炼收尾:“在 Python 3.14 的并发工具箱中,I/O 密集型优先选 asyncio;需要共享巨量内存张量的单体算法选 Free-threaded;需要物理隔离或依赖旧版 C 扩展选 multiprocessing;而对于兼具高状态隔离要求、追求极低启动开销与真多核性能的流水线业务,子解释器是单进程架构下的最优解。”
按照这套逻辑层层展开,不仅能展现出你对 Python 3.14 前沿特性的精准掌握,更能向面试官传递出你严谨的系统级思考框架与工程权衡能力。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









