

Python正则表达式元字符速查:量词、锚点与字符类详解
深入详解Python正则表达式的核心元字符体系,涵盖字符类、量词(贪婪与非贪婪)、锚点位置边界的匹配机制、实战代码与速查图解。
一、字符类(Character Classes):定义“匹配什么”
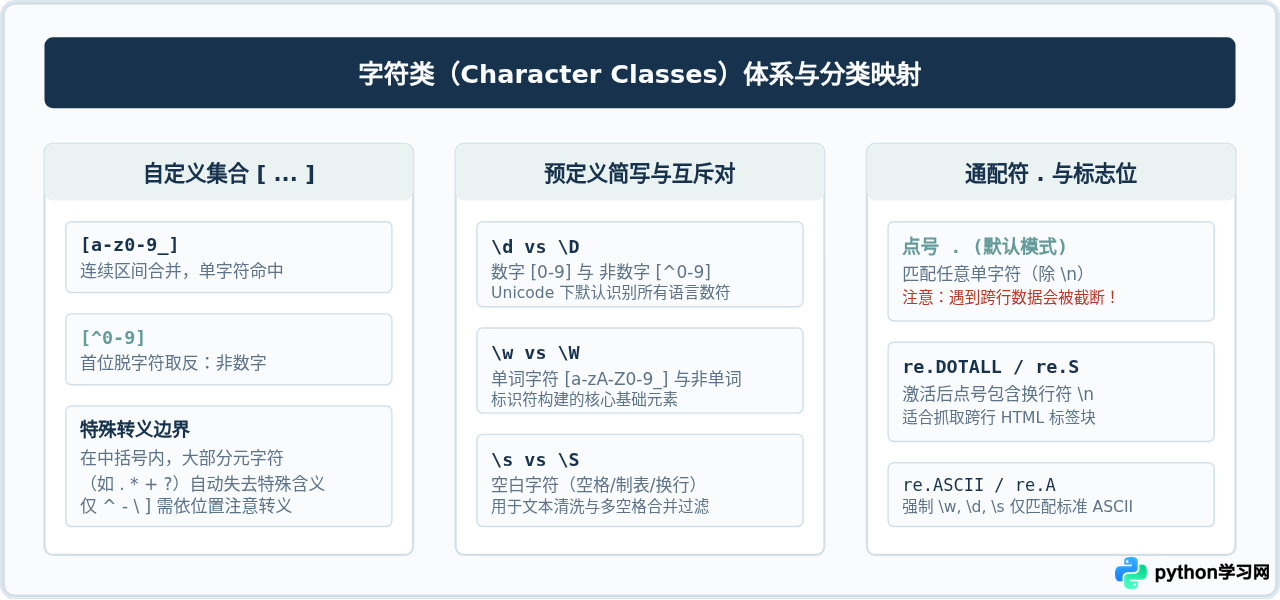
字符类允许正则表达式引擎在一个特定的字符集合中进行单字符匹配。在 Python re 模块中,方括号 [...] 用于构建自定义字符集,反斜杠加字母构成了预定义字符简写,而点号 . 则承担着通用通配符的角色。
1. 自定义集合与取反逻辑
方括号内的字符代表“只要匹配其中任意一个即可”。使用连字符 - 可以指定 ASCII 连续区间,而将脱字符 ^ 放置在方括号内的起始位置时,表示对该集合取反(即匹配不在该集合中的任意单个字符)。
[aeiou]:匹配任意英文字母元音。[a-zA-Z0-9]:匹配任意大小写字母或十进制数字。[^0-9]:匹配任何非数字字符(等价于\D)。[0-9-]或[-0-9]:连字符放在首尾时失去区间含义,直接作为普通连字符匹配。
2. 常用预定义字符集速查
| 元字符 | ASCII 模式含义 | 对应反义元字符 | 反义模式含义 |
|---|---|---|---|
\d |
匹配任意十进制数字 [0-9] | \D |
匹配任意非数字字符 [^0-9] |
\w |
匹配字母、数字及下划线 [a-zA-Z0-9_] | \W |
匹配任意非单词字符 [^a-zA-Z0-9_] |
\s |
匹配空白符(空格、\t、\n、\r、\f、\v) | \S |
匹配任意非空白字符 |
. |
匹配除换行符 \n 外的任意单个字符 |
re.DOTALL 模式下 |
点号可跨行匹配包含 \n 在内的任意字符 |
实战代码示例:过滤与提取字符类
import re

text = "Item code: A89-ZX, Price: $120.50, Quantity: 42, InStock: Yes"

# 1. 使用预定义字符集提取所有纯数字块
numbers = re.findall(r"\d+", text)
print("提取的纯数字:", numbers)
# 示例输出: ['89', '120', '50', '42']

# 2. 使用方括号组合与连字符提取复合商品代码 (如 A89-ZX)
item_codes = re.findall(r"[A-Z0-9]+-[A-Z0-9]+", text)
print("商品编码:", item_codes)
# 示例输出: ['A89-ZX']

# 3. 取反排除非字母字符
clean_words = re.findall(r"[^\d\s\W]+", text)
print("纯字母单词:", clean_words)
# 示例输出: ['Item', 'code', 'A', 'ZX', 'Price', 'Quantity', 'InStock', 'Yes']
二、量词(Quantifiers):定义“匹配多少次”
量词紧跟在字符、字符类或分组之后,用于指定前导模式能够重复出现的次数。掌握量词不仅要记住具体的频次语法,更要理解正则引擎内部的贪婪匹配(Greedy)与非贪婪匹配(Lazy/惰性)机制。
1. 核心量词速查表
| 量词 | 匹配频次 | 等价区间表示 | 典型应用场景 |
|---|---|---|---|
* |
0 次或多次(尽可能多) | {0,} |
可选的重复项、连续空格压缩 |
+ |
1 次或多次(至少 1 次) | {1,} |
连续数字、连续字母单词提取 |
? |
0 次或 1 次(可选出现) | {0,1} |
协议头匹配 (http/https)、正负号 (+/-) |
{m} |
精确匹配 m 次 | 固定次数 | 固话区号 (3-4位)、年月日定长校验 |
{m,n} |
匹配 m 至 n 次 | 闭区间 [m, n] | 密码长度约束 (如 {8,20}) |
{m,} |
至少匹配 m 次 | 开区间 [m, +∞) | 至少达到指定位数的字段匹配 |
2. 贪婪匹配与惰性匹配的运行差异
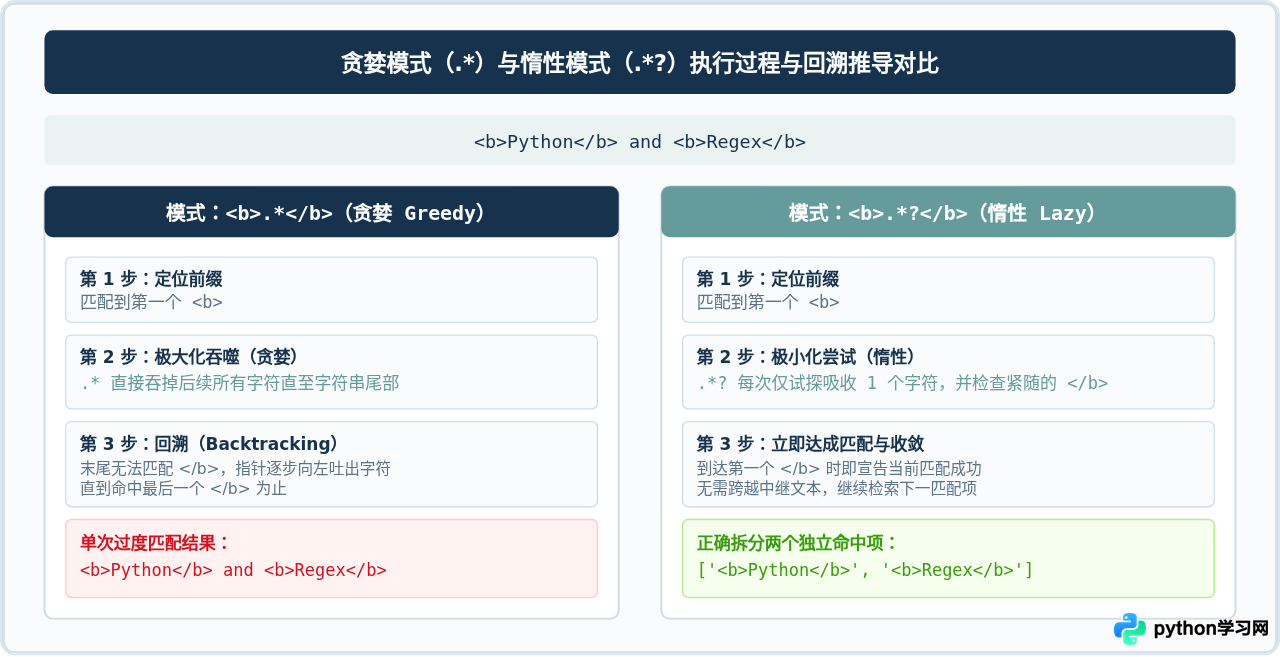
标准量词(*, +, ?, {m,n})在默认情况下均为贪婪(Greedy)模式:正则引擎在满足匹配条件的前提下,会尽可能多地吞入字符,直到后续模式无法匹配时再进行回溯(Backtracking)。
当在任何标准量词后面追加问号(如 *?, +?, ??, {m,n}?)时,量词切换为非贪婪(Lazy)模式:引擎优先尝试消耗最少数量的字符,只要后续模式满足就立即停止扩张。
实战代码示例:贪婪与非贪婪对比
import re

html_snippet = "<div>First Block</div><div>Second Block</div>"

# 贪婪匹配:.* 会一直匹配到最后一个 </div>
greedy_result = re.findall(r"<div>.*</div>", html_snippet)
print("贪婪匹配:", greedy_result)
# 示例输出: ['<div>First Block</div><div>Second Block</div>']

# 惰性匹配:.*? 遇到第一个 </div> 即完成一次匹配
lazy_result = re.findall(r"<div>.*?</div>", html_snippet)
print("惰性匹配:", lazy_result)
# 示例输出: ['<div>First Block</div>', '<div>Second Block</div>']

# 频次区间限制:校验连续 4 到 6 位数字
code_sample = "ID1: 123, ID2: 12345, ID3: 9876543"
valid_codes = re.findall(r"\b\d{4,6}\b", code_sample)
print("符合 4~6 位的数字:", valid_codes)
# 示例输出: ['12345']
三、锚点与位置边界(Anchors & Boundaries):定义“在哪里匹配”
与字符类不同,锚点元字符不消耗任何字符,它们被称为零宽断言(Zero-width Assertions)。锚点的核心职责是检查当前匹配位置是否满足特定的边界条件,例如是否处于行首、行尾或单词边界。
1. 常用锚点元字符清单
| 锚点 | 名称 | 默认行为(无标志) | re.MULTILINE (re.M) 行为 |
|---|---|---|---|
^ |
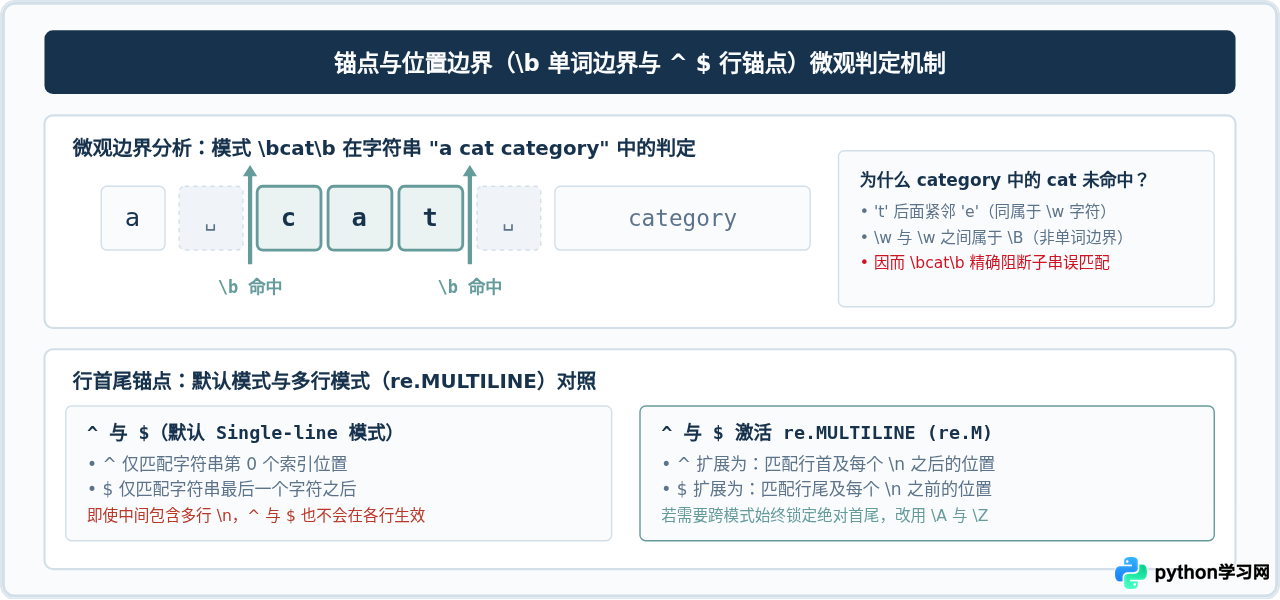
脱字符(行首锚点) | 仅匹配整个字符串的绝对起始位置 | 匹配整个字符串起始,以及每个换行符 \n 之后的位置 |
$ |
美元符(行尾锚点) | 仅匹配字符串末尾(或末尾换行前) | 匹配整个字符串末尾,以及每个换行符 \n 之前的位置 |
\A |
绝对字符首 | 始终仅匹配字符串绝对开头 | 不受 re.MULTILINE 影响,依然仅匹配整个字符串开头 |
\Z |
绝对字符尾 | 始终仅匹配字符串绝对结尾 | 不受 re.MULTILINE 影响,依然仅匹配整个字符串结尾 |
\b |
单词边界 | 匹配 \w 字符与 \W 字符之间的虚拟边界位置 |
同默认行为(与行切换无关) |
\B |
非单词边界 | 匹配两个 \w 或两个 \W 之间的内部位置 |
同默认行为 |
2. 单词边界 \b 的微观判定判定逻辑
许多初学者容易将 \b 误认为是空格或标点符号。实际上,\b 匹配的是一个无宽度的逻辑缝隙。只要缝隙的一侧是单词字符 \w(字母、数字、下划线),而另一侧是非单词字符 \W(包括空格、标点或字符串起始/结束),该位置就形成了一个合法的 \b 边界。
实战代码示例:锚点位置校验
import re

multiline_log = """2026-10-17 [INFO] System boot
2026-10-17 [ERROR] Connection timeout
2026-10-17 [INFO] Shutdown signal"""

# 默认模式下:^ 仅匹配首行开头
single_match = re.findall(r"^\d{4}-\d{2}-\d{2}", multiline_log)
print("单行模式匹配项数量:", len(single_match))
# 示例输出: 单行模式匹配项数量: 1

# 多行模式 (re.MULTILINE):^ 匹配每一行的行首
multi_match = re.findall(r"^\d{4}-\d{2}-\d{2}", multiline_log, re.MULTILINE)
print("多行模式匹配项数量:", len(multi_match))
# 示例输出: 多行模式匹配项数量: 3

# 单词边界 \b 精确匹配独立单词
raw_phrase = "The cat scattered the catalog."
isolated_cat = re.findall(r"\bcat\b", raw_phrase)
print("精确匹配独立单词 cat:", isolated_cat)
# 示例输出: 精确匹配独立单词 cat: ['cat']
四、三类元字符组合应用与速查总结
在实际生产工程中,正则表达式的威力往往建立在量词、锚点与字符类的协同组合上。例如在匹配标准变量标识符时,我们既要使用锚点锁定首尾防止部分匹配漏判,又要使用字符类区隔首字符与后续字符,最后借助量词约束总长度。
- 必须使用原始字符串(Raw String):始终书写
r"..."前缀,避免 Python 解释器在语法解析阶段吃掉反斜杠转义(如r"\b"避免被误解析为退格键)。 - 全文本校验必加首尾锚点:验证手机号、邮箱或身份证时,务必加
^...$或\A...\Z,否则13800000000abc仍能被子串匹配成功。 - 防御 ReDoS(正则拒绝服务):尽量避免“嵌套量词”(例如
(a+)+),在可能发生长回溯的场景优先采用非贪婪量词或改用显式排除字符集。
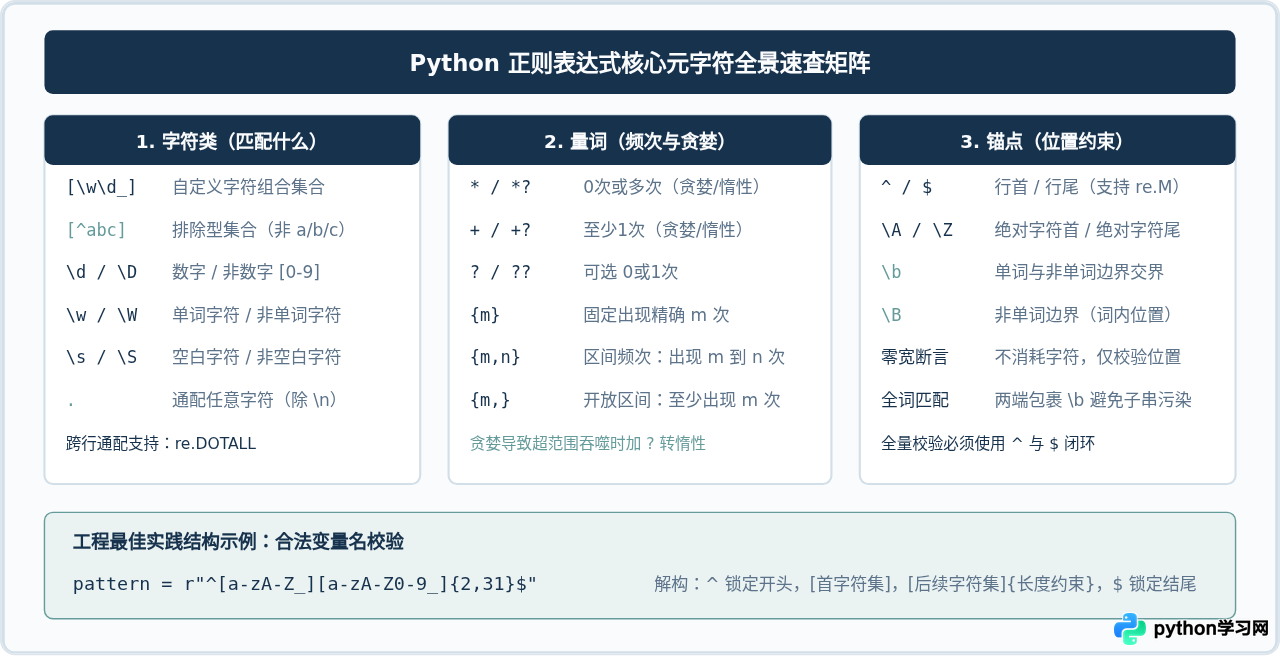
实战组合代码示例:典型校验与清洗
import re

# 1. 严格校验标识符名称:字母或下划线开头,后跟字母数字下划线,总长度 3-20
def validate_identifier(name: str) -> bool:
    pattern = r"^[a-zA-Z_][a-zA-Z0-9_]{2,19}$"
    return bool(re.match(pattern, name))

print("user_name_01 校验:", validate_identifier("user_name_01"))  # True
print("99_invalid 校验:", validate_identifier("99_invalid"))      # False (数字开头)
print("ab 校验:", validate_identifier("ab"))                      # False (长度小于3)

# 2. 提取文本中的独立合法 IPv4 地址
network_log = "Router at 192.168.1.1 connected. Mask 255.255.255.0, ErrCode 999.888.777.666"
# 通过单词边界 \b 防止多位数字截断匹配
ip_pattern = r"\b(?:(?:25[0-5]|2[0-4]\d|[01]?\d\d?)\.){3}(?:25[0-5]|2[0-4]\d|[01]?\d\d?)\b"
matched_ips = re.findall(ip_pattern, network_log)
print("提取的合法 IPv4 地址:", matched_ips)
# 示例输出: ['192.168.1.1', '255.255.255.0']
五、总结
熟练运用 Python 正则表达式的关键在于建立清晰的心智模型:
- 首先用字符类(
[...]、\d、\w、\s)精准划定每个位置允许出现的字符集合; - 再由量词(
*、+、?、{m,n})控制其重复模式,并在需要时追加?抑制过度吞噬; - 最后借助锚点(
^、$、\b)锁死匹配在整行或单词边界上的空间位置。
牢记使用原始字符串 r"..." 前缀,并在必要时组合 re.MULTILINE 与 re.DOTALL 标志位,即可应对绝大多数现实开发中的文本处理与清洗任务。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









