

Python中str与bytes怎么转换以处理中文

在 Python 3 中,处理中文字符的核心是明确区分内存中的抽象文本 str(Unicode 字符串)与物理存储及传输形态 bytes(字节序列)。将中文 str 转换为 bytes 称为编码,调用 str.encode(encoding) 方法;将 bytes 还原为中文 str 称为解码,调用 bytes.decode(encoding) 方法。处理中文时最常用的字符集标准是 UTF-8(通用行业标准,常用汉字占 3 个字节)与 GBK(Windows 历史遗留编码,汉字占 2 个字节)。确保两端编码协议完全一致,并合理配置容错参数,是彻底避免 UnicodeDecodeError 异常与乱码的关键。
一、str与bytes的本质差异与转换方向
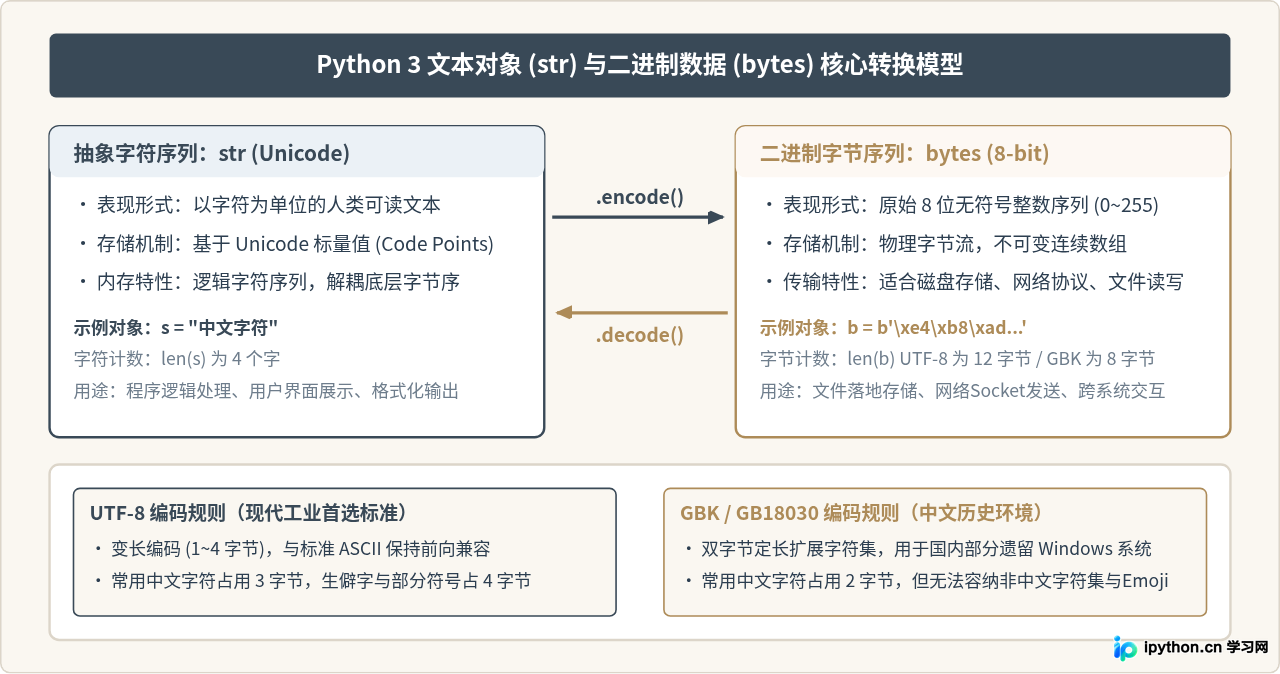
Python 3 对字符模型进行了彻底的类型分离。在底层机制上,str 与 bytes 代表着完全不同维度的计算机数据:
- str(文本字符串):以 Unicode 标量值(Code Points)形式存在于内存中,直接面向人类语言。每个汉字被视为一个独立的逻辑字符,
len("中国")的计算结果为 2。 - bytes(二进制字节流):不可变的 8 位无符号整数序列(每个字节取值范围为 0 到 255),直接面向磁盘存储、网络套接字以及底层驱动。中文字符在字节形态下会拆解为多个物理字节。
由于二者严格解耦,Python 3 不允许对它们进行隐式混用。例如直接执行 "数据" + b"bytes" 会立即抛出 TypeError: can only concatenate str (not "bytes") to str。必须通过显式调用 encode() 与 decode() 方法完成跨形态转换。
在中文场景下,编码规则直接决定了字节序列的长度和排列。以常用汉字“中”(Unicode 码点 U+4E2D)为例,在 UTF-8 编码下表示为 3 个字节 b'\xe4\xb8\xad',而在 GBK 编码下表示为 2 个字节 b'\xd6\xd0'。若编码与解码两端的标准不对应,就会破坏字节序列的边界,引发乱码或异常。
二、从str到bytes:中文字符编码的规范操作与参数
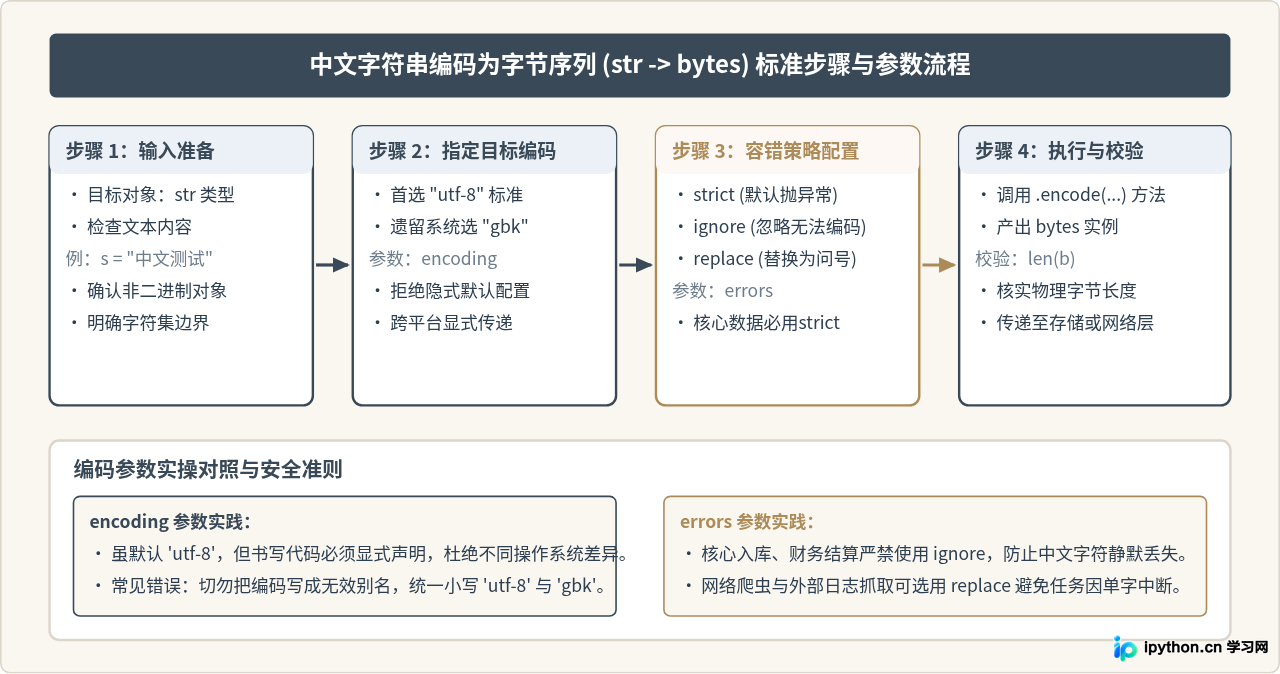
将 Python 字符串转换为字节序列时,使用字符串对象的 encode() 方法。该方法的规范定义如下:
str.encode(encoding="utf-8", errors="strict")1. 核心参数说明
- encoding:指定转换的目标字符编码标准。尽管现代 Python 默认采用
"utf-8",但在生产代码中始终推荐显式传入编码参数,避免跨操作系统平台时产生歧义。常用值包括"utf-8"、"gbk"、"gb18030"。 - errors:指定遇到非法或无法映射的字符时的处理策略:
"strict"(默认值):遇到无法编码的字符时直接抛出UnicodeEncodeError。核心数据库入库或金融级数据必须使用该策略。"ignore":静默跳过无法编码的字符,可能导致字词丢失。"replace":使用预设占位符(如 ASCII 问号?)替换非法字符。"xmlcharrefreplace":替换为 XML/HTML 数字字符实体引用(如Ӓ)。
2. 中文编码标准代码示例
以下示例展示了中文在不同编码格式下的转换表现及参数控制:
# -*- coding: utf-8 -*-

# 原始中文字符串
chinese_text = "Python中文编程"

# 1. 显式编码为 UTF-8 字节序列(推荐实践)
bytes_utf8 = chinese_text.encode("utf-8")
print("UTF-8 字节内容:", bytes_utf8)
print("UTF-8 字节长度:", len(bytes_utf8))  # 6个ASCII字母(6字节) + 4个汉字(12字节) = 18字节

# 2. 编码为 GBK 字节序列(兼容历史Windows系统)
bytes_gbk = chinese_text.encode("gbk")
print("GBK 字节内容:", bytes_gbk)
print("GBK 字节长度:", len(bytes_gbk))    # 6个ASCII字母(6字节) + 4个汉字(8字节) = 14字节

# 3. 容错参数 errors 的使用场景
# 汉字夹带生僻符号或 Emoji 表情
mixed_text = "中文指标 📈"

# GBK 不支持部分现代 Emoji,strict 模式会抛出异常
try:
    mixed_text.encode("gbk", errors="strict")
except UnicodeEncodeError as err:
    print("捕获严格模式编码异常:", err.reason)

# 使用 replace 参数安全降级,防止程序异常中断
safe_gbk = mixed_text.encode("gbk", errors="replace")
print("容错替换编码结果:", safe_gbk)避坑提示:绝对不能在代码中书写 b"中文" 形式的字节字面量。Python 的 bytes 字面量仅允许包含 ASCII 字符(ASCII 码值 0~127)。在源文件中书写 b"中文" 会在编译期直接抛出 SyntaxError: bytes can only contain ASCII literal characters。
三、从bytes到str:字节数据解码与乱码防范
当程序从网络接口、数据库或本地文件接收到二进制字节流时,必须将其解码还原为人类可读的字符串。调用字节对象的 decode() 方法完成此转换:
bytes.decode(encoding="utf-8", errors="strict")1. 乱码与解码异常的根源
中文字符出现乱码或抛出 UnicodeDecodeError,99% 的原因在于编码端与解码端采用了不兼容的字符集协议:
- GBK 字节被当作 UTF-8 解码:UTF-8 对多字节序列的前导字节有着严格的位模式规则(例如三字节汉字首字节高位必须为
1110xxxx)。GBK 编码的汉字首字节往往落在其他区间,解码器检测到非法字节序列时,会立即抛出UnicodeDecodeError: 'utf-8' codec can't decode byte 0xd6 in position 0: invalid start byte。 - UTF-8 字节被当作 GBK 解码:GBK 强制按双字节切分数据,这会导致 UTF-8 的三字节汉字被错误错位合并,解析出完全不相关的冷僻汉字或符号(例如“中文”变为“涓\xad鏂\x87”),产生典型的视觉乱码。
2. 解码操作与异常捕获示例
在实际工程中,解析未知外部数据时应实施严谨的异常处理与降级机制:
# 模拟接收到的外部字节数据(由 GBK 编码生成)
incoming_bytes = "系统操作日志".encode("gbk")

# 错误示范:假设外部数据为 UTF-8 编码
try:
    result = incoming_bytes.decode("utf-8")
except UnicodeDecodeError as exc:
    print("解码失败,字符集协议不匹配:", exc)

# 正确示范:使用一致的 GBK 编码进行解码
valid_text = incoming_bytes.decode("gbk")
print("成功解码文本:", valid_text)

# 场景:网络数据包偶发截断或混杂损坏字节
corrupted_stream = incoming_bytes + b"\xff\xfe"
# 在非关键日志场景下,使用 ignore 或 replace 避免服务崩溃
recovered_text = corrupted_stream.decode("gbk", errors="ignore")
print("容错忽略异常字节后还原:", recovered_text)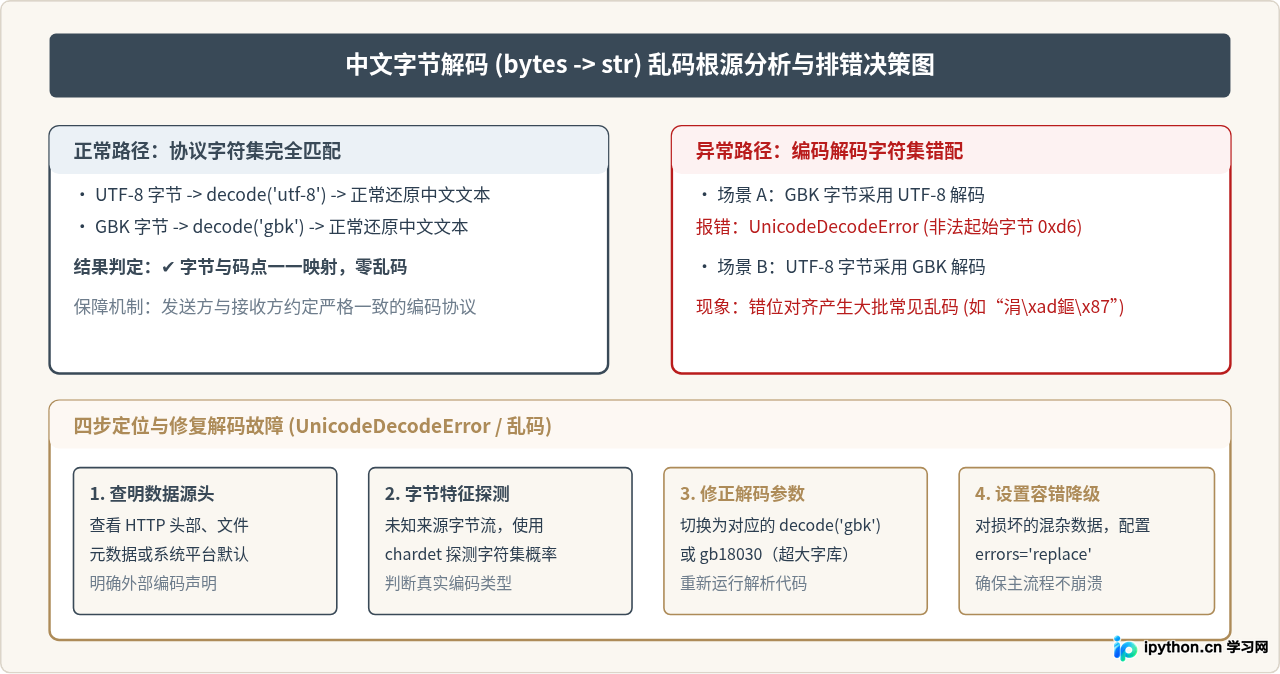
四、典型场景实战:文件操作与网络数据通信
理解了 str 与 bytes 的转换机制后,在实际开发中的常见场景便能游刃有余。
1. 文件读写场景中的转换
Python 的内置函数 open() 提供了文本模式与二进制模式两种处理路径:
- 文本模式(默认模式,如
mode="r"或mode="w"):读写对象为str。Python 底层会自动根据传入的encoding参数完成编码与解码。必须始终显式指定encoding="utf-8",因为在 Windows 系统上,默认编码常为平台相关的cp936(GBK),会导致跨平台文件共享时产生乱码。 - 二进制模式(如
mode="rb"或mode="wb"):读写对象必须为bytes。程序需要自主控制encode()与decode()的时机。
# 1. 文本模式写入:显式指定 encoding
with open("message.txt", mode="w", encoding="utf-8") as file:
    file.write("高质量中文内容存储")

# 2. 二进制模式写入:手动执行 encode
data_bytes = "底层二进制控制".encode("utf-8")
with open("data.bin", mode="wb") as bin_file:
    bin_file.write(data_bytes)

# 3. 二进制模式读取:手动执行 decode
with open("data.bin", mode="rb") as bin_file:
    raw_content = bin_file.read()
    text_content = raw_content.decode("utf-8")
    print("从二进制文件还原内容:", text_content)
2. 网络 Socket 与 HTTP 请求传输
计算机网络传输的物理载荷只能是二进制流。无论是通过 socket 库直接发送数据,还是处理底层 HTTP 请求体,都必须进行类型转换:
import socket

# 创建 TCP 客户端连接
client = socket.socket(socket.AF_INET, socket.SOCK_STREAM)

# 发送前:必须将中文提示信息转换为 bytes
request_payload = "GET_USER_INFO:张三".encode("utf-8")
# client.sendall(request_payload)

# 接收后:收到的数据为 bytes,必须 decode 为 str 才能进行字符串操作
raw_response = b"STATUS_OK:\xe5\xbc\xa0\xe4\xb8\x89"
clean_str = raw_response.decode("utf-8")
print("网络返回解码结果:", clean_str)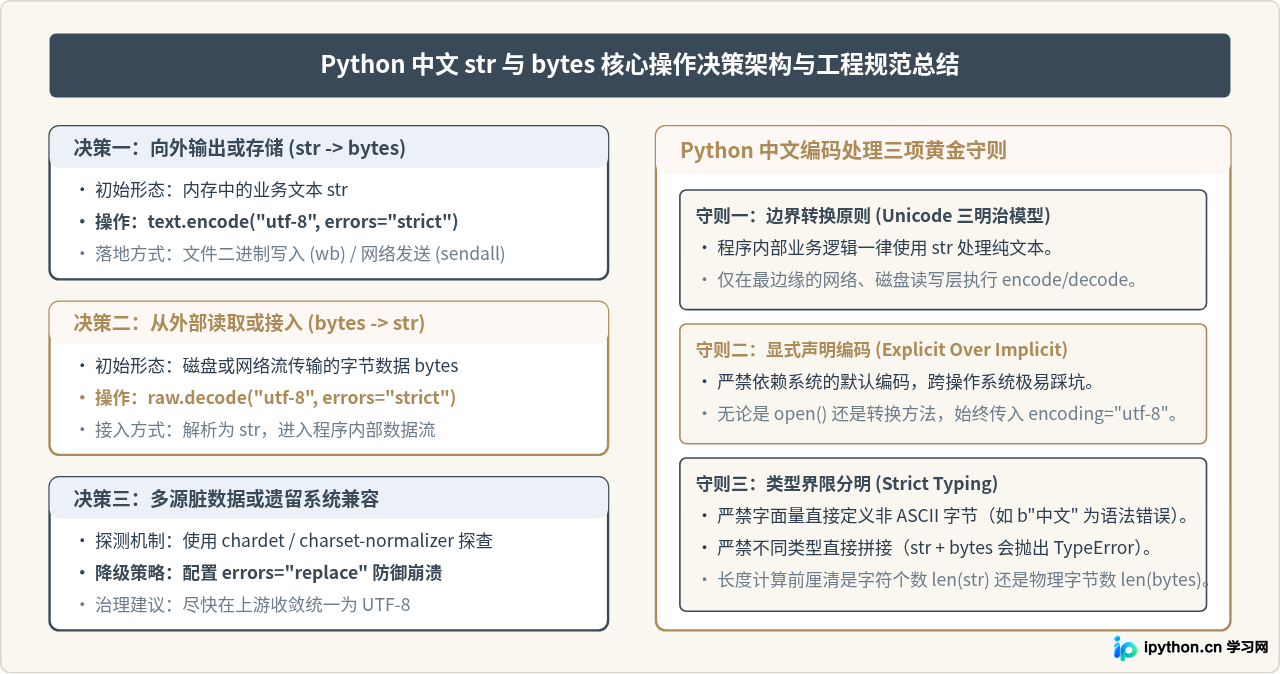
五、中文转换核心规范与总结
在日常 Python 工程开发中,处理中文 str 与 bytes 互转应当坚决贯彻以下三项工程规范:
- 坚持“Unicode 三明治”架构:将程序核心业务逻辑包裹在
str的纯净环境内,所有针对中文字符的截取、拼接、匹配全部使用str;仅在与外界交互的边界层(文件读写、网络 I/O、数据库通信)执行encode()和decode()。 - 永远显式声明 encoding:无论是使用
open()、str.encode()还是bytes.decode(),永远不要省略encoding="utf-8"参数。消除对宿主操作系统的默认编码依赖,是确保代码在 Linux、macOS 和 Windows 下完全一致的基石。 - 审慎选择错误处理策略:对生产数据库写入等关键业务数据,坚持使用默认的
errors="strict",确保数据失真时能够第一时间告警;对日志搜集、外部爬虫抓取等旁路业务,可采用errors="replace"保证整体流程的高可用与弹性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









