

怎么用scikit-learn1.6的validate_data替代私有方法?
本文详细讲解如何在 scikit-learn 1.6 中使用官方公开的 validate_data 方法替代内部私有 _validate_data,涵盖参数机制、状态生命周期、迁移步骤与合规测试。
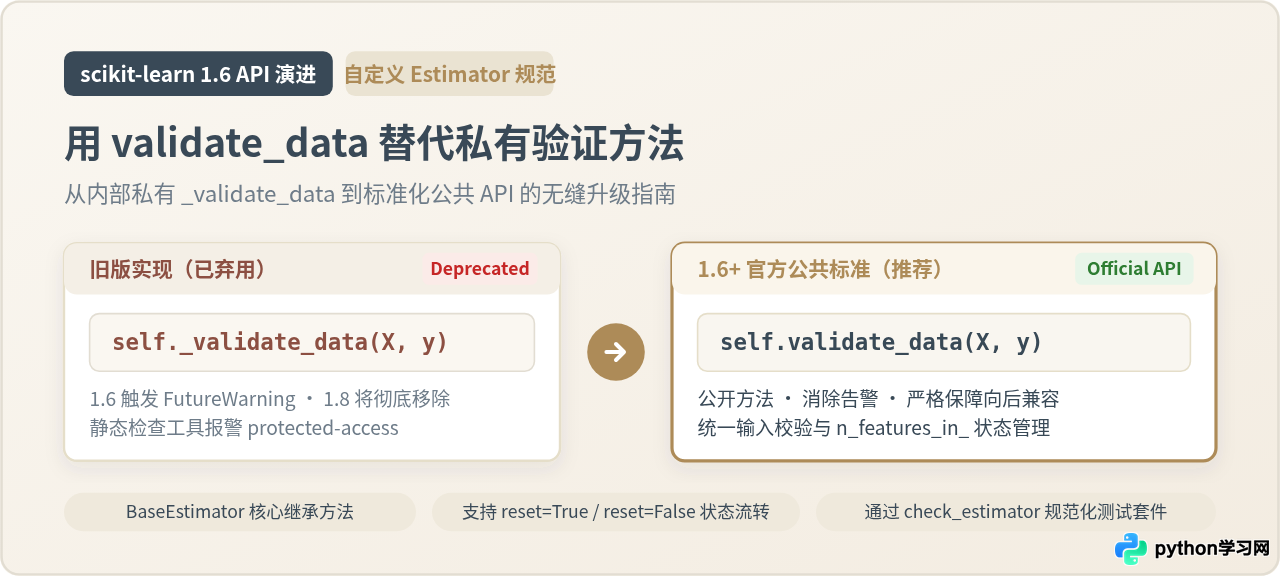
在编写继承自 BaseEstimator 的自定义估算器时,若调用带下划线的私有方法 self._validate_data,从 scikit-learn 1.6 开始会触发 FutureWarning 废弃警告。替代方案非常明确:直接将类内部的 self._validate_data 改写为官方正式公开的 self.validate_data。在 fit 方法中保留 reset=True 记录特征元信息,在 predict 或 transform 方法中设置 reset=False 执行维度一致性对比,即可在零警告前提下完成向官方标准的平滑迁移。
一、弃用背景:为什么需要替代私有方法?
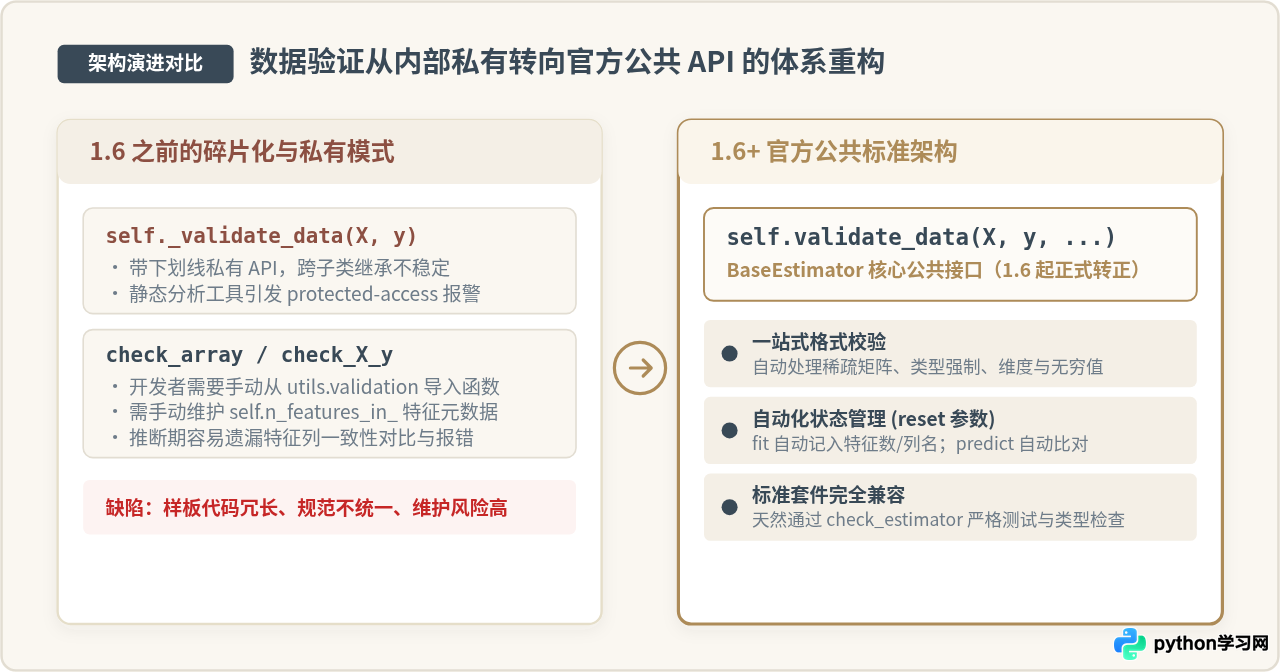
在 scikit-learn 过去的版本中,框架内部依赖 _validate_data 来统一处理 NumPy 数组、Pandas DataFrame 及 SciPy 稀疏矩阵的格式转换,并自动记录特征数量属性 n_features_in_ 与列名属性 feature_names_in_。由于该方法以单下划线开头,它在 Python 约定中被归类为保护方法或私有方法。
这给自定义估算器作者带来了长期困扰:使用私有方法会触发代码静态分析工具(如 Flake8、PyLint、Mypy)的 protected-access 访问告警;而如果不使用它,开发者就必须从 sklearn.utils.validation 手动导入 check_array 或 check_X_y,并自行编写样板代码来统计和比对特征维度。
从 scikit-learn 1.6 开始,社区正式响应了这一需求,将输入校验与状态维护职责标准化,将该方法公开为 BaseEstimator.validate_data。同时,原有的 _validate_data 进入弃用周期,预计将在 1.8 版本中彻底移除。
二、核心机制:validate_data 的工作原理与关键参数
validate_data 是定义在 sklearn.base.BaseEstimator 上的公共实例方法。任何继承自 BaseEstimator 的子类都可以直接通过 self.validate_data(...) 调用。
1. 方法签名与核心参数
该方法的完整调用签名如下:
self.validate_data(
    X="no_validation",
    y="no_validation",
    reset=True,
    validate_separately=False,
    **check_params
)| 参数名称 | 典型取值 | 参数职责与行为说明 |
|---|---|---|
X |
数组 / 矩阵 / DataFrame | 待校验的输入样本矩阵。若无需校验可保持默认 "no_validation"。 |
y |
一维数组 / 目标向量 | 监督学习的目标标签或连续响应值。若为无监督模型可忽略。 |
reset |
True / False |
最关键参数。True 会覆盖更新特征元数据;False 仅用于校验对比。 |
validate_separately |
False / (params_X, params_y) |
是否对 X 和 y 分别传入不同的校验字典(例如 X 需要 float64,y 需要 int)。 |
**check_params |
透传字典 | 透传给底层 check_array 的控制选项,例如 accept_sparse、ensure_2d。 |
2. reset 参数决定的双阶段状态生命周期
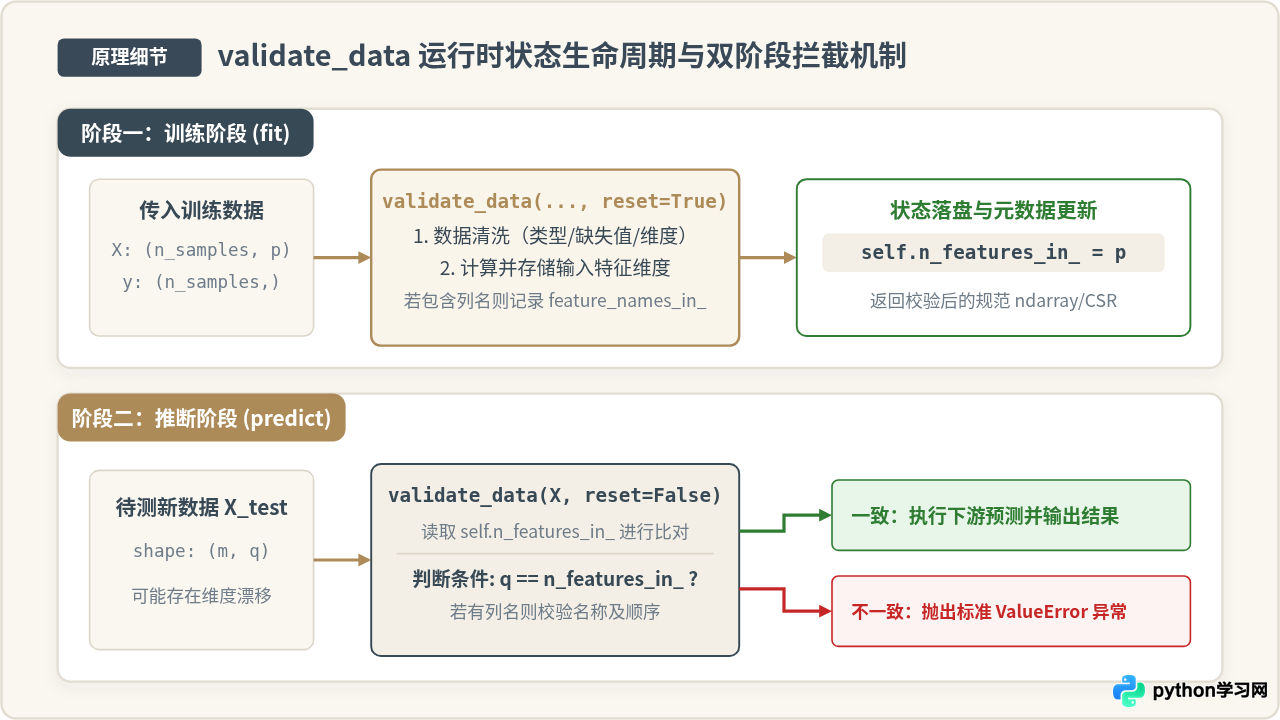
理解 reset 参数是正确使用 validate_data 的核心所在。它将估算器的数据处理清晰地划分为“训练”与“推断”两个互斥状态:
-
训练阶段 (
reset=True):在fit或fit_transform中调用。方法会检验数据合法性,同时在估算器实例上自动写入两个核心属性:记录输入特征维度的self.n_features_in_,以及当输入包含字段名时记录的self.feature_names_in_(NumPy 字符串数组)。 -
推断阶段 (
reset=False):在predict、predict_proba、transform或score中调用。此时模型已拟合完成,方法绝不修改已有的self.n_features_in_,而是将新传入的数据维度与拟合时记录的特征数严格比对。如果测试数据的特征列数不匹配,立即抛出标准异常。
三、迁移步骤:四步改造自定义 Estimator
将存量代码或开源库中的自定义算法改造为 1.6 规范写法,可以遵循以下四个明确步骤展开。
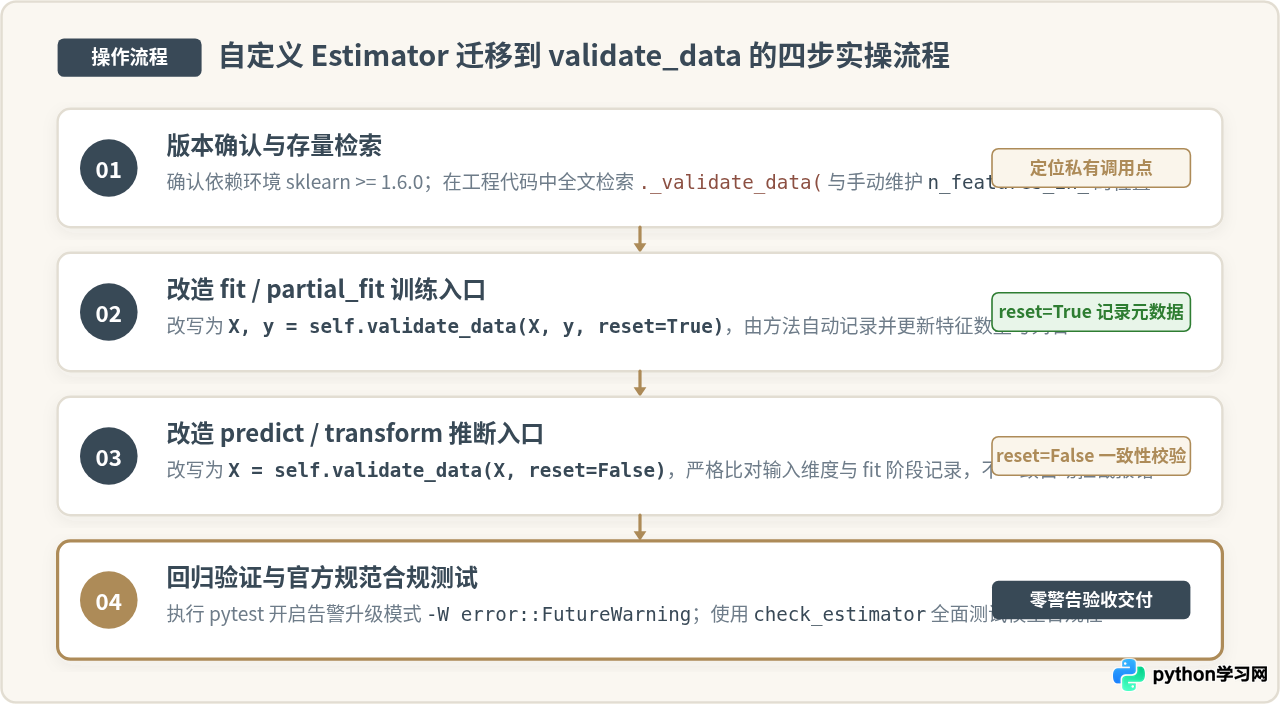
第 1 步:确认依赖版本并检索存量调用
首先通过终端命令检查当前虚拟环境中的 scikit-learn 版本,确保运行环境已升级至 1.6.0 或更高版本:
python -c "import sklearn; print(sklearn.__version__)"
随后在代码工程根目录下检索所有的私有调用点 _validate_data:
git grep -n "_validate_data"第 2 步:改造 fit 方法中的输入验证
在模型的 fit 入口处,将 self._validate_data 修改为 self.validate_data。由于这是学习训练阶段,必须保持 reset=True(默认值即为 True,显式写出可增强代码可读性)。
第 3 步:改造 predict 与 transform 中的推断验证
在预测、转换或评分方法中,同样将下划线移除,并必须显式指定 reset=False。这样可以确保模型能够准确检测特征维度漂移,防止脏数据进入后续数学运算。
第 4 步:完整代码对比示例
下面是一个基于中心距离的自定义最近均值分类器(Nearest Centroid),展示改造前后的完整代码对照:
from sklearn.base import BaseEstimator, ClassifierMixin
import numpy as np

class OldCustomClassifier(BaseEstimator, ClassifierMixin):
    def fit(self, X, y):
        # 1.6 环境下运行此行会触发 FutureWarning 警告
        X, y = self._validate_data(X, y, accept_sparse=False)
        self.classes_ = np.unique(y)
        self.centroids_ = np.array([X[y == c].mean(axis=0) for c in self.classes_])
        return self

    def predict(self, X):
        # 私有方法调用且需要手动设置 reset=False
        X = self._validate_data(X, reset=False)
        distances = np.linalg.norm(X[:, np.newaxis] - self.centroids_, axis=2)
return self.classes_[np.argmin(distances, axis=1)]from sklearn.base import BaseEstimator, ClassifierMixin
import numpy as np
class ModernCustomClassifier(BaseEstimator, ClassifierMixin):
# 符合 scikit-learn 1.6+ 规范的最近中心分类器示例
def fit(self, X, y):
# 1.6+ 正式公共 API:reset=True 自动更新 self.n_features_in_
X, y = self.validate_data(
X, y,
reset=True,
accept_sparse=False,
dtype=[np.float64, np.float32]
)
self.classes_ = np.unique(y)
self.centroids_ = np.array([X[y == c].mean(axis=0) for c in self.classes_])
return self
def predict(self, X):
# 预测阶段:reset=False 校验输入特征数是否与拟合阶段一致
X = self.validate_data(X, reset=False)
distances = np.linalg.norm(X[:, np.newaxis] - self.centroids_, axis=2)
return self.classes_[np.argmin(distances, axis=1)]四、向后兼容:兼顾旧版本环境的过渡方案
如果所维护的第三方库需要同时支持低于 1.6 的老旧环境(如 scikit-learn 1.3、1.4)和 1.6+ 新环境,可以在辅助工具模块中编写一个轻量兼容适配函数:
def compat_validate_data(estimator, *args, **kwargs):
    # 跨版本调用数据验证方法的安全适配器
    # 优先调用 1.6+ 公开方法 validate_data;
    # 若运行在旧版本中,则平稳回退至 _validate_data。
    if hasattr(estimator, "validate_data"):
        return estimator.validate_data(*args, **kwargs)
    return estimator._validate_data(*args, **kwargs)
在自定义 Estimator 内部直接调用 compat_validate_data(self, X, y, reset=True),即可在任意版本下正常运行且不产生废弃告警。
五、测试与验证:如何确认问题已彻底解决?
修改完成后,不应仅依靠肉眼检查,建议通过以下两种标准方式进行严谨验收:
1. 开启警告阻断运行单元测试
运行 pytest 时,配置参数将 FutureWarning 提升为致命错误。如果在迁移过程中存在遗漏的 _validate_data 调用,测试将直接报错并输出精确堆栈:
pytest tests/ -W error::FutureWarning==== 6 passed in 0.42s ====
2. 执行官方 check_estimator 规范性测试
scikit-learn 提供了权威的合规性测试套件 check_estimator。该套件会自动注入维度不匹配、非连续内存、NaN/Inf 以及带列名的 DataFrame 测试用例:
from sklearn.utils.estimator_checks import check_estimator

# 实例化待测估算器
clf = ModernCustomClassifier()

# 运行自动化测试,若符合规范则平稳执行完毕,无任何异常抛出
check_estimator(clf)
print("恭喜:自定义估算器完全符合 scikit-learn 官方规范!")六、总结与避坑要点
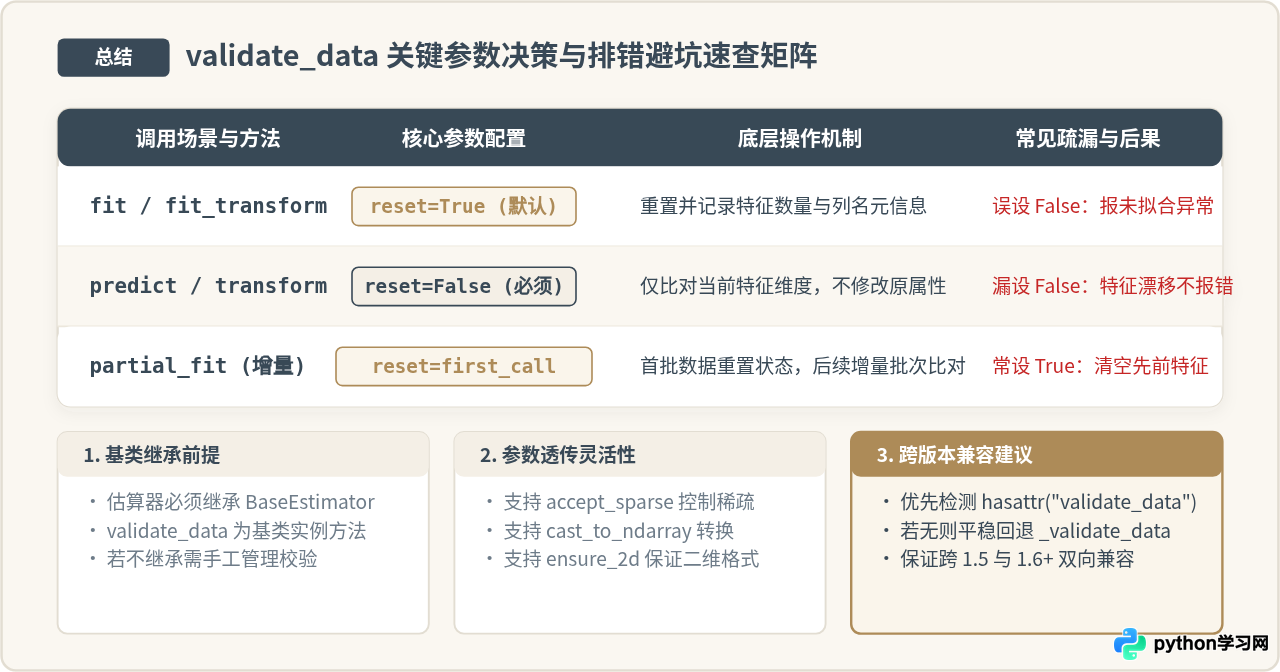
用 validate_data 替代私有验证方法不仅是为了消除告警,更让自定义算法融入了 scikit-learn 的标准生态。在日常编码与重构中,请重点注意以下三点:
-
必须继承自 BaseEstimator:
validate_data是面向对象的实例方法。如果自定义类没有继承BaseEstimator,直接调用self.validate_data会导致AttributeError。非继承类如需校验,应从sklearn.utils.validation中直接使用check_array。 -
切勿在 predict 中遗漏 reset=False:若在
predict中未传递reset=False(默认值会重置状态),传入形状异常的测试数据将无法被拦截,且会意外改写n_features_in_,破坏模型的特征记忆。 -
增量学习 partial_fit 的状态重置:对于支持流式更新的模型,仅在首次调用时设置
reset=True,从第二次调用起必须切换为reset=False,以防止已有模型权重与新输入特征空间发生错位。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









