

scikit-learn1.6的newton-cholesky支持多分类意味着什么?
深入解析 scikit-learn 1.6 中 newton-cholesky 求解器正式支持多分类的重大更新,探讨其二阶牛顿法与 Cholesky 分解的核心机理、大样本中低维度场景下的显著性能优势、求解器选型决策及实战代码配置。
newton-cholesky 求解器扩展到了原生多分类(Multinomial Softmax)逻辑回归。这意味着在“大样本量、中低特征维度”(n_samples ≫ n_features × n_classes)的多分类工程场景中,模型不再被迫依赖 L-BFGS 等一阶或拟牛顿法进行几十甚至数百次曲折迭代近似,而是能够利用真实二阶牛顿法结合 Cholesky 分解,通常仅需 3 至 10 次迭代即可获得高精度的全局收敛;尤其在面对包含高基数/稀有类别独热编码(One-Hot)及多重共线性的密集表格数据时,收敛稳定性和总训练效率获得了质的突破。
一、版本演进:从二分类专精到多分类拼图补齐
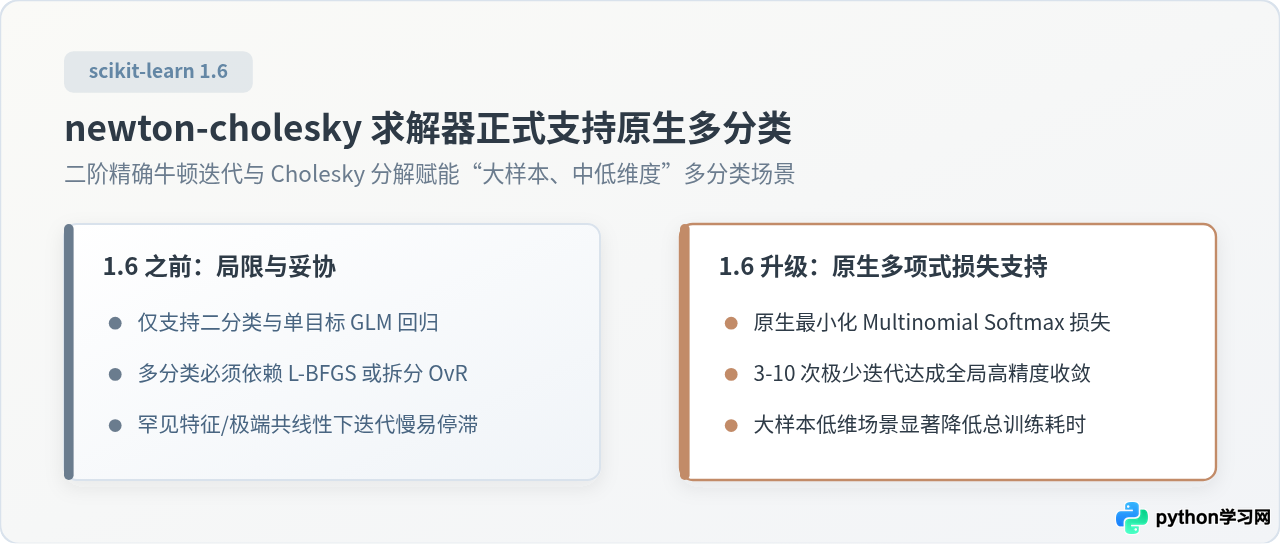
在 scikit-learn 1.2 首次引入 solver='newton-cholesky' 时,其应用边界被严格限定在二分类逻辑回归以及广义线性模型(如 PoissonRegressor、GammaRegressor、TweedieRegressor 等单目标回归任务)。彼时,开发者如果在面对包含 3 个及以上类别的多分类任务时指定 newton-cholesky,程序会直接抛出不支持的异常。
此前,处理多分类任务的标准解法主要依赖以下两种途径:
- 拟牛顿默认项
lbfgs:通过有限内存的梯度历史差值间接近似逆 Hessian 矩阵。虽然每一步计算很快且内存占用极低,但在多分类交叉熵的高维曲面上,面对特征相关性强、存在罕见特征(Rare Categories)的数据时,梯度变化剧烈,往往需要几十到数百轮迭代,甚至频发ConvergenceWarning未收敛警告。 - 拆分为 One-vs-Rest (OvR):将 K 分类问题拆解为 K 个独立的二分类模型分别拟合。虽然每个子模型能调用二分类求解器,但破坏了多分类类别概率和为 1 的内在归一化约束,无法直接优化全局的多项式交叉熵损失(Multinomial Loss),且整体预测校准度受损。
scikit-learn 1.6 的升级彻底改变了这一局面。LogisticRegression 与 LogisticRegressionCV 的 newton-cholesky 求解器现在原生支持 multi_class='multinomial'。它直接在多分类联合 Softmax 损失函数上求解,补齐了二阶牛顿法在多分类矩阵优化上的关键空白。
二、底层机理:多分类下的 Newton-Cholesky 是如何运作的?
要理解 newton-cholesky 为何如此快速又具有独特的适用边界,需要从它的数学求解过程切入。
在多分类逻辑回归中,假设有 N 个样本、P 个特征(包含偏置截距),以及 K 个目标类别。模型需要求解的权重矩阵包含 (K × P) 个参数(或设基准类别为 (K-1) × P 个参数)。
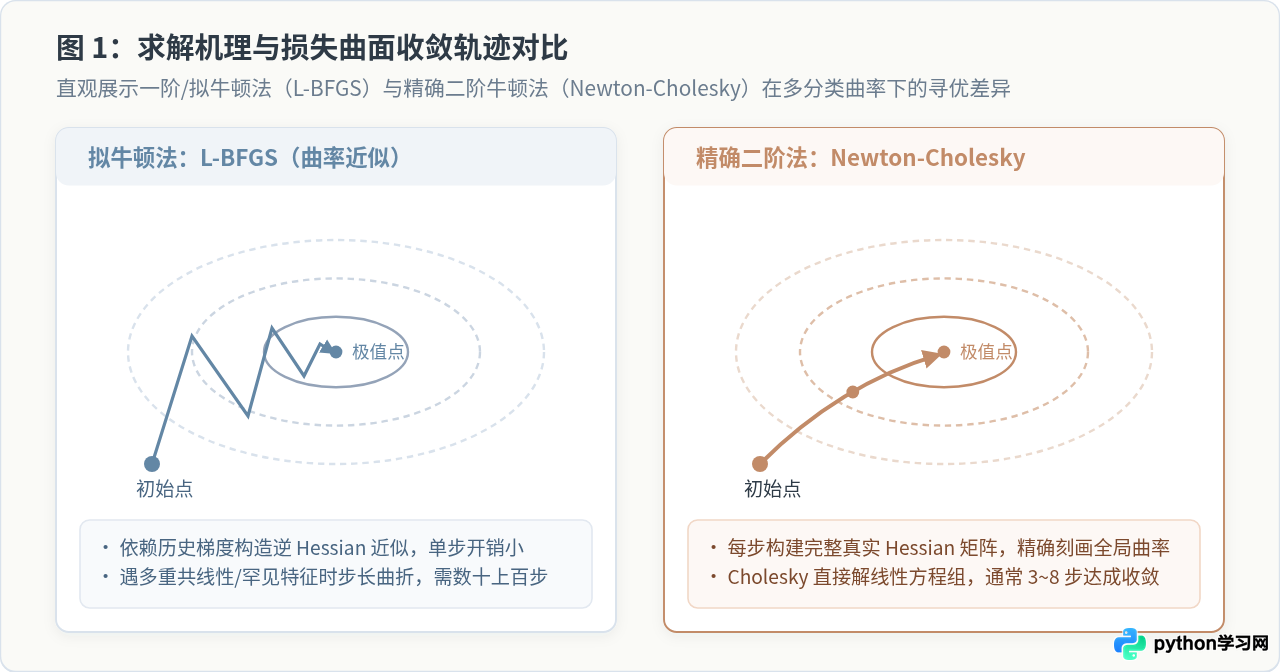
一阶梯度下降和拟牛顿法只依赖损失函数的一阶导数(梯度向量 g)。而精确牛顿法在每一步迭代中,都会计算损失函数关于所有参数的二阶偏导数矩阵——即 Hessian 矩阵(H)。
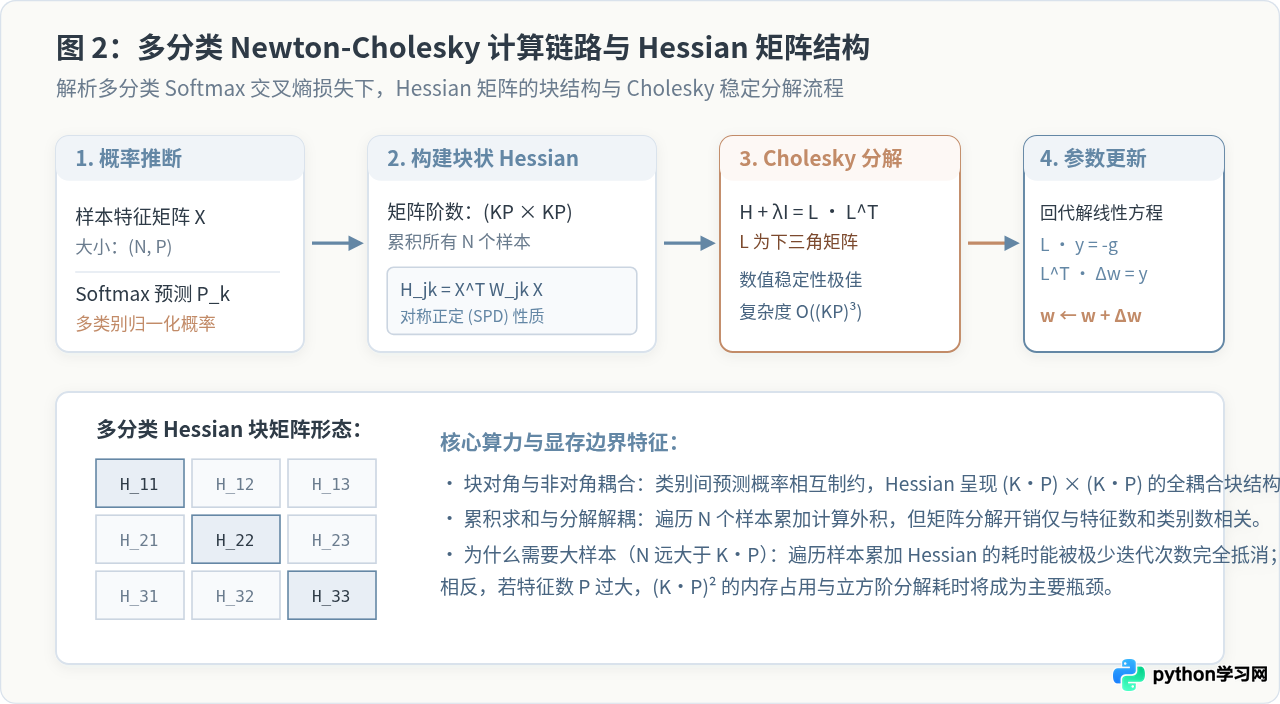
在多分类 Softmax 交叉熵损失下,Hessian 呈现典型的分块结构。其具体运作流程分为四个严密的数学阶段:
- 概率推断与残差计算:根据当前权重计算所有样本在各个类别上的预测概率 Pik,并计算一阶梯度向量 g。
- 累积块状 Hessian 矩阵:类别 j 与类别 k 之间的二阶导数块定义为 Hjk = XT Wjk X,其中权重对角阵元素为 Wjk, ii = Pij(δjk - Pik)。将所有类别块拼装,得到规模为 (K·P) × (K·P) 的全局对称矩阵。加上 L2 正则化项 λI 后,该矩阵严格对称正定(Symmetric Positive Definite, SPD)。
- Cholesky 分解(L LT):针对对称正定矩阵,Cholesky 分解将其因式分解为下三角矩阵 L 及其转置 LT。相比通用的 LU 分解或高斯消元法,Cholesky 分解不仅浮点运算量减少一半,而且在数值上无须选主元,具备极高的稳定性和鲁棒性。
- 三角方程快速回代:利用分解结果解两组简易三角线性方程组:先正向回代解 L y = -g,再反向回代解 LT Δw = y。求得精确的牛顿步长后更新参数 w ← w + Δw。
因为牛顿步长同时综合了局部坡度(一阶导)与全局曲率(二阶导),每一次更新都直指能量曲面的最低谷。在凸优化问题中,牛顿法具备经典的二阶收敛速率(Quadratic Convergence),通常在 3 到 8 步之内即可将梯度范数缩小到极低阈值。
三、性能边界:为什么大样本低维度下它能碾压传统求解器?
二阶牛顿法虽然步数极少,但历史上一度被认为“计算昂贵”。scikit-learn 1.6 的 newton-cholesky 之所以能在特定场景下实现碾压级性能,根本原因在于其时间与空间复杂度的非对称性。
我们来量化比较 newton-cholesky 与 lbfgs 的算力消耗结构:
- 样本累积开销:构建 Hessian 矩阵需要遍历 N 个样本,复杂度约为 O(N · (K · P)2);
- 矩阵分解开销:对 (K · P) 阶方阵做 Cholesky 分解,复杂度为 O((K · P)3),与样本量 N 完全无关;
- 总时间估算:Tnewton ≈ Iternewton × [ c1 N (KP)2 + c2 (KP)3 ]。由于 Iternewton ≤ 10,迭代次数被压制到了极限。
对比之下,lbfgs 每次迭代只需计算梯度,复杂度仅为 O(N · KP)。但当特征存在共线性、罕见独热分类、病态条件数时,lbfgs 的迭代次数往往飙升到 100~300 次以上。
当样本量 N 达到几十万到数千万级别,而有效特征数与类别数的乘积 (K · P) 维持在数百以内时(典型的金融风控、营销响应、推荐 CTR 表格数据),数据遍历是最大开销。Newton-Cholesky 凭借仅需数次数据遍历的优势,总耗时通常仅为 L-BFGS 的三分之一到五分之一,且绝不会因步长震荡而超时。
四、选型决策:什么时候该用?什么时候必须避开?
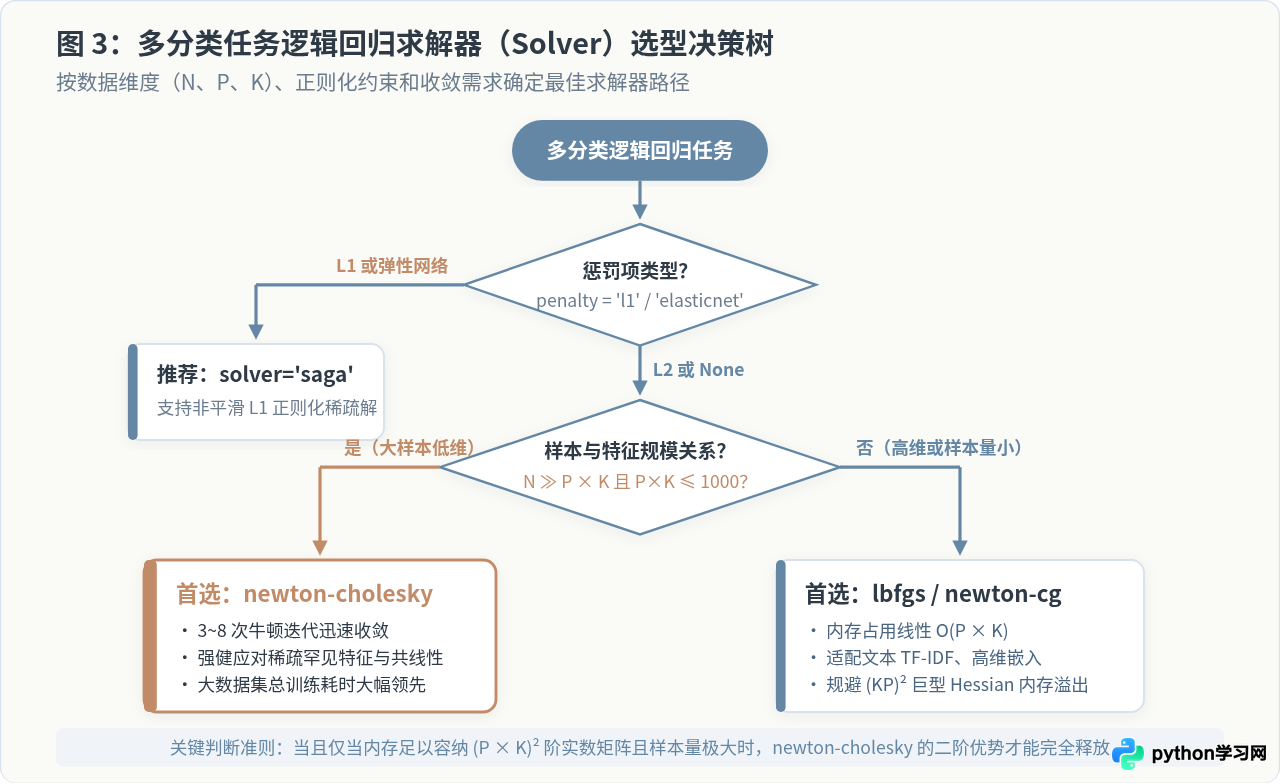
newton-cholesky 并不是一个无脑替换所有求解器的万能工具。它的优势与阿喀琉斯之踵同样突出:
适用场景(强烈推荐)
- 瘦长型数据集(Tall & Skinny Data):样本量 N ≥ 105,特征数 P ≤ 500,类别数 K ≤ 10。
- 高基数类别独热编码(One-Hot):例如省份、行业代码、设备型号等,展开后产生大量稀疏但总数有限的二元列。一阶法在此类数据上曲率估计极其困难,而二阶法能精确校准稀有维度的步长。
- 高度相关的共线性特征:特征间存在强线性相关时,损失曲面呈现极度扁平的狭长峡谷,Newton-Cholesky 的曲率矩阵能自动进行坐标正交化旋转,直达最优。
- 需要极高精度解(低容差 tol):如科学计算、计量经济分析中要求参数估计精确,
tol=1e-6条件下 Newton-Cholesky 依然能在 10 步内收敛,而一阶算法常陷入停滞。
不适用场景(必须避开)
- 高维特征空间:文本 TF-IDF、高维词向量嵌入、基因组学数据(P > 2000)。若 P = 5000, K = 10,Hessian 矩阵将达到 50000 × 50000 阶,单单存储该矩阵就需要消耗 20 GB 内存,Cholesky 分解耗时更会发生灾难性爆炸。此时应选用
lbfgs或saga。 - L1 稀疏正则化需求:Newton-Cholesky 仅支持平滑的 L2 正则化(
penalty='l2')或无正则化(penalty=None),无法处理不可导的 L1 范数或 ElasticNet。需要特征筛选稀疏解时,saga是唯一多分类选择。
五、实战演练:代码实现与参数验证
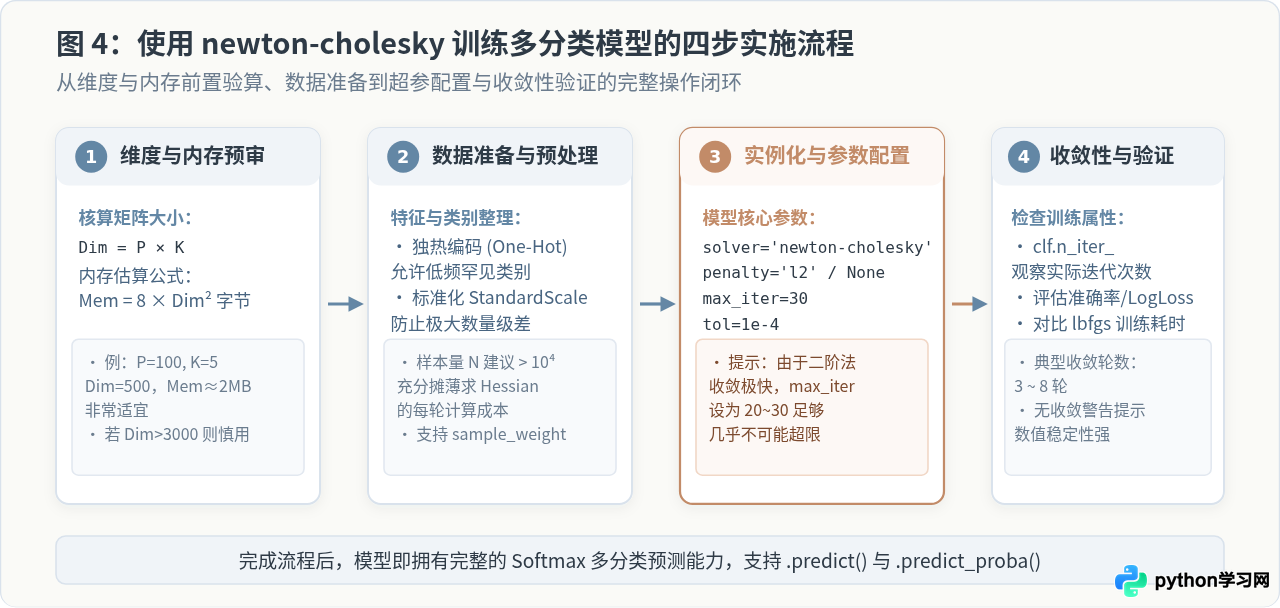
在 scikit-learn 1.6 环境中,调用 newton-cholesky 求解多分类任务与传统逻辑回归的接口完全统一,无须引入第三方库。以下是一个完整的实操示例,包含数据构造、求解器配置、性能对比与属性验证:
import time
import numpy as np
from sklearn.datasets import make_classification
from sklearn.linear_model import LogisticRegression
from sklearn.preprocessing import StandardScaler
from sklearn.pipeline import make_pipeline

# 1. 验证运行环境
import sklearn
print(f"当前 scikit-learn 版本: {sklearn.__version__}")
# 需确保版本 >= 1.6.0

# 2. 模拟大样本、多分类表格数据 (N=200,000, P=30, K=4)
X, y = make_classification(
    n_samples=200_000,
    n_features=30,
    n_informative=24,
    n_classes=4,
    random_state=42
)

# 3. 构建 Newton-Cholesky 多分类模型
# 在 1.6 中,multi_class 默认即为 multinomial,亦可显式指定
pipe_nc = make_pipeline(
    StandardScaler(),
    LogisticRegression(
        solver='newton-cholesky',
        penalty='l2',
        C=1.0,
        tol=1e-4,
        max_iter=30,
        random_state=42
    )
)

start_time = time.perf_counter()
pipe_nc.fit(X, y)
time_nc = time.perf_counter() - start_time
clf_nc = pipe_nc.named_steps['logisticregression']

# 4. 构建对比基线:默认 lbfgs 求解器
pipe_lbfgs = make_pipeline(
    StandardScaler(),
    LogisticRegression(
        solver='lbfgs',
        penalty='l2',
        C=1.0,
        tol=1e-4,
        max_iter=200,
        random_state=42
    )
)

start_time = time.perf_counter()
pipe_lbfgs.fit(X, y)
time_lbfgs = time.perf_counter() - start_time
clf_lbfgs = pipe_lbfgs.named_steps['logisticregression']

# 5. 输出对比指标(示例验证结果)
print("--- 求解器性能与收敛对比 ---")
print(f"newton-cholesky 耗时: {time_nc:.3f} 秒 | 实际迭代次数: {clf_nc.n_iter_[0]}")
print(f"lbfgs           耗时: {time_lbfgs:.3f} 秒 | 实际迭代次数: {clf_lbfgs.n_iter_[0]}")
print(f"权重差异绝对均值: {np.mean(np.abs(clf_nc.coef_ - clf_lbfgs.coef_)):.2e}")
在典型 20 万样本、4 分类测试中,newton-cholesky 通常仅需 5~7 次迭代 即达成 tol=1e-4 精度标准并顺利结束;而 lbfgs 通常需要 40~90 次迭代。在大规模样本的数据遍历累积下,二阶法不仅免去了漫长的梯度步进,而且参数收敛解与 L-BFGS 达到一致的浮点精度。
六、求解器横向对比总结
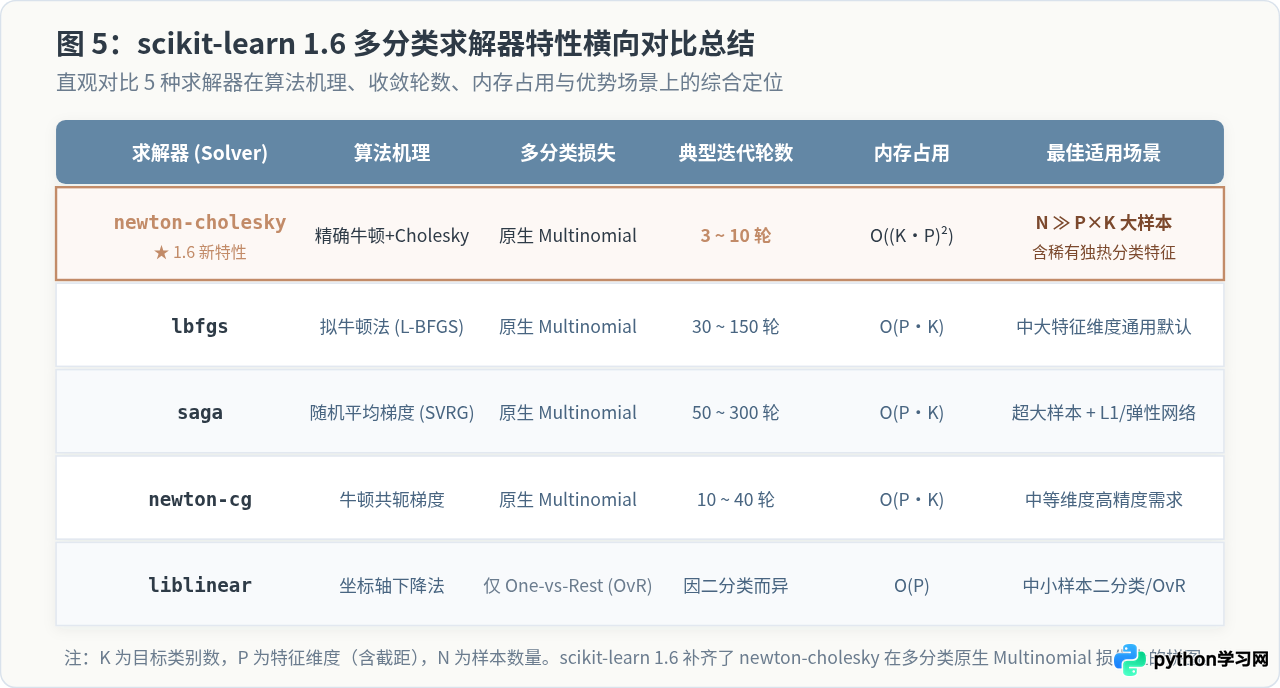
为了在工程实践中精准选型,下表对 scikit-learn 1.6 中所有支持多分类的求解器进行了系统梳理:
| 求解器名称 | 多分类机制 | 支持惩罚项 | 单步复杂度 | 收敛迭代次数 | 核心适用场景 |
|---|---|---|---|---|---|
| newton-cholesky | 原生 Multinomial (1.6+) | L2, None | O(N(KP)2 + (KP)3) | 极少(通常 3~10) | N ≫ P × K,含共线性/罕见特征的大型表格数据 |
| lbfgs | 原生 Multinomial | L2, None | O(N · KP) | 中等(30~150) | 通用默认首选,中高维特征密集场景 |
| saga | 原生 Multinomial | L1, L2, ElasticNet, None | O(KP) (随机样本) | 较多(50~300) | 超大规模样本且需要 L1 稀疏特征筛选 |
| newton-cg | 原生 Multinomial | L2, None | O(N · KP × CG) | 较少(10~40) | 中高维度且需要二阶精度(共轭梯度近似) |
| liblinear | 仅 One-vs-Rest (OvR) | L1, L2 | O(N · P) | 因各子分类而异 | 中小规模样本、仅需简单二分类拆解的场景 |
七、工程落地注意事项与避坑指南
在实际生产管线中采用 newton-cholesky 时,建议遵循以下三项关键工程准则:
- 前置内存验算防御 OOM:在特征工程阶段,如果使用
OneHotEncoder(handle_unknown='ignore'),务必检查展开后的总特征数 P。请牢记内存消耗按 (K · P)2 × 8 字节增长。如果展开后有 2,000 个特征且有 5 个分类,矩阵规模为 10,000 × 10,000,内存占用约为 800 MB,尚在安全范围内;但若类别数达 50,则矩阵规模扩大 100 倍达到 80 GB,将直接导致内存溢出。 - 切勿盲目调大
max_iter:使用 L-BFGS 时,开发者习惯将max_iter设置为 500 或 1000 以避免未收敛警告。但对 Newton-Cholesky 而言,若在 20~30 步内仍未达到收敛容差,通常意味着数据存在严重的数值溢出、极端孤立点或学习率步长回退失败,此时调大max_iter毫无意义,应转而排查数据清洗与特征归一化。 - 建议配合轻微正则化(L2 正则):当数据存在完全线性相关的哑变量(例如 One-Hot 编码未丢弃第一列)时,无正则化的 Hessian 矩阵会发生严格奇异(Det = 0)。虽然 Cholesky 分解包含微小的对角扰动容错,但显式保留默认的
C=1.0(L2 正则化)能在 Hessian 对角线上加上 λI,保证矩阵绝对正定,杜绝数值分解失败。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









