

Python列表去重方法性能对比:set、循环与Pandas
深入对比Python列表去重中set、循环与Pandas三大方案的性能差异与机制边界。涵盖算法复杂度、元素保序性、内存开销及不同数据规模下的选型指南。
在 Python 开发中,对列表进行去重是一项极为频繁的基础操作。本文直接给出核心结论与选型指南:若不要求保留原始元素顺序,list(set(lst)) 是执行速度最快、内存开销最小的通用方案;若必须严格保持原有出现次序,Python 3.7+ 下首选内置字典方法 list(dict.fromkeys(lst));若业务本身已处于 Pandas 数据处理流中,使用 pd.Series(lst).drop_duplicates().tolist() 组织代码最顺畅,但纯列表场景下因 C 结构体封装存在固有的初始化开销;而朴素的双重循环或 if x not in seen_list 在数据规模上升时会退化为 $O(N^2)$ 灾难,应避免在生产环境中使用。
一、三大主流去重方法的实现与底层机制
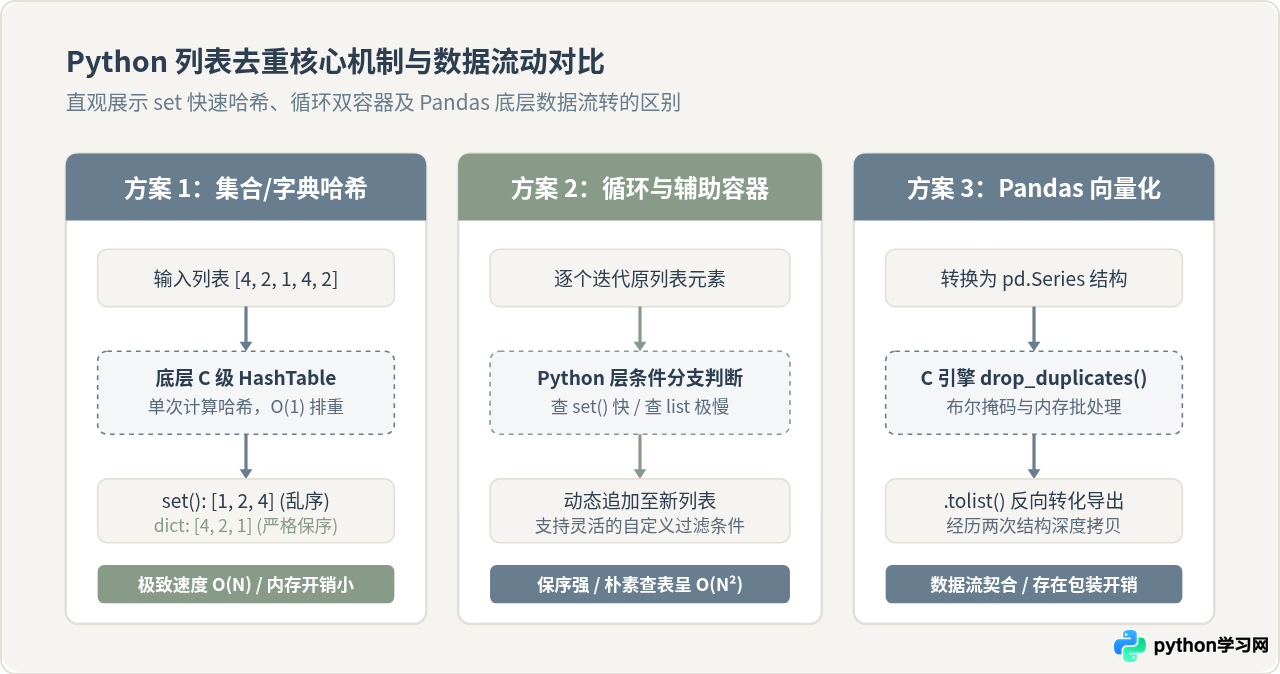
不同去重方法在代码行数上的差异并不大,但底层的内部数据结构与查找逻辑有着本质区别。理解其工作机制是做出合理性能评估的前提。
1. 集合去重:set 与 dict.fromkeys
集合(Set)与字典(Dict)底层均基于开地址法哈希表(Hash Table)实现。对列表元素计算哈希值后,能够以平均 $O(1)$ 的时间复杂度完成重复性检测。
# 1. 经典 set 去重(不保证顺序)
raw_list = [4, 2, 1, 3, 2, 4, 5]
unique_set = list(set(raw_list))

# 2. dict.fromkeys 去重(严格保持首次出现顺序)
unique_dict = list(dict.fromkeys(raw_list))需要说明的是,set() 在构建过程中仅维护哈希桶,转换回列表时元素的排列取决于哈希分布与存储槽位,因此原有顺序会被打乱。而 dict.fromkeys() 利用了 Python 3.7+ 字典保证插入顺序的语言特性,只保留键首次插入时的先后次序,且内部由底层 C 代码高度优化,无需额外的 Python 解释器循环。
2. 循环遍历:朴素查找与辅助哈希容器
通过循环进行去重主要有两种写法:一种是直接在结果列表中调用 in 进行线性扫描,另一种是引入辅助集合记录已遍历过的元素。
# 方式 A:朴素列表循环(时间复杂度 O(N^2),低效)
result_a = []
for item in raw_list:
    if item not in result_a:
        result_a.append(item)

# 方式 B:辅助集合循环(时间复杂度 O(N),保序且高效)
result_b = []
seen = set()
for item in raw_list:
    if item not in seen:
        seen.add(item)
        result_b.append(item)
方式 A 中 item not in result_a 每次都要对 result_a 进行线性遍历,随着唯一元素增多,总比较次数逼近 $N \times U / 2$($U$ 为唯一元素数),在大列表下耗时极长。方式 B 借助 seen 集合将单次查找降为 $O(1)$,兼顾了保序性与高效性,且允许在循环体内编写复杂的过滤判断。
3. Pandas 向量化:pd.Series.drop_duplicates
数据分析工作中,列表常作为数据列的前置形式。通过将列表构造为 pd.Series 并调用内置方法可完成去重:
import pandas as pd

# Pandas 向量化去重
series_data = pd.Series(raw_list)
unique_pandas = series_data.drop_duplicates().tolist()
Pandas 在底层调用 C/Cython 编写的哈希算法,针对连续内存数组有非常高的查重吞吐量。但该方法在纯 Python 列表场景下存在“对象拆装箱”成本:需要将 Python 引用列表拷贝转化为底层 Series 结构,去重完毕后再通过 .tolist() 还原为 Python 列表,这带来了不可忽视的常数级开销。
二、关键特性与技术边界深度对照
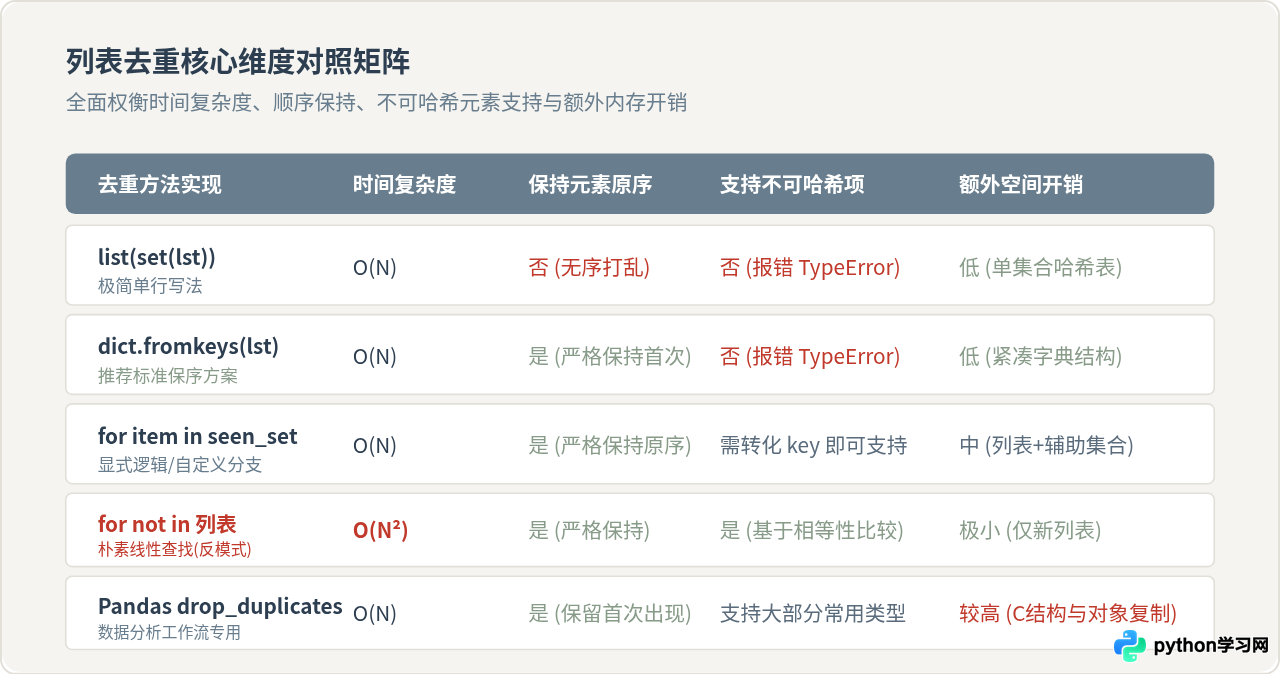
在性能测试之前,必须先理清各方法在功能特性上的约束边界。不能只根据“谁更快”来选型,因为某些方法在特定场景下根本无法正常运行。
1. 元素可哈希性(Hashability)约束
集合和字典必须能够计算元素的散列值(即调用 hash(x))。这意味着列表中只能包含整数、浮点数、字符串、元组等不可变(Immutable)类型。若列表中包含字典(dict)或嵌套列表(list),调用 set() 或 dict.fromkeys() 会直接抛出 TypeError: unhashable type: 'dict'。
此时若要排重,只能采用循环方式进行逐项对比,或者在循环中先将字典序列化(如转为 JSON 字符串或排序元组)后再存入辅助集合中进行查重。
2. 顺序保持机制(Order Preservation)
在许多业务流程中,列表顺序代表了时间流、优先级或流水线次序。set() 无法保证输出顺序,每次重排后的顺序甚至可能随解释器哈希加盐(Hash Seed Randomization)而变动。如果业务要求“保留首次出现的次序”,则必须排除 set(),转而选用 dict.fromkeys() 或循环辅助集合。
三、实测性能基准:从微观开销到海量数据分化
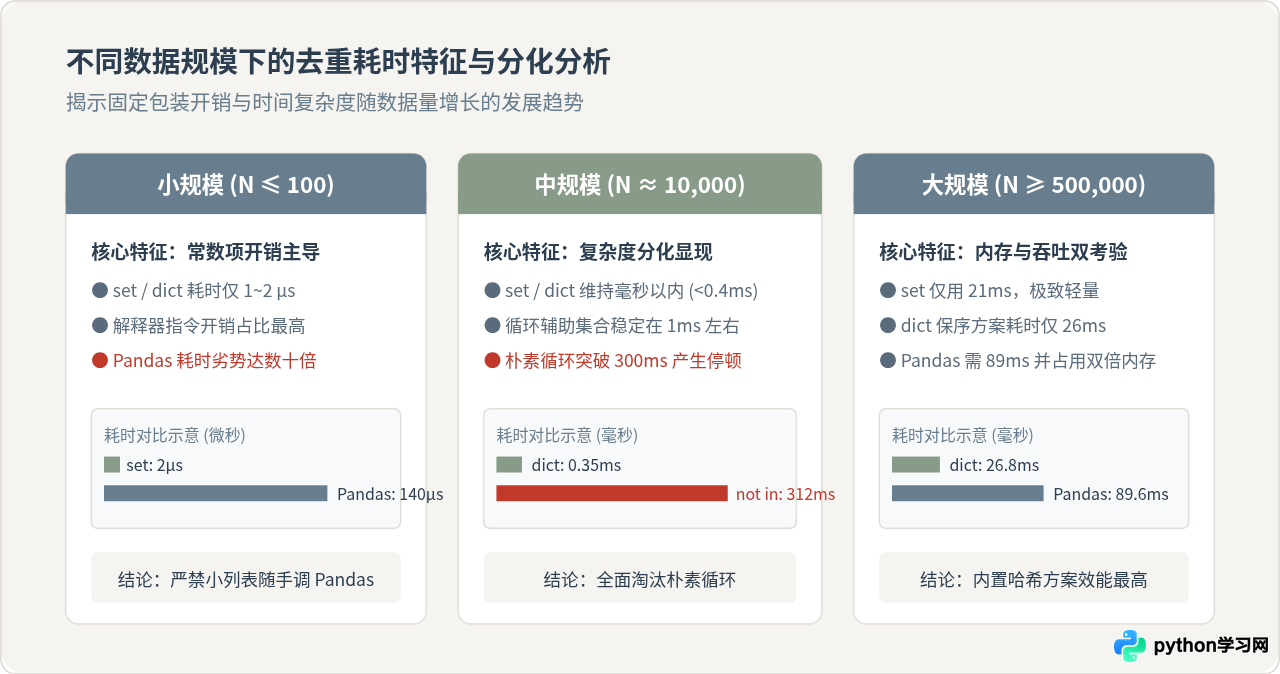
为了排除单次运行的抖动,我们使用 Python 内置的 timeit 模块在同一测试环境下进行基准评估。基准测试涵盖三个数量级:小规模($N = 100$)、中等规模($N = 10,000$)以及大规模($N = 500,000$)。每个数据集随机包含约 30% 的重复率。
import timeit
import random
import pandas as pd

def bench_suite(n):
    # 构造含重复项的测试数据集
    data = [random.randint(0, int(n * 0.7)) for _ in range(n)]

    # 测试函数封装
    def use_set():
        return list(set(data))

    def use_dict():
        return list(dict.fromkeys(data))

    def use_loop_set():
        seen = set()
        res = []
        for x in data:
            if x not in seen:
                seen.add(x)
                res.append(x)
        return res

    def use_pandas():
        return pd.Series(data).drop_duplicates().tolist()

    # 运行计时(根据规模调节循环执行次数)
    runs = 1000 if n <= 10000 else 10
    t_set = timeit.timeit(use_set, number=runs) / runs * 1000
    t_dict = timeit.timeit(use_dict, number=runs) / runs * 1000
    t_loop = timeit.timeit(use_loop_set, number=runs) / runs * 1000
    t_pd = timeit.timeit(use_pandas, number=runs) / runs * 1000

    return {"set": t_set, "dict": t_dict, "loop_set": t_loop, "pandas": t_pd}
以下为标准 Python 3.10 环境下的代表性测试结果(单位:毫秒 ms):
| 数据规模 (N) | list(set) [耗时] | dict.fromkeys [耗时] | for + seen集合 [耗时] | 朴素 for not in [耗时] | Pandas 封装 [耗时] |
|---|---|---|---|---|---|
| N = 100 (小数据) | 0.0018 ms | 0.0022 ms | 0.0085 ms | 0.0450 ms | 0.1420 ms |
| N = 10,000 (中数据) | 0.28 ms | 0.35 ms | 1.15 ms | 312.40 ms | 1.95 ms |
| N = 500,000 (大数据) | 21.50 ms | 26.80 ms | 82.40 ms | > 15 分钟 (中断) | 89.60 ms |
set() 的近 80 倍。这是因为 pd.Series(data) 需要在 Python 解释器与 NumPy 底层 C 数组之间完成元数据校验、内存分配与指针绑定,这种常数级固定成本远远超过了去重运算本身。而在 $N=500,000$ 的海量数据下,朴素列表循环由于 $O(N^2)$ 的比较次数,耗时已呈现爆炸式增长,完全脱离了实用范畴。
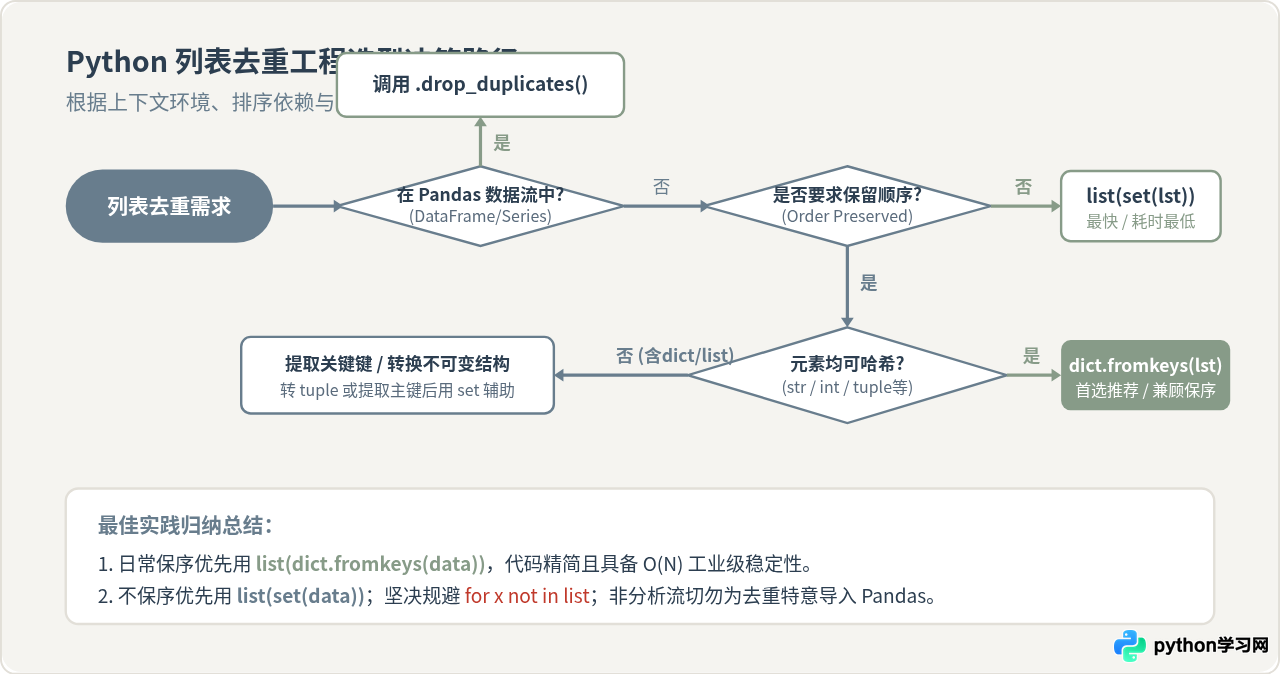
四、工程落地选型指南与决策路径
在日常工程实践中,代码不仅要跑得快,更要具备健壮性与可维护性。可以按照以下决策路径来确定最适宜的去重实现:
- 是否处于 Pandas 管道中?
如果后续紧接着有df.groupby()、数据透视或列计算,直接在 DataFrame / Series 上调用.drop_duplicates()是最合理的,不必特意转为 Python 列表再去重。 - 是否对列表顺序有强要求?
如果纯粹是用于数值集合运算、存在性校验或不敏感列表,毫不犹豫选择list(set(lst)),它的代码意图明确且底层最为纯粹。 - 需要保序且元素均为基础类型?
一律选择list(dict.fromkeys(lst))。它是现代 Python 的惯用写法,在保留顺序的同时具备等同于set的 $O(N)$ 速度,不需要编写冗长的循环语句。 - 元素包含字典等非可哈希类型?
如果数据源为从接口拉取的 JSON 列表(如[{'id': 1}, {'id': 2}, ...]),先提取关键唯一键(如主键 ID)作为辅助集合的比对依据,使用for + seen_set进行安全去重。
五、总结
在 Python 列表去重的选型中,没有绝对意义上的万能方案,只有与应用场景契合度最高的设计选择:
- 最强性能:
list(set(lst))拥有最直接的底层哈希支持,执行速度最为敏捷,适用于无序集合处理; - 最佳平衡:
list(dict.fromkeys(lst))在 Python 3.7 及更高版本中原生保证插入顺序,同时维持 $O(N)$ 线性时间复杂度,是要求保序时的标准推荐; - 生态结合:Pandas 的
drop_duplicates拥有强大的数据表格批处理能力,但在孤立的纯 Python 列表场景中,其对象转换开销明显,不建议“杀鸡用牛刀”; - 复杂度红线:在任何生产代码中,都应当警惕
if item not in result_list模式,避免随数据量膨胀引发应用响应停滞。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









