

怎么用python-mtokenize查看词法分析?
详细讲解如何通过终端命令 python -m tokenize 运行 Python 标准库的词法分析器,解析代码 Token 输出格式、-e 精确参数、缩进栈机制以及实际排错应用。
tokenize 模块内置了完整的命令行接口,只需在终端中执行 python -m tokenize 文件名.py,解释器就会按出现顺序逐行输出所有 Token 的起止行列号、词法类别与源代码切片。本文将演示从基础调用、管道传参到精确模式 -e 的具体操作,并深入解释输出数据所反映的缩进栈与换行机制。
一、命令行调用方式:文件分析与管道即时输入
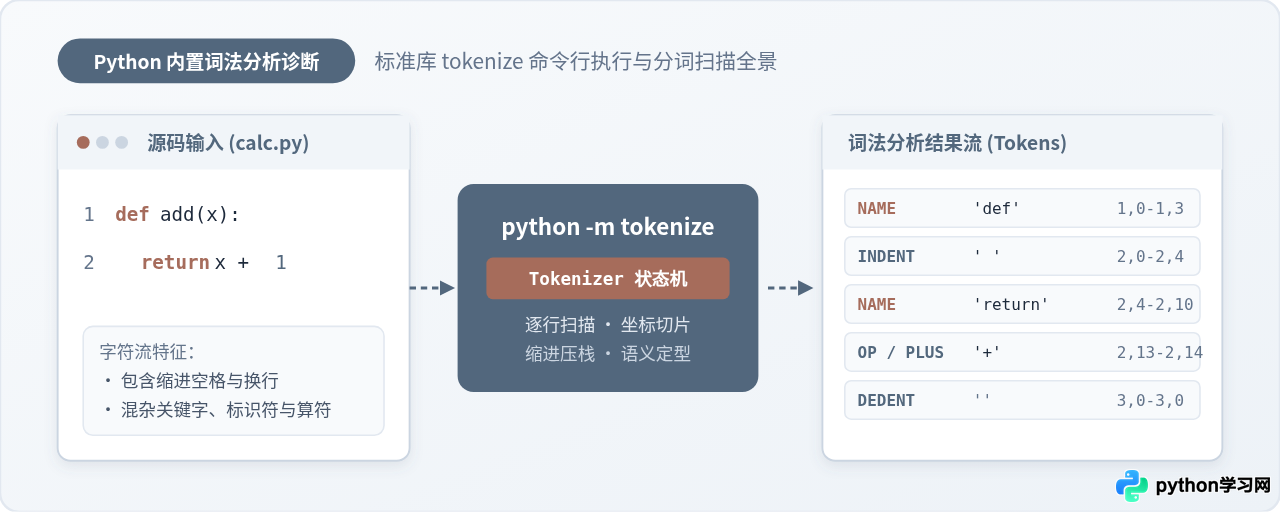
Python 解释器在编译代码时,第一步是由词法扫描器(Scanner/Tokenizer)将文本流转换为离散的词法单元。标准库中的 tokenize.py 提供了入口脚本,使开发者可以直接在终端命令行对任意 Python 文件或代码片段进行词法切片观察。
1. 针对源码文件执行词法分析
最常见的场景是分析现有的脚本文件。假设当前目录下有一个名为 calc.py 的简单代码文件,内容包含一个加法函数:
def add(x):
    return x + 1
在终端中切换到该文件所在目录,直接运行以下命令:
python -m tokenize calc.py运行后,控制台会立刻打印出由上至下的词法分析结果流:
1,0-1,3:            NAME           'def'
1,4-1,7:            NAME           'add'
1,7-1,8:            OP             '('
1,8-1,9:            NAME           'x'
1,9-1,10:           OP             ')'
1,10-1,11:          OP             ':'
1,11-1,12:          NEWLINE        '
'
2,0-2,4:            INDENT         '    '
2,4-2,10:           NAME           'return'
2,11-2,12:          NAME           'x'
2,13-2,14:          OP             '+'
2,15-2,16:          NUMBER         '1'
2,16-2,17:          NEWLINE        '
'
3,0-3,0:            DEDENT         ''
3,0-3,0:            ENDMARKER      ''
2. 使用管道从标准输入即时分析
如果只想临时验证一两个表达式,或者快速比对某段语法的切词规则,无需特意在磁盘上创建 .py 文件。当不给 tokenize 传递文件名参数时,它默认从标准输入(stdin)读取源码。可以通过系统管道直接传入代码:
echo "a = 10 * (b + 2)" | python -m tokenize1,0-1,1: NAME 'a'
1,2-1,3: OP '='
1,4-1,6: NUMBER '10'
1,7-1,8: OP '*'
1,9-1,10: OP '('
1,10-1,11: NAME 'b'
1,12-1,13: OP '+'
1,14-1,15: NUMBER '2'
1,15-1,16: OP ')'
1,16-1,17: NEWLINE '
'
2,0-2,0: ENDMARKER '' 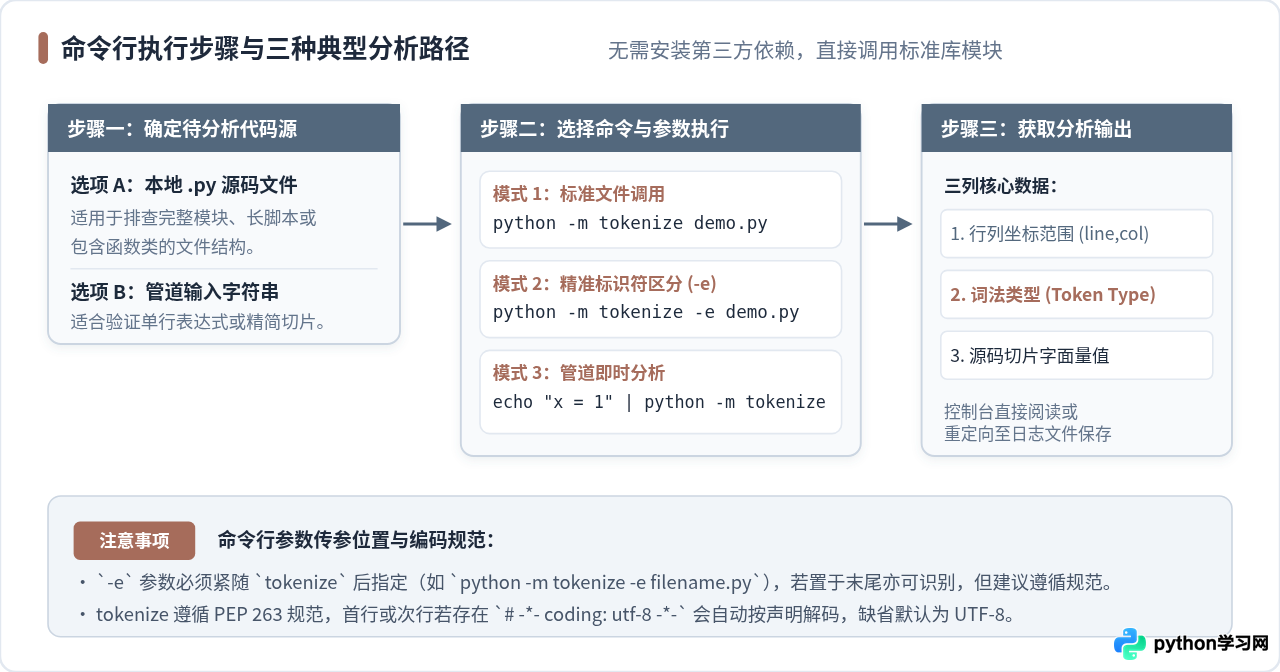
二、读懂输出结果:坐标区间、Token 类型与字面量
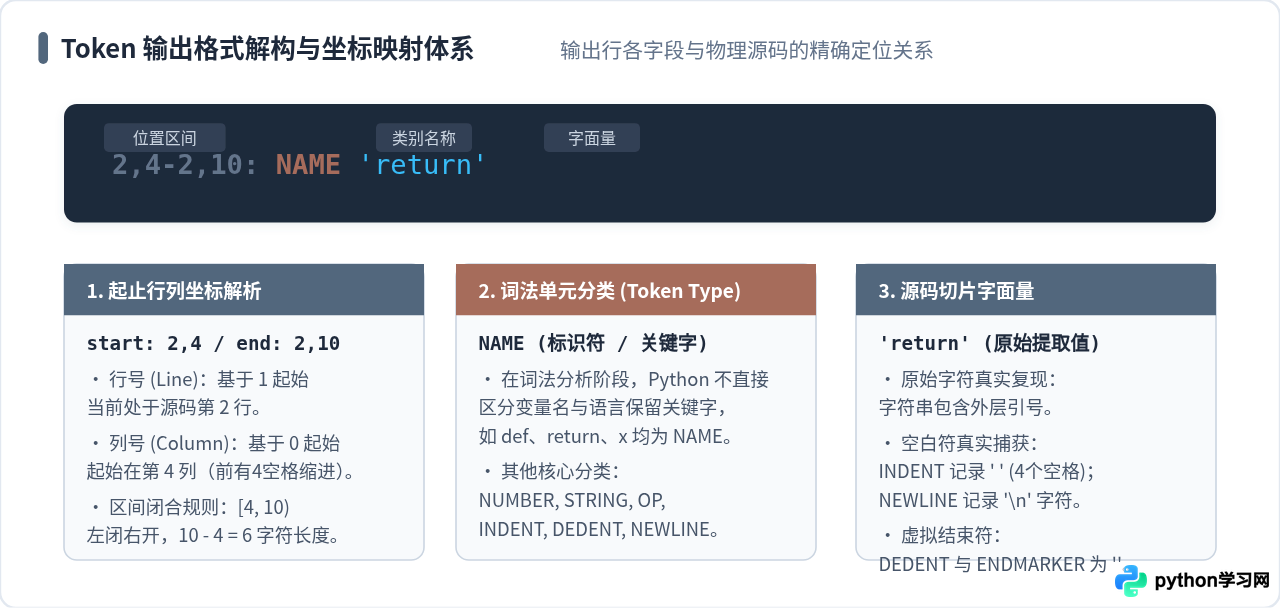
观察 tokenize 的输出结果,会发现每一行严格遵循固定的三段式布局。理解这三段信息是解读 Python 底层如何看待源码的关键。
1. 坐标范围:基于行列的左闭右开区间
位于最左侧的 2,4-2,10: 表示该词法单元在源码中的起止几何坐标。格式为 start_line,start_col-end_line,end_col。这里有一个至关重要的坐标系规则:
- 行号(Line)基于 1 起始:源码第一行就是行号 1。
- 列号(Column)基于 0 起始:行首第一个字符的索引为 0。
- 区间采用半开半闭区间
[start_col, end_col):例如2,4-2,10表示第 2 行从第 4 个字符开始,到第 10 个字符之前结束,切片总长度为 10 - 4 = 6 个字符,对应的正是 6 个字母的关键字'return'。由于前面有 4 个空格缩进(占据了 0, 1, 2, 3 四个位置),因此'return'恰好从第 4 列开始。
2. Token 类别:通用词法类型
居中一列为大写字母表示的词法类别。在默认输出模式下,常见的分类包括:
NAME:所有的标识符与语言关键字(如变量名add、参数x,以及关键字def、return等)。词法分析器在此阶段只负责切分,并不单独区分关键字与自定义变量。NUMBER:整型、浮点型、十六进制或科学计数法等数值字面量。STRING:由单引号、双引号或三引号包裹的字符串字面量。OP:操作符与标点符号(包括赋值号=、加号+、冒号:、括号()等)。INDENT/DEDENT:缩进加深与缩进回退的边界标记。NEWLINE/NL:换行符标记。ENDMARKER:输入流的终结符,标志整个文件读取完毕。
3. 字面量切片:源码的真实物理反映
最右侧为带单引号的实际捕获内容。这里反映的是字符在源文件中的本来面貌:缩进会真实展示空格序列 ' ' 或制表符 ' ',换行则直接展示 '
'。而 DEDENT 与 ENDMARKER 这类由状态机内部虚拟生成的边界单元,其对应的字面量为空字符串 ''。
三、进阶参数:使用 -e 开启精确词法类别
在默认模式下,所有的运算符与标点符号均被笼统标记为 OP。这在需要细化语法结构或开发自定义语法高亮工具时略显模糊。为此,tokenize 提供了 -e(或 --exact)参数,用于输出更具体的 Token 名字。
python -m tokenize -e calc.py1,0-1,3: NAME 'def'
1,4-1,7: NAME 'add'
1,7-1,8: LPAR '('
1,8-1,9: NAME 'x'
1,9-1,10: RPAR ')'
1,10-1,11: COLON ':'
1,11-1,12: NEWLINE '
'
2,0-2,4: INDENT ' '
2,4-2,10: NAME 'return'
2,11-2,12: NAME 'x'
2,13-2,14: PLUS '+'
2,15-2,16: NUMBER '1'
2,16-2,17: NEWLINE '
'
3,0-3,0: DEDENT ''
3,0-3,0: ENDMARKER ''
对比默认输出可以清晰看到变化:原本通用的 OP 被精确细分为 LPAR(左圆括号)、RPAR(右圆括号)、COLON(冒号)以及 PLUS(加号)。这些更精确的名称直接来自于 Python 标准库的 token.EXACT_TOKEN_TYPES 映射表,能够直观展示代码中的标点与算符属性。
四、剖析 Python 特有机制:缩进栈与两类换行符
与 C、Java 等使用花括号 {} 显式界定作用域的语言不同,Python 采用越位规则(Off-side Rule),通过空白符缩进来表达代码块嵌套。这也决定了 Python 词法分析器具备两个极具特色的行为:维护缩进栈与区分两类换行符。
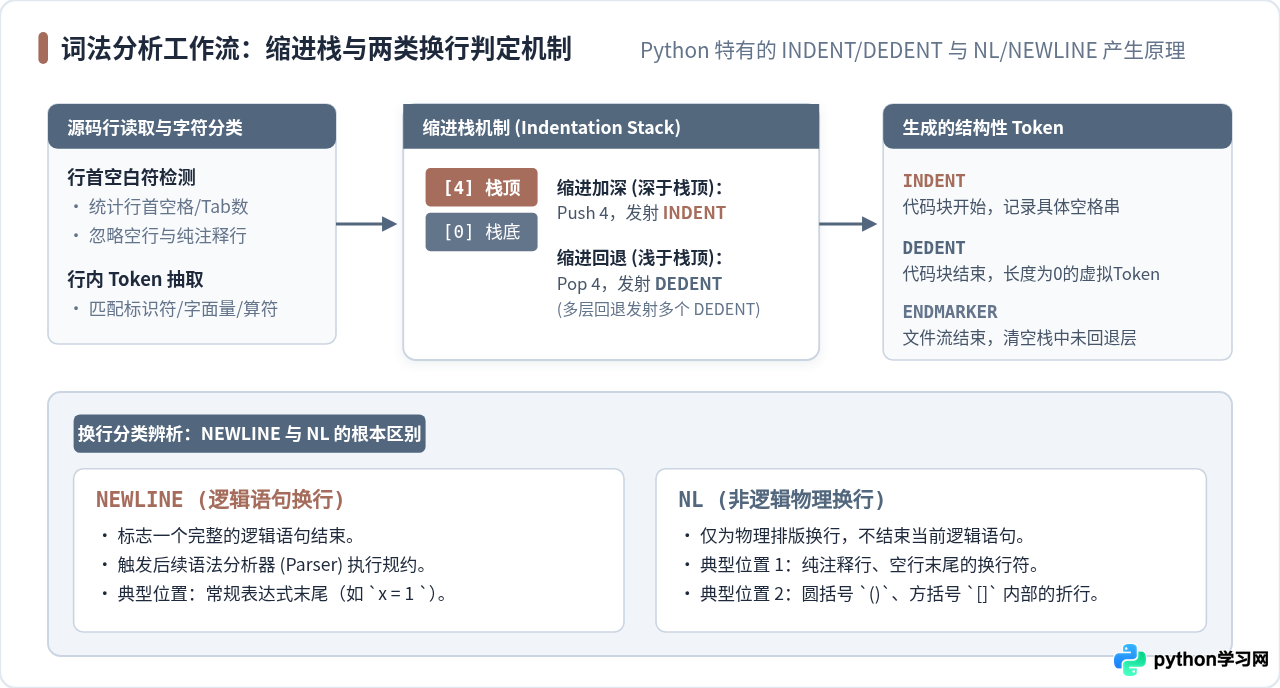
1. 缩进栈如何生成 INDENT 与 DEDENT
词法分析器内部维护着一个名为 缩进栈(Indentation Stack) 的数组,栈底默认压入 0。当扫描到新一行的行首时:
- 如果该行的缩进空白数大于当前栈顶值,说明进入了更深的嵌套代码块,解释器将该缩进值压栈,并立刻发射一个
INDENT标记。 - 如果该行的缩进空白数等于栈顶值,表示仍处于当前同级代码块,不发射任何缩进 Token。
- 如果该行的缩进空白数小于栈顶值,说明已有代码块闭合。解释器开始执行弹栈(Pop)操作,直到栈顶数值与当前缩进量吻合。每弹出一层,就发射一个
DEDENT标记。若一次性跳出三层嵌套,就会连续产生三个DEDENT。 - 如果弹栈遍历到最后,仍找不到与当前行缩进量完全相等的历史层级,词法阶段就会直接抛出
IndentationError: unindent does not match any outer indentation level。 - 当遇到文件末尾(EOF)时,若缩进栈中除 0 外还存有其他数值,解释器会自动逐一弹出并补全对应的
DEDENT,最后发出ENDMARKER。
2. 逻辑换行 NEWLINE 与物理换行 NL 的根本区别
在 tokenize 输出中,有时换行被标记为 NEWLINE,有时却被标记为 NL。这两者在语法解析器中具有完全不同的地位:
NEWLINE(逻辑语句换行):代表一个完整的 Python 独立语句已结束。语法分析器在收到NEWLINE后,会执行语句归约(Reduce)。NL(非逻辑物理换行):代表文本在物理排版上换行了,但在语法逻辑上并不结束当前语句。常见于两种情形:- 纯注释行(如
# 提示说明)或仅包含空白的空行。 - 处于未闭合的圆括号
()、方括号[]或大括号{}内部时的折行。
- 纯注释行(如
例如在下面这段代码中,可以清晰观察到两者的交替出现:
# 这是一个注释
numbers = [
    1,
    2
]1,0-1,9: COMMENT '# 这是一个注释'
1,9-1,10: NL '
'
2,0-2,7: NAME 'numbers'
2,8-2,9: OP '='
2,10-2,11: OP '['
2,11-2,12: NL '
'
3,0-3,4: NUMBER '1'
3,4-3,5: OP ','
3,5-3,6: NL '
'
4,0-4,4: NUMBER '2'
4,4-4,5: NL '
'
5,0-5,1: OP ']'
5,1-5,2: NEWLINE '
'
6,0-6,0: ENDMARKER ''
注释行末尾以及方括号内的换行全部被标记为 NL,整个列表在物理上跨越了 4 行,但直到第 5 行右方括号 ] 闭合之后,解释器才发射出 NEWLINE。这证明了在 Python 内部,这整段结构自始至终被当作单一逻辑语句处理。
五、实战排错场景与认知边界
在日常开发与脚本调试中,python -m tokenize 往往能作为排查某些隐蔽语病与不可见字符缺陷的有力工具。
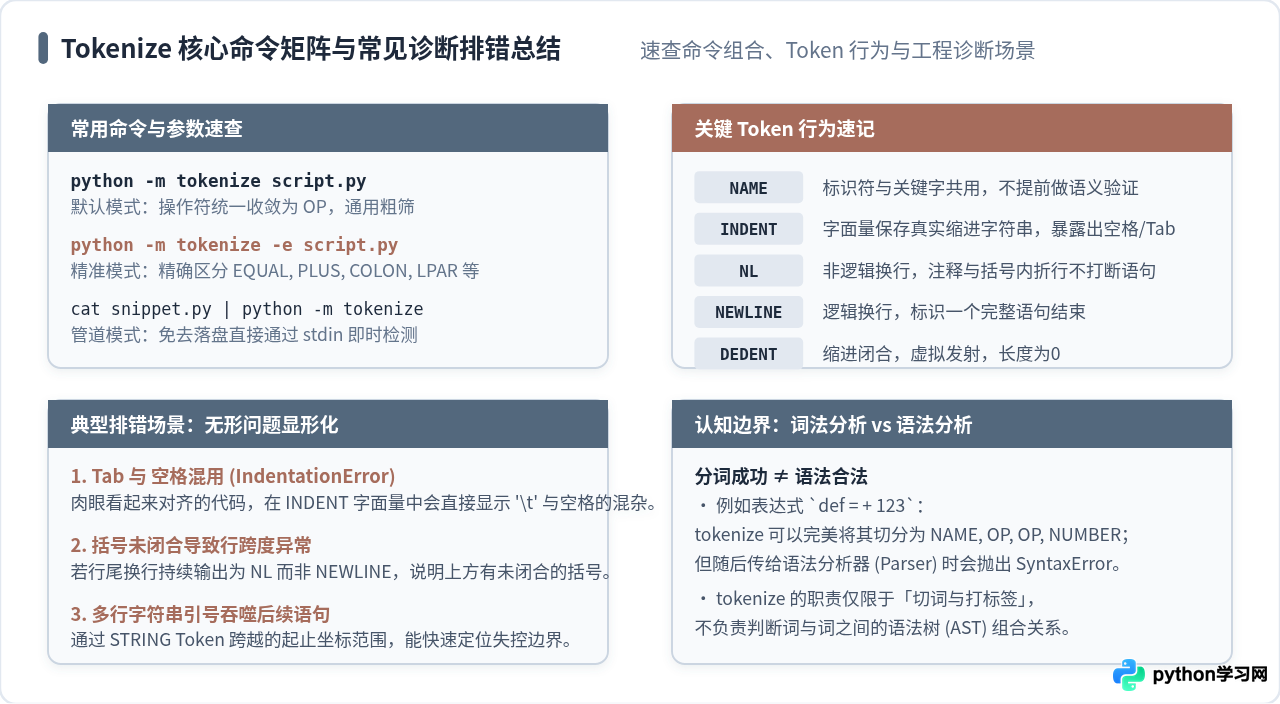
1. 排查 Tab 与空格混用引发的缩进异常
在很多代码编辑器中,制表符(Tab)与 4 个空格在视觉上完全一致。但若团队中不同成员混用了两类缩进字符,在跨环境运行时可能频繁触发 TabError: inconsistent use of tabs and spaces in indentation。
直接用 python -m tokenize problematic_file.py 检查,其 INDENT 字段会毫无保留地打印出引号内的原始字符。如果是 4 个空格,会明确显示为 ' ';如果是制表符,则会直接显示为 ' '。只需搜索输出流中的 ,即可瞬间定位混入制表符的具体行数。
2. 检测括号或多行字符串未闭合的边界
有时我们在很长的复杂函数里漏写了一个闭合括号,Python 解释器在报错时往往指向数十行之后的某一行,甚至直接指向文件末尾,让人难以定位源头。
此时使用 tokenize 观察输出:如果看到原本应该是独立语句的地方,行尾本该出现的 NEWLINE 却连续多行被标记为了 NL,那么发生异常转变的最上方那一行,必然存在未闭合的括号结构。类似地,如果多行三引号字符串缺失了结束引号,后续所有正常的代码逻辑都会被吞没进一个巨大的 STRING 词法单元中,其起始坐标能精准指明未闭合引号的所在行。
必须注意,tokenize 的工作仅仅是根据字符边界切分 Token 并贴上类型标签,它不会校验语句是否符合语法逻辑规则。例如执行 echo "def = + 123" | python -m tokenize,分词器能够毫无阻碍地切出 NAME、OP、OP、NUMBER 并返回退出码 0。但随后的语法分析器(Parser)在构建抽象语法树(AST)时就会抛出 SyntaxError。明确两者的职责边界,有助于更准确地界定诊断范围。
六、操作与核心知识总结
掌握 python -m tokenize 的使用方式,为我们提供了一个无需依赖额外调试工具即可洞察 Python 代码底层分词过程的视角。下表归纳了本文涉及的常用操作与核心概念要点:
| 类别 | 语法 / 命令 | 核心作用与典型表现 |
|---|---|---|
| 基础调用 | python -m tokenize file.py |
分析指定文件,输出每个 Token 的起止行列号、通用类别与字面量 |
| 精准模式 | python -m tokenize -e file.py |
将通用 OP 细化为 PLUS、COLON、LPAR 等具体算符与符号 |
| 管道传参 | echo "code" | python -m tokenize |
从标准输入读取临时代码片段,免写文件即时验证切词行为 |
| 缩进维护 | INDENT / DEDENT |
通过内部缩进栈动态发射;字面量记录真实空白符,便于排查混用 |
| 换行区分 | NEWLINE vs NL |
NEWLINE 标志逻辑语句结束;NL 仅代表物理排版换行(注释/括号内) |
无论是在深入理解 Python 语言的编译机制、开发自定义代码格式化或静态检查工具,还是在遇到棘手的不可见字符与多行语法嵌套错误时,灵活运用这一内置命令都能快速提供清晰准确的底层证据。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









