

怎么使用Python读取和解析现有的SQLite数据库文件
详细讲解如何使用Python读取和解析现有的SQLite数据库文件(.db或.sqlite)。涵盖安全连接、元数据表结构探测、行映射解析、Pandas高效分析及避坑指南。
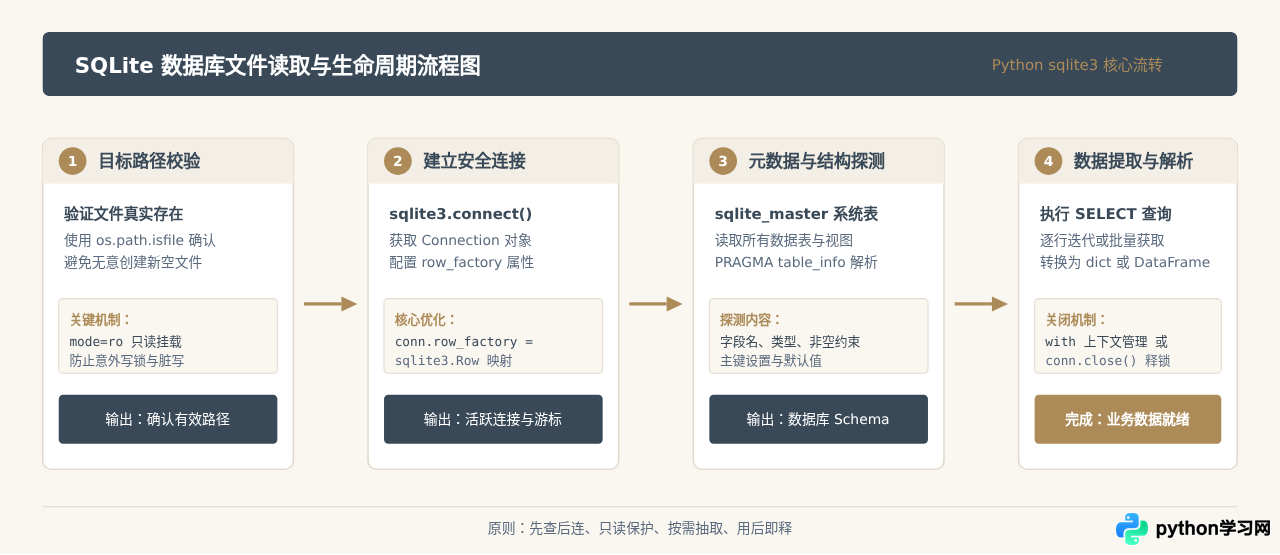
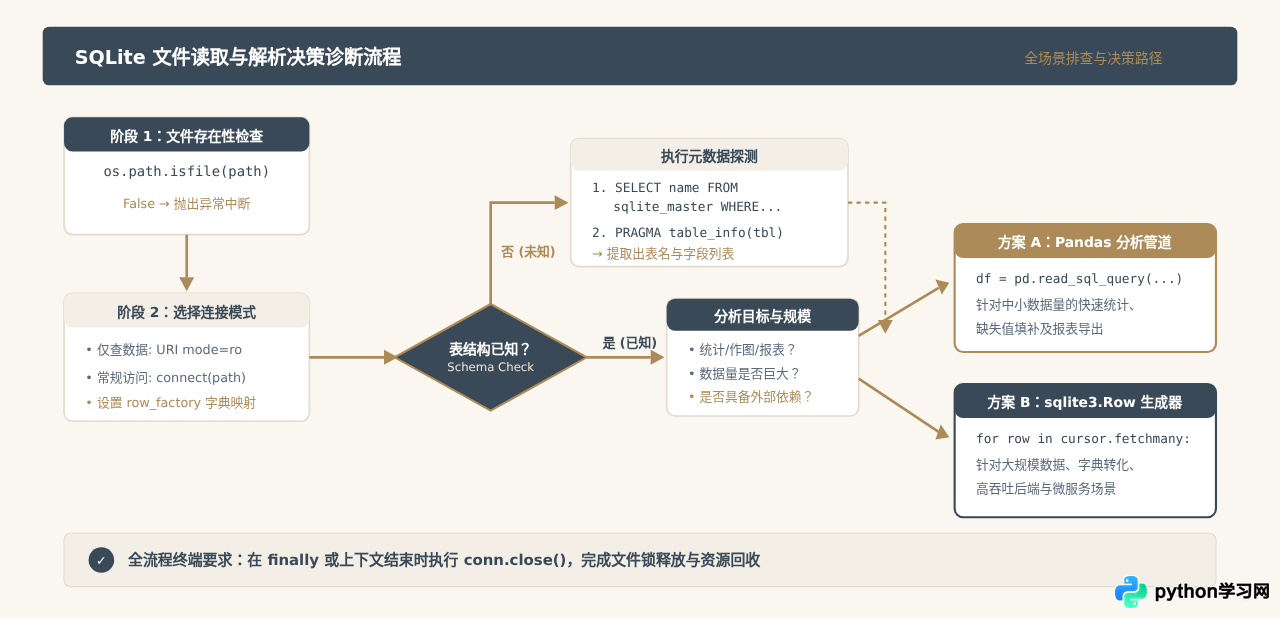
.db、.sqlite 或 .sqlite3),最直接且标准的方法是使用 Python 自带的 sqlite3 标准库,无需安装任何第三方依赖。整个处理路径分为五步:验证文件与建立只读连接、探索内部 Schema 确定数据表和字段定义、执行查询并提取数据记录、将字段映射为结构化对象或字典、最后释放连接。如果需要进行多维统计与报表导出,也可以搭配 pandas 实现一行加载为数据帧。
一、准备工作与安全连接机制
在操作既有数据库文件之前,首先要明确 Python 内置 sqlite3 模块的一项默认行为:如果连接的目标路径不存在,sqlite3.connect() 会默默在磁盘上自动创建一个全新的空数据库文件,而不会报错。如果程序中的文件路径有拼写错误,后续查询数据表时就会抛出 sqlite3.OperationalError: no such table 异常。
为了保证确实在读取“现有的”目标文件,建议先使用 os.path.exists() 验证文件路径,或者使用 SQLite 专用的只读 URI 模式进行连接。只读 URI 连接不仅能在文件缺失时立即抛错,还能避免任何意外的写操作修改原始数据库文件。
1. 常规基础连接
import os
import sqlite3

db_path = "data_store.db"

# 检查文件是否存在,防止自动生成空文件
if not os.path.isfile(db_path):
    raise FileNotFoundError(f"未找到数据库文件:{db_path}")

# 建立连接
conn = sqlite3.connect(db_path)
cursor = conn.cursor()

# 逻辑处理完成后显式关闭
cursor.close()
conn.close()
2. 只读模式(URI 方式)
如果目标数据库正在被其他进程访问,或者你希望杜绝脚本因任何意外写入造成数据篡改,可以使用 URI 连接字符串声明只读(mode=ro):
import sqlite3
import os

db_path = os.path.abspath("data_store.db")
# 启用 uri=True,以只读模式挂载
conn = sqlite3.connect(f"file:{db_path}?mode=ro", uri=True)
cursor = conn.cursor()
二、探索未知数据库的元数据与表结构(Schema 解析)
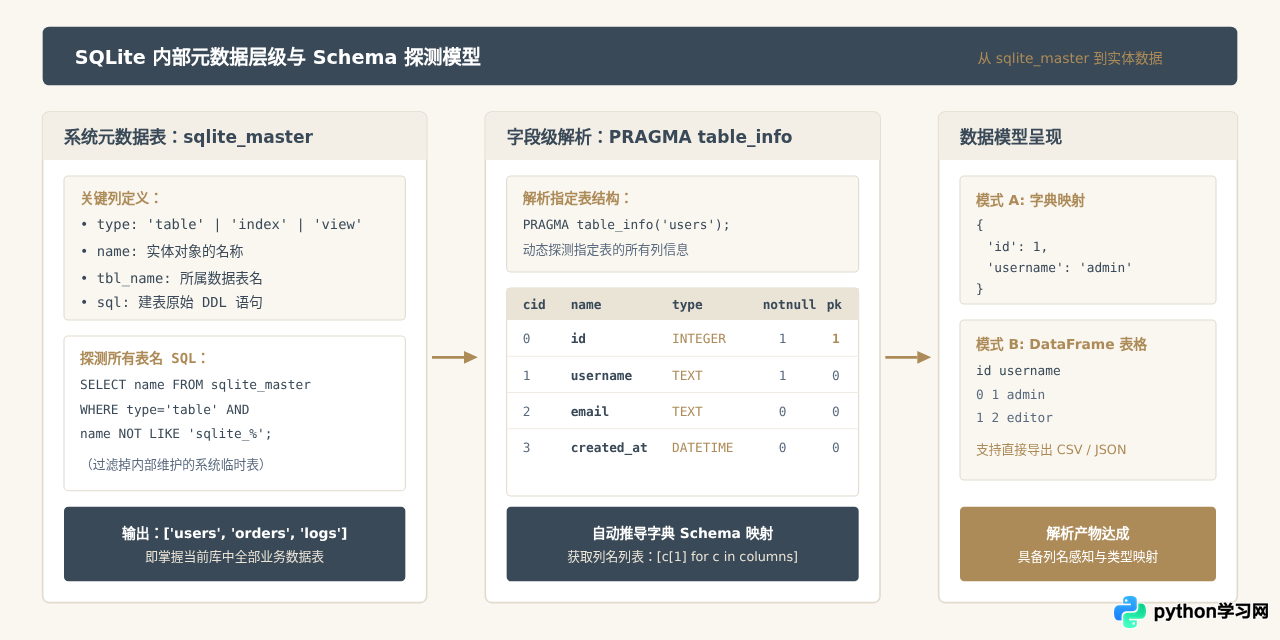
在很多实际工作场景下,拿到一个 .db 文件时,往往不知道里面究竟包含哪些表,更不知道每张表的字段名称与类型。SQLite 在内部维护了一张名为 sqlite_master(较新版本中也叫 sqlite_schema)的系统表,其中记录了该数据库下所有的表、索引、视图与触发器定义。
1. 查询当前库中的所有数据表
执行以下代码,可以完整列出当前数据库中存在的所有数据表名称:
import sqlite3

conn = sqlite3.connect("data_store.db")
cursor = conn.cursor()

# 查询所有普通数据表(过滤系统内部维护表)
query = "SELECT name FROM sqlite_master WHERE type='table' AND name NOT LIKE 'sqlite_%';"
cursor.execute(query)

tables = [row[0] for row in cursor.fetchall()]
print(f"找到的数据表列表: {tables}")
2. 查询指定表的字段名称与数据类型
确定了表名后,可以通过 PRAGMA table_info(表名) 命令获取字段详情:
table_name = tables[0] if tables else None
if table_name:
    cursor.execute(f"PRAGMA table_info({table_name});")
    columns_info = cursor.fetchall()

    print(f"\n【表名:{table_name} 的字段结构】")
    for col in columns_info:
        cid, name, col_type, notnull, default_val, pk = col
        pk_flag = " [主键]" if pk else ""
        print(f"字段序号: {cid} | 字段名: {name:<15} | 类型: {col_type:<10} | 非空: {bool(notnull)}{pk_flag}")
三、提取并解析数据记录(从元组到键值字典)
默认情况下,cursor.fetchall() 返回的是一个由原生 Python 元组(tuple)组成的列表。如果表字段较多,通过下标 row[0]、row[1] 访问不仅极易出错,而且代码可读性极差。
1. 使用 sqlite3.Row 实现字典式键值访问
Python sqlite3 提供了一个内置的轻量行映射工厂:sqlite3.Row。只需在连接建立后设置 conn.row_factory = sqlite3.Row,游标返回的每一行对象即可同时支持通过字段名访问、通过下标访问,还能方便地通过 dict(row) 快速转为真正的 Python 字典:
import sqlite3

conn = sqlite3.connect("data_store.db")
# 设置行工厂为 sqlite3.Row
conn.row_factory = sqlite3.Row

cursor = conn.cursor()
cursor.execute("SELECT * FROM users LIMIT 3;")

rows = cursor.fetchall()
for row in rows:
    # 方式一:通过字段名称直接访问
    user_id = row["id"]
    username = row["username"]

    # 方式二:快速转为原生字典
    user_dict = dict(row)
    print("解析为字典:", user_dict)

conn.close()
2. 大数据量场景下的流式解析(避免内存溢出)
如果现有的 SQLite 数据库文件体积较大(例如数百兆或数吉字节),绝对不能一次性调用 cursor.fetchall(),这会将全部数据一次性载入内存导致 OOM。应当利用游标本身的迭代器协议,逐行生成解析:
def stream_parse_table(db_path, table_name, chunk_size=1000):
    conn = sqlite3.connect(db_path)
    conn.row_factory = sqlite3.Row
    cursor = conn.cursor()

    cursor.execute(f"SELECT * FROM {table_name};")

    # 方式 A:分批提取(fetchmany)
    while True:
        records = cursor.fetchmany(chunk_size)
        if not records:
            break
        for row in records:
            yield dict(row)

    conn.close()

# 调用示例
for record in stream_parse_table("data_store.db", "users"):
    # 逐条消费处理
    pass
四、技术方案对比:原生 sqlite3 与 Pandas
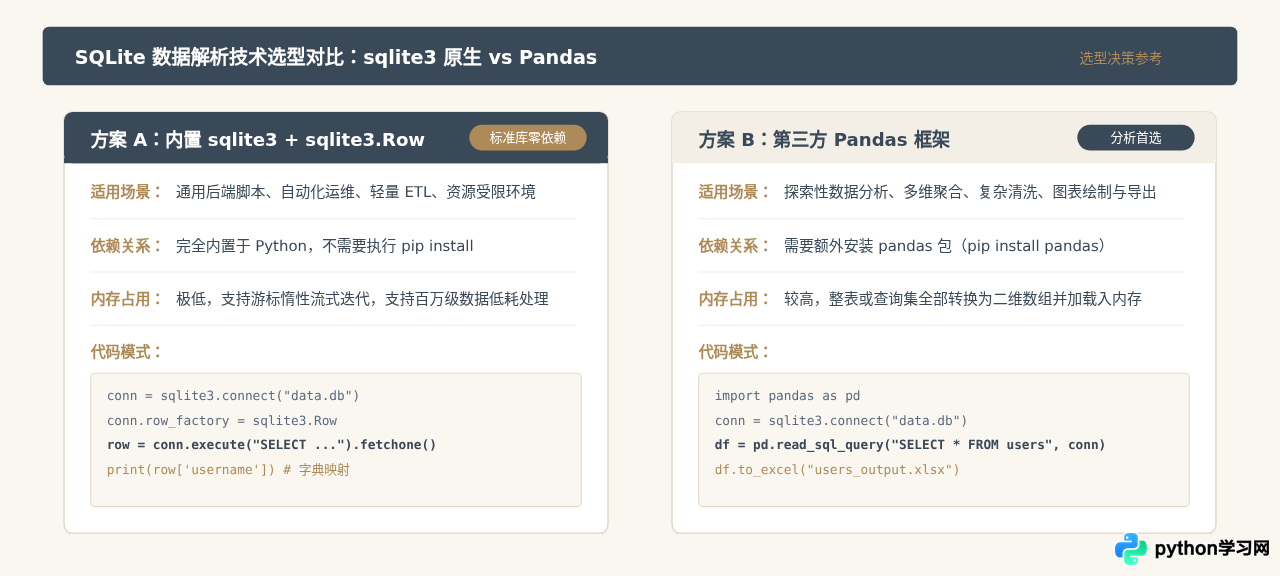
除了原生模块,数据科学与分析领域最常用的工具是 pandas。使用 pandas.read_sql_query() 可以直接将 SQL 查询结果转换为结构化的 DataFrame。两种方式在不同场景下各有优势:
使用 Pandas 一行读取与导出
import sqlite3
import pandas as pd

conn = sqlite3.connect("data_store.db")

# 一行代码将整张表解析为 Pandas DataFrame
df = pd.read_sql_query("SELECT * FROM users WHERE status = 1;", conn)

# 查看前 5 行及字段数据类型
print(df.head())
print(df.dtypes)

# 转换为字典列表
records = df.to_dict(orient="records")

# 导出为 Excel 或 CSV 文件
df.to_csv("users_parsed.csv", index=False)

conn.close()
五、特殊数据类型解析与处理技巧
SQLite 采用的是动态类型系统(亲和类型机制),核心数据类型只有 NULL、INTEGER、REAL、TEXT 和 BLOB 五种。在解析已有的业务数据库时,常常会遇到两类特殊字段:日期时间(Datetime)与序列化 JSON 字符串。
1. 日期与时间字段的自动解析
默认情况下,SQLite 中的日期时间通常以文本字符串(ISO-8601 标准如 2026-10-17 08:30:00)或 Unix 时间戳存储。可以通过连接参数让 sqlite3 自动将其转换为 Python 的 datetime.datetime 对象:
import sqlite3

# 声明解析列名与类型探测标志
conn = sqlite3.connect(
    "data_store.db",
    detect_types=sqlite3.PARSE_DECLTYPES | sqlite3.PARSE_COLNAMES
)
cursor = conn.cursor()

# 如果表定义中字段声明为 TIMESTAMP 或 DATETIME,读取出的值会自动是 datetime 对象
cursor.execute("SELECT created_at FROM orders LIMIT 1;")
created_at_val = cursor.fetchone()[0]
print(type(created_at_val), created_at_val)
2. JSON 字符串字段的解析
现代应用常把复杂的配置或键值对保存在 SQLite 的 TEXT 列中。在解析这类字段时,可借助标准库 json 模块进行解码:
import json
import sqlite3

conn = sqlite3.connect("data_store.db")
conn.row_factory = sqlite3.Row
cursor = conn.cursor()

cursor.execute("SELECT id, extra_meta FROM system_logs LIMIT 5;")
for row in cursor.fetchall():
    raw_meta = row["extra_meta"]
    # 如果字段不为空,解析为 Python 字典
    meta_dict = json.loads(raw_meta) if raw_meta else {}
    print(f"日志 ID {row['id']} 包含的扩展元数据: {meta_dict}")

conn.close()
六、排查常见错误与最佳实践清单
- 防误创空文件:务必在连接前执行路径验证或使用
?mode=ro,避免将路径拼写错误演变为“创建新文件+查无数据”。 - 防死锁或被锁:读取操作应确保使用只读连接,避免长时间占用写锁;查询完毕后一定要调用
conn.close()。 - 防 SQL 注入:若查询条件来自外部输入,务必使用参数化占位符
?,严禁使用 f-string 拼接 SQL。 - 资源妥善关闭:推荐使用
with上下文管理器或在finally块中保证conn.close()被执行。
七、完整可执行代码范例
以下提供一个功能完整的通用解析脚本,它集成了路径检查、只读挂载、动态探测表名、解析字段结构以及安全提取前五条记录并转化为字典的完整闭环。读者只需将 db_file 变量替换为目标实际文件即可直接执行:
import os
import sqlite3

def inspect_and_read_sqlite(db_file: str):
    # 1. 验证目标文件有效性
    if not os.path.isfile(db_file):
        raise FileNotFoundError(f"指定的 SQLite 文件不存在: {db_file}")

    abs_path = os.path.abspath(db_file)
    print(f"[*] 正在挂载数据库文件: {abs_path}")

    # 2. 以只读 URI 模式建立连接,并启用 sqlite3.Row 映射
    conn = sqlite3.connect(f"file:{abs_path}?mode=ro", uri=True)
    conn.row_factory = sqlite3.Row
    cursor = conn.cursor()

    try:
        # 3. 探测所有的非系统数据表
        cursor.execute("SELECT name FROM sqlite_master WHERE type='table' AND name NOT LIKE 'sqlite_%';")
        tables = [row["name"] for row in cursor.fetchall()]

        if not tables:
            print("[-] 该数据库中未找到任何有效的数据表。")
            return

        print(f"[+] 发现数据表 ({len(tables)} 个): {', '.join(tables)}\n")

        # 4. 遍历探测各表结构并提取前 3 条样本数据
        for tbl in tables:
            print(f"--- 正在解析数据表: {tbl} ---")

            # 解析列元数据
            cursor.execute(f"PRAGMA table_info({tbl});")
            col_definitions = cursor.fetchall()
            col_names = [col["name"] for col in col_definitions]
            print(f"字段结构: {col_names}")

            # 读取前 3 条记录并转为字典
            cursor.execute(f"SELECT * FROM {tbl} LIMIT 3;")
            records = [dict(row) for row in cursor.fetchall()]

            print(f"样本数据 ({len(records)} 条):")
            for idx, item in enumerate(records, start=1):
                print(f"  [{idx}] {item}")
            print()

    finally:
        # 5. 确保游标与连接被安全关闭
        cursor.close()
        conn.close()
        print("[*] 数据库连接已安全关闭。")

if __name__ == "__main__":
    # 替换为你的现有 SQLite 文件路径进行测试
    test_db = "my_existing_database.db"
    if os.path.exists(test_db):
        inspect_and_read_sqlite(test_db)
    else:
        print(f"提示:请将 test_db 变量指向实际存在的 SQLite 文件路径。")
通过以上规范流程,不仅能够保证在面对完全未知的 SQLite 数据库文件时快速梳理出其存储结构,而且通过只读挂载和行映射工厂,既有效保护了既有数据的完整性,又获得了极佳的编码体验与可维护性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









