

Python字符串中怎么插入换行符\n
详细讲解在Python字符串中插入换行符\n的多种核心方法,涵盖基础转义字符、多行三引号排版、join列表拼接以及原始字符串和跨平台避坑指南。
\n。当使用 print() 输出或将字符串写入文件时,解释器会将 \n 解释为标准换行(ASCII 码 10,LF)。除转义字符外,根据不同业务场景,还可以使用三引号多行字符串、str.join() 批量拼接以及格式化字符串(f-string)。本文详细说明每种方式的具体用法、原理对比及常见避坑细节。
一、基础用法:直接在字符串中写入转义字符 \n
在 Python 字符串字面量中,反斜杠 \ 作为转义前缀使用,紧随其后的英文字母 n 组合构成转义序列 \n,代表换行符(Newline)。
# 基础单行字符串中嵌入换行符
content = "姓名:张三\n职位:后端开发工程师\n部门:技术研发部"
print(content)
执行上述代码后,终端会将文本分为三行呈现:
姓名:张三
职位:后端开发工程师
部门:技术研发部
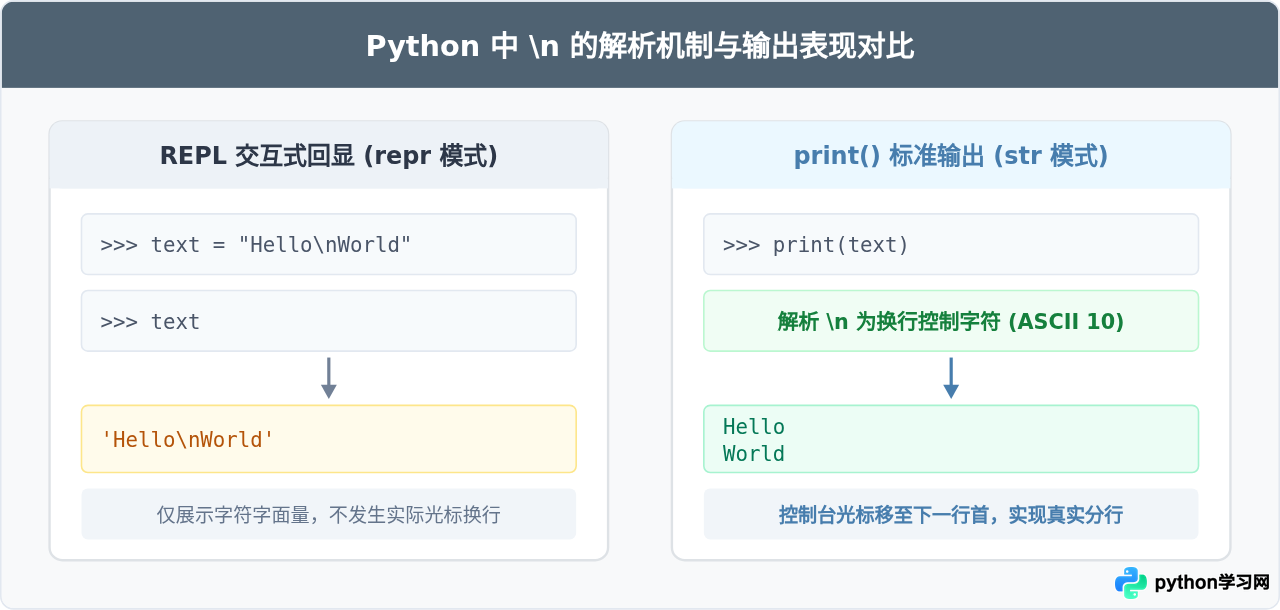
核心机制:为什么交互式命令行回显不会真正换行?
初学者常遇到一个疑问:在交互式命令行(REPL / Jupyter Notebook)中直接输入包含 \n 的变量并敲击回车,终端显示的是带引号和双反斜杠的内容,并没有真正换行:
>>> text = "第一行\n第二行"
>>> text
'第一行\n第二行'  # 此处终端显示 repr 原始形态,并未实际分行
>>> print(text)
第一行
第二行             # print 会渲染 str 内容,换行生效
这是因为直接在终端输入变量名时,解释器调用的是对象的 __repr__() 方法,其目标是向开发者展示对象的内部表示,因此会将换行符显式写出;而 print() 调用的是 __str__() 方法,专门用于人眼阅读,此时换行控制字符才会被控制台解析为物理光标换行动作。
二、多行长文本排版:使用三引号字符串及缩进清理
当需要编写多行提示信息、SQL 语句或格式化邮件正文时,反复在单行中书写 \n 会让代码难以阅读和维护。此时可以使用三引号(""" 或 ''')定义多行字符串:
template = """欢迎使用自动化构建工具:
1. 检查本地环境依赖
2. 执行单元测试套件
3. 打包发布产物"""

print(template)
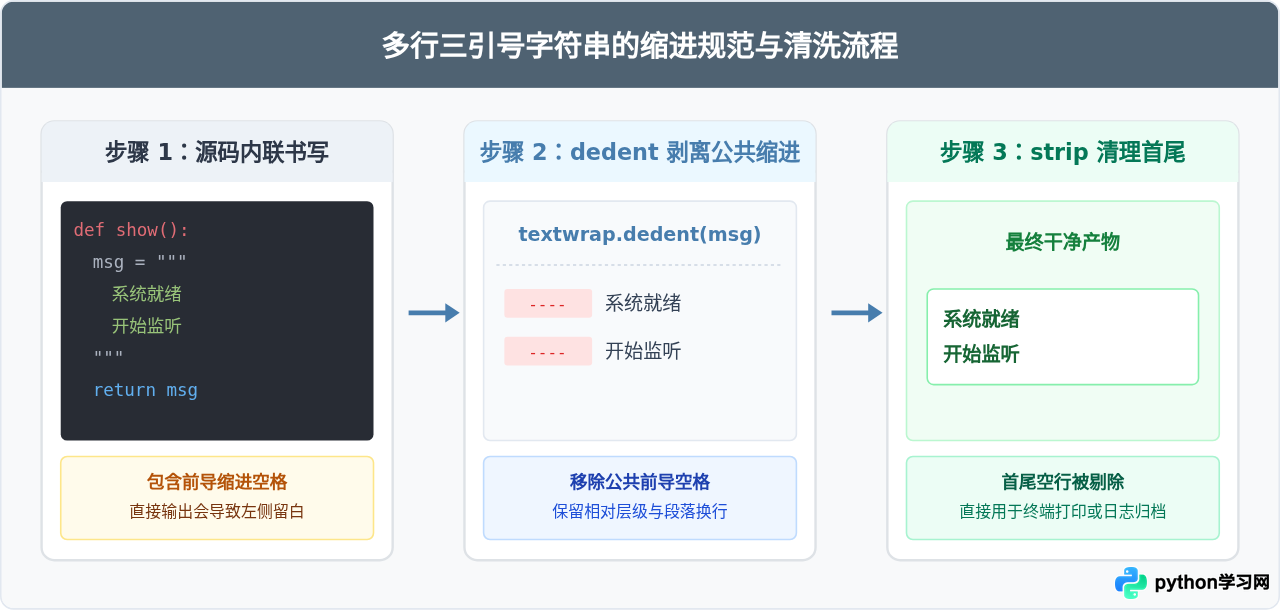
三引号会忠实记录你在编辑器中敲击的每一次物理换行。但若将三引号写在函数或类方法内部,代码编辑器的缩进空格也会被原封不动地保留在字符串中,导致输出内容左侧出现多余空白:
import textwrap

def get_help_doc():
    # 函数内部带有代码缩进
    doc = """
        使用说明:
        --help      查看帮助命令
        --version   查看当前版本号
    """
    # 使用 textwrap.dedent 剥离公共缩进,配合 strip 去除首尾多余空行
    return textwrap.dedent(doc).strip()

print(get_help_doc())textwrap.dedent() 会自动检测字符串中所有非空行的最长公共前导空格并将其移除,从而在保持源码缩进整齐的同时,确保输出文本左边缘紧凑对齐。
三、动态生成与批量拼接:join() 与 f-string
在实际业务中,换行数据往往不是静态写死的,而是存放在列表、元组或数据库查询结果集中的多个独立项。此时应避免使用 + 运算符循环拼接字符串,而应使用 Python 高性能的 str.join() 方法。
# 将列表元素按行拼接
log_entries = [
    "[INFO] 2026-10-17 08:30:00 服务启动",
    "[INFO] 2026-10-17 08:30:02 数据库连接池初始化完毕",
    "[WARN] 2026-10-17 08:30:05 缓存命中率低于阈值"
]

# 使用换行符作为连接符号
full_log = "\n".join(log_entries)
print(full_log)
"\n".join(iterable) 会在序列中两两相邻的元素之间精准插入一个换行符,不会在首尾产生多余的空行,内存利用效率高,是处理日志、文件批量输出的最佳实践。
f-string 中嵌入换行符的注意事项
使用格式化字符串时,直接将 \n 放入字符串字面量部分完全合法:
user = "Alice"
status = "Active"
message = f"用户:{user}\n状态:{status}"
print(message){...} 内部严禁包含反斜杠(例如 f"{'\n'.join(items)}" 会报 SyntaxError),需要提前把连接后的变量计算好再传入;自 Python 3.12 引入新的 PEG 解析器后,官方正式解除了此限制,大括号内部已支持完整的反斜杠表达式。
四、避坑指南:原始字符串与跨平台差异
1. 原始字符串(Raw String)导致换行失效
当在字符串前加上前缀 r 或 R 时,Python 会将其定义为原始字符串(Raw String)。在原始字符串中,反斜杠 \ 被视为普通字符,失去转义功能,导致 \n 无法生效:
# 错误做法:原始字符串导致无法换行
raw_str = r"第一行\n第二行"
print(raw_str)
# 终端输出结果:第一行\n第二行 (原样输出了 \ 和 n)
原始字符串通常用于正则表达式(Regex)或 Windows 物理文件路径处理,以防止反斜杠被意外转义。如果需要进行文本换行,切勿对字符串添加 r 前缀。
2. 操作系统与换行符标准的兼容性
不同操作系统在历史演进中形成了不同的默认换行标准:
- Linux / macOS:采用
\n(Line Feed,LF,ASCII 10)。 - Windows:采用
\r\n(Carriage Return + Line Feed,CRLF,ASCII 13 + ASCII 10)。 - 早期 Mac OS(经典版):采用
\r(CR,ASCII 13,现代系统已基本绝迹)。
在 Python 3 中进行文件读写时,内置的 open() 函数默认开启了通用换行符模式(Universal Newlines):
- 读取文件时:无论文件中原本存储的是
\r\n还是\n,Python 都会在内存中统一转换为\n。 - 写入文件时:文本模式下写入
\n,Python 会自动将其转换为当前操作系统的默认换行符(在 Windows 下自动变为\r\n,Linux 下保持\n)。
# 文件读写示范:直接写 \n 即可保持全平台兼容
with open("output.txt", "w", encoding="utf-8") as f:
f.write("第一行数据\n第二行数据\n")\r\n,或在 open() 中指定参数 newline="" 禁用系统的自动转换。
3. print 函数自带的换行控制
print() 函数自带一个名为 end 的关键字参数,其默认值为 "\n"。这意味着每次调用 print() 结束时,都会自动在末尾追加一个换行符:
# 默认每次 print 换行
print("第一段")
print("第二段")

# 修改 end 参数取消自动换行
print("正在加载中", end="")
print("......完成")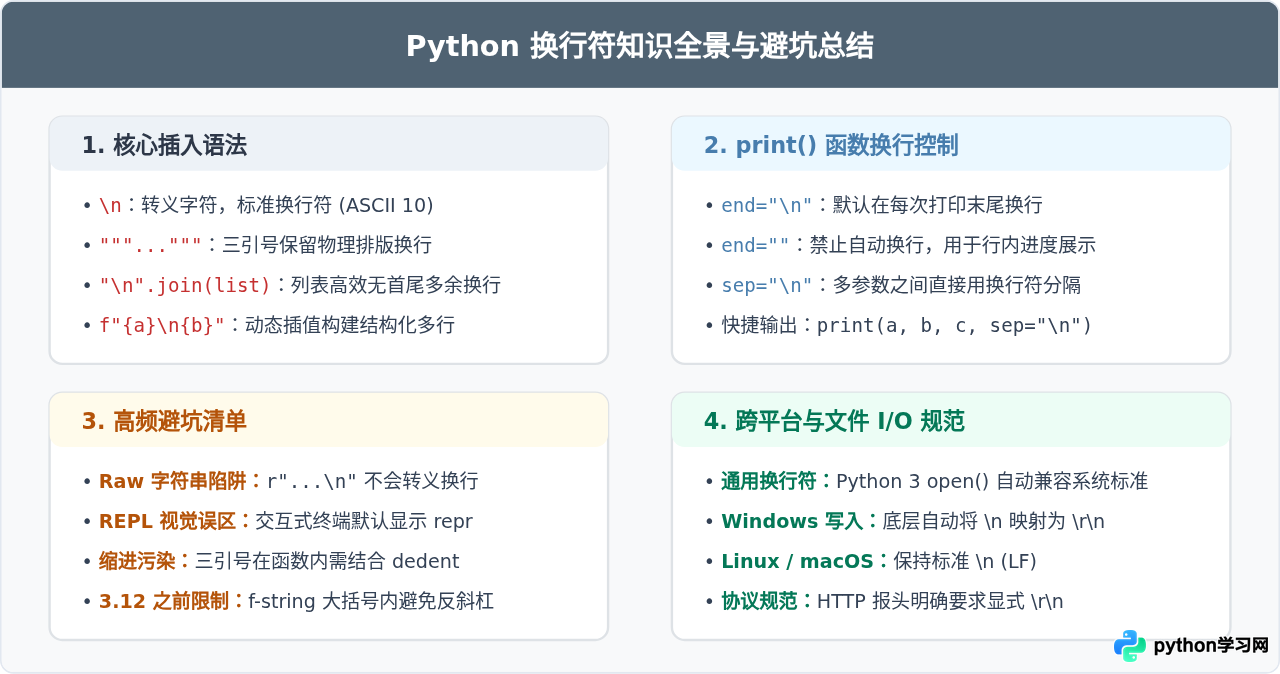
五、总结速查表
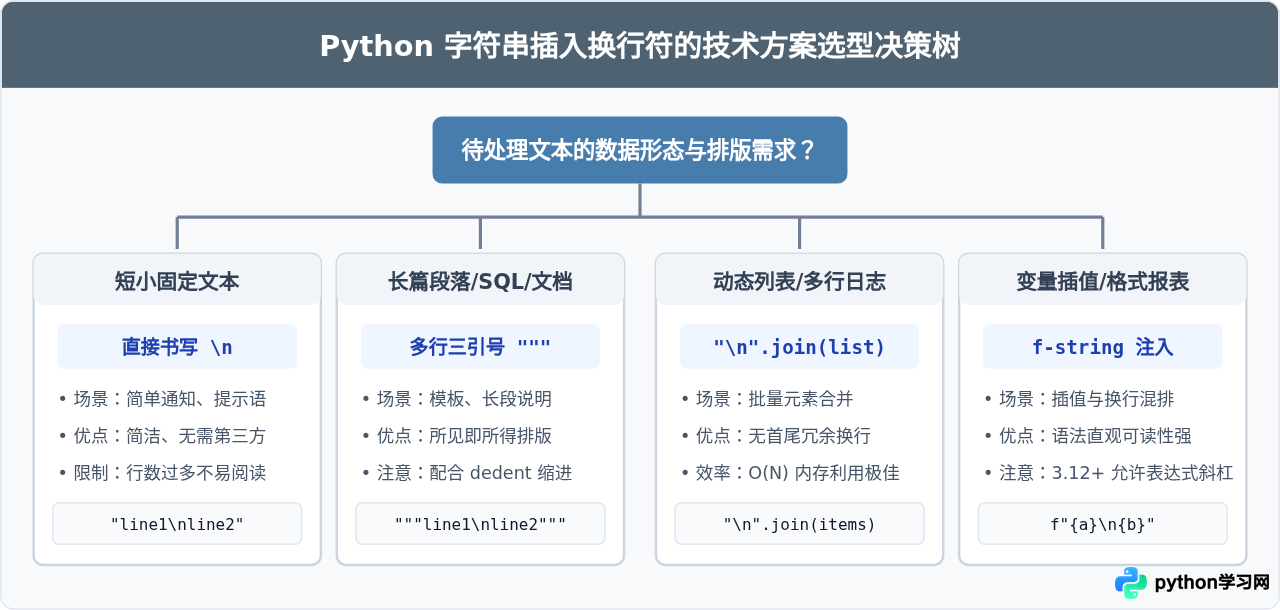
为了便于在编码时快速选取最适合的换行方案,以下整理了各种常见方法的应用特征:
| 实现方式 | 典型代码示例 | 核心优势 | 注意事项 |
|---|---|---|---|
转义字符 \n |
"line1\nline2" |
直接、轻量、通用性强 | 不能用于带 r 前缀的原始字符串中 |
| 多行三引号 | """line1 |
所见即所得,适合大段文本与模板 | 在函数中需配合 textwrap.dedent() 消除缩进 |
str.join() 拼接 |
"\n".join(lines) |
高效、不会产生首尾冗余空行 | 列表中所有元素必须提前转换为字符串类型 |
| f-string 格式化 | f"{user}\n{info}" |
变量与排版结合直观清晰 | Python 3.11 及以下版本大括号内不支持反斜杠 |
print(..., sep="\n") |
print(a, b, sep="\n") |
快速批量逐行打印多个对象 | 仅影响终端打印输出,不改变对象本身 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









