

JupyterAI怎么用大模型辅助写python
本文系统讲解如何在JupyterLab中使用官方Jupyter AI扩展接入大语言模型辅助编写Python,涵盖依赖安装、API密钥配置、侧边栏Jupyternaut对话、%%ai单元格魔法命令、动态变量注入与报错排查修复等实用操作与最佳实践。
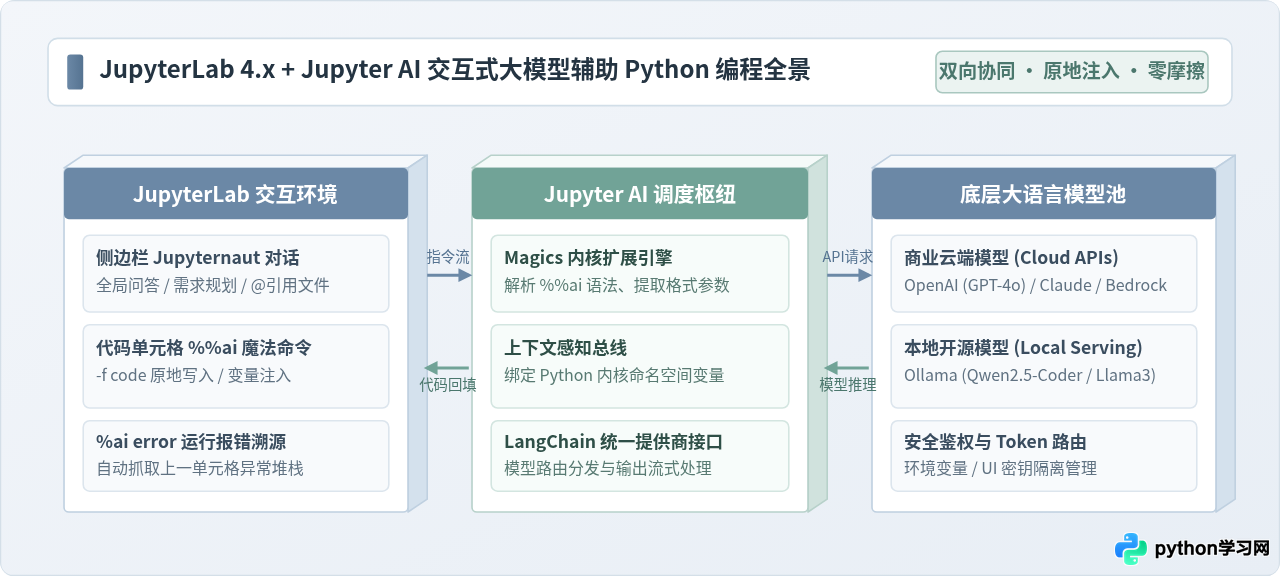
在数据分析与交互式编程中,频繁在浏览器聊天窗口和 Notebook 之间复制粘贴代码不仅打断思路,还容易丢失变量定义与上下文信息。Jupyter AI 是 Project Jupyter 官方维护的开源扩展,它把大语言模型直接接入 JupyterLab 环境。使用它辅助编写 Python 的核心方式有两种:在左侧对话面板中用自然语言交流并让助手生成代码或完整 Notebook,或者在 Notebook 代码单元格中通过 %%ai 魔法命令直接向模型提问并将生成的 Python 代码自动写回单元格。掌握这两项功能,配合运行时错误自动诊断,即可在不脱离 Notebook 的前提下完成日常 Python 脚本的快速编写与调试。
Jupyter AI 的工作原理与上下文感知能力
普通网页端大模型对话工具最大的局限,在于它们不知道当前 Jupyter 内存里存在哪些变量、导入了哪些数据、以及刚才执行的单元格到底报了什么错。如果要把一个数据处理任务讲清楚,通常需要手动复制表格的前几行、列名以及一长串报错信息,沟通过程繁琐低效。
Jupyter AI 通过内核扩展(Kernel Extension)与客户端插件将大模型无缝嵌入到 JupyterLab 内部。它在底层依靠 LangChain 抽象出统一的提供商接口,既能接入 OpenAI、Anthropic 等公有云商业模型,也支持通过 Ollama 连接本地私有部署的开源代码大模型。
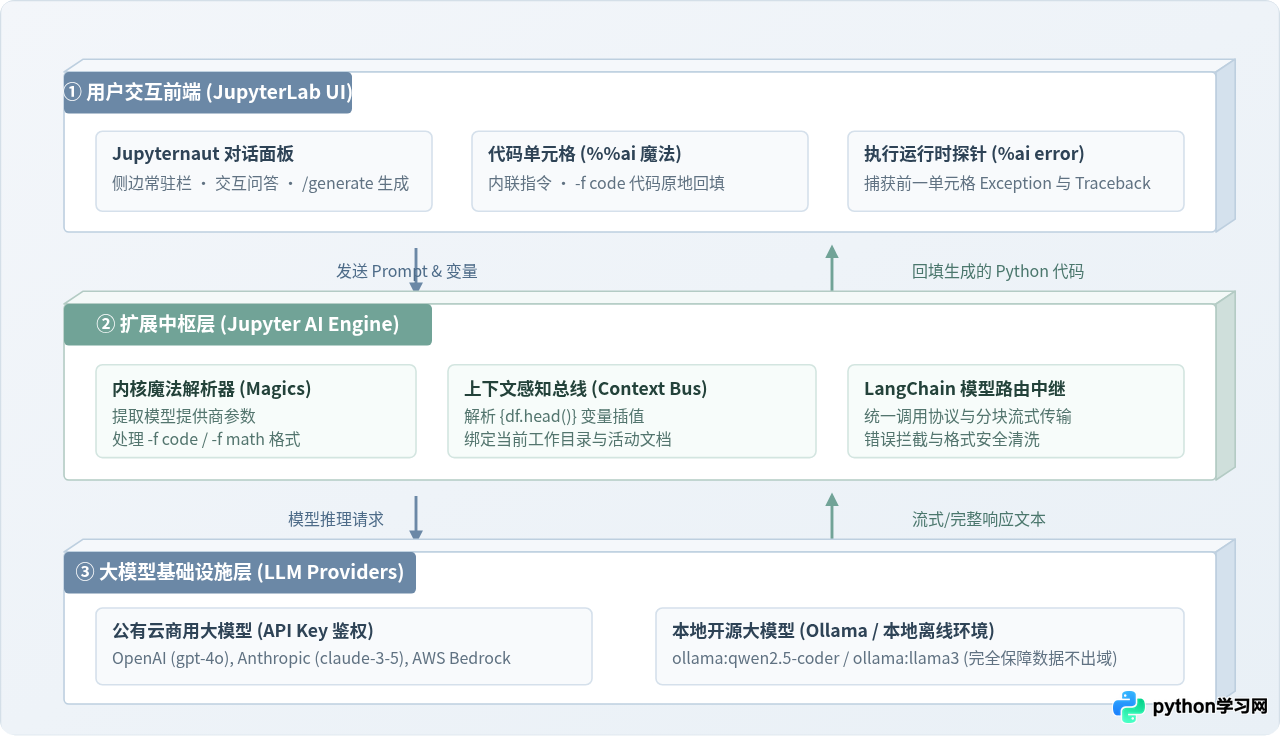
在架构层面,Jupyter AI 分为三个协同层级:
- 前端交互层:提供侧边栏常驻的 Jupyternaut 对话窗口、单元格
%%ai魔法命令解析器,以及行内代码自动补全探针。 - 服务与中枢调度层:包含内核魔法解释器和上下文感知总线。它能够捕获当前活动的 Notebook、读取文件目录,并通过变量插值语法将运行时内存中的 DataFrame 结构直接注入提示词。
- 基础设施层:统一管理 API Key 鉴权、端点路由及流式传输,隔离敏感凭证,保证代码生成过程安全受控。
环境准备与提供商密钥配置
使用 Jupyter AI 前,需要确认本地已具备 Python 3.8 及以上环境,并已安装 JupyterLab 4.x。推荐在独立的虚拟环境(如 Conda 或 venv)中完成安装,避免与已有数据科学包产生版本依赖冲突。
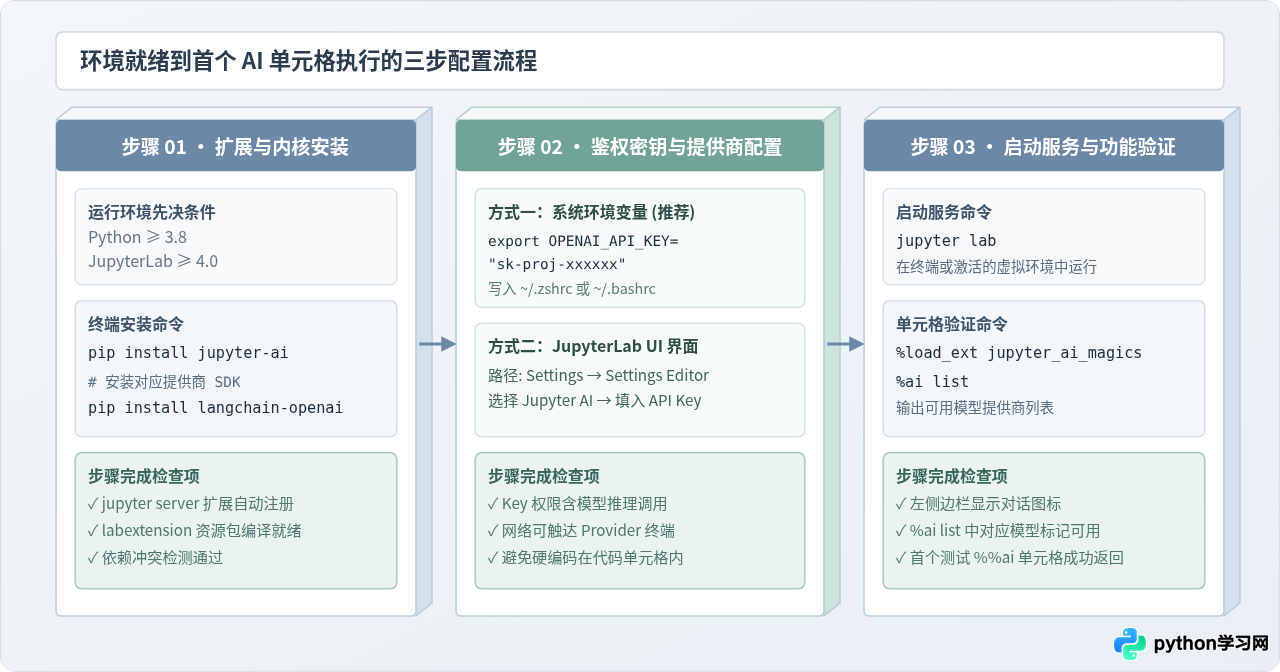
第一步:在终端中安装扩展包
打开系统终端,激活对应的 Python 环境,执行以下命令安装核心包:
# 安装 Jupyter AI 核心包及魔法命令组件
pip install jupyter-ai

# 如果计划使用 OpenAI 模型(如 gpt-4o),同时安装依赖包
pip install langchain-openai
安装完成后,JupyterLab 会自动识别并注册前后端扩展,不需要手动执行额外的构建编译命令。
第二步:注入模型鉴权密钥
大模型服务需要 API Key 才能调用。最安全且便于持续使用的方法是配置系统环境变量。以 OpenAI 为例,在终端配置文件(如 ~/.zshrc 或 ~/.bashrc)中添加:
# 导出对应模型提供商的 API 密钥
export OPENAI_API_KEY="sk-proj-xxxxxxxxxxxxxxxxxxxxxxxx"

# 如果使用 Anthropic Claude 模型,则设置:
export ANTHROPIC_API_KEY="sk-ant-xxxxxxxxxxxxxxxxxxxxxxxx"
添加完成后在终端执行 source ~/.zshrc 使其生效。如果不习惯命令行配置,也可以在启动 JupyterLab 后,依次点击顶部菜单栏的 Settings → Settings Editor,在左侧列表中找到 Jupyter AI,在界面右侧的可视化输入框中直接粘贴各厂商的 API Key。
注意:切勿将 API Key 直接明文硬编码在 .ipynb 单元格内。Notebook 文件往往需要共享或提交到 Git 仓库,明文密钥极易发生泄露导致意外扣费。
第三步:启动服务并验证安装
在终端启动 JupyterLab:
jupyter lab服务启动后,观察 JupyterLab 窗口左侧活动图标栏。如果安装成功,活动栏中会出现一个机器人气泡形状的 Jupyter AI (Jupyternaut) 图标。新建一个 Python 笔记本,在首个单元格输入并运行验证命令:
# 加载 Jupyter AI 魔法命令扩展
%load_ext jupyter_ai_magics

# 列出当前所有可用的模型提供商与接入状态
%ai list
输出结果会以表格形式罗列所有支持的提供商及其模型标识符。凡是已正确配置 API Key 的提供商,状态均会标记为可用。
场景一:利用侧边栏 Jupyternaut 全局对话构思与生成代码
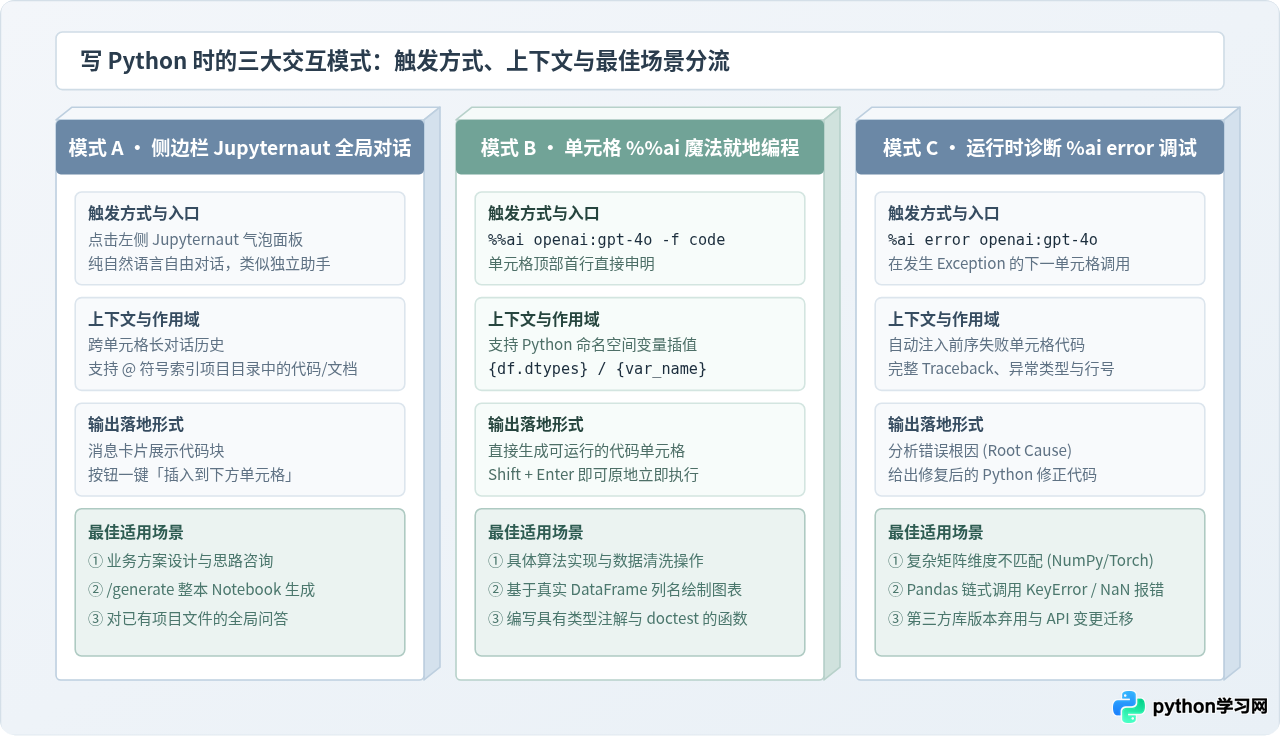
Jupyternaut 是常驻在左侧侧边栏中的交互式助手。它的交互模式与聊天机器人相似,但针对编程场景进行了专门强化。适合在项目初期需要梳理分析逻辑、编写整套多步骤脚本,或者希望从零生成一份完整 Notebook 时使用。
1. 自然语言生成业务代码
点击左侧 Jupyternaut 图标展开对话面板,在下方输入框中输入具体需求,例如:
请编写一段 Python 脚本,使用 requests 和 BeautifulSoup 抓取指定页面中的新闻标题与发布时间,对缺失值进行填充,并将清洗后的结果整理为 Pandas DataFrame 保存为 CSV 文件。Jupyternaut 会在侧边栏回复完整的 Python 代码,并在代码卡片右上角提供两个非常实用的操作按钮:
- Copy to Clipboard(复制):复制代码文本到剪贴板。
- Insert Below Selection(插入下方):直接将代码段作为一个崭新的代码单元格插入到当前 Notebook 光标所在位置,省去了手动创建单元格和粘贴的繁琐操作。
2. 使用 /generate 宏命令生成整本 Notebook
如果需要快速搭建一个完整的数据分析工作流框架,可以使用 Jupyter AI 独有的 /generate 指令。在侧边栏聊天框中输入:
/generate An exploratory data analysis notebook for California Housing dataset using pandas, matplotlib and seaborn
Jupyternaut 会在当前目录下自动新建一个名为 california_housing_eda.ipynb 的文件,并在其中依次创建包含 Markdown 业务说明、数据加载、统计描述、分布可视化图表的连续单元格。开发者只需在此基础上修改数据路径或细化图表样式即可。
场景二:在单元格中使用 %%ai 魔法命令就地编程
如果说侧边栏适合宏观规划,那么 %%ai 单元格魔法命令则是日常写 Python 最频繁、最高效的工具。它允许开发者直接在代码单元格内部向大模型提问,并把生成的代码直接沉淀在单元格中。
1. 基础语法与 -f code 原地写入
%%ai 是一个多行单元格魔法命令,必须写在单元格的第一行。基础语法结构为:
%%ai <提供商名称>:<模型名称> [格式参数]
用户提示词内容...
在写 Python 代码时,强烈建议添加 -f code(或 --format code)参数。如果不加这个参数,大模型默认会返回 Markdown 格式的长篇文字解释;加上 -f code 后,Jupyter AI 会自动剥离任何客套话,将纯粹的可执行 Python 代码直接替换或插入为代码单元格。
例如,在一个空白单元格中输入:
%%ai openai:gpt-4o -f code
编写一个 Python 函数 calculate_moving_average(data, window_size),
使用 collections.deque 实现实时滑动平均值计算,包含类型注解和简单的边界检查。
按下 Shift + Enter 执行该单元格后,Jupyter AI 会调用模型,并在当前单元格下方生成一个整洁的代码单元格:
# 示例生成结果:
from collections import deque
from typing import List, Union

def calculate_moving_average(data: List[Union[int, float]], window_size: int) -> List[float]:
    if window_size <= 0:
        raise ValueError("window_size 必须为正整数")
    if not data:
        return []

    result = []
    window = deque(maxlen=window_size)
    for num in data:
        window.append(num)
        result.append(sum(window) / len(window))
    return result
生成完毕后,代码就是一个标准的 Python 单元格,可以立即再次按 Shift + Enter 编译运行,整个流程一气呵成。
2. 动态变量插值与数据结构感知
在数据清洗和算法编写中,大模型最容易犯的错误就是“幻觉凭空捏造字段名”。例如真实表头是 trans_amt,模型却猜测为 amount,导致代码一运行就报 KeyError。
Jupyter AI 提供了大括号 {表达式} 变量插值功能。在单元格执行前,Jupyter AI 会先提取大括号中的 Python 表达式在当前内核中求值,并将求值结果拼接进 Prompt 发送给大模型。
假设当前内存中已经加载了一个名为 df_sales 的数据表:
# 先在前面单元格中加载了真实数据
import pandas as pd
df_sales = pd.read_csv("sales_data.csv")
紧接着在下一个单元格中使用变量插值写需求:
%%ai openai:gpt-4o -f code
根据当前数据表的结构:
{df_sales.dtypes}

请完成以下数据分析任务:
1. 筛选出交易状态为 'SUCCESS' 且金额大于 500 的记录;
2. 按照用户所属城市分组,计算客单价与总订单数;
3. 将客单价最高的 Top 5 城市使用 seaborn 绘制水平柱状图,添加数据标签。
通过 {df_sales.dtypes},大模型能够精准看到当前表中真实的列名和数据类型,生成的代码会精准对应字段,杜绝字段名称猜测错误。
场景三:代码运行报错排查与自动修复
交互式编程中难以避免会遇到语法错误、张量维度不一致或空指针异常。传统做法是把异常 Traceback 复制到搜索引擎或大模型聊天窗口排查;而在 Jupyter AI 中,可以使用单行魔法命令 %ai error 实现一键诊断。
1. 使用 %ai error 自动捕获堆栈
假设在运行一段矩阵计算或数据切片代码时抛出了异常:
# 发生报错的单元格代码示例:
import numpy as np

matrix_a = np.ones((3, 4))
matrix_b = np.ones((5, 3))
result = np.dot(matrix_a, matrix_b)
此时控制台输出了一长串 ValueError: shapes (3,4) and (5,3) not aligned: 4 (dim 1) != 5 (dim 0) 报错堆栈。
此时无需复制任何文字,直接在下方新建一个单元格,运行:
%ai error openai:gpt-4oJupyter AI 会自动从内核提取上一单元格的代码文本和执行 Traceback,直接打包发给模型。模型会明确指出:
- 报错原因:矩阵点积运算要求前一个矩阵的列数等于后一个矩阵的行数。当前
matrix_a的列数为 4,而matrix_b的行数为 5,维度不匹配。 - 修复方案:应将
matrix_b进行转置(matrix_b.T)或调整点积相乘顺序为np.dot(matrix_b, matrix_a)。 - 修正后的完整代码:给出可直接替换执行的代码块。
本地开源大模型接入(Ollama 离线无密钥方案)
在很多企事业单位或涉及专有数据资产的场景下,业务数据和代码逻辑不能上传到公网云端 API。Jupyter AI 支持直接连接本地运行的开源大模型,完全在局域网甚至断网环境下辅助编写 Python。
目前最便捷的本地部署方案是配合 Ollama 使用专门的代码模型(如 Qwen2.5-Coder、DeepSeek-Coder 或 Llama 3)。
1. 本地启动 Ollama 并拉取代码模型
在系统终端中运行:
# 启动 Ollama 服务并下载针对代码场景微调的高性能模型
ollama run qwen2.5-coder:7b
2. 在 Jupyter 中指定 ollama 提供商
由于 Ollama 在本地默认监听 http://localhost:11434,Jupyter AI 无需额外配置密钥即可直接识别。在 Notebook 单元格中直接调用:
%%ai ollama:qwen2.5-coder:7b -f code
编写一个基于 Python threading 和 Queue 的生产者-消费者多线程模型,
要求支持优雅退出(Graceful Shutdown),并带有简单的执行测试代码。
该命令的所有推理计算全部在本地 GPU 或 CPU 上完成,任何提示词与代码均不出本地机器,兼顾了开发效率与数据合规安全性。
提高代码生成质量的实用经验与注意事项
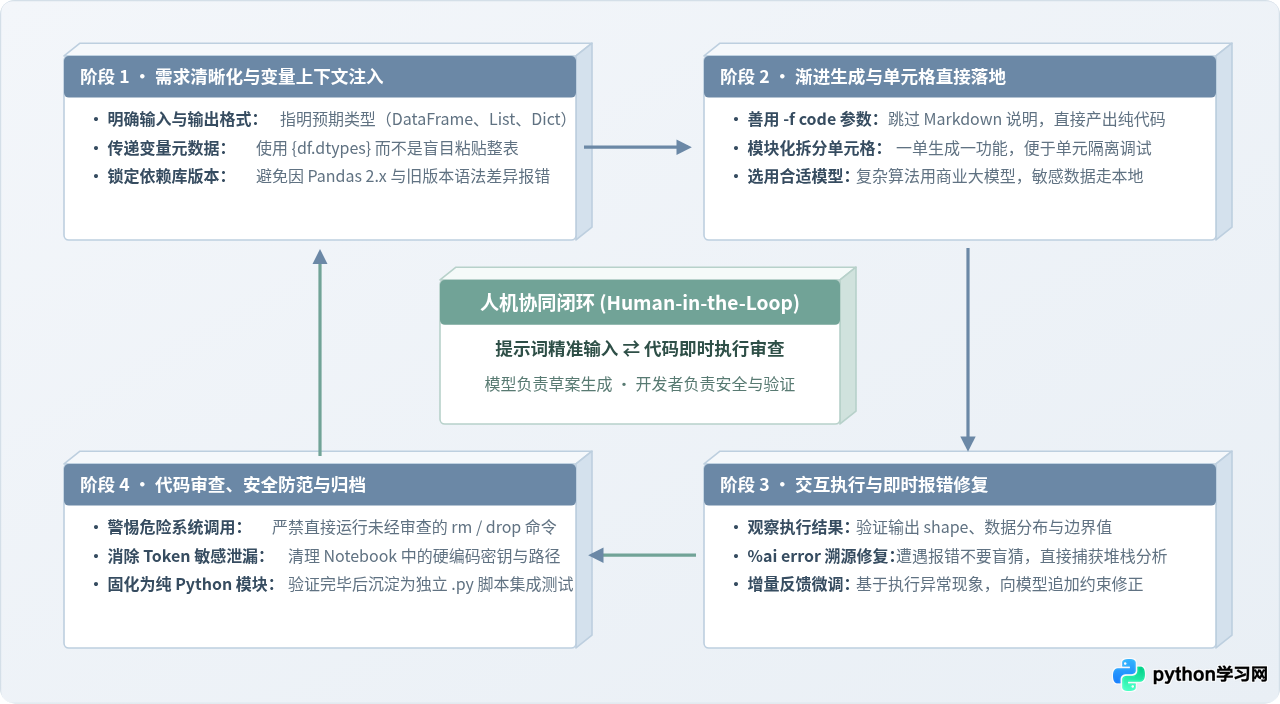
大模型能够大幅减少样板代码的编写耗时,但在实际使用中,输出质量严重依赖于输入质量。结合人机协同开发闭环,总结出以下四项关键规范:
| 实践环节 | 常见误区 | 规范做法 |
|---|---|---|
| 需求输入 | 仅给出模糊目标,如“帮我分析一下销售数据” | 明确指明使用的库(如 Pandas 2.x)、目标函数名、输入参数格式与返回值类型 |
| 变量插值 | 将整张大表 {df.to_string()} 完整传入,超出上下文上限 |
仅传递表头结构与前两行样本,如 {df.dtypes} 或 {df.head(2)} |
| 单元格颗粒度 | 一个提示词要求生成几百行涉及爬虫、入库、绘图的巨型脚本 | 按功能分步推进,一个单元格仅聚焦一项独立子任务,降低调试难度 |
| 代码执行审查 | 不看逻辑直接盲目运行生成代码 | 重点审查文件系统删除、外部网络请求与数据库更新操作,防止误操作 |
进阶提示:在 Notebook 探索性试验结束后,应将已验证正确的核心逻辑提炼整合为标准的 .py 模块文件,编写单元测试并提交版本控制,避免在长期维护的项目中保留大量带有 %%ai 临时生成标记的未归档单元格。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









