

在Python大型项目中应用工厂模式管理数据导入类
深入探讨在Python大型工程项目中,如何利用抽象基类与注册制工厂模式解耦海量异构数据导入逻辑,实现高内聚、低耦合与易扩展的现代数据管道架构。
一、情境痛点:当数据源从三种膨胀到三十种
假设我们正在开发一个大型自动化数据分析与入库系统。最初系统只需要接入本地运营提交的 CSV 报表与配置 JSON。开发人员通常会在主业务流水线中直接写出如下所示的紧耦合逻辑:
# 典型的反模式:调用方强依赖于具体导入类与冗长的分支判定
def run_pipeline(source_path: str, format_type: str):
    if format_type == "csv":
        importer = CSVDataImporter(encoding="utf-8")
        data = importer.load_and_parse(source_path)
    elif format_type == "json":
        importer = JSONDataImporter(strict_mode=True)
        data = importer.load_and_parse(source_path)
    elif format_type == "parquet":
        importer = ParquetDataImporter()
        data = importer.load_and_parse(source_path)
    else:
        raise ValueError(f"暂不支持的数据格式: {format_type}")

    process_data(data)
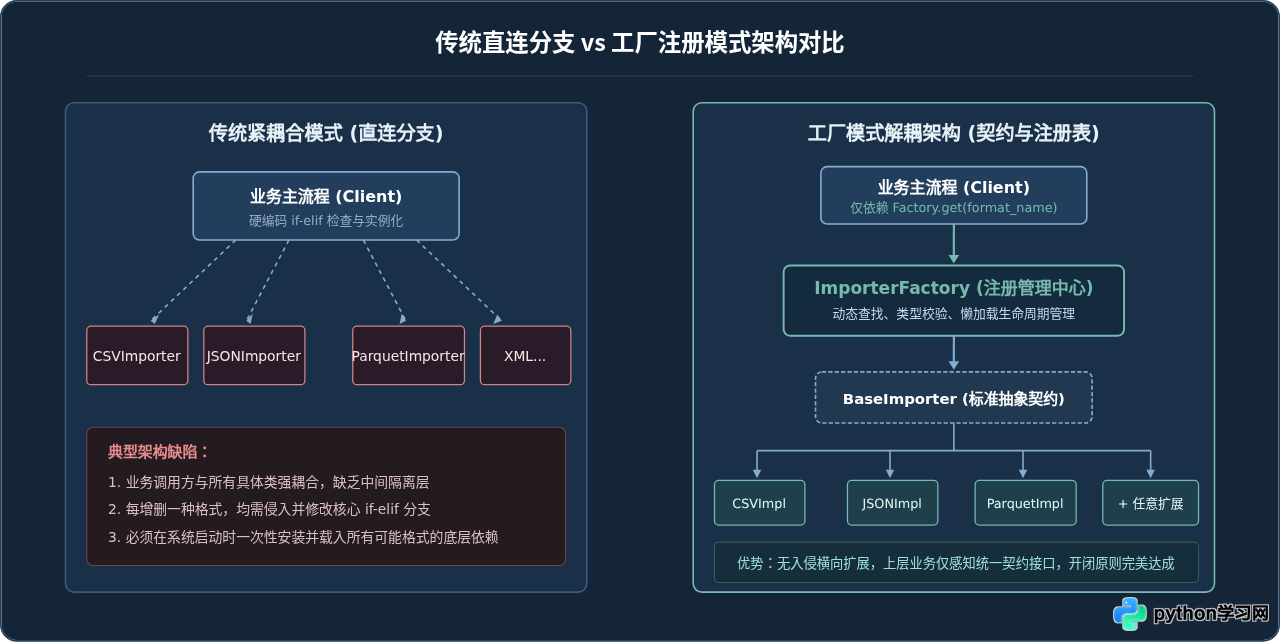
随着系统向企业级中台演进,外部接入方带来了 Excel (.xlsx/.xls)、ORC、Avro、MySQL Dump、XML 以及各类专有传感器二进制数据流。如果继续沿用这种直连模式,业务代码将面临三大致命架构风险:
- 破坏开闭原则(Open-Closed Principle):每次新增或废弃一种数据格式,工程师都必须修改核心调度函数所在的源文件,极易引发回归故障。
- 重量级依赖污染与启动延迟:所有导入类的依赖库(例如处理 Parquet 必须的
pyarrow、读取 Excel 必须的openpyxl)都在模块顶层被无差别加载。哪怕流水线只需要处理一个 10KB 的 CSV,进程也必须承受漫长且庞大的内存初始化开销。 - 契约规范缺失:缺乏严格的抽象约束,不同工程师编写的具体导入类方法各异(有的叫
load_file,有的叫parse_stream),导致上层批处理引擎无法实行多态化管道调度。
二、核心契约设计:用抽象基类(ABC)规范导入行为
在设计模式中,工厂模式的核心价值建立在“针对接口编程而非针对实现编程”的前提之上。在大型 Python 项目中,我们使用标准库 abc 模块来定义所有数据导入类必须遵从的契约规范。
一个高质量的数据导入基类不仅仅是一个空函数容器,它应当承担三项职责:
- 输入源标准化抽象:统一支持文件路径(
Path)、二进制流(IOBase)或连接描述符。 - 生命周期钩子(Hooks):提供资源预检查、解析、数据合法性校验与资源释放的标准化模板流程。
- 元数据自省能力:提供支持的扩展名、MIME 类型及默认编码声明。
from abc import ABC, abstractmethod
from pathlib import Path
from typing import Any, Dict, List, Optional, Union
import logging

logger = logging.getLogger(__name__)

class BaseImporter(ABC):
    """所有数据导入类的抽象基类,规范标准导入契约"""

    def __init__(self, **options: Any) -> None:
        self.options: Dict[str, Any] = options
        self._validate_options()

    def _validate_options(self) -> None:
        """可选的参数校验钩子,子类可覆盖"""
        pass

    @classmethod
    @abstractmethod
    def supported_extensions(cls) -> List[str]:
        """返回该导入器支持的文件扩展名列表,如 ['.csv', '.tsv']"""
        raise NotImplementedError

    @abstractmethod
    def load(self, source: Union[str, Path]) -> List[Dict[str, Any]]:
        """
        核心导入方法:解析数据源并返回标准字典列表。

        :param source: 数据源路径或标识符
        :return: 结构化解析结果
        :raises DataImportError: 导入解析过程发生异常时统一抛出的自定义业务异常
        """
        raise NotImplementedError

    def validate_content(self, data: List[Dict[str, Any]]) -> bool:
        """通用数据有效性检查逻辑"""
        return len(data) > 0
三、进阶实现:基于装饰器的插件式注册制工厂
在经典面向对象教科书中,工厂类经常被实现为包含内部巨大 match-case 或 if-elif 结构的工厂方法。但在大型工程中,这种“简单工厂”依然需要集中维护代码,只要新增格式就必须修改工厂类内部,违背开闭原则。
大型项目中最优雅的方案是“注册制工厂(Registry Pattern)”配合类装饰器。让具体导入类在自身模块中主动声明自己支持的格式;工厂本身只保留一个动态哈希注册表与创建入口。
from typing import Callable, Dict, Type, Optional
import os

class ImporterFactory:
    """集中式数据导入类工厂与注册中心"""

    _registry: Dict[str, Type[BaseImporter]] = {}

    @classmethod
    def register(cls, format_key: str) -> Callable[[Type[BaseImporter]], Type[BaseImporter]]:
        """
        类装饰器:用于将具体导入器注册到工厂中。

        用法:
            @ImporterFactory.register("csv")
            class CSVImporter(BaseImporter):
                ...
        """
        def decorator(subclass: Type[BaseImporter]) -> Type[BaseImporter]:
            normalized_key = format_key.lower().strip().lstrip(".")
            if normalized_key in cls._registry:
                logger.warning(
                    "导入格式 '%s' 已被 %s 注册,当前将被 %s 覆盖",
                    normalized_key, cls._registry[normalized_key].__name__, subclass.__name__
                )
            cls._registry[normalized_key] = subclass
            return subclass
        return decorator

    @classmethod
    def get_importer(cls, format_key: str, **kwargs: Any) -> BaseImporter:
        """
        根据格式标识符实例化对应的导入类。
        """
        normalized_key = format_key.lower().strip().lstrip(".")
        importer_cls = cls._registry.get(normalized_key)

        if not importer_cls:
            supported = ", ".join(cls._registry.keys())
            raise ValueError(f"未知的导入格式: '{format_key}'。当前支持的格式: [{supported}]")

        return importer_cls(**kwargs)

    @classmethod
    def create_from_path(cls, file_path: Union[str, Path], **kwargs: Any) -> BaseImporter:
        """
        根据文件路径后缀名自动探测并实例化对应的导入器。
        """
        path = Path(file_path)
        ext = path.suffix.lower().lstrip(".")
        if not ext:
            raise ValueError(f"无法从文件路径 '{file_path}' 中推断扩展名")
        return cls.get_importer(ext, **kwargs)
现在,编写具体格式导入类时,只需引入基类和工厂装饰器。每个具体类完全隔离在自己的文件中,甚至可以由不同团队并行维护:
# 文件路径: app/importers/csv_importer.py
import csv
from pathlib import Path
from typing import Any, Dict, List, Union
from .base import BaseImporter
from .factory import ImporterFactory

@ImporterFactory.register("csv")
@ImporterFactory.register("tsv")
class CSVImporter(BaseImporter):
    @classmethod
    def supported_extensions(cls) -> List[str]:
        return [".csv", ".tsv"]

    def load(self, source: Union[str, Path]) -> List[Dict[str, Any]]:
        path = Path(source)
        delimiter = "\t" if path.suffix.lower() == ".tsv" else self.options.get("delimiter", ",")
        encoding = self.options.get("encoding", "utf-8")

        with path.open("r", encoding=encoding) as f:
            reader = csv.DictReader(f, delimiter=delimiter)
            return [dict(row) for row in reader]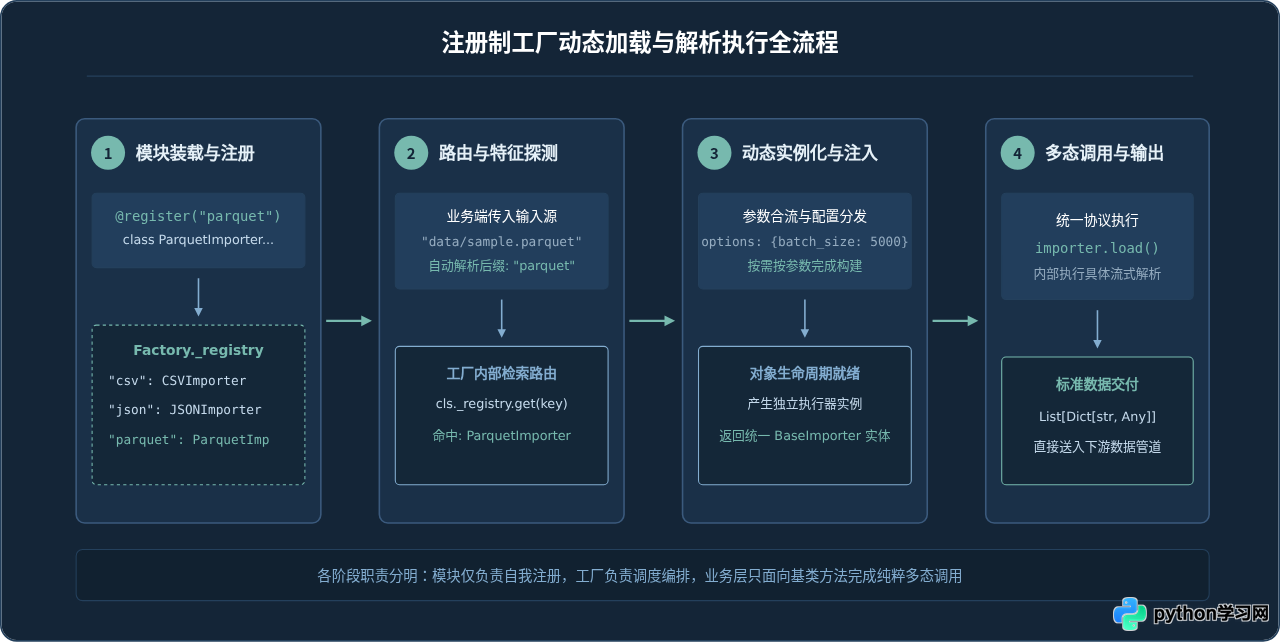
四、大型项目中的深度优化:动态懒加载与包隔离
当项目包含数十种导入类时,另一个严峻问题随之而来:如果用户只是执行一个轻量级的 JSON 导入,系统却在启动时预先载入了 pyarrow(Parquet 依赖,内存数十 MB)或 openpyxl,甚至因为某些机器缺少非必需的 C 扩展编译库而直接导致启动崩溃。
在企业级架构中,必须引入“延迟加载(Lazy Loading)”与“自动服务发现(Plugin Discovery)”机制。通过 Python 的标准库 importlib,工厂可以只在首次请求特定格式时,才按需加载该具体模块,并在具体模块中按需引用第三方重型依赖。
import importlib
import pkgutil
from typing import Set

class LazyImporterFactory(ImporterFactory):
    """具备自动发现与按需懒加载能力的企业级导入工厂"""

    _discovered_modules: Set[str] = set()
    _module_prefix = "app.importers.plugins"

    @classmethod
    def auto_discover_plugins(cls) -> None:
        """
        自动遍历指定插件包目录下的所有模块。
        仅扫描模块名,不立即深度加载重型模块,避免冷启动耗时。
        """
        try:
            package = importlib.import_module(cls._module_prefix)
        except ImportError:
            logger.info("未发现插件目录 %s,跳过自动扫描", cls._module_prefix)
            return

        for _, module_name, _ in pkgutil.iter_modules(package.__path__):
            full_module_name = f"{cls._module_prefix}.{module_name}"
            cls._discovered_modules.add(full_module_name)

    @classmethod
    def get_importer(cls, format_key: str, **kwargs: Any) -> BaseImporter:
        normalized_key = format_key.lower().strip().lstrip(".")

        # 若当前注册表中未找到,尝试按命名规范动态按需加载插件模块
        if normalized_key not in cls._registry:
            candidate_module = f"{cls._module_prefix}.{normalized_key}_importer"
            try:
                # 动态载入模块,触发其内部的 @ImporterFactory.register
                importlib.import_module(candidate_module)
                logger.info("已完成插件模块懒加载: %s", candidate_module)
            except ImportError as e:
                logger.debug("未找到对应的自动加载模块 %s: %s", candidate_module, e)

        # 再次调用父类检索已注册类
        return super().get_importer(normalized_key, **kwargs)
与此同时,在编写具体的导入器时,将笨重的可选第三方库放在具体的导入方法中或封装在私有辅助方法中进行延迟导入:
# 插件文件: app/importers/plugins/parquet_importer.py
from typing import Any, Dict, List, Union
from pathlib import Path
from ..base import BaseImporter
from ..factory import ImporterFactory

@ImporterFactory.register("parquet")
class ParquetImporter(BaseImporter):
    @classmethod
    def supported_extensions(cls) -> List[str]:
        return [".parquet", ".pq"]

    def load(self, source: Union[str, Path]) -> List[Dict[str, Any]]:
        # 懒导入重型依赖:仅在实际执行 Parquet 解析时才加载 pyarrow
        try:
            import pyarrow.parquet as pq
        except ImportError as exc:
            raise RuntimeError(
                "解析 Parquet 格式需要额外依赖 pyarrow。请执行 `pip install pyarrow` 进行安装。"
            ) from exc

        table = pq.read_table(str(source))
        return table.to_pylist()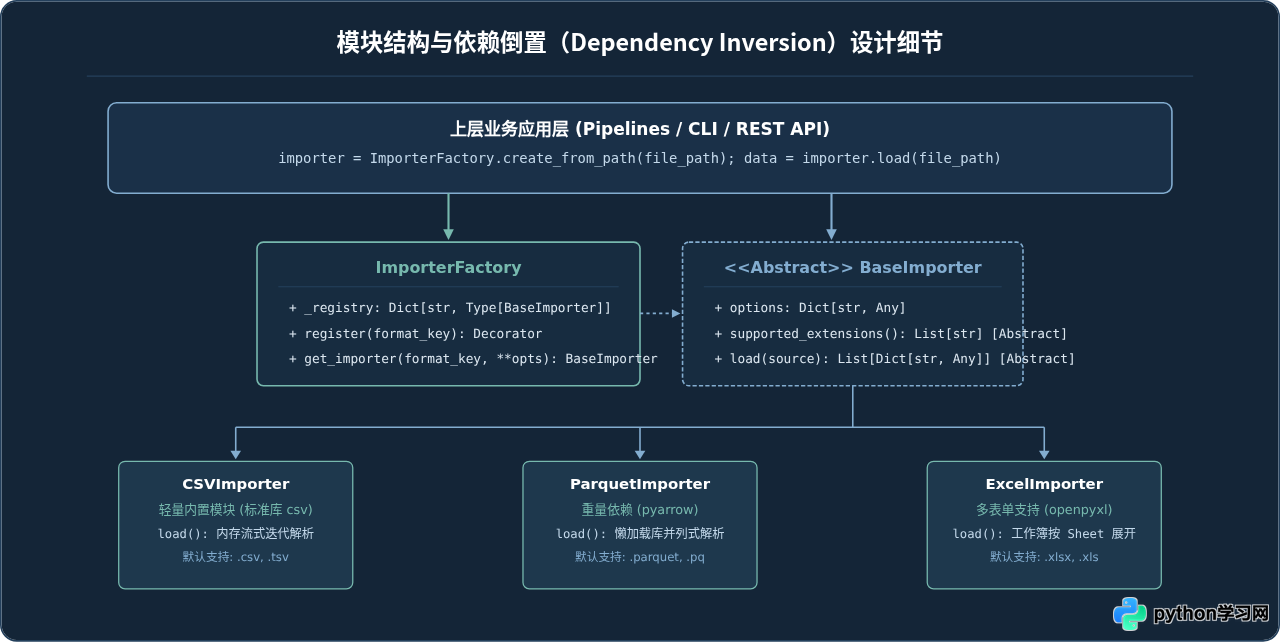
五、生产环境高可用工程实践
在严肃的企业生产环境中,除了上述的基础模式实现,还需要补齐三项关键能力:统一配置注入、上下文异常隔离与单元测试桩支持。
1. 统一配置上下文注入
大型应用通常由 YAML 或环境变量提供全局配置。工厂应当支持向具体导入器统一注入通用运行选项(如默认编码、并发度、临时目录路径),同时保留格式专属参数:
# 生产环境配置分发器示例
class ConfiguredDataDispatcher:
    def __init__(self, global_settings: Dict[str, Any]):
        self.global_settings = global_settings

    def dispatch(self, file_path: str, custom_options: Optional[Dict[str, Any]] = None) -> List[Dict[str, Any]]:
        merged_options = {**self.global_settings, **(custom_options or {})}

        # 由工厂统一分发,隔离具体类的创建细节
        importer = ImporterFactory.create_from_path(file_path, **merged_options)
        return importer.load(file_path)
2. 异常隔离与上下文溯源
数据导入最常遇到编码不匹配、字段截断或格式损坏。如果具体类抛出的原生错误(如 csv.Error、json.JSONDecodeError、ArrowInvalid)未经处理直接冒泡,调用方将无法做统一捕获处理。推荐定义统一的 DataImportException 层次:
class DataImportError(Exception):
    """数据导入核心基础异常"""
    def __init__(self, message: str, source_path: Union[str, Path], cause: Optional[Exception] = None):
        super().__init__(message)
        self.source_path = str(source_path)
        self.cause = cause

class FormatNotSupportedError(DataImportError):
    """格式未知或未注册异常"""
    pass

class CorruptedSourceError(DataImportError):
    """源文件损坏或不符合规范异常"""
    pass
3. 单元测试与 Mock 隔离策略
工厂模式的一大显著工程优势在于极度易于编写单测。当需要测试上层数据编排业务时,测试用例无需在磁盘上创建真实的 Parquet 或 Excel 文件,只需向工厂注册一个虚拟的 Mock Importer 即可实现无外部依赖的高速测试:
def test_pipeline_with_mock_importer():
    # 动态定义并注册测试专用的假导入器
    @ImporterFactory.register("mock_test")
    class MockDataImporter(BaseImporter):
        @classmethod
        def supported_extensions(cls):
            return [".mock"]

        def load(self, source):
            return [{"id": 1, "name": "test_record"}]

    # 测试管道调度
    importer = ImporterFactory.get_importer("mock_test")
    result = importer.load("fake_path.mock")

    assert len(result) == 1
    assert result[0]["name"] == "test_record"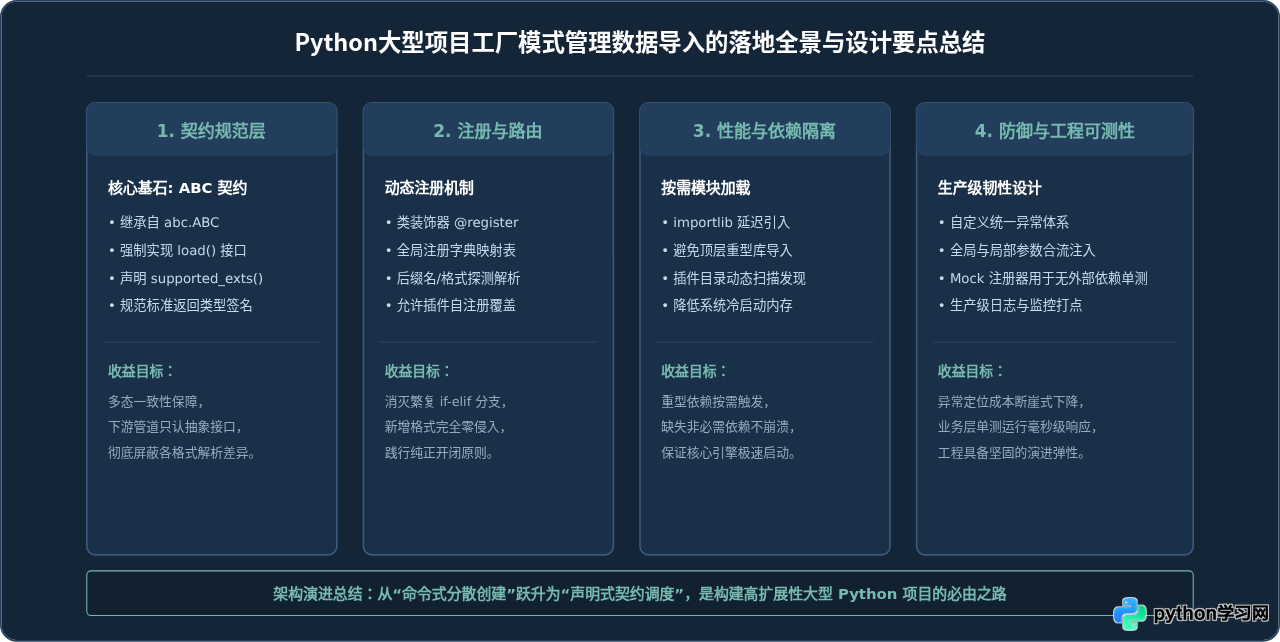
六、总结与落地建议
在大型 Python 系统中管理不断膨胀的数据导入类,本质上是在寻找架构灵活性与系统复杂度之间的最佳平衡点。过度的简单工厂容易沦为巨大的“上帝分支”,而单纯的接口又缺乏自愈和动态发现能力。
通过本文介绍的“抽象契约 + 装饰器注册中心 + 按需懒加载 + 统一异常封装”组合拳,团队可以获得以下立竿见影的工程收益:
- 协同开发无冲突:不同的数据团队可以各自维护自己的格式解析插件,无需互相争抢修改主流程文件。
- 资源消耗按需调配:服务器无需在容器启动时加载全部解析工具包,有效压缩了 Docker 容器冷启动时间与基础内存占用。
- 可测试性大幅跃迁:业务主流程彻底摆脱对真实磁盘文件的依赖,单元测试与持续集成变得轻快且健壮。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









