

Python执行JS后返回数据中文乱码怎么处理
深入分析Python调用JavaScript代码返回中文乱码的产生根源,系统讲解标准流编码配置、PyExecJS运行时修补、Base64安全通道及Unicode转义反序列化等实用解决方案。
一、识别乱码的典型表现与产生原因
Python 本身并不具备原生执行 JavaScript 代码的能力,通常是通过子进程(如 subprocess 启动 Node.js)或者利用桥接库(如 PyExecJS、quickjs)间接调用外部脚本引擎。在这个过程中,数据需要跨越进程边界传输,一旦两端的编码约定不一致,就会产生乱码。
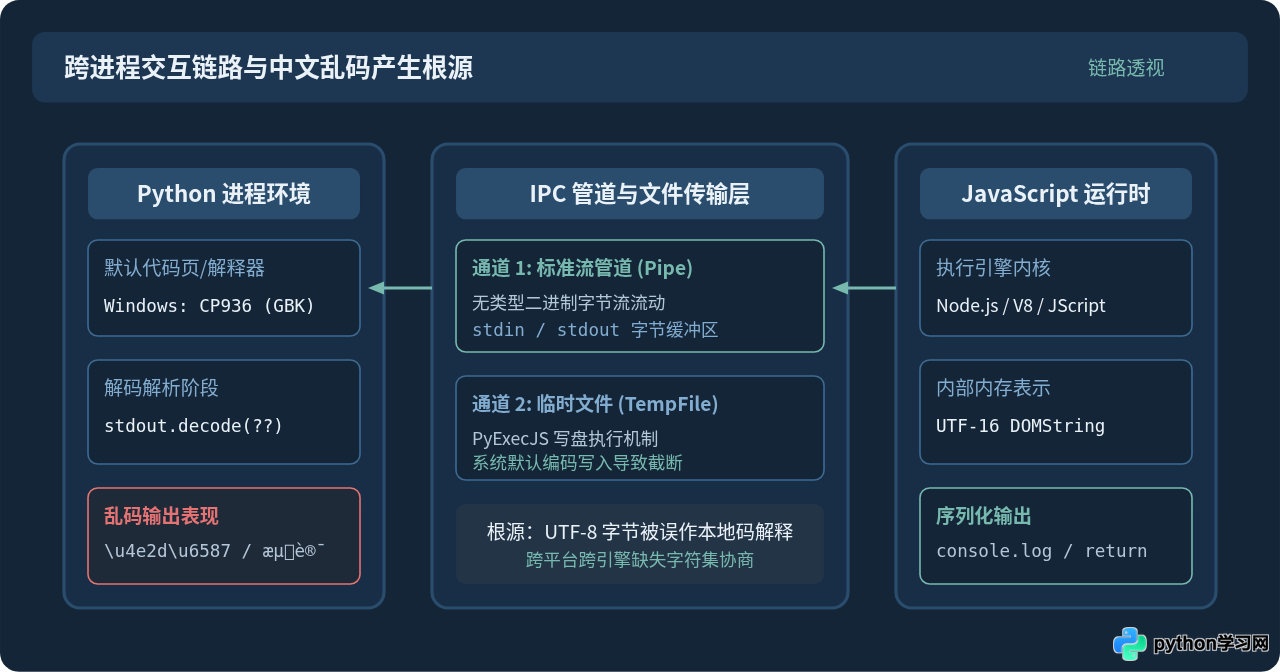
常见的乱码形态主要分为以下三类:
- Unicode 转义序列未还原:返回的内容形如
\u4e2d\u6587\u6d4b\u8bd5。这并不是真正的字节乱码,而是 JS 在输出 JSON 或对象时将非 ASCII 字符转义成了 Unicode 字面量,Python 端仅当作纯文本接收而没有反序列化。 - UTF-8 字节被误用 GBK/CP936 解码:在 Windows 环境下最常见,Node.js 默认以 UTF-8 编码向标准输出写入字节,但 Windows 上的 Python 进程默认采用本地 ANSI 代码页(CP936)读取管道,导致产生大量不可读的拼合乱码,甚至直接报错
UnicodeDecodeError。 - 双重编码(Latin-1 错位):UTF-8 格式的中文经过特定序列化工具传输时被强制视作单字节字符集(ISO-8859-1)处理,表现为
æµè¯这类带有西欧重音符的特征字符。
二、问题排查与定位步骤
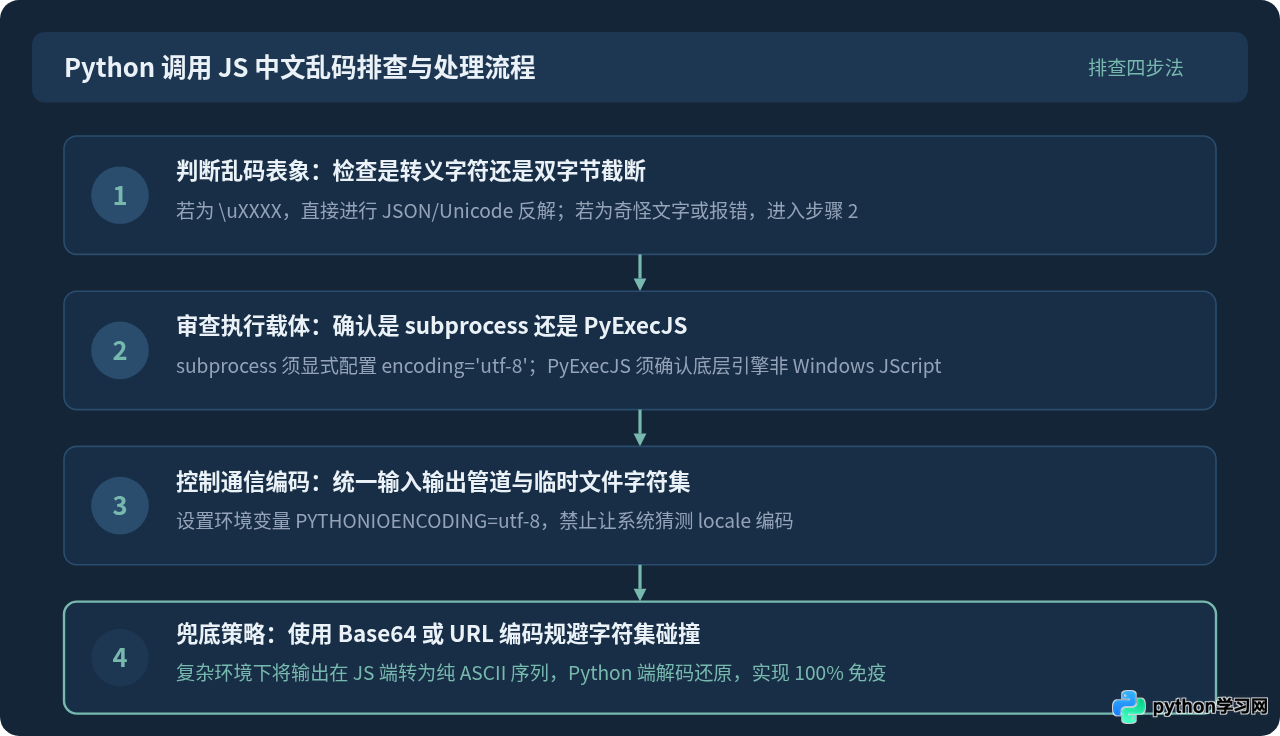
解决乱码需要根据实际的技术链路按序排查,确定问题到底发生在 JS 序列化阶段、IPC 管道阶段,还是 Python 的字符串还原阶段。
三、三大核心解决方案与代码实现
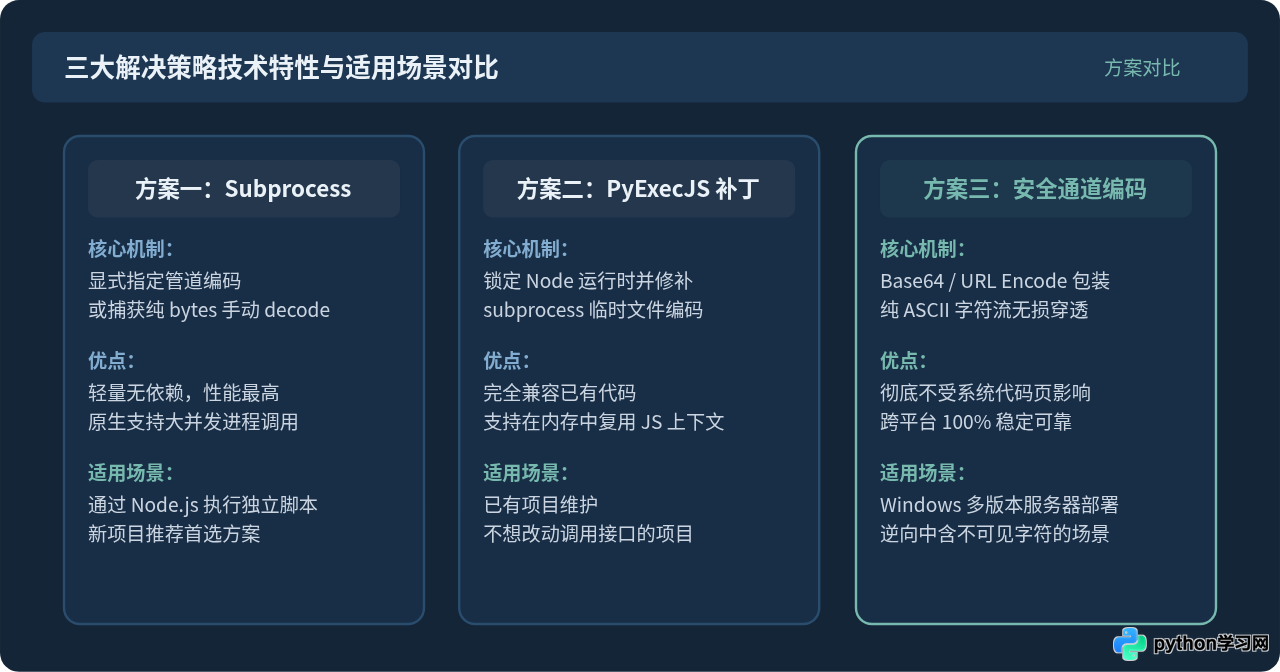
在明确了乱码原因后,开发者可以根据当前所使用的技术栈选择最契合的处理方案。
方案 1:使用 subprocess 显式指定 UTF-8 管道
如果是通过 Python 的 subprocess 模块直接调用 Node.js,切勿省略 encoding 参数。若不显式指定,Python 3 将回退到系统本地默认编码(Windows 下为 CP936)。
import subprocess
import json

# 示例:通过 subprocess 执行 Node.js 代码并显式指定 UTF-8 编码
js_code = """
const userInfo = { name: "张三", role: "管理员", city: "北京" };
console.log(JSON.stringify(userInfo));
"""

# 正确做法:显式指定 encoding='utf-8',避免回退到系统本地 ANSI 编码
result = subprocess.run(
    ["node", "-e", js_code],
    capture_output=True,
    text=True,
    encoding="utf-8"
)

if result.returncode == 0:
    data = json.loads(result.stdout)
    print("解析结果:", data["name"], data["city"])
else:
    print("执行失败:", result.stderr)
如果需要更细粒度的控制,建议直接以纯二进制字节模式读取输出(不设置 text=True),随后显式使用 decode('utf-8', errors='replace') 进行安全解码:
# 以二进制方式接收原始字节流,规避管道自动解码中的截断异常
raw_result = subprocess.run(["node", "-e", js_code], capture_output=True)
output_str = raw_result.stdout.decode("utf-8", errors="replace")
print("安全解码输出:", output_str)
方案 2:修复 PyExecJS 在 Windows 上的默认编码陷阱
许多爬虫逆向项目依然采用 PyExecJS 库。该库在 Windows 环境下有两个著名缺陷:
- 默认可能使用系统自带的
JScript(cscript.exe),其底层字符集受限于系统本地代码页; - 其内部调用
subprocess.Popen生成临时文件并读取输出时,未显式传参encoding='utf-8'。
针对 PyExecJS 的标准修复方案包含“指定 Node 运行时”与“环境变量/运行时修补”两步:
import os
import execjs

# 步骤 1:强制指定运行时为 Node.js,防止其降级为 JScript
os.environ["EXECJS_RUNTIME"] = "Node"

# 步骤 2:设置标准 I/O 环境变量为 UTF-8
os.environ["PYTHONIOENCODING"] = "utf-8"

# 步骤 3:在导入或使用前,通过 Monkey Patch 确保 subprocess 默认采用 utf-8
import subprocess
_original_popen = subprocess.Popen

def patched_popen(*args, **kwargs):
    if "encoding" not in kwargs and kwargs.get("text", False):
        kwargs["encoding"] = "utf-8"
    return _original_popen(*args, **kwargs)

subprocess.Popen = patched_popen

# 编译并执行 JS
ctx = execjs.compile("""
function getInfo() {
    return { title: "Python与JS跨语言交互", status: "成功" };
}
""")
data = ctx.call("getInfo")
print("PyExecJS 接收中文:", data)
方案 3:Base64 / URL Encode 安全通道传输(终极防御)
在某些企业内网受限机器、定制精简版 Windows 或复杂的 Docker 镜像中,环境变量和管道编码设置可能被底层宿主覆盖。此时,最稳健的做法是在 JS 端直接将返回值编码为纯 ASCII 字符流,到达 Python 后再反解。
import subprocess
import urllib.parse
import json

# 方案 3.1:URL 编码(encodeURIComponent)
js_code_url = """
function generateData() {
    const raw = { msg: "数据包含特殊中文及符号:¥100 & 测试" };
    // 在 JS 端将内容转为标准 URI 编码串(全 ASCII)
    return encodeURIComponent(JSON.stringify(raw));
}
console.log(generateData());
"""

res = subprocess.run(["node", "-e", js_code_url], capture_output=True, text=True)
# Python 端使用 unquote 还原
decoded_json_str = urllib.parse.unquote(res.stdout.strip())
data = json.loads(decoded_json_str)
print("URL 编码安全还原:", data["msg"])
对于二进制数据或长文本,也可以在 JS 端使用 Base64 编码输出,Python 端通过 base64.b64decode() 解码:
import base64

# 方案 3.2:Base64 编码
js_code_b64 = """
const payload = { result: "高性能计算结果:深度学习模型预测完成" };
const b64 = Buffer.from(JSON.stringify(payload)).toString('base64');
console.log(b64);
"""

res = subprocess.run(["node", "-e", js_code_b64], capture_output=True, text=True)
json_bytes = base64.b64decode(res.stdout.strip())
final_data = json.loads(json_bytes.decode("utf-8"))
print("Base64 安全还原:", final_data["result"])
四、特殊场景:处理 \uXXXX 形式的 Unicode 转义序列
有时 Python 打印出来的中文既不是乱码也不是报错,而是形如 \u6570\u636e\u8fd4\u56de 的字符串。这通常发生在 JS 进行了 JSON.stringify() 序列化,或者直接返回了未反转义的字面量。
"\u4e2d\u6587" 且 len 为 6(包含斜杠与 u 字符),说明它是一个包含了转义字符的普通字符串,而非真实的中文 Unicode 码点。
处理这种序列可以直接利用 Python 的 json.loads 或原生编码器:
import json

raw_escaped_str = r'{"status": "\u6210\u529f", "message": "\u64cd\u4f5c\u5b8c\u6210"}'

# 正确还原方法 1:通过 json.loads 自动解析 Unicode 转义
parsed = json.loads(raw_escaped_str)
print("JSON 解析:", parsed["message"])  # 输出:操作完成

# 正确还原方法 2:针对单独的转义字符串使用 raw_unicode_escape 解码
single_escaped = r"\u6210\u529f"
restored = single_escaped.encode("utf-8").decode("unicode_escape")
print("单串解码:", restored)  # 输出:成功
五、总结与排查速查清单
为避免线上环境再次发生偶发性中文乱码,可以将排查逻辑与最佳实践归纳为以下全景图:
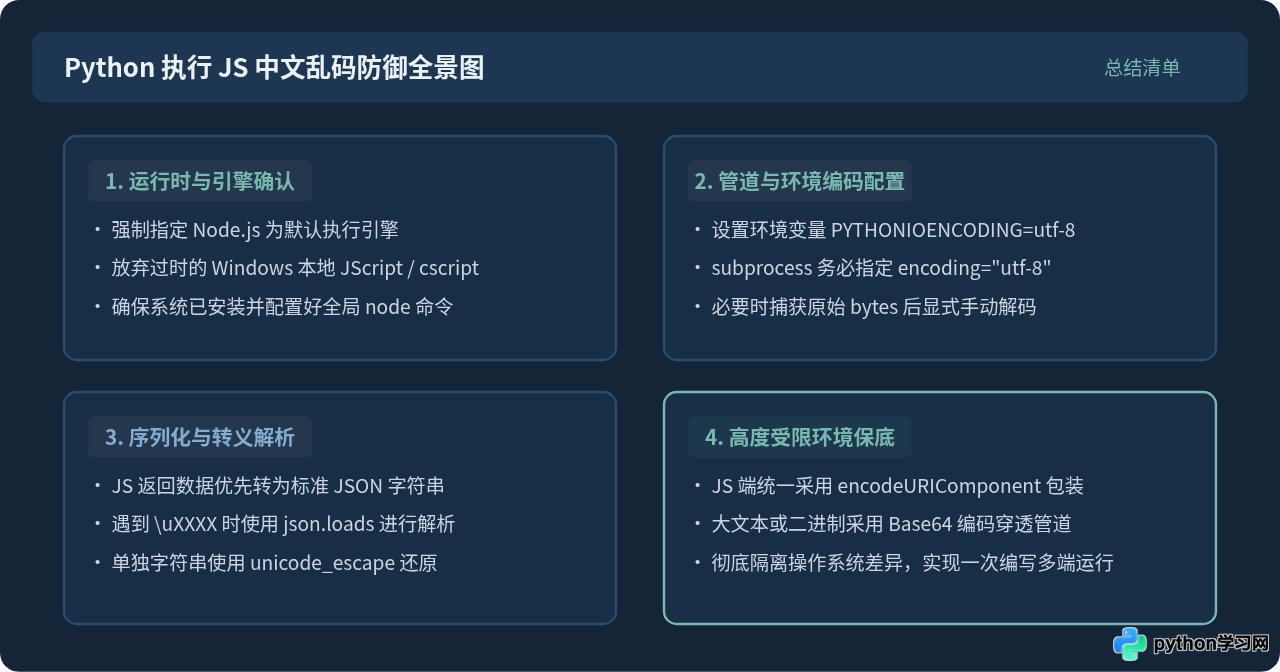
在实际项目中,优先推荐采用 subprocess.run(..., encoding="utf-8") 显式指定编码方式;如果面对异构平台且出现不可排查的系统编码干扰,则采用 Base64 或 URL 编码封装作为坚固的兜底手段。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









