

为什么Python网页版运行速度慢或超时?常见限制与解决办法
深入分析Python在线运行工具速度慢、卡顿或超时的核心原因,涵盖浏览器端Wasm机制与云端沙箱容器限制,并提供实用的排查步骤、优化技巧与替代方案。
一、两类主流网页版Python的运行机制与架构瓶颈
常见的在线Python运行工具(如各类教育平台的在线练习器、在线IDE或代码评测环境)在技术路线上主要分为两派:客户端浏览器沙箱(WebAssembly/Pyodide)与服务端云端容器(Docker/Kubernetes沙箱)。两者的性能瓶颈点完全不同。
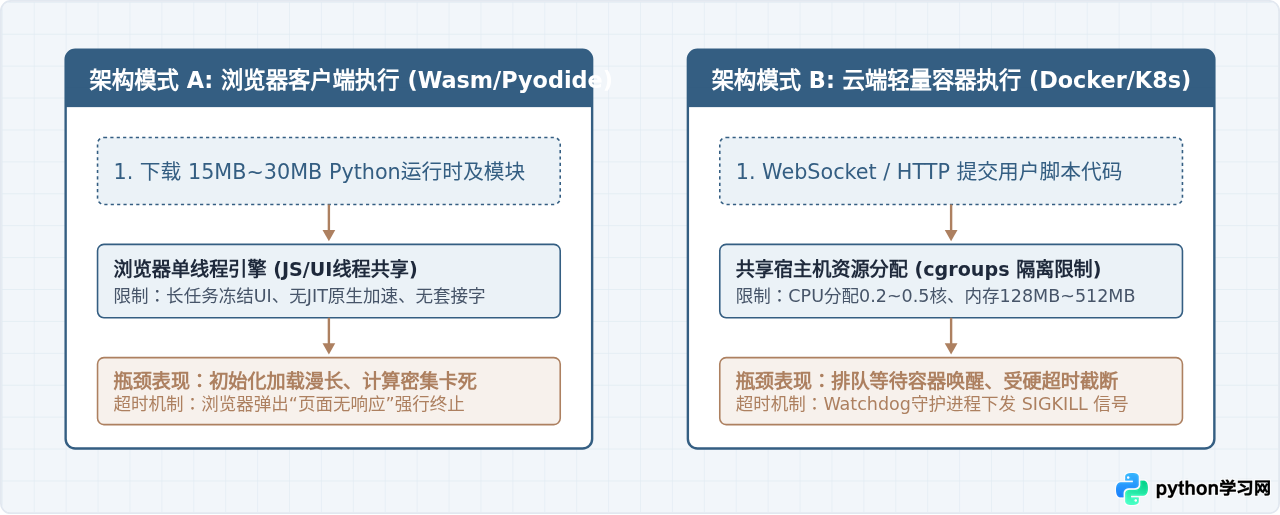
在架构模式 A(客户端执行)中,解释器是编译为WebAssembly(简称Wasm)的二进制文件。代码的解析、执行全部依赖访问者的本地计算机算力与浏览器引擎。首次打开时,浏览器需要从服务器下载包含Python运行时及标准库的体积庞大的静态包,导致启动阶段响应缓慢。一旦代码中包含死循环或高负荷计算,浏览器UI渲染主线程会被直接占满,导致页面卡死并触发浏览器的崩溃防护。
在架构模式 B(云端容器执行)中,代码被发送至平台的远程服务器,由后端的Linux容器创建子进程执行。为了防止黑客攻击、恶意挖矿或单一用户榨干多租户服务器资源,平台管理方在操作系统层面对进程施加了强约束:单次代码执行时长上限通常配置为5秒至15秒,内存使用量一般锁死在128MB至512MB。超过阈值时,守护进程会直接发送 SIGKILL 信号强制销毁容器,并向前端抛出 Execution Timeout Exceeded 或 Process killed 错误。
二、导致慢和超时的六大常见诱因与代码特征
除去平台本身的客观资源分配上限外,绝大多数网页版超时问题是由特定的代码写法引起的。以下是六种最典型的诱因:
- 高阶时间复杂度($O(N^2)$ 或 $O(2^N)$)算法处理规模化数据: 本地开发机拥有3GHz+的多核心处理器和宽裕的内存缓存,双重循环嵌套处理几万条数据往往能在数百毫秒内完成;但在网页端仅分配到 0.2 核甚至模拟指令集的环境下,运算时间会放大几十倍。
-
无终止条件或递增失效的死循环:
在编写
while循环时,终止标志位未正确变动,或者退出条件判断存在边界错误,程序陷入无限计算直接耗尽单次任务分配的时限。 -
交互式输入(
input())未及时提供或被忽略: 由于云端容器属于无交互终端(Non-interactive TTY),如果代码调用了input()但运行平台并未弹出输入框,进程会无限期阻塞在等待标准输入的挂起状态,直到服务器硬超时强退。 -
在循环体内频繁触发标准输出(I/O开销):
在网页端,每一行
print()均需经过标准输出重定向、JSON序列化、WebSocket帧传输以及前端DOM渲染。在循环中无节制打印内容,主要耗时往往不在计算,而在网络与DOM节点挂载上。 -
阻塞式网络请求与第三方接口调用:
许多纯客户端网页版出于安全策略(CORS)与沙箱规范,禁用了直接底层套接字(Socket);而云端容器也多数处于内网沙箱,屏蔽了外网访问。直接在代码中使用
requests.get()会因为网络连接挂起最终超时。 -
加载过大第三方包产生的冷启动开销:
使用
import pandas、import matplotlib等重型科学计算库时,在线环境需动态下载预编译轮子或解压依赖包,初始化解析阶段便已消耗数秒时间。
三、运行缓慢与超时的系统排查流程
当页面提示代码超时或卡死时,不要盲目重复点击运行按钮。按照以下标准四步法进行逐层排查,能够快速定位问题症结。
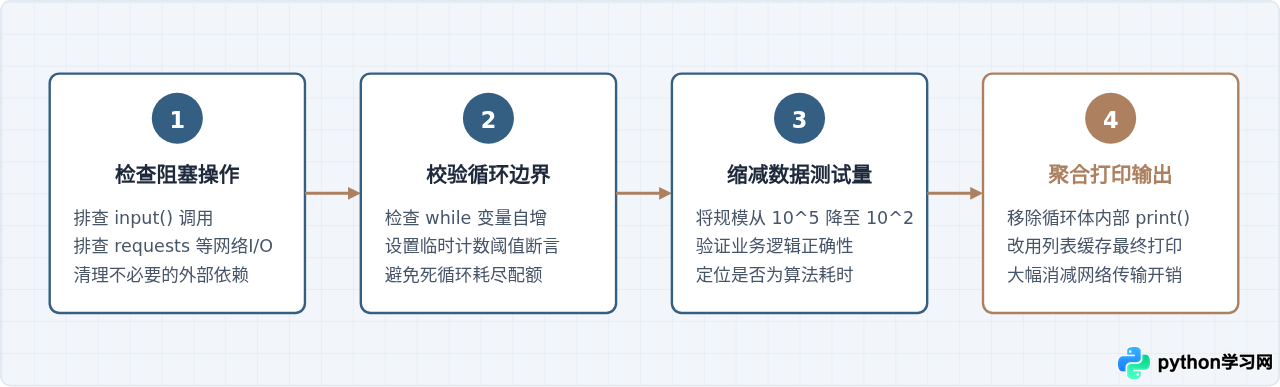
import time; t0 = time.time(); ...; print(f"耗时: {time.time()-t0:.2f}秒")。
四、提升网页端执行效率的核心代码优化方法
在资源受限的环境下,优化代码往往能带来几十倍的性能收益。以下是四种立竿见影的改写方案。
1. 移除循环体内的频繁 I/O 操作
每次调用 print() 都会迫使运行时把数据推给前端控制台。通过内存聚合后一次性输出,能省去海量的网络通信与字符串转义时间。
# ❌ 低效做法:循环10000次,向前端推送10000次输出帧(极易导致页面卡死)
for i in range(10000):
    if i % 100 == 0:
        print(f"当前进度: {i}")

#  高效优化:在内存中完成过滤与收集,最后仅触发一次输出操作
output_buffer = [f"当前进度: {i}" for i in range(10000) if i % 100 == 0]
print("\n".join(output_buffer))
2. 降低算法复杂度:用集合(Hash Set)替代列表扫描
在列表中执行 item in my_list 是 $O(N)$ 复杂度的全量遍历;而在集合中使用 item in my_set 是 $O(1)$ 的哈希查找。当数据量上升时,两者在网页版低算力容器中的差距是几十秒与数毫秒的分别。
# 假设有两个包含数千个元素的数组
raw_data = list(range(5000))
target_data = list(range(2500, 7500))

# ❌ 低效做法:双重遍历匹配,$O(M * N)$ 复杂度(在网页端易触发超时)
common_elements = []
for item in raw_data:
    if item in target_data:  # 每次判断都要遍历 target_data 列表
        common_elements.append(item)

#  高效优化:转换为 Set 哈希结构,$O(M + N)$ 复杂度(毫秒级完成)
target_set = set(target_data)
common_elements = [item for item in raw_data if item in target_set]
3. 防御性循环设计:避免隐藏死循环
在网页端编写复杂逻辑时,为循环添加一个上限保护保险丝,可以在算法逻辑异常时主动抛出提示,而不是让后端容器直接截断连接导致无从定位问题。
# 带有自我保护熔断机制的 while 循环示例
max_iterations = 50000  # 设置安全阈值
current_step = 0
found = False

while not found:
    current_step += 1
    if current_step > max_iterations:
        raise TimeoutError("执行超过安全上限,可能陷入了死循环,已主动中止。")

    # 模拟业务判断逻辑
    if (current_step * 17) % 9999 == 1:
        found = True

print(f"在第 {current_step} 步找到解")
五、深层对比:如何选择适合当前任务的环境?
网页版虽然开箱即用,免去了配置 Python 解释器与虚拟环境的成本,但它并不适合所有的工作场景。合理了解不同执行工具的边界,能够避免做无用功。
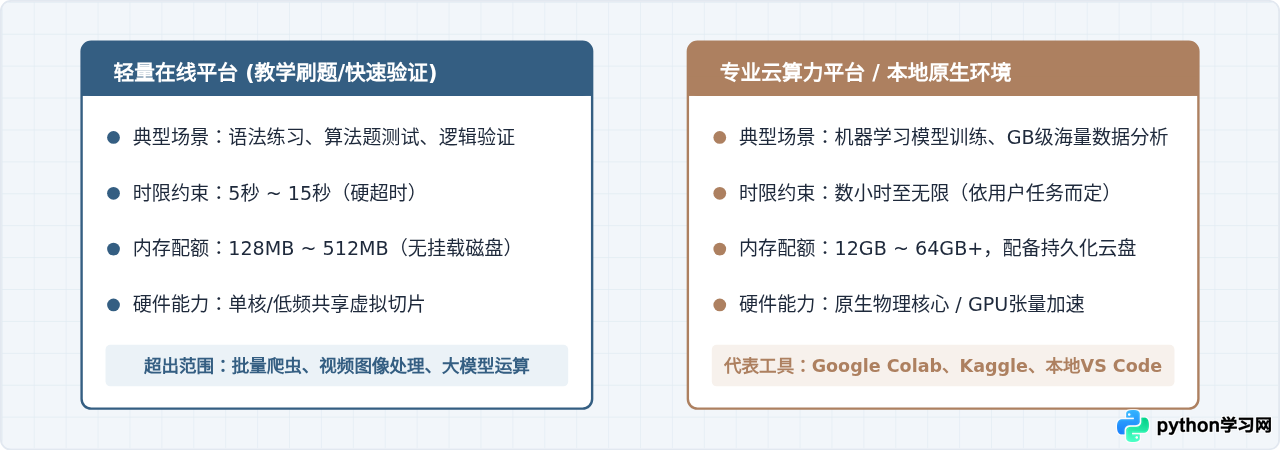
如果你在轻量网页版上反复遭遇超时,且算法已优化至理论极限,说明任务的规模已经超越了该环境的设计初衷。此时可以根据需求平滑迁移至以下场景:
| 业务需求与数据特征 | 建议使用的环境 | 解决的核心瓶颈 |
|---|---|---|
| 课堂小作业、简易函数、算法面试题练习 | 各类在线网页版(按本文方法优化代码) | 免安装、秒开运行、降低学习摩擦 |
| 数据科学探索、带图表展示、几十兆CSV分析 | 云端 Jupyter Notebook(如 Colab / Kaggle) | 破除10秒单次时限,提供GB级大内存与持久存储 |
| 网络爬虫、自动化脚本、操作本地文件系统 | 本地原生 Python 环境(VS Code / PyCharm) | 解除沙箱网络限制、解除本地文件I/O限制 |
六、总结与关键决策依据
Python网页版并非不能胜任计算,而是它所处的容器与Wasm架构天生带有“防挂死”和“多租户隔离”的安全枷锁。在面对慢或超时问题时,可以参考以下最终决策闭环来判断行动方向:
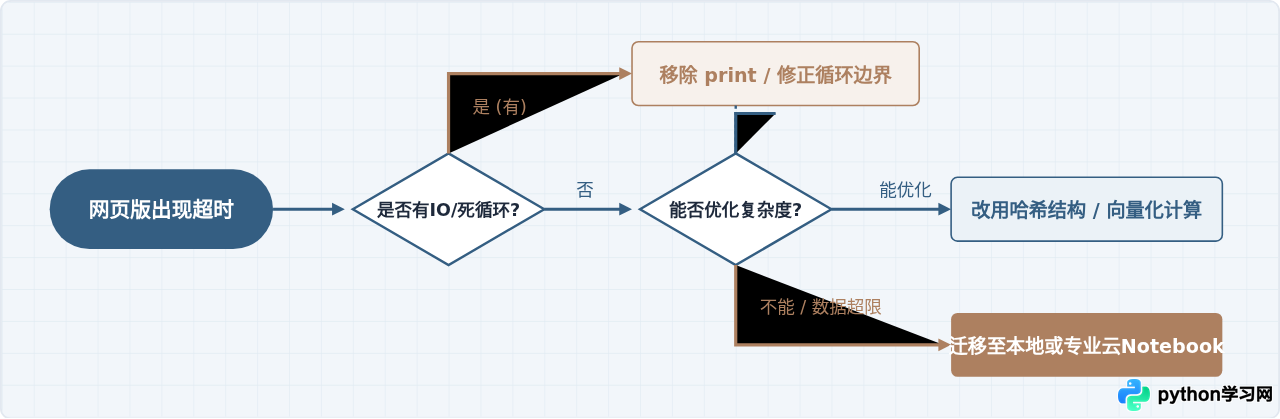
只要牢记“减少循环内标准输出、控制数据结构检索复杂度、认清受限容器的硬件边界”,绝大多数因超时报错困扰的代码,都能在几分钟内恢复顺畅执行。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









