

pythongenerator生成器函数yield怎么用
实用讲解Python生成器函数(Generator)与yield关键字的用法、运行机制、逐步求值步骤、send双向通信以及海量数据流式处理实战与避坑指南。
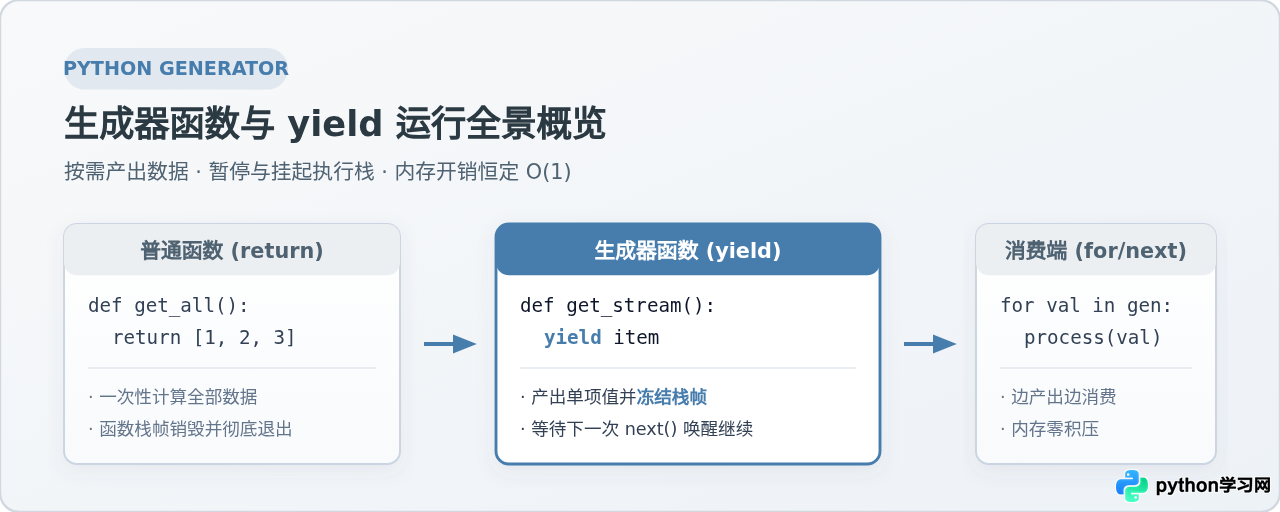
return 替换为 yield:调用该函数时并不会立即执行其内部代码,而是返回一个专用的生成器对象;每次对其调用 next(),函数便会从上次挂起的位置继续向下运行,直到再次遇到 yield 产出数据并重新暂停。这种机制实现了“按需计算”与“状态保留”,仅需恒定的 O(1) 内存即可流式处理无限序列或海量数据集。
认识生成器函数:yield 与 return 的本质区别
在 Python 中,编写一个普通函数时,我们习惯使用 return 返回最终计算结果。return 一旦执行,当前函数的执行栈帧就会被彻底销毁,内部所有临时变量立刻清空退出。如果要返回 100 万条数据,普通函数必须在内存中构造出一个包含 100 万个元素的巨大列表并整体返回,这极易引发内存耗尽(OOM)。
而只要一个函数的定义体中包含了 yield 关键字,Python 解释器在编译字节码时就会自动将其标记为生成器函数(Generator Function)。它的行为发生了两点关键质变:
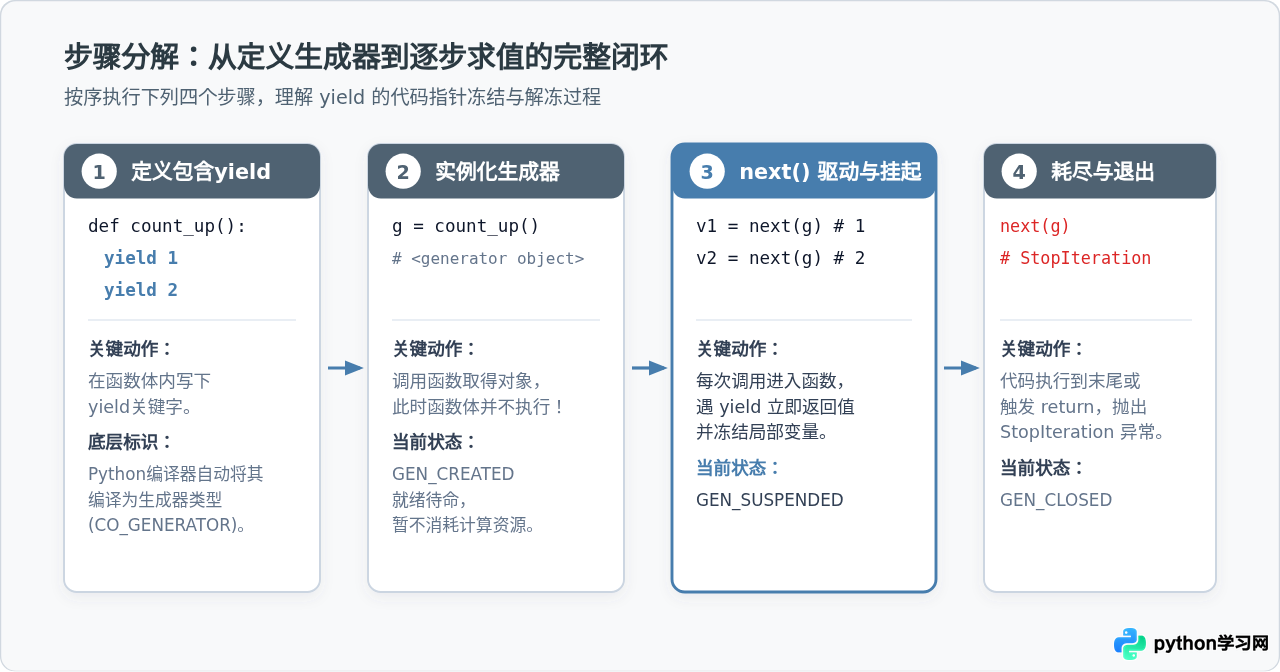
- 调用时不执行函数体:执行
g = my_generator()时,不会运行函数内部任何一行代码,仅返回一个生成器迭代器对象。 - 产出值并冻结现场:当外界需要数据并调用
next(g)时,代码开始执行;一旦碰到yield 某个值,Python 立即将该值输出给外部调用者,同时将当前函数在解释器层面的程序计数器、局部变量和执行上下文完全冻结在内存中,交出 CPU 控制权。
生成器操作步骤:从声明到逐步提取数值
要实际使用生成器函数,可以清晰地拆解为定义、实例化、步进取值和捕获结束这四个核心步骤。下面我们通过一个清晰明了的计数器示例来观察这一过程:
# 步骤 1:定义包含 yield 的生成器函数
def step_generator():
    print("-> 启动生成器,准备产出第 1 个值")
    yield "苹果"

    print("-> 恢复执行,准备产出第 2 个值")
    yield "香蕉"

    print("-> 再次恢复,函数即将执行完毕")

# 步骤 2:实例化生成器对象(此时不打印任何内容)
fruits = step_generator()
print("实例化完成,生成器类型为:", type(fruits))

# 步骤 3:使用 next() 驱动生成器
item1 = next(fruits)
print("外部接收到:", item1)

item2 = next(fruits)
print("外部接收到:", item2)

# 步骤 4:再次调用,生成器耗尽抛出 StopIteration
try:
    next(fruits)
except StopIteration:
print("生成器数据已全部产出,正常结束")-> 启动生成器,准备产出第 1 个值
外部接收到: 苹果
-> 恢复执行,准备产出第 2 个值
外部接收到: 香蕉
-> 再次恢复,函数即将执行完毕
生成器数据已全部产出,正常结束
在日常业务开发中,我们通常无需手动调用 next() 并编写 try-except 处理 StopIteration。因为 Python 的 for 循环、列表推导式、sum()、min() 等聚合函数原生遵循迭代器协议,它们会自动调用 next() 并在捕获到 StopIteration 时优雅退出:
# 使用 for 循环安全、简洁地消费生成器
for item in step_generator():
    print("遍历消费:", item)
底层机制剖析:栈帧挂起与生命周期状态机
为什么普通函数退出后变量都消失了,而生成器能够“记住”上一次执行到了哪一行?这依赖于 CPython 底层对生成器对象的封装机制。普通的 Python 函数调用会在虚拟机调用栈上压入一个栈帧(PyFrameObject),函数返回时弹出并释放。但生成器对象单独持有独立的堆内存栈帧,当遇到 yield 时,解释器只是保存了当前帧的执行指令指针(f_lasti),随后从栈上解除引用,等待下次被唤醒。
我们可以借助 Python 标准库中的 inspect 模块,清晰观察生成器在其生命周期中的四种底层状态转换:
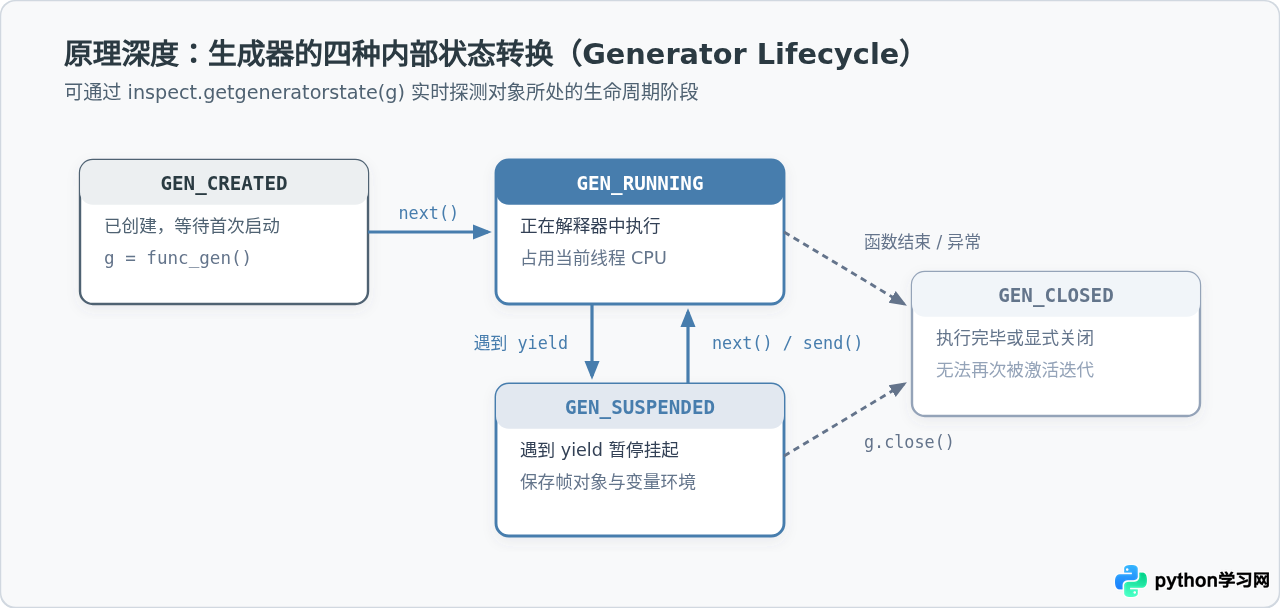
- GEN_CREATED(就绪状态):生成器刚被实例化出来,等待接收第一次启动调用。
- GEN_RUNNING(运行状态):当前 CPU 正在解释器中执行生成器函数体内的指令。
- GEN_SUSPENDED(暂停挂起状态):遇到了
yield,函数体暂停,上下文被原样封存。 - GEN_CLOSED(关闭状态):遇到
return、自然执行到代码末尾抛出StopIteration,或调用了close()方法彻底终止。
GEN_CLOSED,它就变成了不可逆的单向流。无论你之后再次对它调用多少次 next(),它都只会恒定抛出 StopIteration,绝不会重新回到起点执行。
双向通信机制:yield 表达式与 send() 传递数据
很多初学者以为 yield 仅仅是一个单向发射数据的语句,但实际上在 Python 中,yield 是一个完整的表达式(Expression)。这意味着它不仅能向外“吐出”数据,还能在恢复执行的一瞬间,接收外部传入的数据:received = yield output_val。
与 yield 表达式配合的方法是生成器对象的 .send(value)。它在唤醒生成器继续执行的同时,将 value 赋值给生成器内部挂起处的变量。
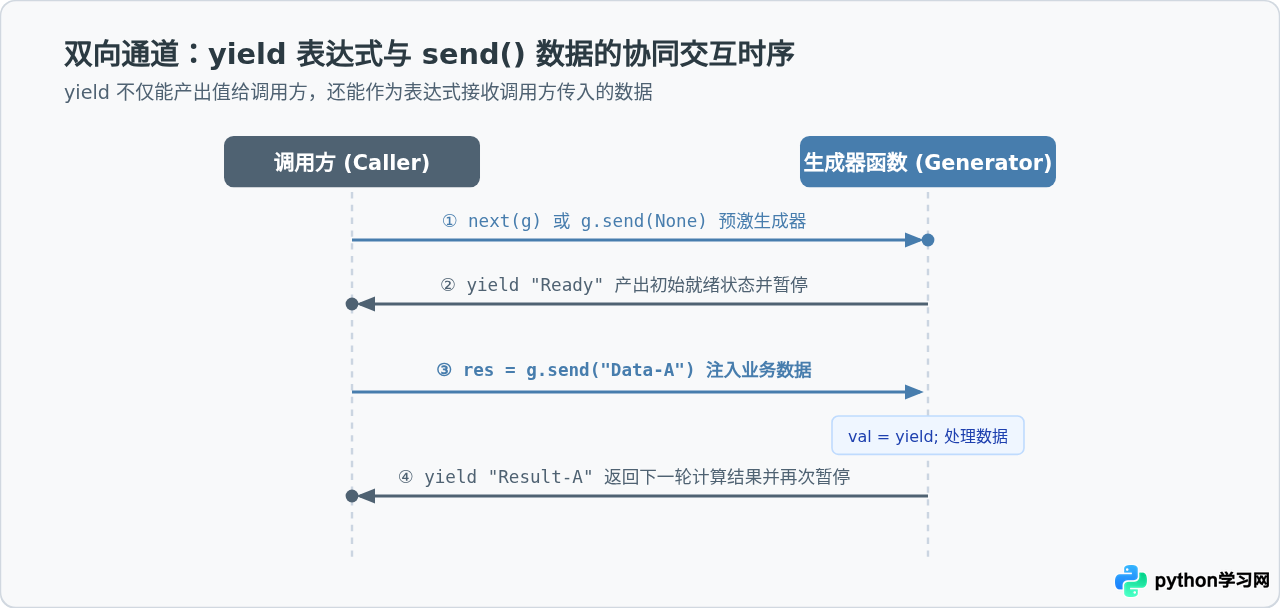
下面的示例展示了一个实时计算动态移动平均数的生成器,外部源源不断向其推送新样本,生成器实时响应最新的平均值:
def running_average():
    total = 0.0
    count = 0
    average = None
    while True:
        # 挂起并产出当前的 average,同时等待接收外部 send 传入的新数值
        new_val = yield average
        if new_val is None:
            break
        total += new_val
        count += 1
        average = total / count

# 1. 创建生成器对象
avg_gen = running_average()

# 2. 预激生成器(Priming):必须先调用一次 next() 或 send(None),使其执行至首个 yield 处暂停
next(avg_gen)

# 3. 双向交互:推送数值并即刻获取更新后的平均数
print("推送 10 后的均值:", avg_gen.send(10))
print("推送 20 后的均值:", avg_gen.send(20))
print("推送 60 后的均值:", avg_gen.send(60))

# 4. 关闭生成器
avg_gen.close()推送 20 后的均值: 15.0
推送 60 后的均值: 30.0
GEN_CREATED 状态的生成器直接调用 send(非None值),Python 会明确抛出 TypeError: can't send non-None value to a just-started generator。必须先通过 next(gen) 或 gen.send(None) 驱动其到达第一处 yield,这一步骤在工程上称为“预激(Priming)”。
生产实操场景:yield 解决实际问题的三大典范
场景一:高效流式读取 GB 级大文件
在服务器排查故障或进行数据分析时,日志文件可能高达数十 GB。如果使用 file.readlines(),系统会尝试一次性将所有文本读入内存构建列表,瞬间导致内存溢出崩溃。使用生成器可以按块(Chunk)或按行惰性加载:
def read_large_file(file_path, chunk_size=4096):
    """分块流式读取大文件,内存占用始终保持在 chunk_size 大小"""
    with open(file_path, "r", encoding="utf-8") as f:
        while True:
            chunk = f.read(chunk_size)
            if not chunk:
                break
            yield chunk

# 无论文件是 100MB 还是 50GB,该循环的内存占用始终小于几十 KB
for block in read_large_file("access.log"):
    parse_log_chunk(block)
场景二:生成数学无限序列与分布式自增 ID
列表无法存储无穷多的数据,但生成器可以轻松表达无限数学序列,例如斐波那契数列或自增流水号:
def fibonacci_stream():
    a, b = 0, 1
    while True:
        yield a
        a, b = b, a + b

fib = fibonacci_stream()
# 按需取出前 6 个斐波那契数
first_six = [next(fib) for _ in range(6)]
print("前六位斐波那契数:", first_six) # [0, 1, 1, 2, 3, 5]
场景三:管道式数据流处理(Pipeline)
Unix 哲学的核心是管道符 |,每个程序专注做一件事并将结果传给下一个。利用生成器,我们可以在 Python 中搭建零内存积压的纯 Python 数据管道:
# 阶段 1:数据生成阶段
def source_integers(limit):
    for i in range(limit):
        yield i

# 阶段 2:过滤过滤奇数
def filter_evens(numbers):
    for n in numbers:
        if n % 2 == 0:
            yield n

# 阶段 3:映射计算平方
def square_numbers(evens):
    for n in evens:
        yield n * n

# 组装管道:数据只有在被消费时才会流动并依次处理
pipeline = square_numbers(filter_evens(source_integers(10)))
print("管道计算结果:", list(pipeline)) # [0, 4, 16, 36, 64]
常见避坑指南:初学者易犯的典型错误
-
误区一:试图复用已消费完毕的生成器
生成器是一次性消耗品。当遍历完一遍后,其指针已抵达终点。如果需要再次遍历,必须重新调用生成器函数创建全新的生成器实例,或者通过itertools.tee进行多副本分支克隆。 -
误区二:在生成器函数内部使用 return 返回具体数值
在 Python 3 中,允许在生成器函数内写return val,但这个返回值不会被for循环捕获,而是作为StopIteration(val)异常的参数附加在异常对象上。它的主要目的是在yield from协程委托时向父协程传递退出状态,普通业务迭代中切勿将数据指望通过 return 交付给循环。 -
误区三:误以为可以用下标访问生成器
生成器没有实现__getitem__协议,执行gen[0]会直接抛出TypeError: 'generator' object is not subscriptable。如需按切片截取,应导入标准库itertools.islice(gen, start, stop)。
技术选型与机制总结
为了帮助大家在日常开发中准确决策何时使用 yield,下表与决策图汇总了常规列表与生成器函数的关键特性差异:
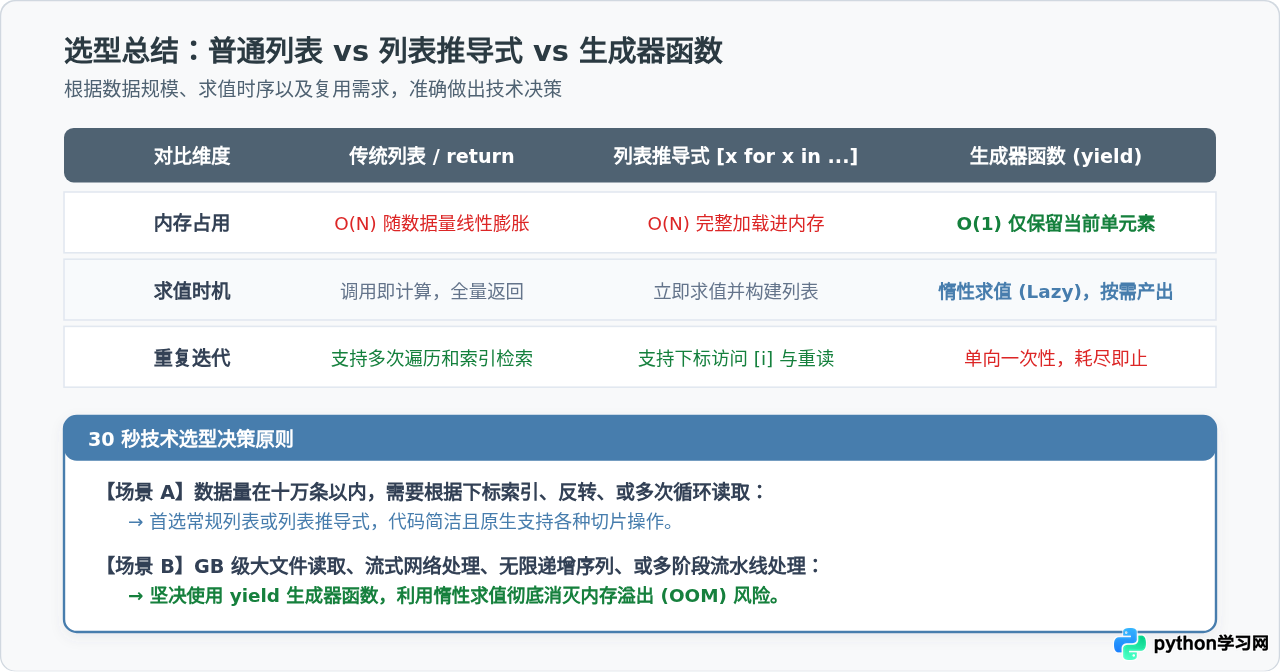
掌握 yield 的使用是迈向 Python 高阶编程、深入理解异步协程(async/await 底层基于生成器演进)以及架构轻量级数据流处理的基础工具。通过合理使用生成器,既能写出低耦合的模块化数据管道,又能彻底消除大规模运算带来的内存隐患。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









