

Python密码学编程常见安全陷阱与规避指南
深入剖析Python密码学编程中的常见安全陷阱,包括伪随机数生成、ECB与无认证对称加密、低强度口令哈希、短路时序攻击及密钥管理误区,并提供基于现代密码学标准的规避指南与生产级代码示例。
在 Python 中编写涉及加密、解密、口令存储和身份验证的代码时,最常见的安全漏洞往往不是底层数学算法本身被攻破,而是源于工程实现层面的误用——例如混淆了伪随机数与密码学安全随机数、对称加密缺乏认证导致密文被篡改、在校验令牌时使用了常规字符串比对引入时序侧信道,或者使用了已被证明过时的哈希算法。本文围绕 Python 密码学编程中最常出现的五大典型陷阱展开,剖析其技术成因、潜在攻击风险,并提供符合现代密码工程标准的防御手段与代码示例。
陷阱一:混淆伪随机数与密码学安全随机数
生成随机凭证是安全编程的第一道门槛,但也是最容易被忽视的隐患点。很多开发者习惯于直接导入 Python 的 random 模块来生成会话密钥、重置密码令牌(Password Reset Token)或临时验证码。
random 模块基于 Mersenne Twister(MT19937)算法实现。这是一个面向科学计算和统计模拟的高效伪随机发生器(PRNG),具有确定性的周期特征。攻击者只需收集连续 624 个 32 位随机数输出,即可通过求解线性方程反推出生成器的全部内部状态向量,从而精准预测后续生成的全部随机令牌,甚至逆向推导历史会话凭据。
针对密码学应用场景,必须使用密码学安全伪随机数生成器(CSPRNG)。从 Python 3.6 开始,标准库提供了专用的 secrets 模块;底层也可直接依赖 os.urandom()。它们直接调用操作系统内核提供的熵源(如 Linux 上的 getrandom() 系统调用或 /dev/urandom,Windows 上的 BCryptGenRandom),具备不可预测性与抗状态重建能力。
# ❌ 错误示范:严禁在安全场景中使用 random 模块
import random
import string

def unsafe_generate_token(length=32):
    # Mersenne Twister 状态可被轻易预测!
    chars = string.ascii_letters + string.digits
    return ''.join(random.choice(chars) for _ in range(length))

# ✅ 正确做法:使用标准库 secrets 模块
import secrets

def safe_generate_token(length=32):
    # 底层对接系统级 CSPRNG,抗逆向推导
    return secrets.token_urlsafe(length)

def safe_generate_symmetric_key():
    # 生成 256 位(32 字节)高强度对称密钥
    return secrets.token_bytes(32)
陷阱二:对称加密模式不当与缺乏完整性认证
选择块密码(如 AES)时,算法本身只是基础,分组模式的选择至关重要。常见错误包括误用电子密码本模式(ECB),或者在 CBC 模式下未附加消息认证码(MAC)。
ECB 模式将明文切分为固定大小的分块,并对每个分块独立进行相同的加密运算。如果两个明文块内容相同,对应的密文块也完全相同。攻击者无需破解密钥,仅通过观察密文分块的重复模式就能推测出数据结构、图像轮廓或协议协议头。此外,缺乏认证保护的 CBC 模式极易遭遇密文位翻转攻击和填充预言机攻击(Padding Oracle Attack)。
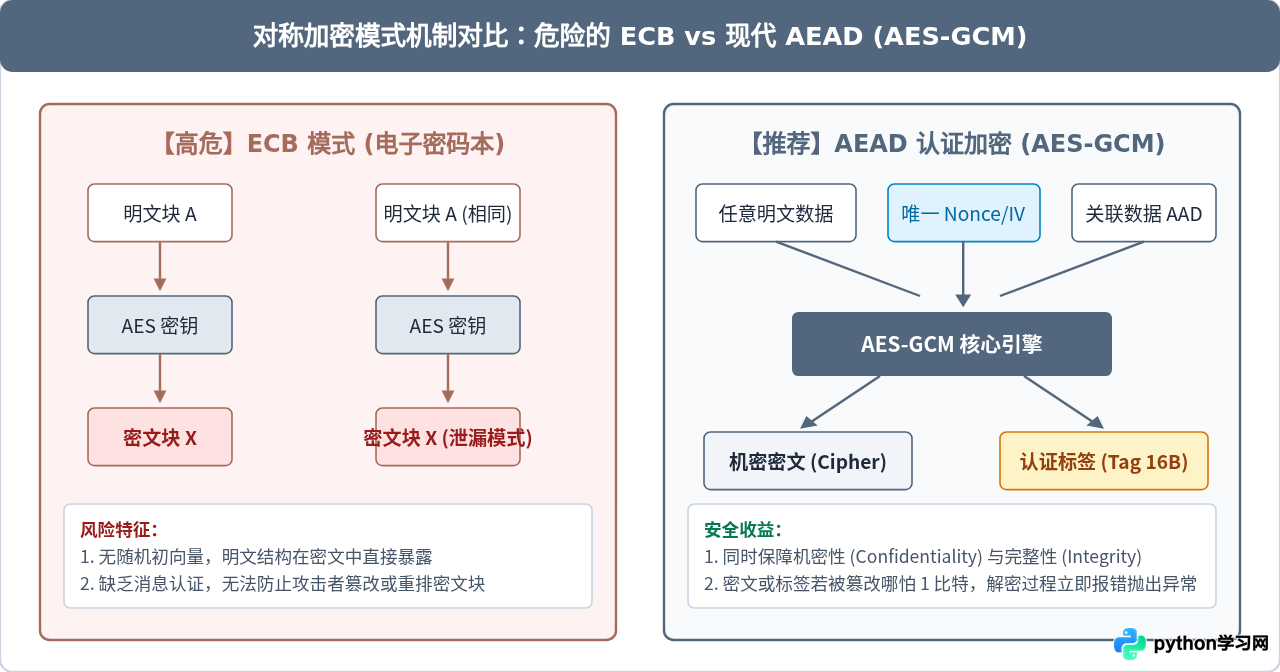
现代密码学工程强烈推荐使用带有关联数据的认证加密(AEAD)模式,如 AES-GCM 或 ChaCha20-Poly1305。对于绝大多数 Python 应用场景,直接使用 cryptography 库提供的 Fernet(内部采用 AES-128-CBC + HMAC-SHA256)或 AESGCM 是最佳实践。
# ✅ 生产级实践:使用 AESGCM 进行认证加密
import os
from cryptography.hazmat.primitives.ciphers.aead import AESGCM

# 1. 生成 256 位安全密钥
key = AESGCM.generate_key(bit_length=256)
aesgcm = AESGCM(key)

# 2. 每次加密必须生成全新且唯一的 Nonce(GCM 标准为 12 字节 / 96 位)
nonce = os.urandom(12)
plaintext = b"Sensitive transaction data payload"
associated_data = b"user_id=10042"  # 关联数据参与认证但不加密

# 3. 执行加密(密文末尾自动包含 16 字节认证标签)
ciphertext = aesgcm.encrypt(nonce, plaintext, associated_data)

# 4. 传输或存储:必须将 nonce 与 ciphertext 一并保存
stored_payload = nonce + ciphertext

# 5. 解密与验签
extracted_nonce = stored_payload[:12]
raw_ciphertext = stored_payload[12:]
try:
    decrypted = aesgcm.decrypt(extracted_nonce, raw_ciphertext, associated_data)
    print("解密成功:", decrypted.decode("utf-8"))
except Exception as e:
    # 若数据被微小篡改,此处立即抛出 InvalidTag 异常
    print("密文已被篡改或认证标签失效:", e)
陷阱三:低强度口令哈希与加盐误区
用户密码的安全存储是Web应用最核心的防护层。很多人误认为“只要加了盐(Salt),用 MD5 或 SHA-256 哈希就很安全”。这种认识停留在大约十五年前。
MD5、SHA-1 以及 SHA-256 属于通用快速哈希算法,设计初衷是为了在几微秒内处理海量数据。利用现代高端 GPU 或专业 ASIC 芯片,攻击者每秒可以计算数百亿次 SHA-256 散列。单纯添加一个静态全局盐(Pepper)或短随机盐,完全无法抵御离线暴力破解。
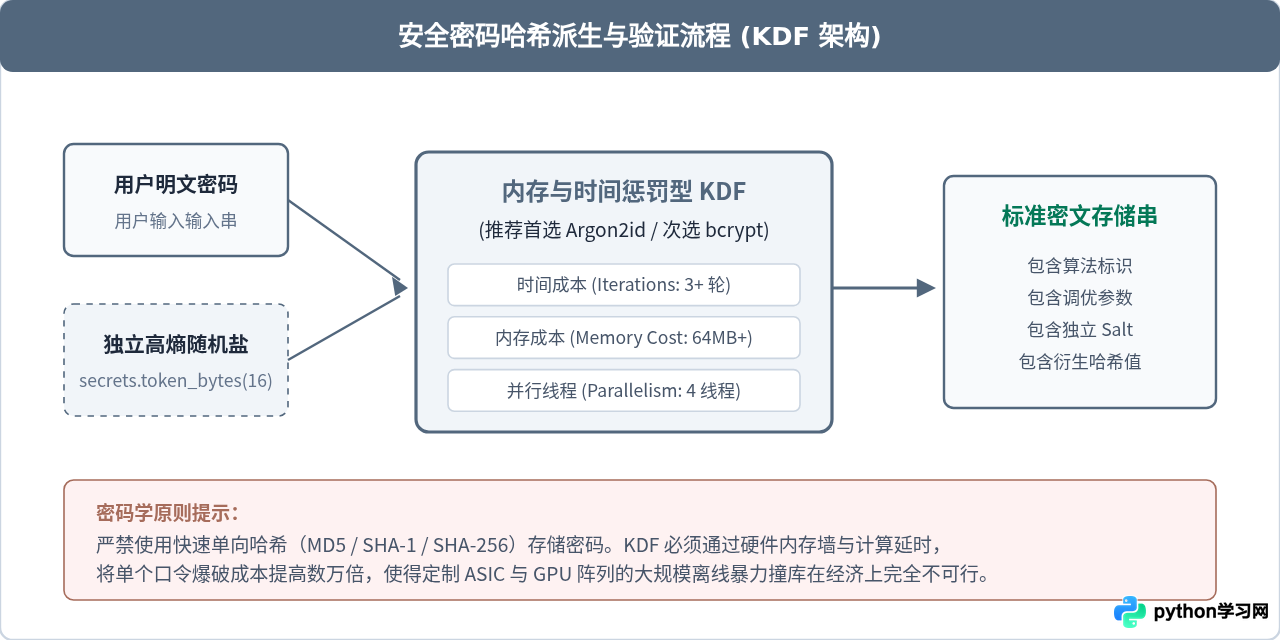
安全的密码存储必须采用专用慢速密钥派生函数(KDF),核心算法推荐:
- Argon2id:密码哈希竞赛(PHC)优胜算法,兼具抗侧信道时序攻击与抗 GPU 内存硬度,是当前工业级首选。
- bcrypt:经受长期检验的经典算法,基于 Blowfish 修改版,对计算资源有天然惩罚。
- PBKDF2-HMAC-SHA256:Python 标准库
hashlib原生自带,若受限于无第三方 C 扩展依赖的环境,建议将迭代次数设为 600,000 次以上。
# ✅ 生产实践 1:标准库原生 PBKDF2 (无外部依赖时)
import hashlib
import secrets

def hash_password_pbkdf2(password: str) -> tuple[bytes, bytes]:
    # 每个用户密码生成独立的高熵随机盐 (16 字节)
    salt = secrets.token_bytes(16)
    # OWASP 建议 2023+ 年迭代次数不少于 600,000 次
    iterations = 600000
    derived_hash = hashlib.pbkdf2_hmac(
        'sha256',
        password.encode('utf-8'),
        salt,
        iterations
    )
    return salt, derived_hash

# ✅ 生产实践 2:使用工业界标准推荐 Argon2id (需安装 argon2-cffi)
try:
    from argon2 import PasswordHasher
    ph = PasswordHasher(time_cost=3, memory_cost=65536, parallelism=4)

    # 生成包含算法、参数、盐和哈希的标准编码串
    hashed_str = ph.hash("UserSecretPassword_123")
    print("Argon2id 密文字符串:", hashed_str)

    # 验证密码(自带常数时间比对与参数自动升级检查)
    is_valid = ph.verify(hashed_str, "UserSecretPassword_123")
    print("密码验证结果:", is_valid)
except ImportError:
    pass
陷阱四:字符串直接比较引发的时序侧信道攻击
在验证 API Token、Webhook 签名或密码重置令牌时,大部分开发者会下意识地使用 Python 默认的相等操作符:token == expected_token。这在通用业务逻辑中没有问题,但在密码学与安全校验中却是一个致命缺陷。
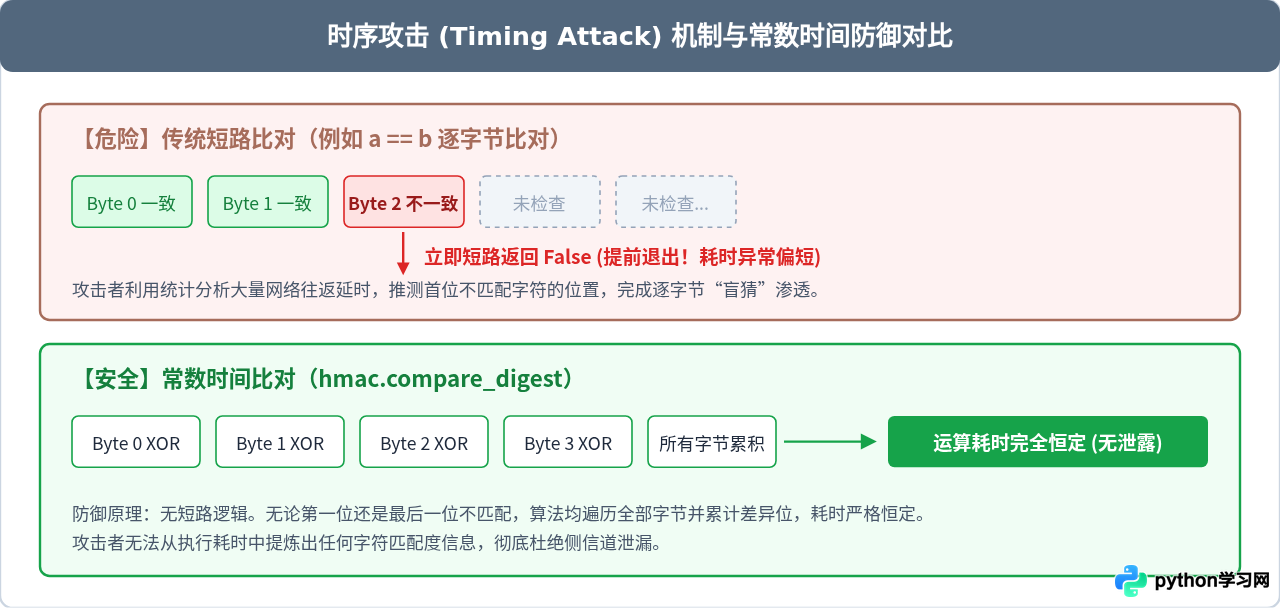
标准字符串等于比对采用了“短路评估”(Early Return)机制:一旦发现首个不相等的字符,便立刻终止比较并返回 False。如果在网络环境下进行数千次至数万次请求并进行统计学滤波,攻击者便能探测出“匹配了 3 个字符”与“匹配了 0 个字符”之间的微秒级时间差异,从而逐个字符枚举出真实的签名值。
Python 标准库在 hmac 模块中专门提供了抗时序侧信道的解决方案:hmac.compare_digest()。
import hmac

# ❌ 错误做法:普通短路比对(存在纳秒/微秒级侧信道泄漏)
def unsafe_verify_token(user_token: str, real_token: str) -> bool:
    return user_token == real_token

# ✅ 正确做法:常数时间比对(时间开销独立于内容匹配位置)
def safe_verify_token(user_token: str, real_token: str) -> bool:
    # 支持 str、bytes 或 bytearray
    return hmac.compare_digest(user_token, real_token)

# 实际 Webhook 签名校验示例
import hashlib

def verify_webhook_signature(payload: bytes, signature_header: str, secret_key: bytes) -> bool:
    expected_signature = hmac.new(secret_key, payload, hashlib.sha256).hexdigest()
    # 必须使用 compare_digest 防止时序推断
    return hmac.compare_digest(signature_header, expected_signature)
陷阱五:手写加密原语与硬编码密钥生命周期缺陷
“不要发明自己的密码学算法(Don't roll your own crypto)”是整个信息安全行业最深刻的共识之一。初学者往往喜欢使用异或(XOR)加循环移位、自定义字符置换表或压缩算法混淆来实现所谓的“轻量级加密”。这些自制算法缺乏严格的数学抗差分分析验证,在已知明文攻击(KPA)面前往往脆弱得不堪一击。
与手写算法并存的另一个严重问题是密钥硬编码。把 AES Key、私钥字面量直接写入 Python 源码脚本中,随着代码提交进入 Git 仓库,极易在团队共享、开源或日志报错时全面暴露。
- 优先选择高层封装(如
cryptography.fernet.Fernet),避免自己组装低层块密码原语。 - 严禁将密钥字面量写在
.py文件中;生产环境应通过环境变量(os.environ)、Docker Secrets 或专有秘钥管理器(如 Vault、AWS KMS)动态注入。 - 对高敏感密钥实施轮换(Key Rotation)机制,设计密文格式时应预留
key_id前缀以便平滑过渡。
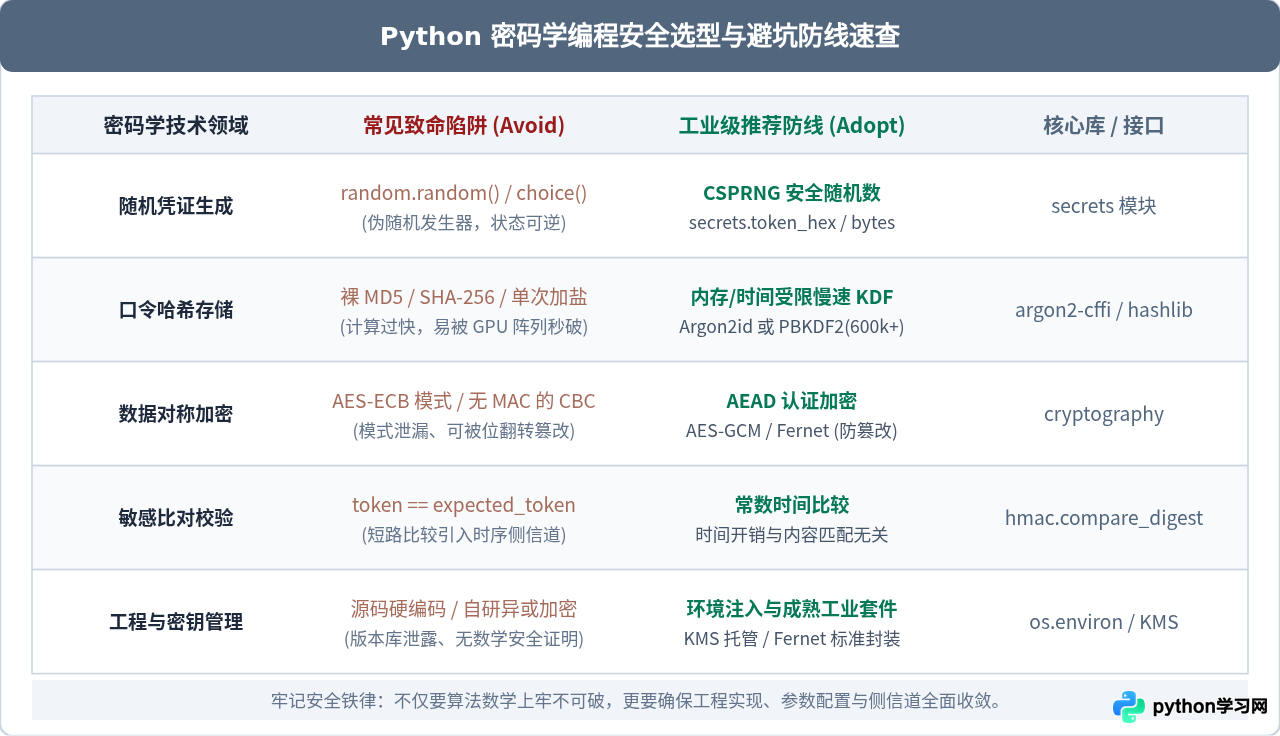
总结与规避准则清单
构建一个能够抵御真实世界攻击的 Python 系统,密码学编程必须严谨恪守以下三条核心准则:
- 用专职模块替代通用工具:生成随机数只用
secrets;比对摘要只用hmac.compare_digest;存储口令只用针对性设计的 KDF(如 Argon2id)。 - 认证永远先于解密(AEAD 原则):不要在生产系统使用未经认证的纯加密模式;对于对称加密,首选 AES-GCM 或封装成熟的
Fernet,确保密文具备防篡改校验。 - 保持最小暴露面:绝不自行发明加密、混淆或哈希组合逻辑;不将密钥写入代码库;让经过严格安全审计的第三方工业级库(如
cryptography)承担底层复杂的密码运算。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









