

Python dataclasses怎么用:简化数据类编写的实战技巧
深入讲解Python dataclasses模块的核心用法与实战技巧,涵盖基本语法、默认值避坑、不可变类、排序比较、生命周期钩子及序列化转换。
在 Python 3.7 及更高版本中,标准库内置的 dataclasses 模块提供了一种通过类型注解自动生成面向对象样板代码的高效方式。如果你经常编写仅用于封装状态、属性和配置的数据结构类,使用 @dataclass 可以省去手动书写 __init__、__repr__、__eq__ 等重复方法的成本,在保持原生类灵活性与运行效率的同时,大幅提升代码的可读性与健壮性。
一、什么是 dataclass:它解决了什么问题
在传统面向对象编程中,当我们定义一个表示“商品”(Product)或“用户”(User)的数据载体类时,往往需要写出大量机械化的方法代码。例如在 __init__ 中逐个接收参数并赋值给 self,为了便于调试日志还要手动格式化 __repr__,为了支持实例间值的比较还要实现 __eq__。
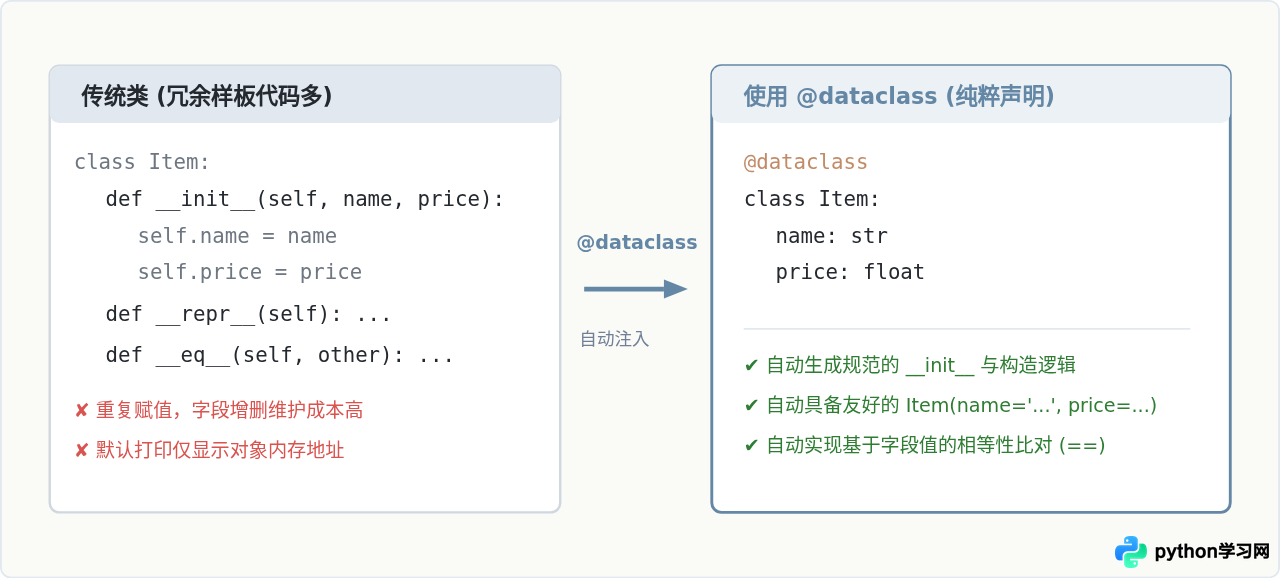
dataclass 本质上是一个类装饰器(Class Decorator)。它在运行时解析类中声明的类型注解字段(Type Annotations),依据这些元数据在后台动态构建并绑定对应的特殊方法。它生成的依然是标准的 Python 类,与普通类无缝兼容,支持方法扩展、多继承和类型检查。
二、基础语法与核心上手流程
使用 dataclasses 的基本流程非常直观,通常包含四个主要阶段:从标准库导入装饰器、声明类及带类型注解的属性字段、为可选属性配置默认值,最后直接实例化并使用内置生成的行为。
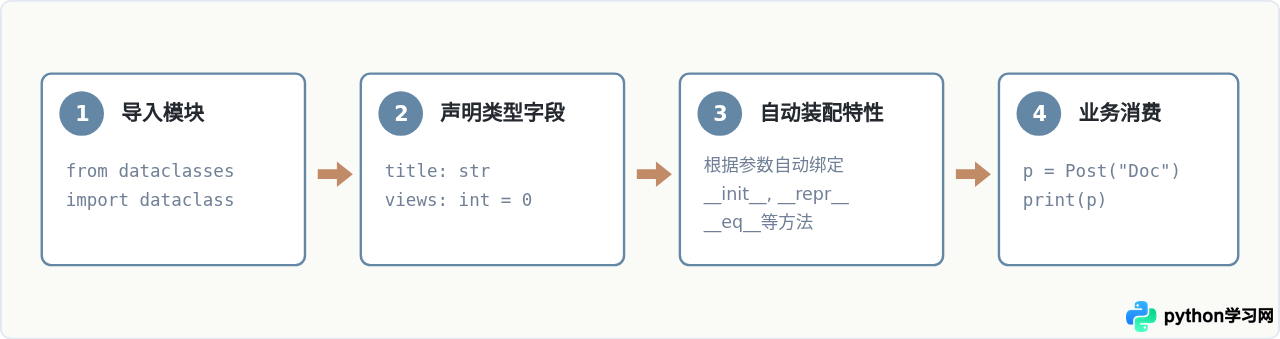
下面是一个标准的最小可用示例:
from dataclasses import dataclass

@dataclass
class Article:
    title: str
    word_count: int
    published: bool = False

# 1. 实例化
art1 = Article(title="Python入门", word_count=2400)
art2 = Article(title="Python入门", word_count=2400)

# 2. 自动格式化输出
print(art1)
# 示例输出:Article(title='Python入门', word_count=2400, published=False)

# 3. 自动基于字段比较
print(art1 == art2)
# 示例输出:TrueAny)。如果只写 title = "未命名" 而没有类型注解,dataclass 会将其视作普通的类属性,而不会将其纳入构造函数参数与实例字段中。
三、实战技巧一:处理可变默认值与 field() 函数
在普通 Python 函数或类定义中,直接使用可变对象(如 list、dict、set)作为默认值是经典的“坑点”,因为所有实例都会共享同一个底层对象。dataclass 对此做了强制安全限制:如果你直接写 tags: list = [],Python 在解释执行该类时就会直接抛出 ValueError。
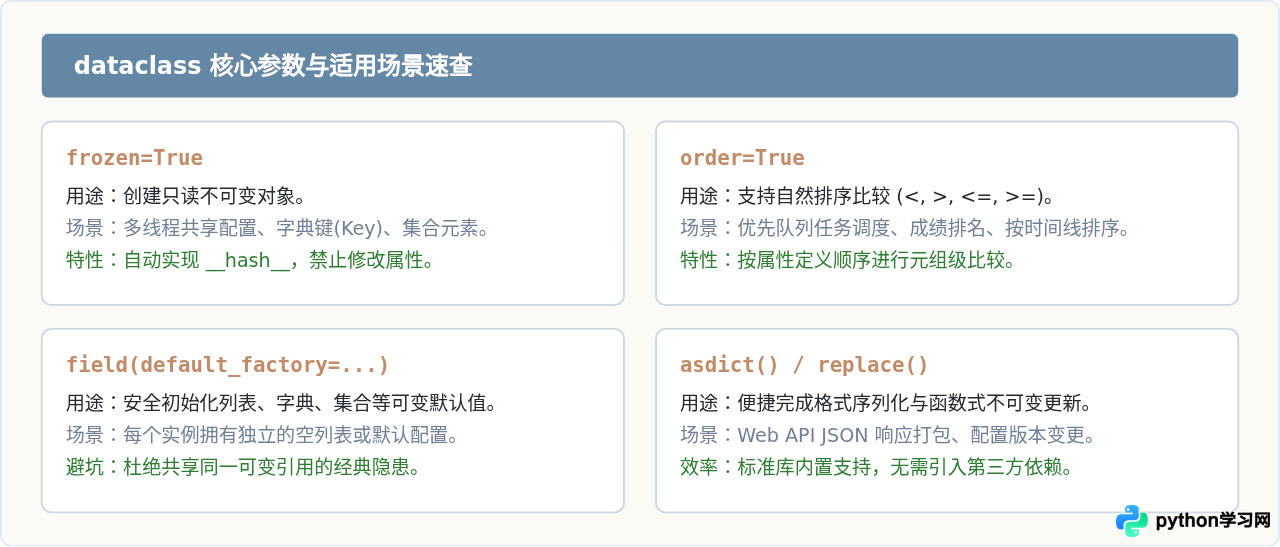
为了规范字段属性,dataclasses 提供了 field() 函数,通过指定 default_factory 延迟工厂函数来安全创建容器:
from dataclasses import dataclass, field
from typing import List

@dataclass
class BlogPost:
    title: str
    # 正确做法:使用 default_factory 生成全新的列表实例
    tags: List[str] = field(default_factory=list)
    # 控制不将敏感字段输出在 __repr__ 中
    password_hash: str = field(default="", repr=False)
    # 控制不参与相等性判断比较
    internal_id: int = field(default=0, compare=False)

post = BlogPost(title="架构设计", password_hash="secret_xyz")
print(post)
# 示例输出:BlogPost(title='架构设计', tags=[], internal_id=0)
# 可以看到 password_hash 并没有打印出来,有效保护敏感数据
四、实战技巧二:后处理与数据校验(__post_init__)
@dataclass 自动生成的 __init__ 负责将传入的参数逐一绑定到 self。但在生产环境中,我们往往需要在对象初始化后执行数据合法性校验(比如确保价格不能为负数),或者计算派生字段。此时可以使用 __post_init__ 钩子方法。
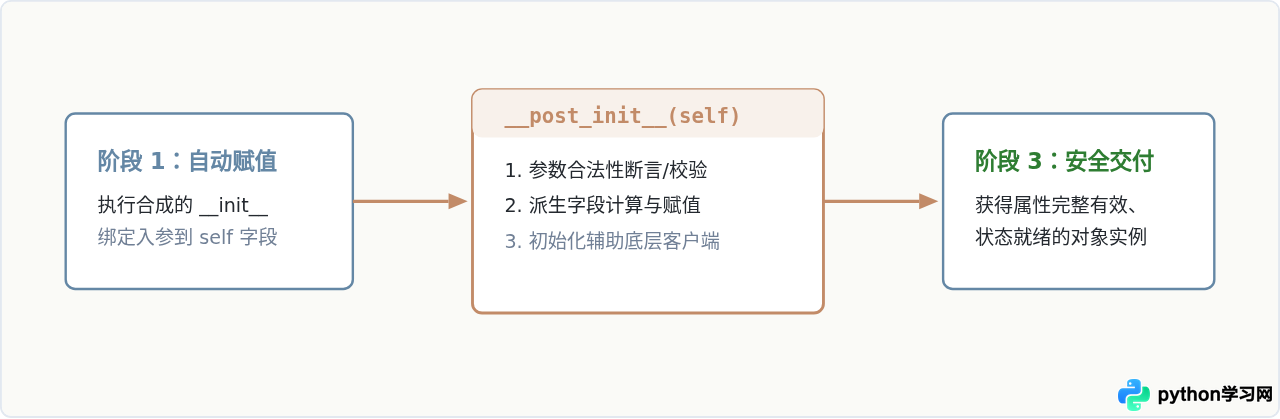
以下示例演示了如何通过 __post_init__ 完成参数有效性验证及派生属性的自动填充:
from dataclasses import dataclass, field

@dataclass
class OrderItem:
    item_id: str
    unit_price: float
    quantity: int
    # total_price 由数量与单价计算得出,无需外部调用者传入
    total_price: float = field(init=False)

    def __post_init__(self):
        if self.unit_price < 0:
            raise ValueError(f"单价不能为负数: {self.unit_price}")
        if self.quantity <= 0:
            raise ValueError(f"数量必须大于0: {self.quantity}")

        # 自动计算衍生属性
        self.total_price = round(self.unit_price * self.quantity, 2)

order = OrderItem(item_id="P-101", unit_price=29.9, quantity=3)
print(order.total_price)
# 示例输出:89.7
五、实战技巧三:不可变数据与排序控制
@dataclass 提供了多个装饰器控制参数,其中最常用的两个是 frozen 和 order。
1. 制造不可变对象(frozen=True)
设置 @dataclass(frozen=True) 后,生成的类实例属性将被冻结。任何对实例属性的再次赋值修改都会引发 FrozenInstanceError。同时,Python 还会自动为该类实现 __hash__ 方法,使得该类的实例可以安全地放入 set 或作为 dict 的键(Key)。
@dataclass(frozen=True)
class Coordinate:
    x: int
    y: int

coord = Coordinate(10, 20)
# coord.x = 30  # 这行会直接抛出 FrozenInstanceError

# 可以作为字典键
locations = {coord: "仓库A区"}
print(locations[Coordinate(10, 20)])
# 示例输出:仓库A区
2. 自动支持大小比较(order=True)
默认情况下,dataclass 只生成 __eq__,不支持使用 <、<=、>、>=。设置 order=True 后,dataclass 会按照字段声明的先后顺序依次比较各属性值,非常适合用于排行榜、任务调度优先级队列等场景。
@dataclass(order=True)
class Task:
    priority: int
    name: str

t1 = Task(priority=1, name="修复紧急Bug")
t2 = Task(priority=5, name="重构样式代码")

print(t1 < t2)
# 示例输出:True (因为 1 < 5)
六、实战技巧四:与原生类型的互相转换与序列化
在网络请求响应、数据库存储或消息传递时,我们通常需要将对象转为字典或元组。dataclasses 模块提供了原生的高效辅助工具函数:
asdict(instance):递归地将数据类实例及其嵌套的数据类转换为原生 Python 字典;astuple(instance):将数据类属性提取为有序元组;replace(instance, **changes):基于现有实例创建一个浅拷贝,同时允许修改部分指定字段(在frozen=True的函数式不可变编程中尤为常用)。
from dataclasses import dataclass, asdict, replace

@dataclass(frozen=True)
class UserProfile:
    user_id: int
    nickname: str
    role: str = "guest"

user = UserProfile(user_id=1001, nickname="Kimi")

# 转换为字典
user_dict = asdict(user)
print(user_dict)
# 示例输出:{'user_id': 1001, 'nickname': 'Kimi', 'role': 'guest'}

# 基于已有实例生成修改后的新实例
upgraded_user = replace(user, role="admin")
print(upgraded_user)
# 示例输出:UserProfile(user_id=1001, nickname='Kimi', role='admin')
七、特性速查与核心选型参考
为了在实际开发中快速对齐需求与参数,以下矩阵总结了常见场景下的技术方案:
八、常见误区与避坑建议
- 默认值顺序规则:与普通函数参数一致,没有默认值的字段不能排在有默认值的字段之后。在继承时也遵循相同顺序,父类已带有默认值的字段若在子类增加无默认值字段,会导致 Python 抛出
SyntaxError。 - 它不负责运行时的严格类型校验:类型注解主要是为静态分析工具(如 Mypy、IDE 智能提示)提供支持。如果你向
price: float传入了字符串"100",dataclass 本身不会自动强行校验或抛错;如果业务需要强类型运行时校验与解析,可在__post_init__中手动校验,或在重型 API 校验场景中使用 Pydantic。 - 无需过度封装时优先采用:如果仅仅是存放中间数据,用
@dataclass替代传统的纯dict可以带来完整的自动补全和属性安全保障;而相比命名元组(namedtuple),它具有更好的可扩展性与面向对象方法定义能力。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









