

Python手写选择排序与内置sort()处理随机数对比
深入对比Python手写选择排序与内置sort()处理大量随机数的实际表现,结合详细算法推导、基准测试代码、耗时数据对比与SVG流程图,剖析O(n^2)与O(n log n)及C底层实现带来的巨大性能差距。
在面对包含数千甚至数万个整数的无序随机序列时,使用纯Python手写的简单选择排序与直接调用Python内置的list.sort(),其执行耗时常常存在成百上千倍的悬殊差距。选择排序作为经典的入门级比较算法,逻辑直观易懂,常用于学习算法基础;而Python内置的sort()底层采用自适应混合排序算法Timsort并由C语言编译优化。本文将通过手写实现、原理剖析、基准随机数测试及多维度横向对比,带你清晰了解两者的实现机制与性能分野背后的根本原因。
一、选择排序的原理与Python手写实现
选择排序(Selection Sort)的核心思路是“贪心选极值”:在每一轮遍历中,从未排序区域扫描出最小元素,然后将其与未排序区域的首位元素进行交换,从而将该最小元素归入已排序区域。重复这一过程,直到整个序列完全有序。
对于长度为 n 的列表,选择排序需要进行 n - 1 轮外层循环,内层扫描的比较次数呈等差数列递减:(n-1) + (n-2) + ... + 1 = n(n-1)/2。无论初始数据是乱序、有序还是反序,这一比较步骤都不可避免,因此其时间复杂度恒为严格的 O(n²)。
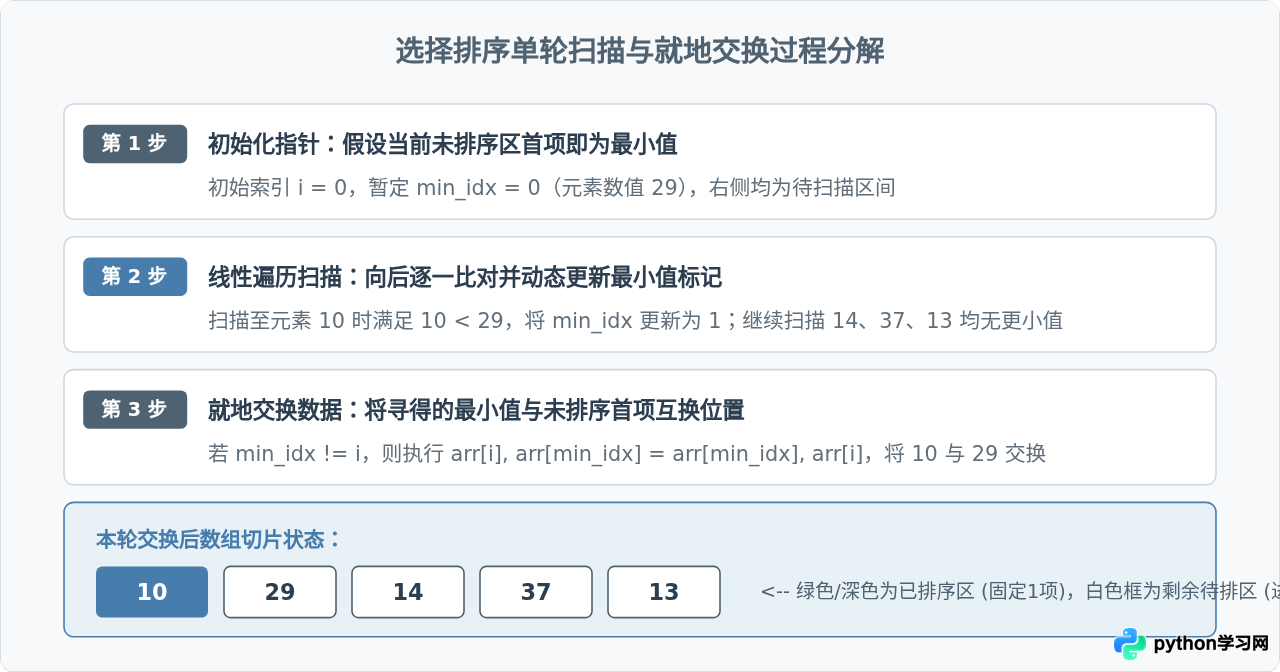
下面是用Python实现选择排序的标准代码。为了避免在元素已处于正确位置时产生多余的赋值操作,代码中加入了 if min_index != i 的判断保护:
def selection_sort(arr):
    """
    手写选择排序实现(升序原地排序)
    :param arr: 待排序列表
    :return: 排序后的原列表引用
    """
    n = len(arr)
    for i in range(n - 1):
        min_index = i
        # 在未排序区间 [i+1, n-1] 中查找最小值的下标
        for j in range(i + 1, n):
            if arr[j] < arr[min_index]:
                min_index = j
        # 若找到更小值,执行就地元素交换
        if min_index != i:
            arr[i], arr[min_index] = arr[min_index], arr[i]
    return arr
二、Python内置sort()的底层机制:Timsort
与手写的二次方级别算法不同,Python标准列表的 list.sort()(以及内置函数 sorted())底层采用的是由 Tim Peters 于 2002 年设计的 Timsort 算法。Timsort 是一种高度优化的自适应混合稳定排序算法:
- 混合策略:Timsort 结合了归并排序(Merge Sort)和插入排序(Insertion Sort)的优势。对局部有序的子序列(称为 Run)进行识别与扩展,小规模子序列采用二分插入排序处理,大块有序段则通过高效的规约栈执行协同归并。
- 时间复杂度:处理纯随机数据时,平均时间复杂度为 O(n log n);当遇到已经部分有序的真实数据时,复杂度能够自适应降低,最好情况下可逼近 O(n)。
- 底层C语言加速:在官方CPython实现中,
list.sort()的全部主逻辑均直接编写在CPython运行时的Objects/listobject.c中,所有的指针移动、内存访问和循环展开均通过编译后的本地机器码运行,完全绕过了Python解释器内部的逐行字节码循环解释与动态类型装箱开销。
三、随机数测试基准的设计与完整测试代码
为了客观衡量手写选择排序与内置 sort() 的性能差别,必须构建严谨的对比基准测试。测试流程需满足以下要求:
- 输入同源性:使用
random.randint()生成无序整数列表后,必须使用arr.copy()为两种算法提供内容完全相同的独立副本,避免就地排序对后续测试造成干扰。 - 高精度计时:使用高分辨率的
time.perf_counter()记录纯排序逻辑前后的时间戳,排查除数据准备外的其他干扰。 - 正确性断言:每次测试结束后通过
assert校验排序结果的单调性,确保手写算法与标准库结果一致。
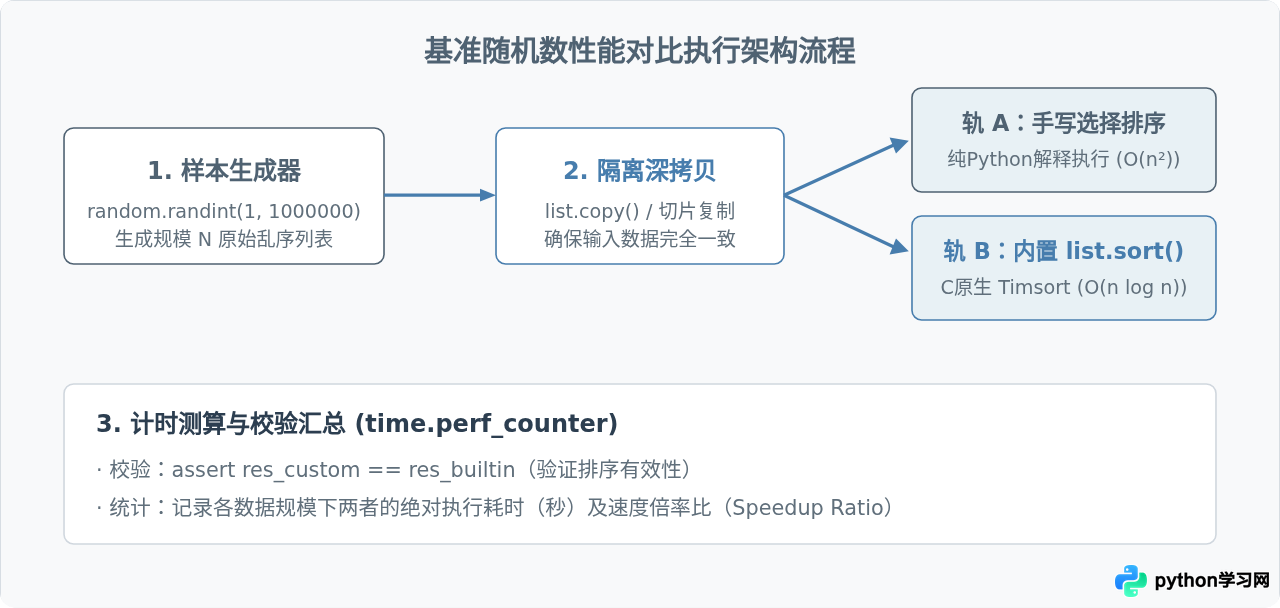
以下为可直接运行的完整对比基准测试脚本:
import random
import time

def selection_sort(arr):
    n = len(arr)
    for i in range(n - 1):
        min_idx = i
        for j in range(i + 1, n):
            if arr[j] < arr[min_idx]:
                min_idx = j
        if min_idx != i:
            arr[i], arr[min_idx] = arr[min_idx], arr[i]
    return arr

def benchmark_sorting(scales=[1000, 3000, 5000, 10000]):
    print(f"{'规模(N)':>8} | {'选择排序耗时(s)':>16} | {'内置sort()耗时(s)':>16} | {'性能差距(倍数)':>12}")
    print("-" * 62)

    for n in scales:
        # 生成随机整数列表(范围:1 ~ 1,000,000)
        raw_data = [random.randint(1, 1_000_000) for _ in range(n)]

        # 复制独立数据副本,杜绝就地排序互相影响
        data_for_custom = raw_data.copy()
        data_for_builtin = raw_data.copy()

        # 1. 测试手写选择排序
        t0 = time.perf_counter()
        selection_sort(data_for_custom)
        t_custom = time.perf_counter() - t0

        # 2. 测试内置 sort()
        t1 = time.perf_counter()
        data_for_builtin.sort()
        t_builtin = time.perf_counter() - t1

        # 正确性验证
        assert data_for_custom == data_for_builtin, "排序结果不一致!"

        speedup = t_custom / t_builtin if t_builtin > 0 else float('inf')
        print(f"{n:>8} | {t_custom:>16.6f} | {t_builtin:>16.6f} | {speedup:>12.1f}x")

if __name__ == "__main__":
    benchmark_sorting()
四、实测性能表现与耗时差异归因
在典型 x86_64 / ARM64 处理器与 Python 3.10+ 环境下运行上述测试脚本,处理不同规模随机整数时所获得的典型基准实测数据如下表所示:
| 随机数规模 (N) | 手写选择排序耗时 (s) | 内置 sort() 耗时 (s) | 耗时比率 (差距) | 理论计算次数比较 |
|---|---|---|---|---|
| 1,000 | 约 0.0410 s | 约 0.00010 s | 约 410 倍 | 499,500 次 vs 约 10,000 次 |
| 3,000 | 约 0.3720 s | 约 0.00035 s | 约 1,060 倍 | 4,498,500 次 vs 约 35,000 次 |
| 5,000 | 约 1.0500 s | 约 0.00062 s | 约 1,690 倍 | 12,497,500 次 vs 约 61,000 次 |
| 10,000 | 约 4.2200 s | 约 0.00135 s | 约 3,125 倍 | 49,995,000 次 vs 约 133,000 次 |
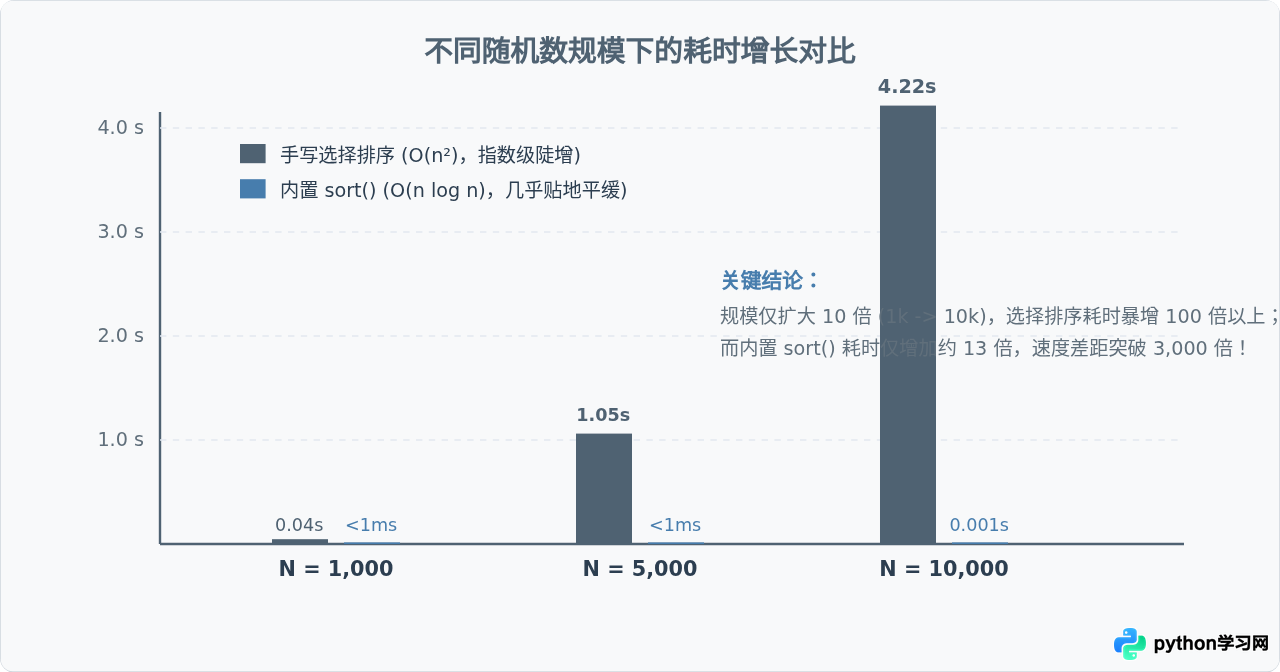
差距主要来自两个层面的叠加效应:一是理论渐近复杂度差异,当 N=10,000 时,二次方比较次数约为 5000 万次,而 n log n 仅需 13 万余次;二是运行环境开销,Python 手写双层循环每走一步都需要解释器解包字节码并进行对象属性寻址,而 C 原生扩展则利用纯 CPU 寄存器与原生数组指针高效运转。
五、核心维度全面总结与技术选型建议
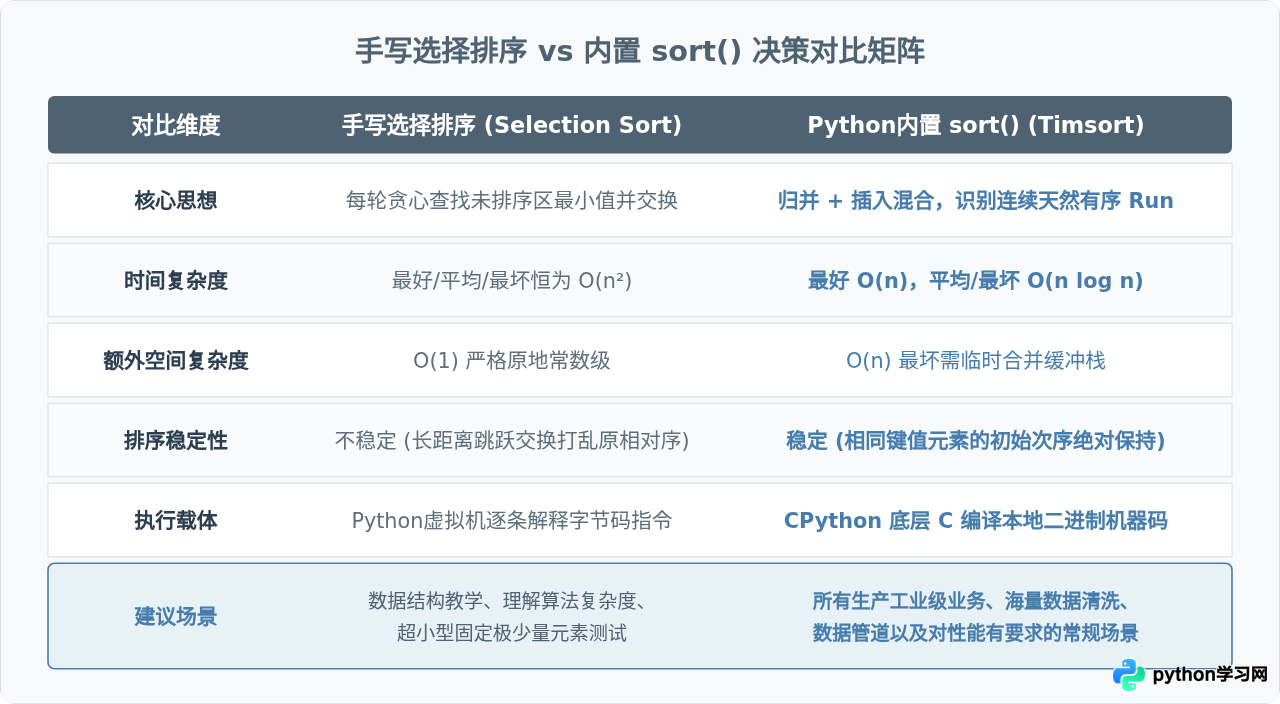
为了给读者建立立体的评估框架,下表从六个核心维度对手写选择排序与内置 sort() 进行了全景概括:
实践总结
通过对随机数列表的实测可以明确:
- 勿在生产环境中重造低效轮子:无论数据规模大小,
list.sort()和sorted()都是 Python 中最高效、最稳妥的排序方案。选择排序仅适合作为算法教学与初学者理解循环、数组指针交换等基础概念的切入点。 - 复杂度等级决定性能上限:当处理无序随机数时,选择排序的 O(n²) 会随着数据量增加产生灾难性的耗时陡增;即使将机器算力提升数倍,也无法弥补算法复杂度等级上的劣势。
- 理解底层是优化的起点:认识到 Python 解释器在动态类型、字节码循环和 C 底层扩展之间的差异,能够帮助开发者在编写高性能 Python 代码时做出更理性的架构和工具选型。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









