

python函数定义后为什么要调用才执行
深入解析Python中函数定义后为什么要调用才执行的核心原理。从解释器底层机制、代码对象编译、调用栈帧生命周期及架构解耦价值等维度全面拆解,帮助初学者建立清晰的执行心智模型。
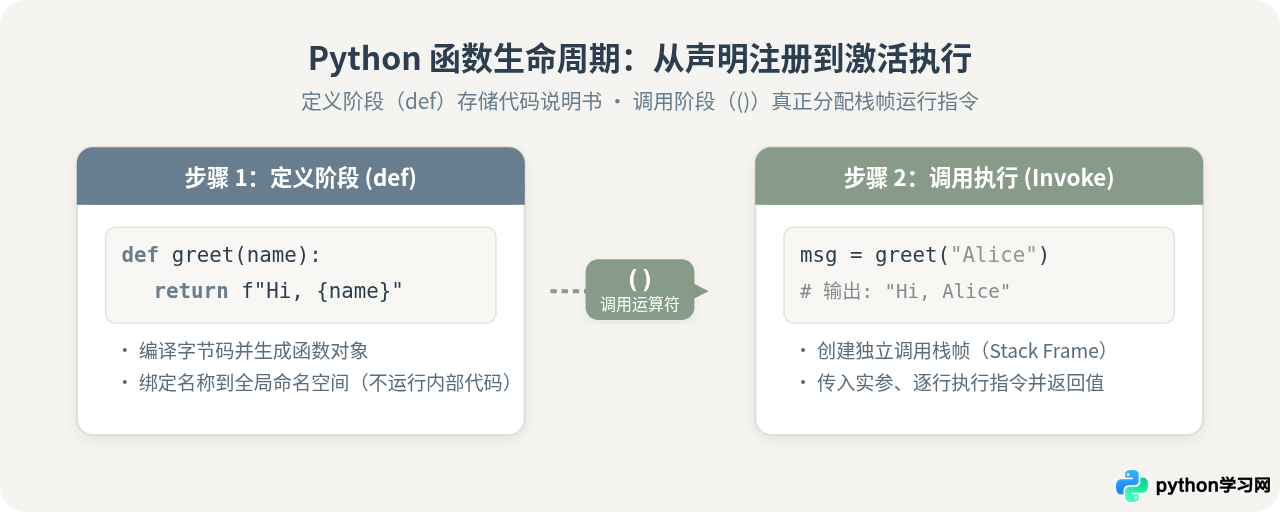
在 Python 中,函数定义(使用 def 语句)的本质是“向解释器注册一段可重复使用的逻辑说明书”,而非立即执行这段代码。Python 解释器在遇到 def 时,会将其内部语句编译为只读的代码对象(Code Object),并将该函数对象绑定到当前命名空间中,随后直接跳过函数体继续向下运行。只有在后续代码中显式附加圆括号运算符 () 发起调用时,解释器才会为其分配调用栈帧、绑定具体参数并正式执行。这种“定义与执行分离”的机制,是现代高级程序语言实现逻辑复用、条件调度以及模块化协作的基础基石。
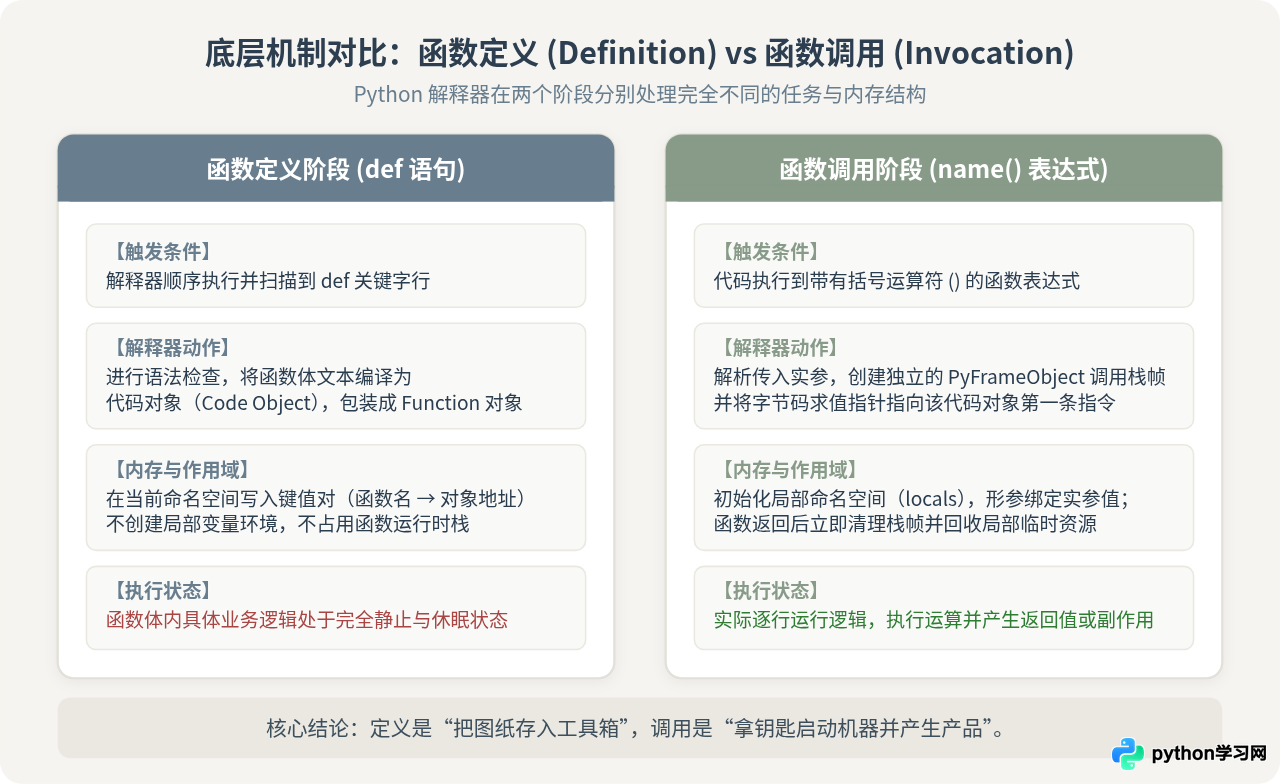
一、定义与调用的本质区别:机制与状态对比
初学者在编写 Python 代码时,经常产生一种直觉误区:“既然我已经在文件中写下了代码,解释器从上往下读到这一行,它就应该顺理成章地运行出结果。”然而,在解释器的执行模型中,“定义语句”与“普通可执行语句”有着根本不同的职责定位。
我们通过一个现实生活中的直观对照来理解:写下一份“红烧肉烹饪菜谱”,并不等于开火起锅把肉做熟。
- 函数定义阶段(写菜谱):你确定了菜谱的名字(函数名)、需要哪些食材配料(形参),并把具体的下锅翻炒步骤写在纸上(函数体指令)。写完菜谱后,厨房里并没有任何食物产出,但此时这份菜谱已经被妥善存入料理柜(内存命名空间),随时可以拿出来指导操作。
- 函数调用阶段(开火炒菜):客人来到餐厅点单,厨师按照菜谱的名字取出说明,准备好新鲜的具体食材(实参),点火热锅并严格按照说明一步步翻炒(创建执行栈帧逐行执行),最终端出一盘热腾腾的菜品(返回值)。
在 Python 底层,这两个阶段在解释器内部所经历的生命周期状态完全不同。为了让对比更加直观,下表总结了二者在触发条件、解释器动作以及内存表现上的关键差异:
| 对比维度 | 函数定义阶段(def 语句) | 函数调用阶段(func() 表达式) |
|---|---|---|
| 语法形式 | def calculate_area(width, height): ... |
result = calculate_area(10, 20) |
| 触发时机 | 脚本首次加载或执行到 def 所在的代码行 |
程序流程推进到包含 () 运算符的调用位置 |
| 解释器行为 | 词法分析、语法检查、编译为字节码代码对象并包装为函数对象 | 在当前作用域查找函数符号,分配运行时栈帧,逐行执行字节码 |
| 内存与作用域 | 在当前作用域字典中添加键值映射,不建立局部变量环境 | 开辟专属的局部命名空间(locals),形参与局部变量在此诞生 |
| 内部代码状态 | 完全静态冷冻,内部语句一条也不运行 | 动态激活运行,产生计算逻辑或外部副作用 |
| 生命周期长度 | 随命名空间持续存活(通常贯穿整个模块运行周期) | 随调用开始而诞生,随函数 return 立即销毁 |
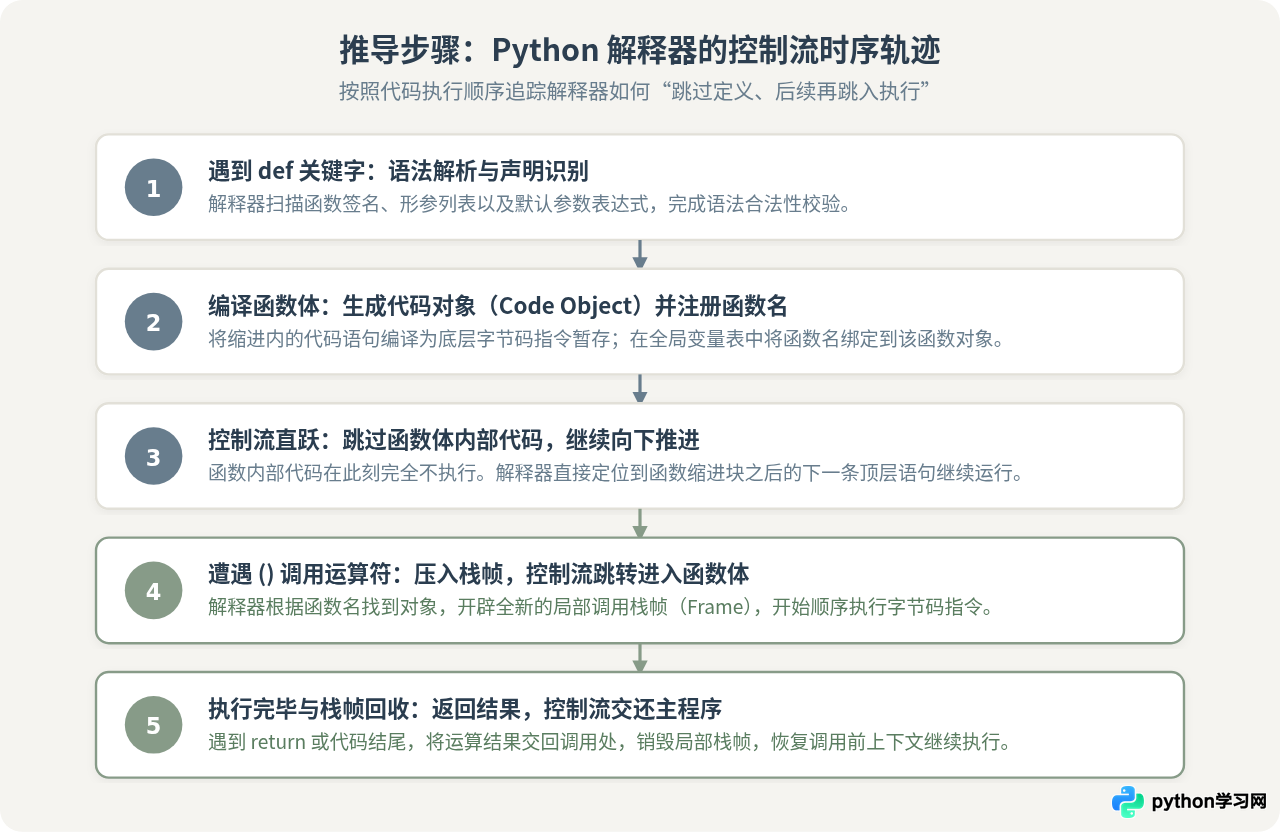
二、解释器时序追踪:从代码解析到控制流流转
为了具体看清 Python 解释器是如何执行一段带有函数的脚本的,我们可以观察下面这段简短的代码示例:
# 文件名:timing_demo.py
print("【步骤 A】脚本启动,准备执行")

def calculate_tax(amount):
    print("  --> [执行内部] 正在根据金额计算税额...")
    rate = 0.08
    return amount * rate

print("【步骤 B】函数定义结束,此时尚未调用")

tax_a = calculate_tax(100)
print(f"【步骤 C】第一次调用计算结果: {tax_a}")

tax_b = calculate_tax(500)
print(f"【步骤 D】第二次调用计算结果: {tax_b}")
当我们运行上述代码时,终端中呈现的实际输出结果如下:
【步骤 A】脚本启动,准备执行
【步骤 B】函数定义结束,此时尚未调用
  --> [执行内部] 正在根据金额计算税额...
【步骤 C】第一次调用计算结果: 8.0
  --> [执行内部] 正在根据金额计算税额...
【步骤 D】第二次调用计算结果: 40.0
请仔细观察输出的顺序:在“步骤 A”打印之后,紧接着输出的是“步骤 B”,而函数体内部的 "正在根据金额计算税额..." 并没有在 A 和 B 之间出现!这一输出时序精确地还原了解释器的处理步骤:
-
第一步:识别签名并编译字节码。
当解释器读到第 3 行的def calculate_tax(amount):时,它确认了这是一个函数定义语句。它对该行及缩进块内的语法进行合规性验证,把函数体代码编译成了底层的 Python 字节码对象(Bytecode / Code Object)。 -
第二步:封装函数对象并绑定名称。
解释器在堆内存中实例化出一个function对象,把编译好的字节码以及当前的全局环境信息打包存放在里面,随后在模块的全局字典globals()中写入一条记录:'calculate_tax' : <function calculate_tax>。 -
第三步:越过缩进块,继续顺序向前推进。
在完成绑定后,解释器的指令指针直接跳过缩进的函数体内容,来到第 8 行,立即执行第 8 行的print("【步骤 B】...")。因此,在没有触发调用的情况下,函数内的语句一条都没有被解释运行。 -
第四步:遭遇括号运算符,控制权转移。
当执行推进到第 10 行的calculate_tax(100)时,圆括号(100)作为调用运算符发挥作用。解释器在命名空间中通过名字calculate_tax检索到之前存储的函数对象,开辟一块新的调用栈帧(Call Frame),将实参100绑定到形参amount上,然后把控制流跳转到函数内部。此时,函数体内的打印和乘法指令才正式开始运行。 -
第五步:返回结果并回收临时栈帧。
遇到return后,计算结果8.0被交回给调用处赋值给tax_a,该函数的调用栈帧随即被弹出并销毁,控制权恢复到主流程继续执行。
三、核心思考:如果不分离,程序会变成什么样?
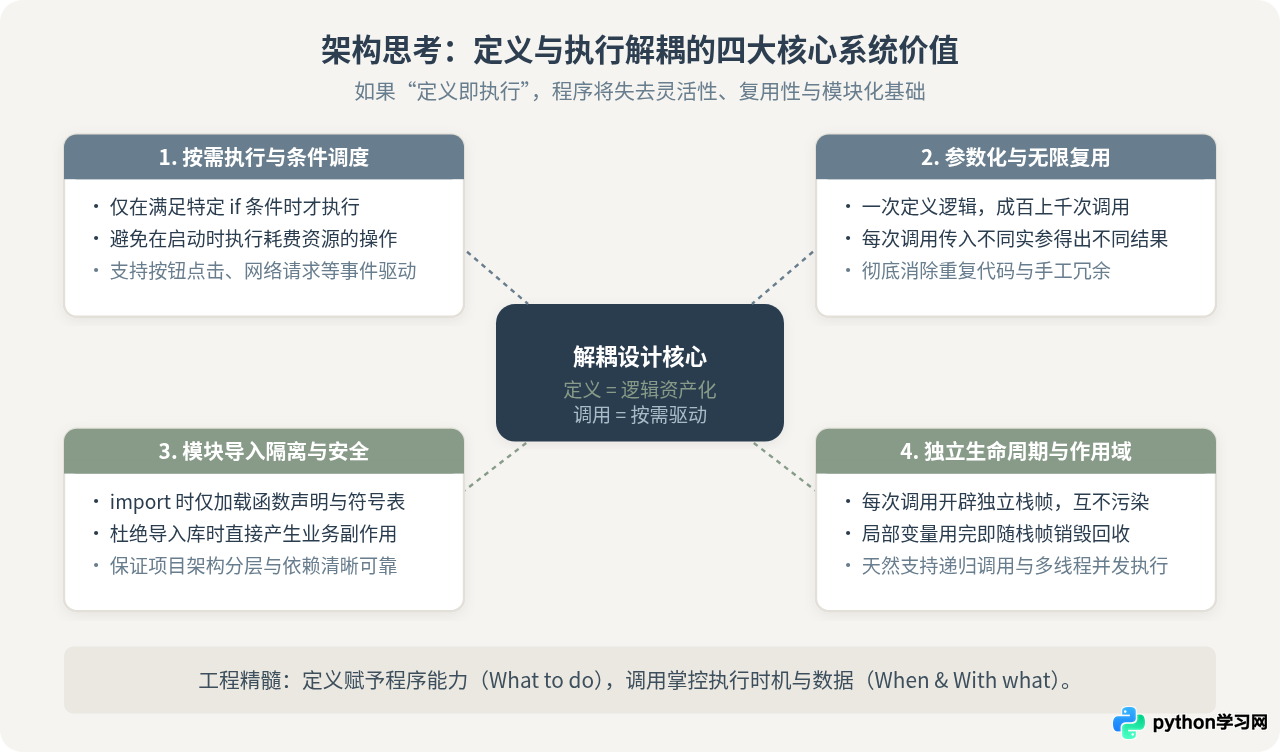
为什么编程语言的设计者不让函数“定义完成就立刻自动执行一次”?深入思考这个问题,能帮助我们透彻理解现代软件架构的组织哲学。“定义”与“调用”在物理时序上的解耦,给软件开发带来了不可替代的核心价值:
1. 支持按需调度与条件分支
现实中的绝大部分程序逻辑都不是无条件立即运行的。例如在支付系统中:
def charge_credit_card(card_number, amount):
    # 与银行网关通信扣款
    gateway.process_payment(card_number, amount)

if user.clicks_pay_button():
    charge_credit_card(user.card, order.total)
如果定义函数就会立刻执行,那么用户刚打开网页或者脚本刚启动,银行卡扣款逻辑就会在没有任何订单的情况下被直接触发。只有将定义(赋予能力)与调用(按需触发)彻底分开,程序才能根据运行时的真实条件(如用户交互、时间定时、传感器信号、网络请求)来灵活掌控运行契机。
2. 实现单点定义与无限参数化复用
函数的核心使命是抽象通用算法。定义时,形参 (amount) 只是一个形式占位符;调用时,调用者可以按需传入 100、500 甚至 10000。如果定义即执行,由于定义时并不存在真实的运行时输入数据,函数就只能执行无参数或者硬编码的固定逻辑,退化为一段只能跑一次的散装脚本,彻底失去了参数化复用的通用价值。
3. 保障模块导入的安全与性能
在 Python 项目中,我们每天都在大量使用 import math、import requests、import numpy 等外部模块。
当我们在自己的代码中写下 import math 时,Python 解释器会从头到尾执行 math.py 模块中的顶层语句。因为模块内的数学函数都只是被 def 声明并注册了名称,而没有被立即执行,所以导入过程极其迅速且安全。如果定义函数就会执行,那么一次 import 就会导致该模块内所有的计算、数据库建表、磁盘写入和网络请求全部被强制跑一遍,整个软件生态将陷入灾难性的副作用失控中。
4. 确保运行状态与调用环境隔离
每一次函数调用都会在系统内存中压入一个独立的调用栈帧(Frame)。在这个栈帧里,函数拥有属于本次调用的局部变量字典。当函数在多处被调用、在循环中反复调用、或者进行自我递归调用时,各个调用实例之间的参数和内部临时变量彼此独立,绝不互相污染。这种干净的生命周期管理,必须依赖于由 () 主动触发的独立栈帧构建。
四、常见认知误区与排查指南
理解了“定义与调用分离”的原理后,初学者在实际编码中容易踩坑的几个典型场景就能迎刃而解:
这是导致“写了函数却不见执行”最高频的错误。在 Python 中,函数是一等公民(First-Class Object)。单独写函数名 calculate_tax,表示的是访问这个函数对象本身(类似拿到了那张菜谱纸);只有写上 calculate_tax(),才是命令解释器执行其内部代码。
# 错误写法:只写了函数名,没有任何控制台输出
calculate_tax

# 打印出来的只是该对象在内存中的地址信息
print(calculate_tax)  # <function calculate_tax at 0x7fa2c10b>

# 正确写法:加上括号运算符触发执行
calculate_tax(200)既然定义阶段只注册说明书,那函数的“默认参数”是在什么时候计算的?答案是:默认参数在函数定义阶段求值一次,且仅求值一次!
def add_item(item, container=[]):
    container.append(item)
    return container

print(add_item("A"))  # 输出: ['A']
print(add_item("B"))  # 输出: ['A', 'B']  <-- 并非预期的 ['B']!
原因就在于:container=[] 位于 def 所在的第一行,它是在解释器执行函数定义时就创建完毕并存入函数对象的 __defaults__ 元组中的。每次后续调用如果未传参,都会共用这同一个列表对象。因此,对于可变默认参数,推荐的规范做法是使用 None 作为默认值,在调用执行的函数体内部再进行实例化判断。
五、核心认知模型与总结
为了在今后的编程中彻底规避此类困惑,我们可以把 Python 函数的生命周期建立成一套立体的心智模型:
- 代码层:
def负责立项登记,函数名负责名片展示,()才是点火钥匙; - 内存层:编译产生 Code Object(静态逻辑),封装成 Function Object(待命资产),调用生成 Frame Object(动态作业);
- 行为层:不调用就是静置的安全模板,一经调用即开辟独立作用域,算完即走、随调随走。
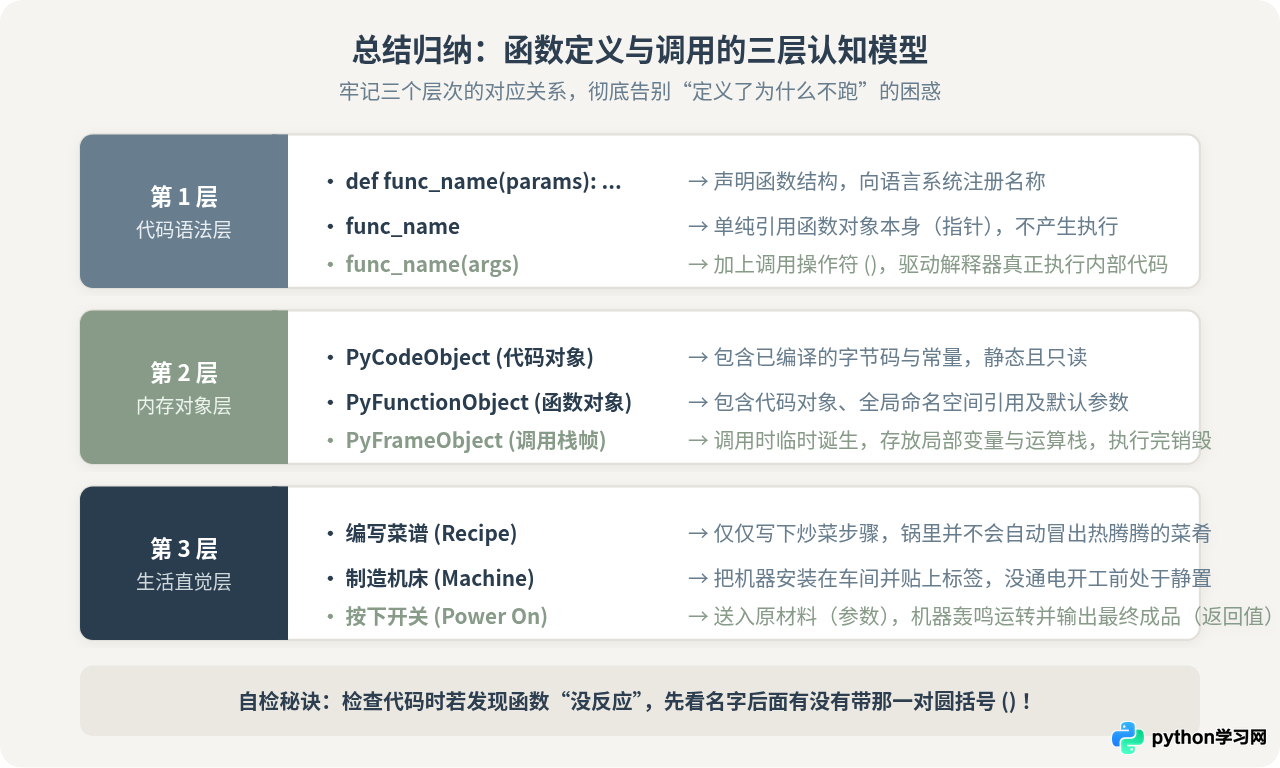
综上所述,Python 函数定义后必须通过调用才执行,并不是编程语言制造的多余繁琐步骤,而是为了将“静态的逻辑抽象能力”与“动态的业务运行调度”进行精准解耦的必然设计。掌握了这一核心分水岭,你在阅读代码、设计程序架构以及排查执行流相关 Bug 时,就能站在解释器的视角,对程序每一步在做什么、何时执行胸有成竹。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









