

Python threading模块基础:创建线程与守护线程设置
系统讲解Python标准库threading模块的核心基础,包括主线程与子线程的生命周期、函数传参与类继承两种创建方式、join方法协作机制,以及守护线程(daemon)的退出规则、配置时机与安全退出实践。
在 Python 程序中执行文件下载、网络接口请求或磁盘日志写入等耗时操作时,若采用单线程串行模式,主流程必须停顿等待当前操作完成才能处理下一项任务。Python 标准库自带的 threading 模块提供了轻量级的并发支持。通过将独立的阻塞任务指派给子线程执行,主程序可以在后台并发处理其他逻辑。本文系统梳理 threading 模块的基础核心:从线程与进程的本质差异、创建并启动线程的两种标准写法,到控制线程生命周期的阻塞等待方法 join(),以及守护线程(daemon)的判定准则、配置时机与安全退出实践。
一、并发核心机制:线程模型与全局解释器锁
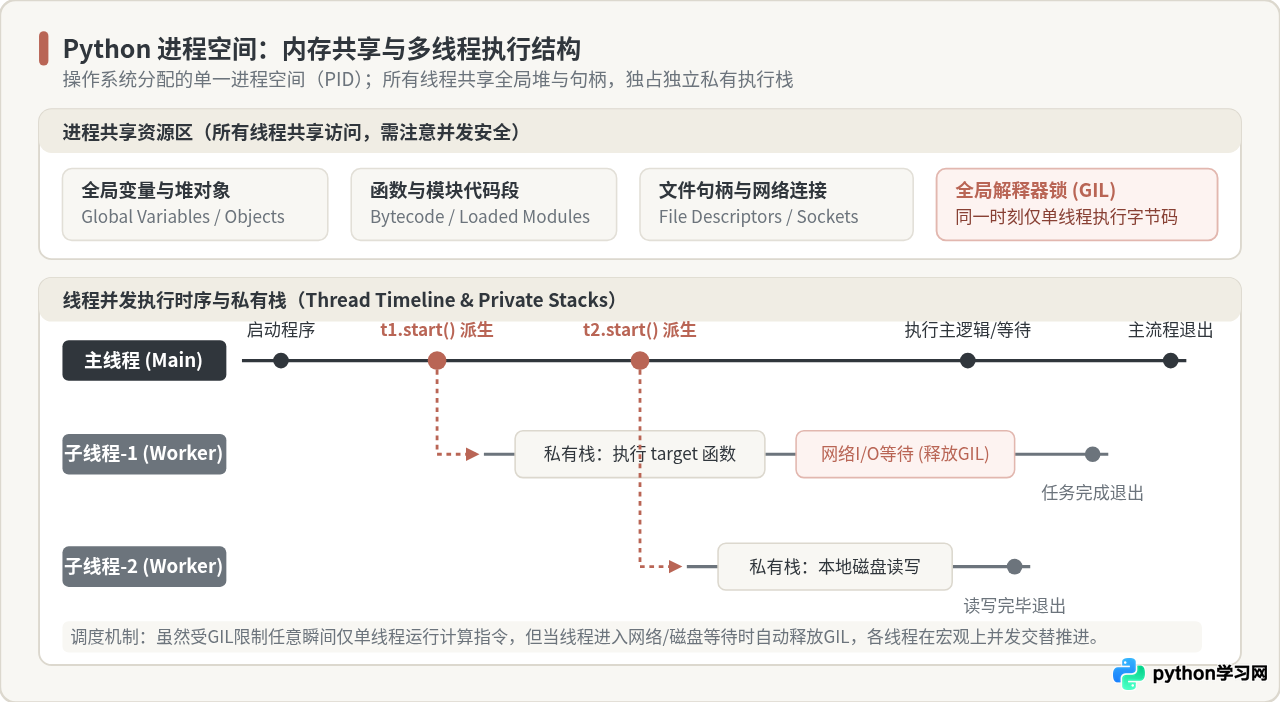
在操作系统层面,进程(Process)是系统分配资源(如虚拟内存、文件句柄)的独立单元,拥有独立的内存地址空间;而线程(Thread)是操作系统调度的最小执行单元,存在于进程之内。同一个 Python 进程内创建的所有子线程,都会共享该进程的全局变量、堆内存对象和系统资源,但每个线程拥有独立的调用栈(Call Stack)与局部变量空间。
理解 Python 多线程,必须清楚全局解释器锁(Global Interpreter Lock,简称 GIL)的运行机制。在官方标准的 CPython 解释器中,GIL 保证了同一时刻只有一个线程在 CPU 核心上执行 Python 字节码。这意味着:
- 密集型计算任务(CPU-bound):如复杂的矩阵运算、高精度数学推演、视频转码。多线程无法突破 GIL 的限制,无法利用多核 CPU 实现并行算力倍增,反而会因频繁的线程上下文切换产生额外开销。此类任务应采用
multiprocessing多进程模块。 - 输入输出密集型任务(I/O-bound):如网络请求下载、数据库读写、文件批量存储、远程接口轮询。当某个线程发起 I/O 操作陷入等待时,Python 解释器会自动释放 GIL,让其他就绪线程获得 CPU 执行权。因此,
threading模块非常适合大幅提升 I/O 密集型任务的宏观并发吞吐率。
二、创建与启动线程的两种标准方式
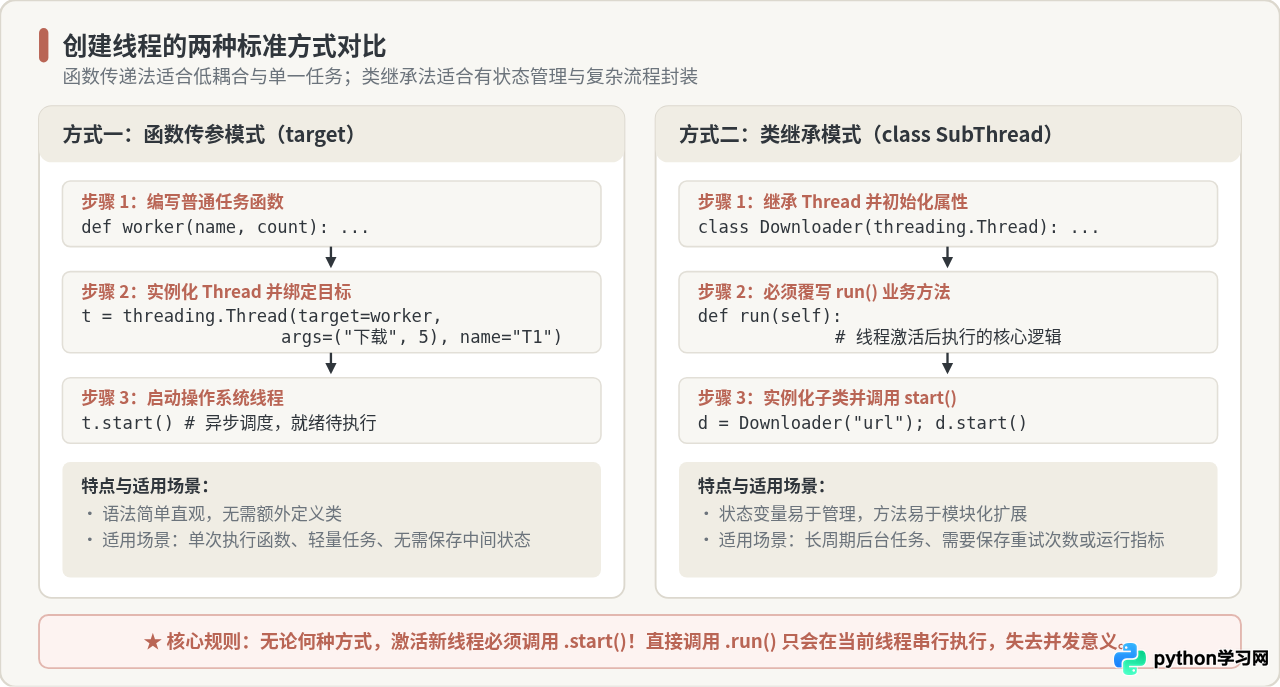
在 threading 模块中,线程的核心封装类是 threading.Thread。创建并运行线程有两种工业标准的实现途径:函数传递模式(target 参数)与类继承模式(重写 run 方法)。
方式一:函数传递模式(实例化 Thread 并绑定 target)
这是最常用、最直接的方式。只需编写一个常规函数,然后将该函数名传递给 threading.Thread 的 target 参数,通过元组 args 或字典 kwargs 传递实参即可。
import threading
import time

def download_task(file_name, delay_seconds):
    """模拟文件下载的阻塞函数"""
    thread_name = threading.current_thread().name
    print(f"[{thread_name}] 开始下载: {file_name}")
    time.sleep(delay_seconds)  # 模拟网络I/O等待
    print(f"[{thread_name}] 下载完成: {file_name}")

if __name__ == "__main__":
    print(f"[{threading.current_thread().name}] 主程序启动")

    # 创建两个线程对象
    # 注意:args 必须传递元组;若只有一个参数,必须加英文逗号,例如 args=("文件A",)
    t1 = threading.Thread(target=download_task, args=("数据集.csv", 2), name="下载线程-1")
    t2 = threading.Thread(target=download_task, args=("模型权重.bin", 1), name="下载线程-2")

    # 启动线程
    t1.start()
    t2.start()

print(f"[{threading.current_thread().name}] 主程序已派发所有任务,继续向下执行")观察输出可见,主线程调用 t1.start() 和 t2.start() 后,并未停顿等待下载完成,而是瞬间输出了后续的主线程日志;两个子线程在后台独立推进,耗时较短的“下载线程-2”先于“下载线程-1”完成。
方式二:类继承模式(继承 threading.Thread 并重写 run)
当任务逻辑较为复杂、需要维护跨步骤的内部状态(如重试计数器、下载进度统计、连接池缓存),或者需要封装完整的生命周期管理时,面向对象的类继承模式结构更清晰。
import threading
import time

class FileDownloadThread(threading.Thread):
    def __init__(self, file_name, delay_seconds, name=None):
        # 必须显式调用父类 __init__ 初始化底层线程状态
        super().__init__(name=name)
        self.file_name = file_name
        self.delay_seconds = delay_seconds
        self.downloaded_bytes = 0

    def run(self):
        """线程启动后在独立调用栈中自动执行的方法"""
        thread_name = self.name
        print(f"[{thread_name}] 任务类开始处理: {self.file_name}")
        time.sleep(self.delay_seconds)
        self.downloaded_bytes = 1024 * 1024  # 更新类内部状态
        print(f"[{thread_name}] 任务类处理完毕,写入字节: {self.downloaded_bytes}")

if __name__ == "__main__":
    print(f"[{threading.current_thread().name}] 主流程开始")

    worker = FileDownloadThread("用户备份.zip", 2, name="对象化工作线程")
    worker.start()  # 触发操作系统线程执行 run()

print(f"[{threading.current_thread().name}] 主流程派发完毕")很多初学者会误将 t.start() 写成 t.run()。直接调用 run() 仅仅是在当前调用者线程(通常是主线程)中以常规方式同步执行该方法,完全不会向操作系统申请派发新线程,代码依然串行阻塞。只有调用 start(),底层才会创建新线程上下文,并在新线程中异步调用 run()。
三、线程同步与协作:join() 方法的作用
在默认情况下,主线程启动子线程后会继续执行后续语句。如果后续代码依赖子线程的产出结果(例如子线程从数据库查询数据,主线程负责对数据做聚合展示),主线程就不能提前运行,必须等待子线程执行完毕。这就是 join() 方法的核心功能。
join([timeout]) 会让调用该方法的当前线程(通常是主线程)进入阻塞挂起状态,直到被调用的目标子线程执行结束退出,或者超时时间到达。
import threading
import time

def process_data(batch_id):
    print(f"批次 {batch_id}: 开始数据处理...")
    time.sleep(2)  # 模拟计算耗时
    print(f"批次 {batch_id}: 处理完毕并入库")

if __name__ == "__main__":
    t = threading.Thread(target=process_data, args=(101,))
    t.start()

    print("主线程:等待批次处理结果...")
    t.join()  # 主线程在此阻塞,直到 t 线程执行完毕
print("主线程:检测到子线程已结束,开始生成汇总报告!")如果不加 t.join(),“开始生成汇总报告”就会紧随“等待批次处理结果”立刻打印,此时数据尚未入库,必然导致业务逻辑出现时序错误。通过 join(timeout=3.0) 还可以设定最长等待秒数,防止子线程由于网络假死导致主程序无限制挂起。
四、守护线程(Daemon Thread)的机制与配置
什么是守护线程
守护线程(Daemon Thread)是一种在后台运行、为其他非守护线程提供辅助性服务的线程。典型的守护线程包括:服务心跳探针、临时内存垃圾监测、性能指标后台采样、未落盘日志轮询等。
守护线程与常规线程(非守护线程)的核心区别,在于它对 Python 解释器进程退出行为的影响:
- 非守护线程(默认,daemon=False):是程序的主力业务载体。只要进程中还有任意一个存活的非守护线程,即使主线程的代码已经全部执行到底,Python 解释器进程也绝不会退出,必须挂起等待该非守护线程自然结束。
- 守护线程(daemon=True):是程序的辅助挂件。当进程中所有存活的非守护线程全部结束时,Python 解释器会认为程序的核心业务已完成,进程会立即无条件退出。所有当前仍在运行的守护线程会被操作系统直接销毁,不会等待其完成。
如何设置守护线程
在 Python 3 中,推荐在实例化线程时通过关键字参数直接声明 daemon=True;也可以在线程启动前修改属性 t.daemon = True。
# 推荐写法(Python 3.3+ 语法,直观且安全)
t = threading.Thread(target=worker, daemon=True)

# 兼容写法(属性赋值)
t = threading.Thread(target=worker)
t.daemon = True  # 必须在调用 t.start() 之前设置!
t.start()一旦对线程调用了 t.start(),该线程就进入了活动就绪状态。如果在此之后尝试执行 t.daemon = True,Python 会立即抛出严重的运行时异常:RuntimeError: cannot set daemon status of active thread。因此,守护属性的配置必须在线程激活之前完成。
守护线程与非守护线程的对比实验
通过对比以下两段极简代码的运行输出,可以直观验证两者的退出行为差异。
实验 A:默认非守护线程(进程等待子线程收尾)
import threading
import time

def regular_worker():
    print("子线程:开始执行耗时任务(3秒)...")
    time.sleep(3)
    print("子线程:耗时任务顺利收尾!")

if __name__ == "__main__":
    t = threading.Thread(target=regular_worker)  # 默认 daemon=False
    t.start()
    print("主线程:主线程最后一行代码已执行完毕!")
实验 B:守护线程(主线程结束后子线程被立即销毁)
import threading
import time

def daemon_worker():
    print("守护线程:进入后台持续循环...")
    time.sleep(3)
    print("守护线程:这一行永远不会被执行!")

if __name__ == "__main__":
    t = threading.Thread(target=daemon_worker, daemon=True)  # 设置为守护线程
    t.start()
    print("主线程:主线程最后一行代码已执行完毕,准备退出!")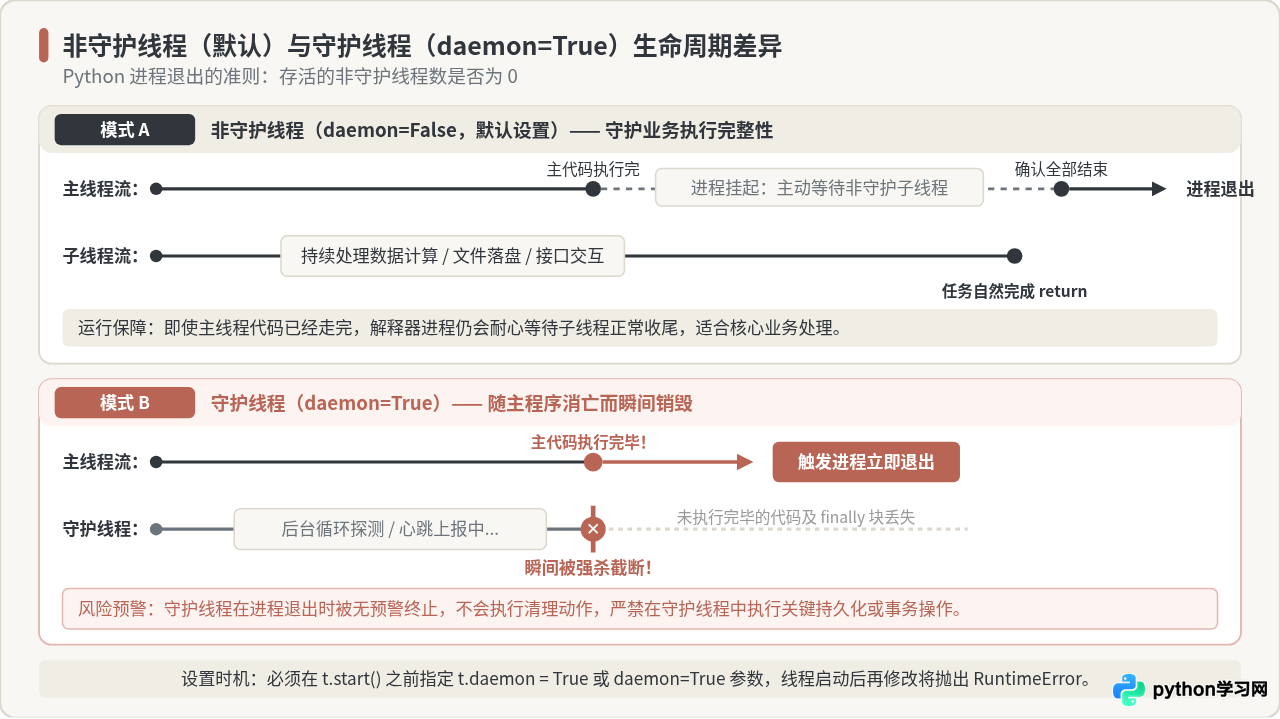
五、守护线程的安全边界与优雅退出模式
守护线程非常便捷,但它带来了一个巨大的潜在风险:资源清理失效。
当 Python 解释器决定退出时,守护线程是被突然杀死的。这意味着:
- 守护线程中的
finally代码块大概率不会被执行。 - 使用
with open(...)写入文件的缓冲区可能未被刷新写盘(flush),导致输出文件内容截断或损坏。 - 数据库连接、网络 Socket 或文件互斥锁可能未正常向远端发送断开协议,造成连接挂起或锁未释放。
因此,对于生产环境的长周期后台服务,推荐的最佳实践是使用 threading.Event 作为退出标志位,实现优雅退出(Graceful Shutdown),而不是任由解释器强杀守护线程。
import threading
import time

class SafeWorker:
    def __init__(self):
        # 创建线程间通信的停止事件标志
        self.stop_event = threading.Event()
        self.thread = threading.Thread(target=self._run_loop, daemon=True)

    def start(self):
        self.thread.start()

    def _run_loop(self):
        print("[后台服务] 启动监控循环...")
        while not self.stop_event.is_set():
            # 使用 event.wait(1) 替代 time.sleep(1),能在收到信号时瞬间响应
            if self.stop_event.wait(timeout=1.0):
                break
            print("[后台服务] 正在执行健康检查心跳...")

        # 退出前的清理动作
        self._cleanup()

    def _cleanup(self):
        print("[后台服务] 收到停止通知,正在平稳释放资源、保存未落盘日志...")
        time.sleep(0.5)  # 模拟资源清理
        print("[后台服务] 资源释放完毕,安全退出!")

    def stop(self):
        print("[主控制] 向后台服务发送终止信号...")
        self.stop_event.set()
        # 阻塞等待后台服务将 _cleanup 真正执行完毕
        self.thread.join(timeout=3.0)

if __name__ == "__main__":
    worker = SafeWorker()
    worker.start()

    time.sleep(3.2)  # 让工作线程运行几次心跳
    worker.stop()    # 主程序通知优雅退出
print("[主控制] 程序整体安全退出")通过 threading.Event() 的 set() 信号,子线程在检查到标志位后主动跳出循环并完成清理;主线程通过 join() 给予子线程充足的收尾时间,既保留了随时退出的灵活性,又消除了数据截断的隐患。
六、非守护线程与守护线程对照及选型指南
在实际工程架构中,应该如何选择是否设置 daemon=True?下表从核心维度对两种模式进行详细对比:
| 对比维度 | 非守护线程(Non-Daemon) | 守护线程(Daemon) |
|---|---|---|
| 参数默认值 | daemon = False(默认行为) |
daemon = True(需显式配置) |
| 解释器退出门槛 | 必须等待所有非守护线程运行完毕 | 不影响解释器退出;无非守护线程时立刻被杀死 |
| finally 代码执行保证 | 完整保证执行 | 不保证执行(极易被跳过) |
| I/O 与文件持久化安全 | 高:数据正常 flush 写盘 | 低:若强退易发生写盘截断与句柄残留 |
| 典型应用场景 | 关键批量下载、数据库批量更新、订单落库、核心事务 | 系统指标探针、心跳维持、临时日志轮询、定时缓存清理 |
| 推荐主线程协同机制 | 调用 t.join() 阻塞等待结果 |
配合 threading.Event 信号优雅停止 |
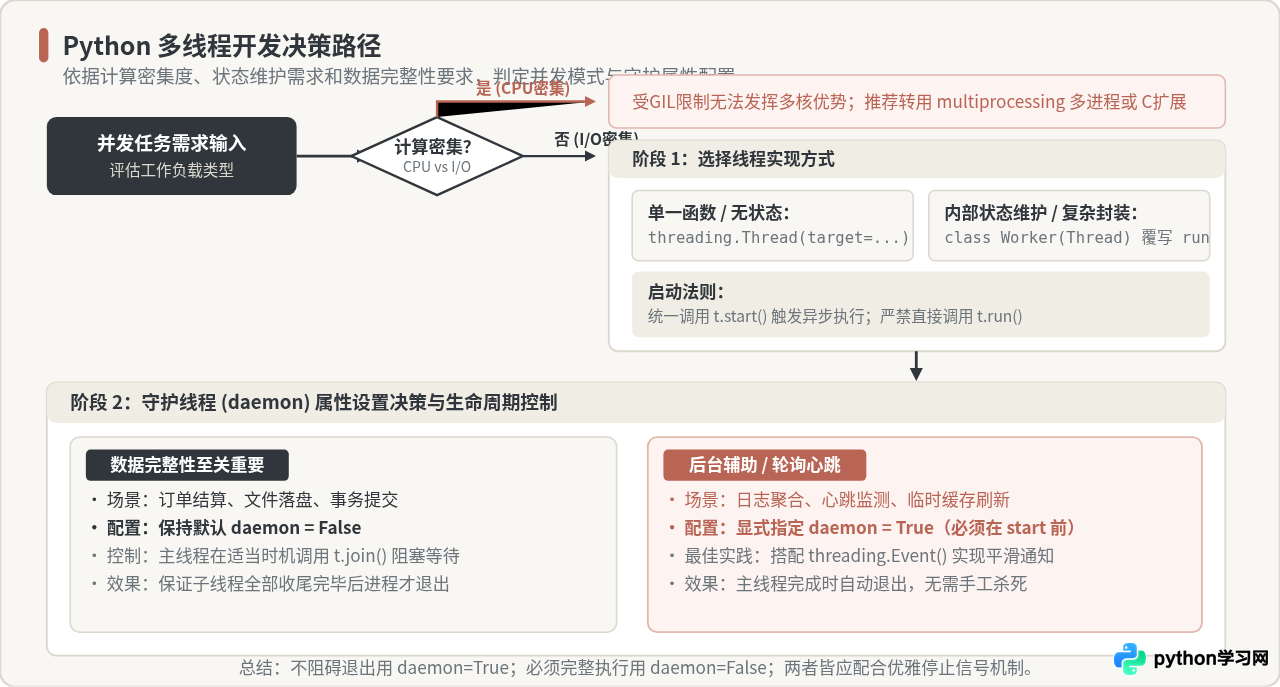
总结而言,Python threading 模块是处理 I/O 阻塞型并发的基石工具。掌握函数传递与类继承两种启动方式、牢记通过 start() 派生操作系统线程、善用 join() 进行主子时序同步,并根据业务对数据持久性的要求谨慎配置 daemon 守护属性与退出机制,是写出高稳定、零泄漏 Python 并发程序的关键基础。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









