

Python爬虫自动化需要掌握哪些第三方库
全面梳理Python爬虫自动化全流程所需掌握的核心第三方库,从网络请求、网页解析到动态浏览器控制及工程调度框架,助你构建稳定高效的自动化数据采集体系。
实现一套稳定可靠的 Python 爬虫自动化系统,核心在于根据目标网站的渲染机制、反爬策略和采集体量,合理搭配网络通信、数据抽取、浏览器驱动及工程调度等维度的第三方库。本文将围绕自动化流程的各个核心环节,明确介绍每个库的职责分工、典型代码范式与技术选型依据。
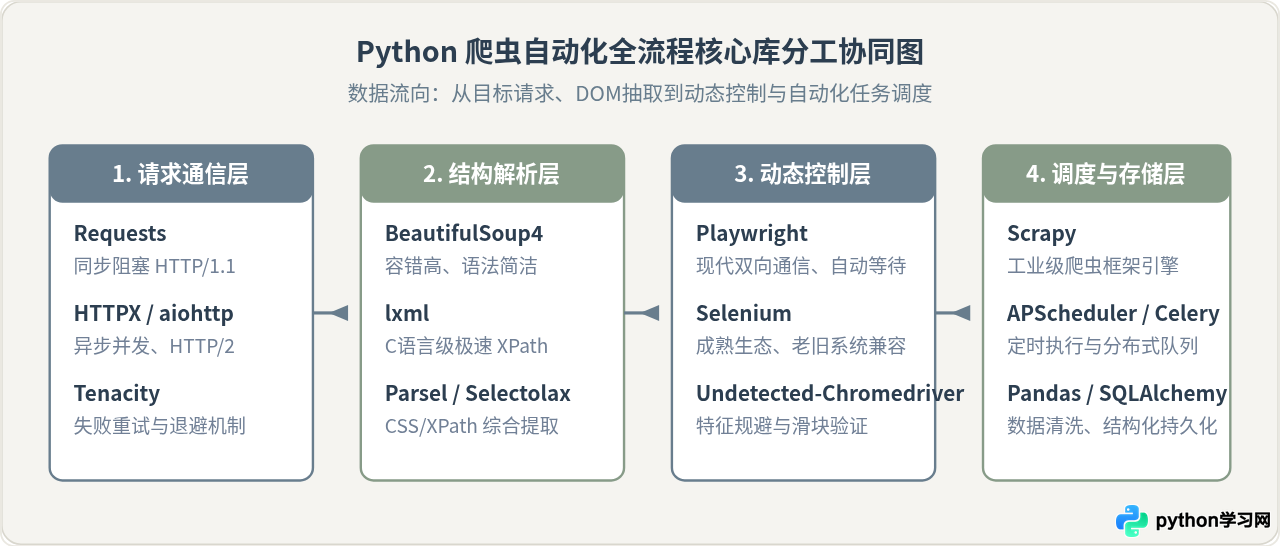
一、网络通信库:自动化请求的发起与会话维持
网络请求是爬虫自动化的第一道入口。根据爬取场景的并发要求与协议特性,主要采用同步与异步两类库。
1. Requests:同步基础与会话管理
requests 是 Python 事实上的 HTTP 标准库。在自动化脚本中,最常用的是通过 requests.Session 自动维护 Cookie、处理重定向,并统一设置全局 Headers。
import requests

session = requests.Session()
session.headers.update({
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36"
})

# 发送带超时与持久化会话的自动化请求
response = session.get("https://api.example.com/items", timeout=10)
if response.status_code == 200:
    data = response.json()
    print("获取成功,数据条数:", len(data))
2. HTTPX 与 aiohttp:异步高并发与 HTTP/2 支持
当目标站点需要抓取数万个页面时,同步请求会导致 CPU 长期处于 I/O 等待状态。httpx 与 aiohttp 提供了基于 async/await 的原生异步接口。其中 httpx 同时提供同步与异步两套 API,且原生支持 HTTP/2 协议多路复用,能显著提高单机请求吞吐量。
import asyncio
import httpx

async def fetch_item(client, item_id):
    url = f"https://api.example.com/items/{item_id}"
    resp = await client.get(url)
    return resp.json()

async def main():
    limits = httpx.Limits(max_keepalive_connections=20, max_connections=50)
    async with httpx.AsyncClient(limits=limits, timeout=10.0) as client:
        tasks = [fetch_item(client, i) for i in range(1, 20)]
        results = await asyncio.gather(*tasks)
        print("异步采集完成,总计条数:", len(results))

# 执行异步主循环
asyncio.run(main())
二、HTML 解析与数据提取库:结构化清洗与定位
从服务器拉取到原始 HTML 字符串后,需要将其解析为可查询的 DOM 树并提取所需字段。
- lxml:基于 C 语言 libxml2 和 libxslt 开发,执行性能极高。支持完整的 XPath 1.0 与 CSS 选择器,在大体量 HTML 的解析场景中是首选。
- BeautifulSoup4 (bs4):封装了多种底层解析器(支持 html.parser、lxml、html5lib)。语法直观且具有出色的容错能力,但在超大规模节点树循环提取时速度慢于原生 lxml。
- Parsel:Scrapy 内部使用的数据提取库,支持同时在一个选择链中使用 CSS 与 XPath,且原生支持正则提取方法
.re()。
from lxml import etree

html_content = """
<div class="goods-list">
    <div class="item" data-id="101"><span class="title">Python教程</span><span class="price">¥59.00</span></div>
    <div class="item" data-id="102"><span class="title">爬虫进阶</span><span class="price">¥79.00</span></div>
</div>
"""

tree = etree.HTML(html_content)
items = tree.xpath('//div[@class="item"]')
for item in items:
    title = item.xpath('./span[@class="title"]/text()')[0]
    price = item.xpath('./span[@class="price"]/text()')[0]
    print(f"商品: {title} | 价格: {price}")
三、动态渲染与无头浏览器库:应对复杂交互与前端渲染
越来越多的现代网站采用单页应用(SPA)或大量异步 Ajax 接口,部分接口还伴随复杂的前端参数加密与混淆。直接发 HTTP 请求难以获取有效内容时,必须引入浏览器自动化库。
核心对比:Selenium 与 Playwright 的机制差异
在自动化爬虫场景中,Selenium 与 Playwright 是最为常见的两种方案。它们在一致的自动化抓取目标下,底层驱动原理与等待机制存在本质差异:
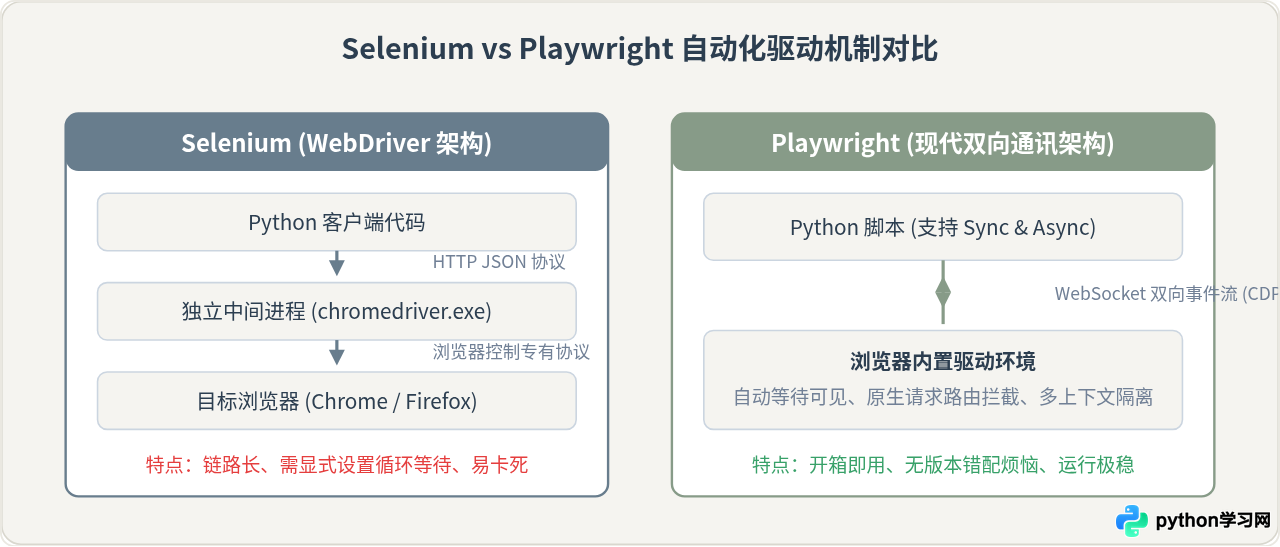
这个差异之所以至关重要:在持续运行的自动化爬虫中,Selenium 因中间驱动进程和频繁的 HTTP 轮询等待,往往在网络波动时出现 TimeoutException 或僵尸进程;而 Playwright 通过 WebSocket 单连接保持双向事件侦听,并且在执行点击、输入或定位时自带“元素可见、可操作”的自动等待特性,大幅减少了由于异步加载延迟引发的代码崩溃。
from playwright.sync_api import sync_playwright

with sync_playwright() as p:
    # 启动无头 Chromium 浏览器
    browser = p.chromium.launch(headless=True)
    # 创建独立浏览器上下文,实现隔离 Cookie
    context = browser.new_context()
    page = context.new_page()

    # 拦截多余静态图片加载,提升自动化抓取速度
    page.route("**/*.{png,jpg,jpeg,svg}", lambda route: route.abort())

    page.goto("https://news.ycombinator.com", wait_until="networkidle")
    titles = page.locator(".titleline > a").all_inner_texts()
    print("前 5 条标题:", titles[:5])

    browser.close()
四、自动化工程与调度流程:实现任务容错与稳定运转
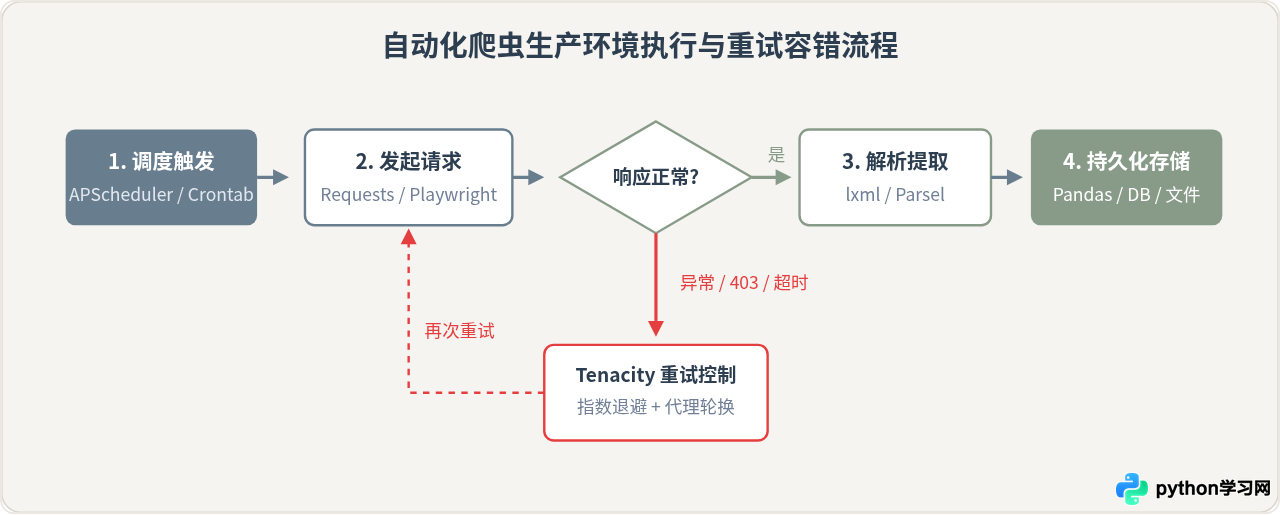
自动化爬虫与一次性采集脚本的本质区别,在于其必须具备异常自动恢复、按周期触发以及可靠的数据清洗管道。
1. Tenacity:轻量且强大的错误重试
网络请求必然会遇到偶发抖动。手动编写 while 循环容易导致逻辑臃肿,而 tenacity 装饰器能提供声明式的退避策略:
from tenacity import retry, stop_after_attempt, wait_exponential, retry_if_exception_type
import requests

@retry(
    stop=stop_after_attempt(3), # 最大重试3次
    wait=wait_exponential(multiplier=1, min=2, max=10), # 指数退避间隔
    retry=retry_if_exception_type(requests.RequestException)
)
def auto_fetch(url):
    response = requests.get(url, timeout=5)
    response.raise_for_status()
    return response.text
2. Scrapy:工业级全栈自动化框架
如果业务不仅需要单页采集,而是要求构建具备爬取队列、多线程下行调度、中间件过滤、增量去重、以及自动化导出至数据库的工程体系,Scrapy 是最成熟的选择。它基于 Twisted 异步事件驱动引擎,内置了完整的 Pipeline 与 Request 调度队列。
3. APScheduler 与 Celery:自动化触发与分布式调度
单机定时任务推荐使用 APScheduler,它支持基于 Cron 表达式或固定时间间隔的作业编排;面对跨机器的大规模爬取,则需配合 Celery 与 Redis/RabbitMQ,将采集任务拆分为多个子任务分发至爬虫节点并行执行。
五、全景选型总结
在面对不同类型的网站和自动化需求时,切忌盲目追求“大而全”。下表总结了各层级推荐的第三方库组合:
| 任务场景 | 推荐核心库搭配 | 核心优势 |
|---|---|---|
| 静态内容或常规公开 API | Requests + lxml + Tenacity | 资源占用低,开发速度快,解析效率高 |
| 大规模高并发采集 | HTTPX (Async) + Selectolax / lxml | 充分利用单机异步 I/O 吞吐能力,节省硬件成本 |
| 复杂 SPA、动态渲染与用户交互 | Playwright + Pandas | 无需配置中间驱动,内置智能等待,支持请求拦截与网络监控 |
| 企业级全站点自动化巡检与监控 | Scrapy + APScheduler + SQLAlchemy | 内置生命周期管理、管道清洗入库,架构健壮易维护 |
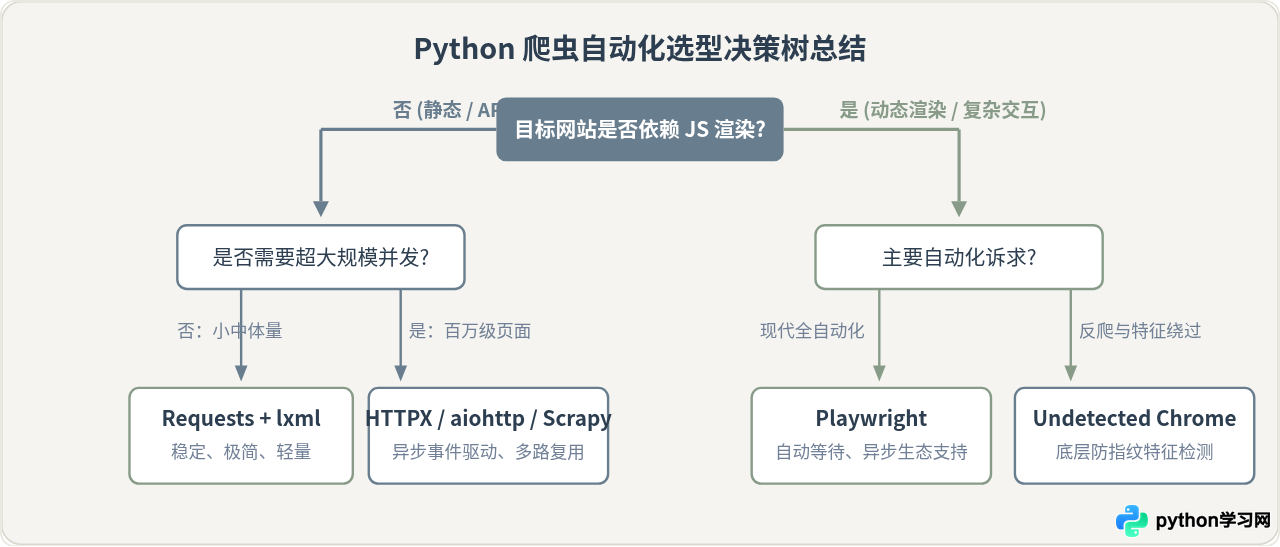
掌握以上第三方库的组合方式与运行机理后,开发者即可根据采集规模和反爬难度灵活组装,构建出兼顾开发效率与生产稳定性的 Python 爬虫自动化系统。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









