

零基础学Python爬虫难吗?真实门槛与时间成本评估
针对零基础学习者的客观分析,详细拆解学习Python爬虫的技术门槛、阶段性时间成本与常见难点,帮助你理性制定学习规划。
零基础学Python爬虫的真实难度呈现显著的“前缓后陡”特征:如果目标是抓取没有复杂防护的静态页面,门槛很低,通常投入2周至1个月即可独立完成;但如果要应对动态渲染、账号登录以及各类反爬机制,则需要扎实的计算机网络与前端交互知识,学习曲线会大幅上升。
一、认识Python爬虫的核心流程与工作模型
网络爬虫本质上是一套自动模拟人类浏览网页并提取信息的程序。理解爬虫的运行机制,有助于拆解其学习门槛。通常情况下,一次完整的爬取任务包含四个标准化步骤:发起网络请求、接收服务器响应、解析并提取数据、将数据持久化保存。
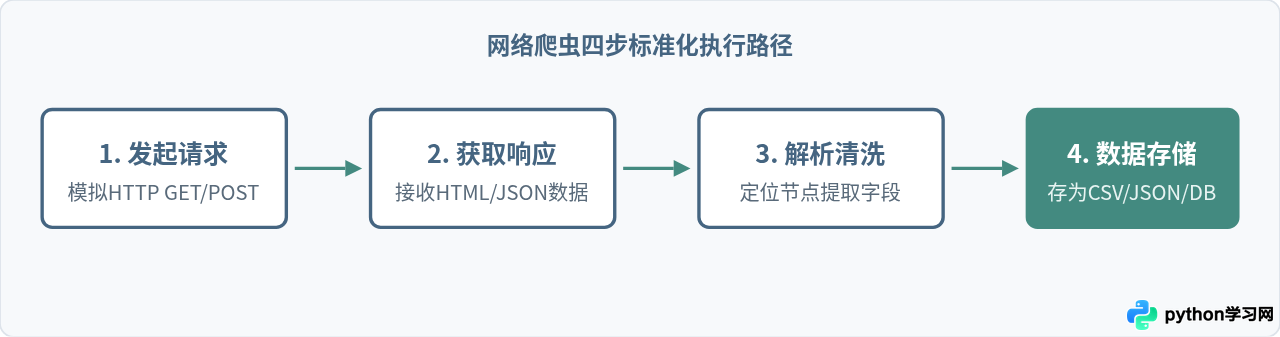
在这个流程中,初学者通常在第一步与第三步遇到具体问题。第一步需要了解目标网站接收哪些参数;第三步需要准确在HTML源码或结构化JSON中提取目标文本,这就构成了爬虫基础学习的核心内容。
二、零基础学习者的真实技术门槛分析
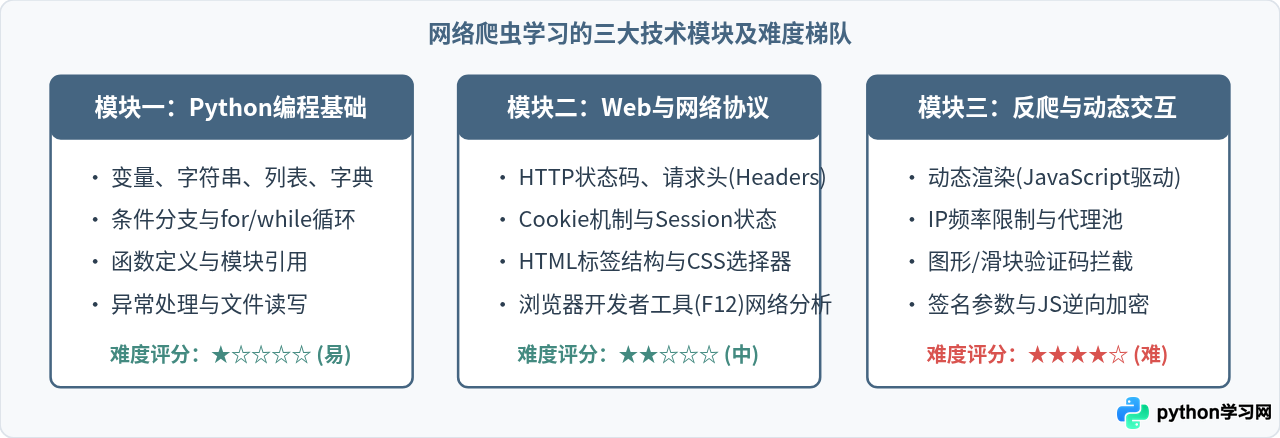
许多零基础学习者误以为学爬虫就是单纯学习Python语法。事实上,爬虫是一项跨学科的基础技能,它的门槛由三个维度的知识组成:Python基础语法、Web基础与HTTP协议,以及反爬对抗与工程维护。
1. Python语法要求(门槛低)
学习爬虫不需要精通Python的高级特性,如元编程、装饰器深层原理或多重继承。你只需要掌握基本数据类型(特别是字典和列表)、流程控制语句、函数的封装以及基本的文件I/O操作即可。这一部分的学习通常在一周内就可以完成。
2. Web基础与工具使用(关键分水岭)
编写爬虫最关键的一步是“看懂目标网页”。学会使用浏览器自带的“开发者工具”(按F12)定位元素、查看Network网络面板中的请求与响应,比写代码本身更为重要。如果无法准确定位数据来源于哪个接口,后续代码就无从谈起。
3. 反爬虫机制对抗(真正的难点)
现代商业网站几乎都配备了反爬机制。从最基础的User-Agent校验,到IP请求频率限制、验证码拦截,再到复杂的前端JS代码混淆和动态加密签名。这一阶段是让许多学习者感到困难的主要原因,需要大量逆向分析和经验积累。
三、学习阶段与真实时间成本评估
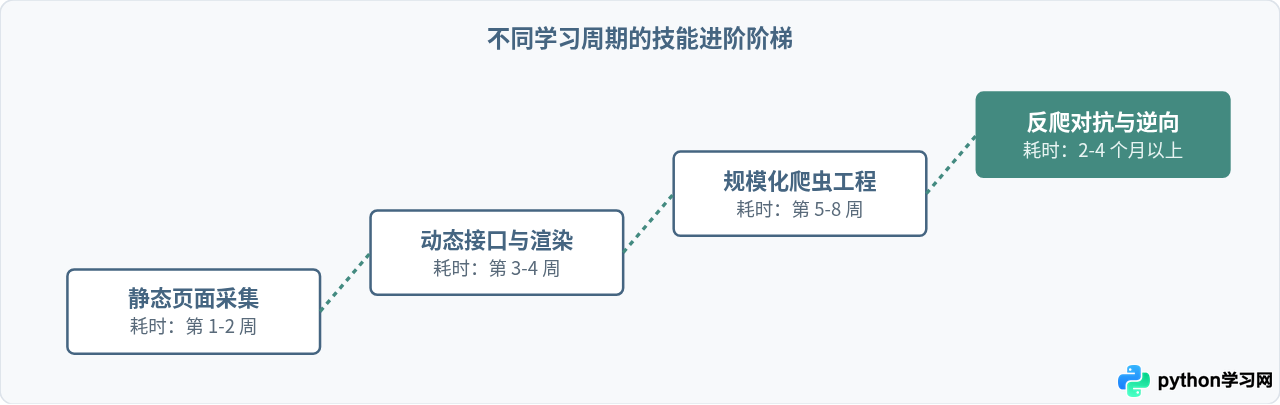
评估学习时间成本必须结合具体的学习目标。按照每天投入1.5至2小时的有效学习时间计算,可以将学习过程划分为四个阶段:
| 学习阶段 | 累计耗时 | 核心学习内容 | 阶段可达成目标 |
|---|---|---|---|
| 阶段一:基础语法与简单抓取 | 1 - 2 周 | Python基础语法、requests库、BeautifulSoup库 | 能够爬取无防备静态网页的文本与图片,保存到本地文件 |
| 阶段二:动态页面与自动化渲染 | 3 - 4 周 | 开发者工具抓包、JSON解析、Playwright/Selenium | 抓取前后端分离网页的数据接口,或使用自动化工具获取动态内容 |
| 阶段三:工程化与并发爬取 | 5 - 8 周 | Scrapy框架、异步编程(aiohttp)、IP代理池、MySQL/MongoDB | 构建自动化爬取管道,支持十万级以上数据的并发采集与持久化 |
| 阶段四:进阶反爬与JS逆向 | 2 - 4 个月+ | 浏览器运行机制、AST混淆还原、常见对称/非对称加密逆向 | 攻克主流商业平台带加密签名的接口,具备对抗反爬的综合能力 |
四、快速验证:一个基础爬虫的代码实现与要点
通过一个具体的简单实例,可以直观体会初级爬虫的代码量和复杂度。下面的示例演示了如何通过 requests 库获取网页并使用 BeautifulSoup 提取标题。
# 环境依赖:pip install requests beautifulsoup4
import requests
from bs4 import BeautifulSoup

# 1. 目标地址与请求头设置
url = "https://example.com"
headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36"
}

# 2. 发起请求并验证状态码
response = requests.get(url, headers=headers, timeout=10)

if response.status_code == 200:
    # 3. 解析HTML文本
    soup = BeautifulSoup(response.text, "html.parser")
    title_tag = soup.find("h1")

    # 4. 获取并清洗结果
    if title_tag:
        print(f"抓取结果:{title_tag.get_text().strip()}")
    else:
        print("未找到指定标签")
else:
    print(f"请求失败,状态码:{response.status_code}")
初学者容易忽略 headers 中的 User-Agent 设置。许多服务器在没有收到标准浏览器标识时,会直接拒绝连接或返回403状态码。养成在每次请求时显式配置请求头的习惯,可以避免绝大多数基础报错。
五、给零基础学习者的三条避坑建议
为了在有效时间内掌握实用技能,建议在学习路径上注意以下三个核心原则:
- 不要盲目死磕高难度目标:初学阶段切忌直接尝试抓取主流电商平台或大型社交媒体。这类网站有极其严密的反爬团队和风控体系,容易挫伤学习积极性。先从政务公开数据、学术静态文献库或个人博客开始练习。
- 重视抓包分析多于代码编写:在写Python代码前,先在浏览器的Network面板中理清目标数据的真实来源。如果数据来源于一个返回JSON的后台接口,直接请求该接口即可,无需耗费大量精力去解析复杂的HTML。
- 恪守合规边界:学习爬虫必须了解法律与道德边界。遵守目标网站的
robots.txt协议,严格控制并发请求频率,不得对个人隐私数据和非公开商业资产进行未经授权的抓取。
六、综合总结与评估结论
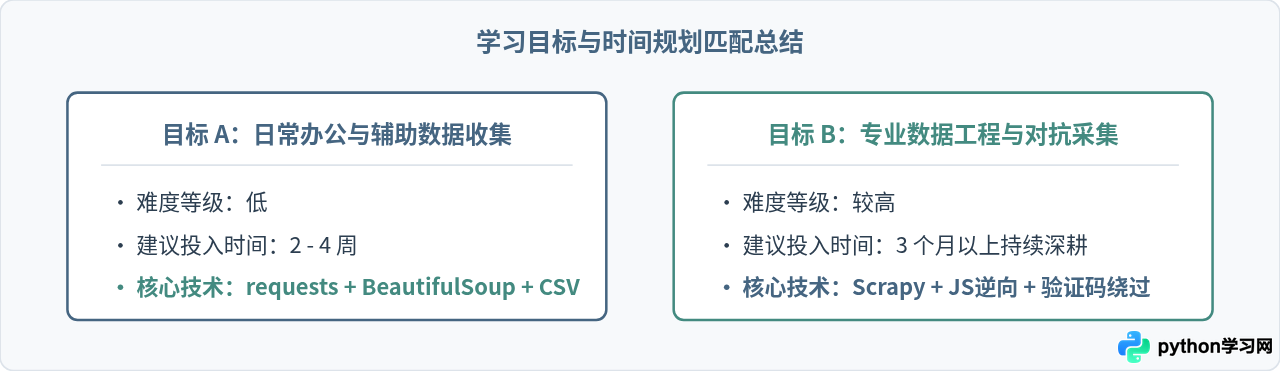
总体而言,学Python爬虫并不难入门。作为普通数据采集工具使用,投入1个月左右即可满足日常办公中的自动化需求。若希望走向专业爬虫开发,则需要将爬虫作为切入点,持续补充网络协议、逆向工程与分布式架构知识。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









