

Python数据结构与算法专项训练题库推荐
针对Python语言特性的数据结构与算法专项训练题库推荐,涵盖LeetCode、Codewars、HackerRank与牛客网等平台的特点解析、多维对比、五步阶梯刷题路线及实战避坑指南。
一、为什么 Python 算法专项训练需要针对性选题
Python 语法高级、灵活且自带大量开箱即用的功能,这种特性在带来极高开发效率的同时,也容易掩盖很多底层数据结构的细节。例如,许多初学者习惯频繁使用 x in list 或 list.pop(0),却未意识到它们是 O(N) 线性耗时操作;而一旦遇到大规模数据输入,程序便会频繁遭遇“运行超时(Time Limit Exceeded)”。
围绕 Python 刷题存在一个常见疑问:“Python 运行效率不如 C++ 和 Java,用它训练算法是否合适?”事实上,现代技术面试与算法能力考核的核心是计算模型、抽象思维与时空复杂度分析,而非单纯比拼硬件执行周期。Python 去除了指针语法和繁冗的类型样板代码,能让学习者更专注于算法逻辑本身。然而,这要求所选的题库必须支持较长且合理的运行超时阈值、提供规范的 Python 运行环境,并拥有高质量的社区题解供学习者比对思路。
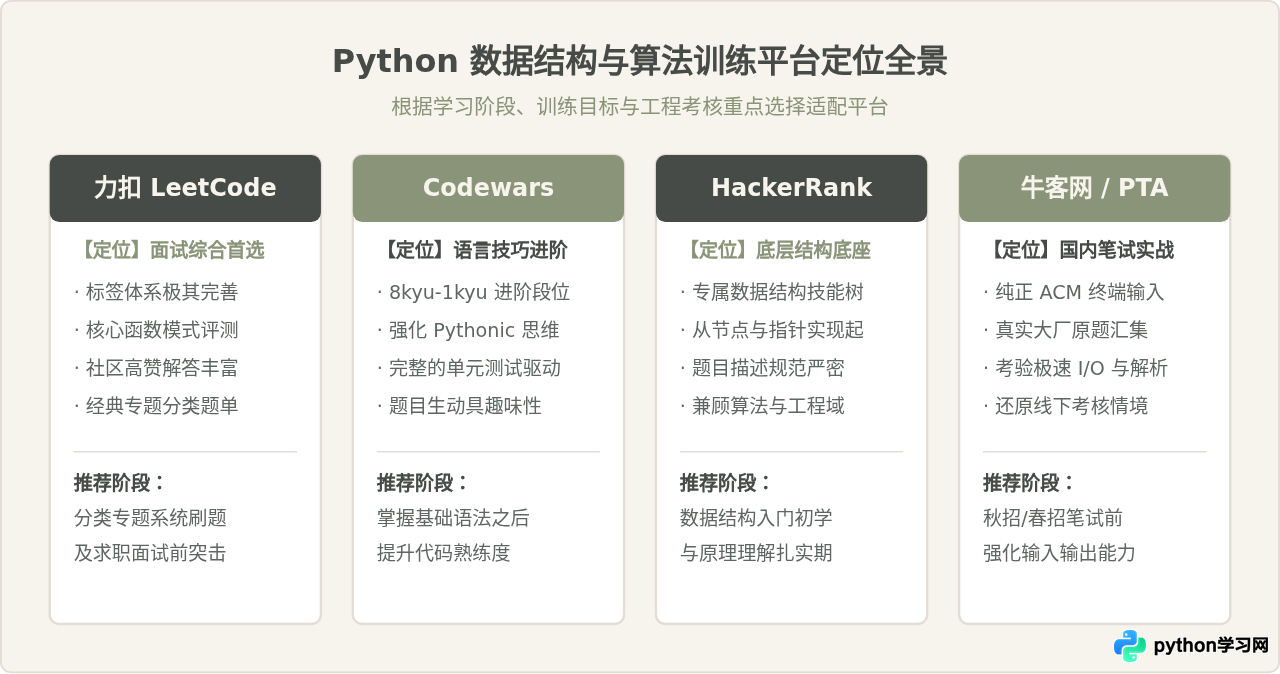
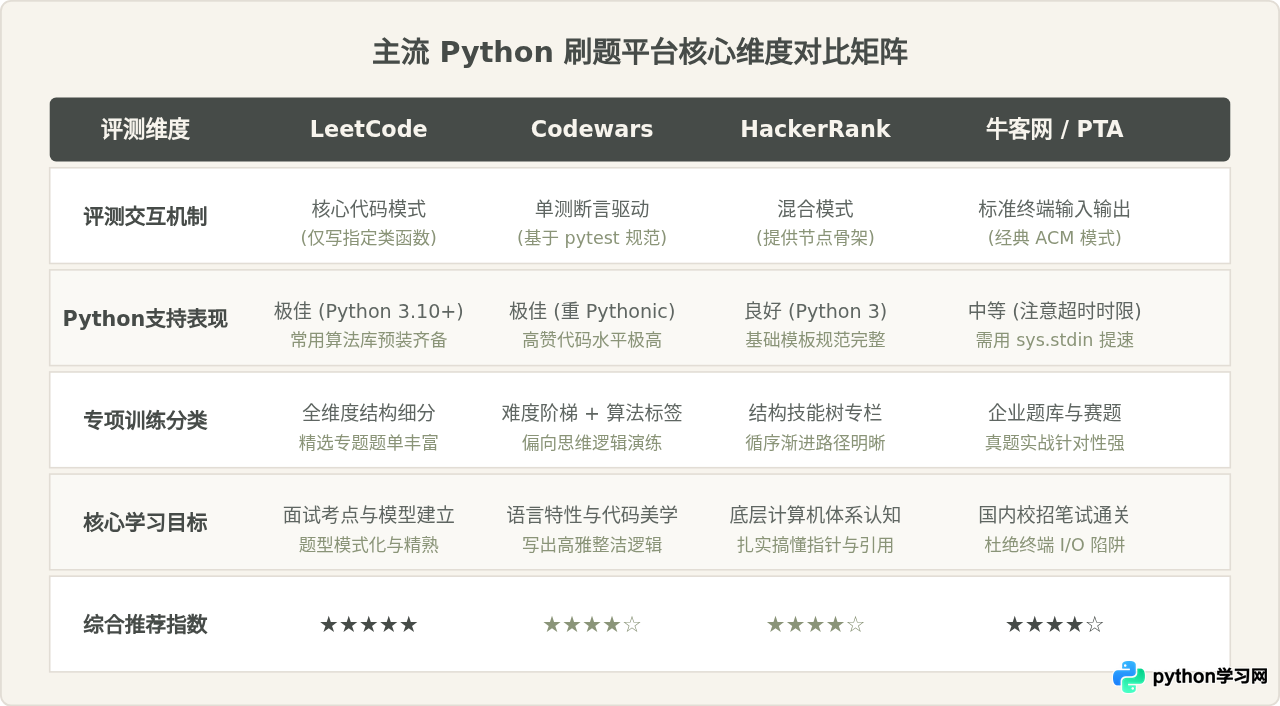
二、主流 Python 算法题库特性详解与推荐度
1. 力扣(LeetCode / LeetCode 中国)
力扣是目前全球应用最广、题解讨论最活跃的算法训练社区。对于 Python 专项训练而言,力扣的核心优势体现在以下三方面:
- 精准的标签体系:支持按“数组、哈希表、链表、二叉树、图、双指针、回溯、动态规划”等结构专项筛选,便于实施分块各个击破。
- 核心代码模式降低干扰:读者无需手写标准输入输出解析代码,只需实现给定的类方法,专注于函数内部的数据结构流转。
- 高质量的 Python3 优质题解:讨论区有大量结合
collections.Counter、heapq、bisect等标准库模块的优秀 Pythonic 示范,能大幅开阔解题视野。
2. Codewars
Codewars 采用独特的“Kata 段位制”(从初学者 8 kyu 到大师级 1 kyu)。与力扣偏向面试题不同,Codewars 的题目带有更强的工程演练色彩。
每个题目均自带一套清晰的单元测试用例,并在提交后展示同段位全球开发者提交的高赞解答。在这里刷题,你会发现很多人用一行生成器推导式、functools.reduce 或优雅的递归解决复杂结构转换。对于想要摆脱“用 C 语言思维写 Python 代码”的学习者,这是一个绝佳的演练场。
3. HackerRank
HackerRank 拥有专门设立的 Data Structures 专项模块。它从最基础的动态数组(Dynamic Arrays)、单链表反转、双向链表插入,一直到树的遍历与堆的维护,循序渐进地引导学习者从零构建数据结构。
它的练习形式往往是提供包含 Node 类的模板骨架,由学习者填补关键操作逻辑。这种由底层指针逻辑推导数据结构的训练方式,弥补了直接调用 Python 内置容器时对内存与节点关系理解不深的短板。
4. 牛客网(Nowcoder)与 PTA(拼题 A)
国内互联网公司与高校机试中,经常采用 ACM 模式(即要求通过 sys.stdin 读取字符串,自行解析行列后向控制台 print 输出结果)。
在力扣刷题习惯了核心代码模式的同学,初次参加笔试时往往会在处理“未指定数量的多行输入”或“大矩阵输入”时浪费半小时甚至直接爆零。牛客网收录了各大厂历年真题,是检验 Python 输入解析能力与避免输出超时(如改用 sys.stdout.write)的关键实战场地。
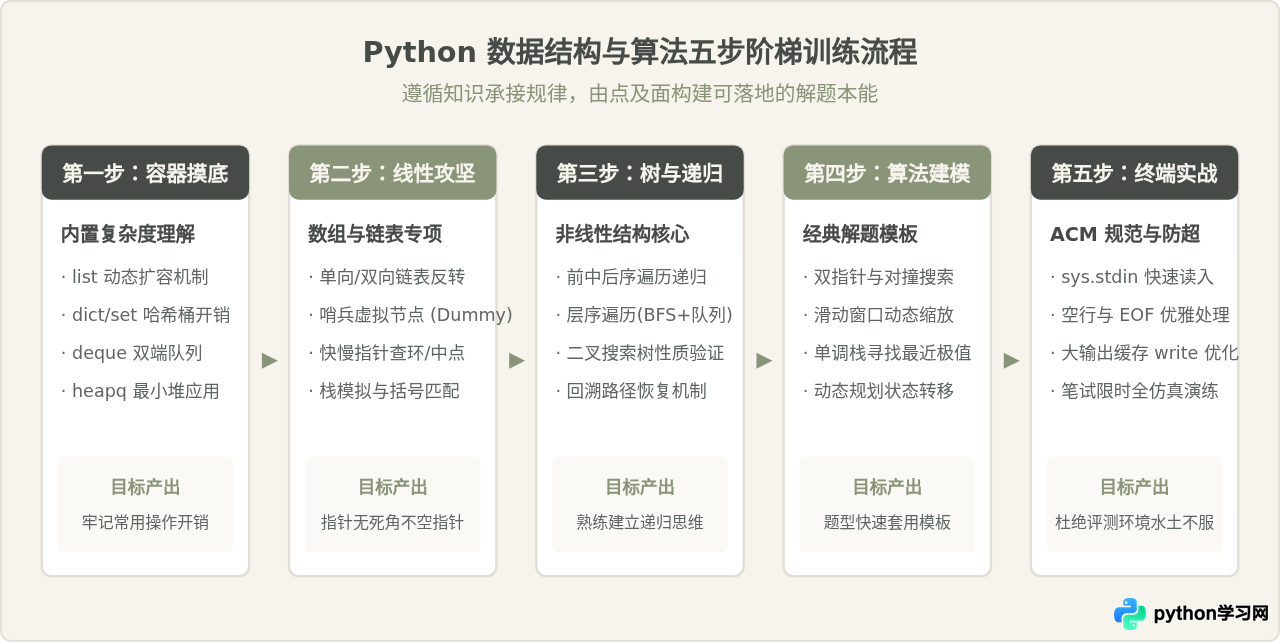
三、Python 专项训练的五步阶梯实操方法
刷算法题切忌在未理清结构特性的情况下随机打卡。合理的方法是按照“基础容器探究 → 线性结构突破 → 非线性与分治 → 算法模型建立 → 终端实战加固”五步展开。
关键实操代码:Python 典型解题模板与输入优化
在进入题库练习时,牢记标准库的正确打开方式,能帮助读者避开绝大多数性能陷阱。以下是实际刷题中两个最高频的核心模板:
错误做法是用 queue = [] 并使用 queue.pop(0) 出队,这会导致单次出队耗时 O(N),整段遍历退化为 O(N^2)。正确做法是使用内置的双端队列 collections.deque:
from collections import deque

def bfs_traverse(graph, start_node):
    visited = set([start_node])
    queue = deque([start_node])  # 初始化双端队列
    traversal_order = []

    while queue:
        curr = queue.popleft()   # O(1) 头部出队,绝对不能用 list.pop(0)
        traversal_order.append(curr)

        for neighbor in graph.get(curr, []):
            if neighbor not in visited:  # set 的查询时间为 O(1)
                visited.add(neighbor)
                queue.append(neighbor)   # O(1) 尾部入队

    return traversal_order
在牛客网或现场笔试中,当题目给出的测试数据达到 10^5 甚至 10^6 行时,原生 input() 因包含控制台换行符解析和 prompt 处理,极易引发 TLE。推荐使用标准输入流加速:
import sys

def solve():
    # 使用 sys.stdin.read 一次性读取全部内容,按空白符切分
    input_data = sys.stdin.read().split()
    if not input_data:
        return

    iterator = iter(input_data)

    # 示例:第一行表示数据组数 T
    t_cases = int(next(iterator))
    results = []

    for _ in range(t_cases):
        n = int(next(iterator))
        # 批量获取接下来的 n 个整数
        arr = [int(next(iterator)) for _ in range(n)]

        # 核心算法处理(示例为计算前缀最大值)
        results.append(str(max(arr)))

    # 批量输出,减少调用 print 的 I/O 开销
    sys.stdout.write("\n".join(results) + "\n")

if __name__ == '__main__':
    solve()
四、专项训练常见误区与避坑指南
在辅导与交流中,很多学习者花费了大量时间刷题,但成效并不显著。深入分析其做题过程,往往存在以下几类典型偏差:
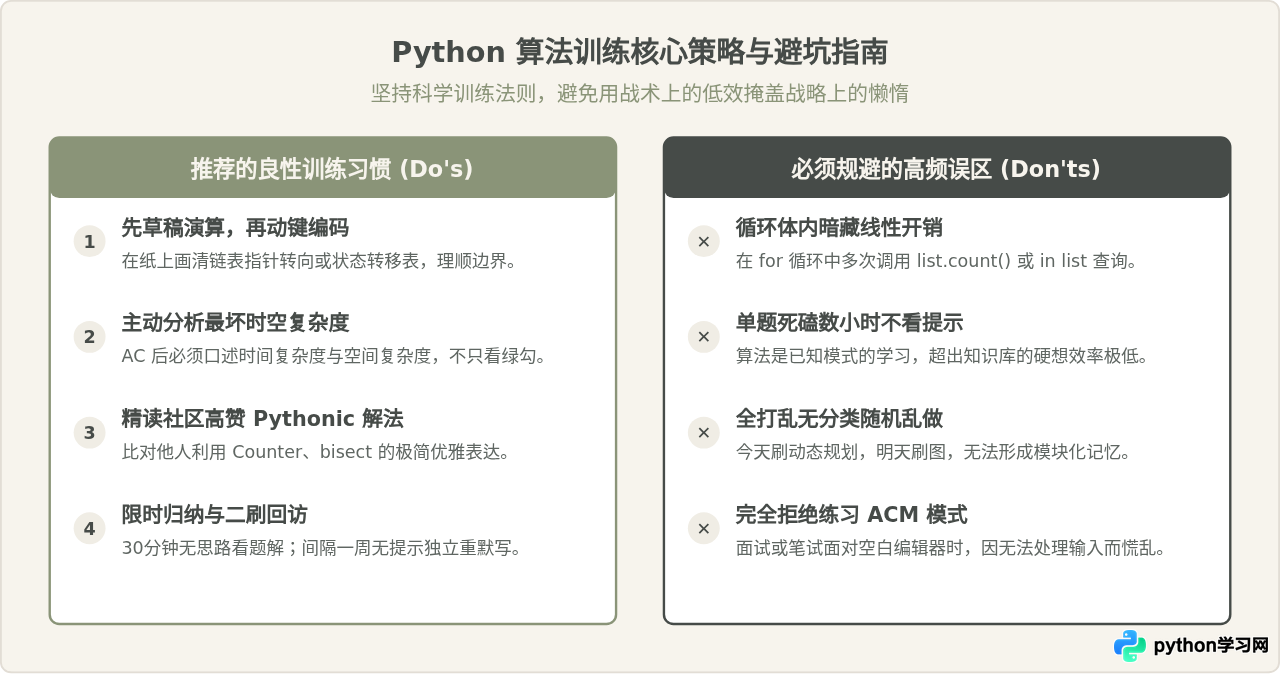
四条核心避坑细则
- 辨析“能运行通过”与“时间复杂度合格”的差异: 很多 Python 初学者在做 LeetCode 简单题时,由于测试用例规模较小,即使写了 O(N^2) 的暴力解法也能勉强通过。但一旦遇到中等题(Medium),测试集放大到 N=10^5 时,暴力方案立刻超时。做完每道题后,务必养成在草稿纸上推导最坏时间复杂度并在脑中验证是否为 O(N) 或 O(N log N) 的习惯。
- 不要将死磕当作毅力: 算法本质上是前人提炼出的数学与计算思维结晶。若一道题在认真审题、推演 30 到 45 分钟后仍毫无思路,说明其背后依赖的算法原型(如拓扑排序、单调队列、并查集)尚未进入你的知识体系。此时最有效的做法是直接翻阅官方题解,弄清底层原理并手写复现,隔周后再行默写。
- 坚持专题击破,拒绝随机拼盘: 大脑对知识的抽象与归纳依赖集中刺激。建议以“连续一周只刷二叉树”、“连续一周只刷滑动窗口与双指针”的节奏进行。当同一个模式在连续十道题目中反复出现时,条件反射与套路建模便会自然形成。
-
重视标准库的高阶用法:
Python 提供了极为强大的标准库,如
heapq(堆队列算法)、bisect(二分查找维护有序数组)、collections.defaultdict与Counter。深入学习这些库不仅能使代码缩短一半,更能规避手动维护底层数组指针带来的边界 Bug。
五、结语与个性化刷题路径建议
综上所述,Python 数据结构与算法能力的提升是一个“建立直觉、强化熟练度、沉淀模式”的过程。针对不同读者群体的具体诉求,推荐以下实施路径:
- 转专业与零基础起步:先在 HackerRank 的 Data Structures 专项中完成链表、树的基本操作,配合 Codewars 完成 8 kyu 到 6 kyu 的基础编程训练,打牢语法与节点交互底座。
- 面试求职与综合提升:以 力扣(LeetCode) 为主战场,紧扣“探索”板块中的结构分类专题,先刷“剑指 Offer”或精选 100 题,集中突破中等难度高频考点。
- 备战国内大厂校招笔试:在力扣基础稳固后,提前 2~3 周切入 牛客网 进行 ACM 模式模拟训练,熟练掌握
sys.stdin.read().split()的快速切分模式与标准格式化输出。
保持每天 1~2 道题目的连贯节奏,重视算法背后的数学原理与复杂度推导,远胜于一次性突击几十道却不求甚解。选对题库、科学推进,Python 算法专项训练就能真正转化为扎实长久的编程竞争力。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









