

为什么C语言比Python快?解析编译型与解释型的性能差异
深入解析C语言与Python在执行模型、类型系统、内存分配及运行时调度上的本质差异,系统阐述编译型与解释型语言的性能分水岭与选型思考。
一、执行模型的本质区别:提前编译与虚拟机解释
要理解执行速度的差距,首先需要拆解两门语言从源代码到最终硬件执行的完整链路。
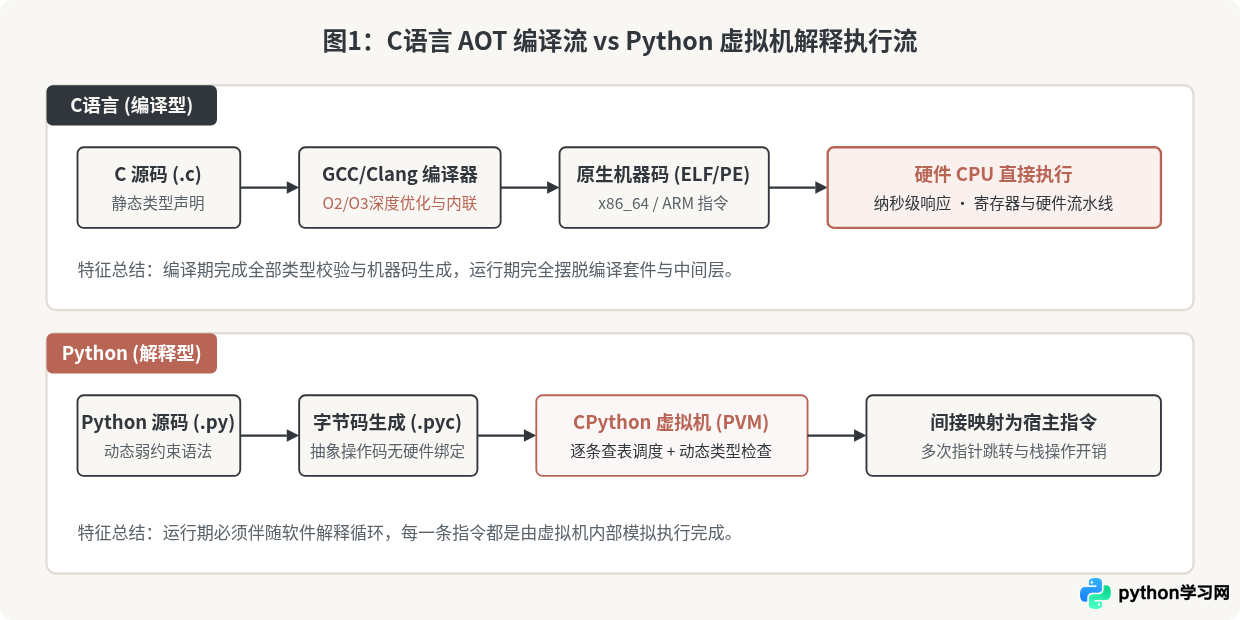
C语言采用**提前编译(Ahead-Of-Time, AOT)**模型。程序员编写的 .c 源代码,会经历预处理、编译、汇编与链接四个阶段。编译器(如GCC或Clang)会在生成机器码的过程中进行全局与局部的死代码消除、循环展开、寄存器智能分配以及向量化(SIMD)指令优化。当最终生成二进制可执行文件后,操作系统只需将其加载到内存,CPU便能直接读取机器指令,在算术逻辑单元(ALU)上以纳秒甚至亚纳秒级完成单次运算。
相比之下,Python采用**字节码解释执行**模型。当运行一个 .py 文件时,解释器首先将源码快速语法解析并编译为抽象的字节码(存放在 .pyc 中)。但这些字节码不是CPU能够直接识别的硬件指令,而是针对Python虚拟机(PVM, Python Virtual Machine)的一套虚拟栈操作指令。PVM本质上是一个用C语言编写的大型软件程序,其核心是一个庞大的循环分发器(ceval.c 中的循环)。虚拟机每次读取一条字节码,解析其操作数,并通过查表或大范围分支跳转调用对应的内部C函数完成计算。
二、静态类型与动态装箱:内存布局与寻址成本
除了执行流程的长短,变量在计算机内存中的表现形式,是导致二者性能出现鸿沟的另一个决定性因素。
在C语言中,变量是强静态类型的。例如声明一个整型变量:
int x = 42;
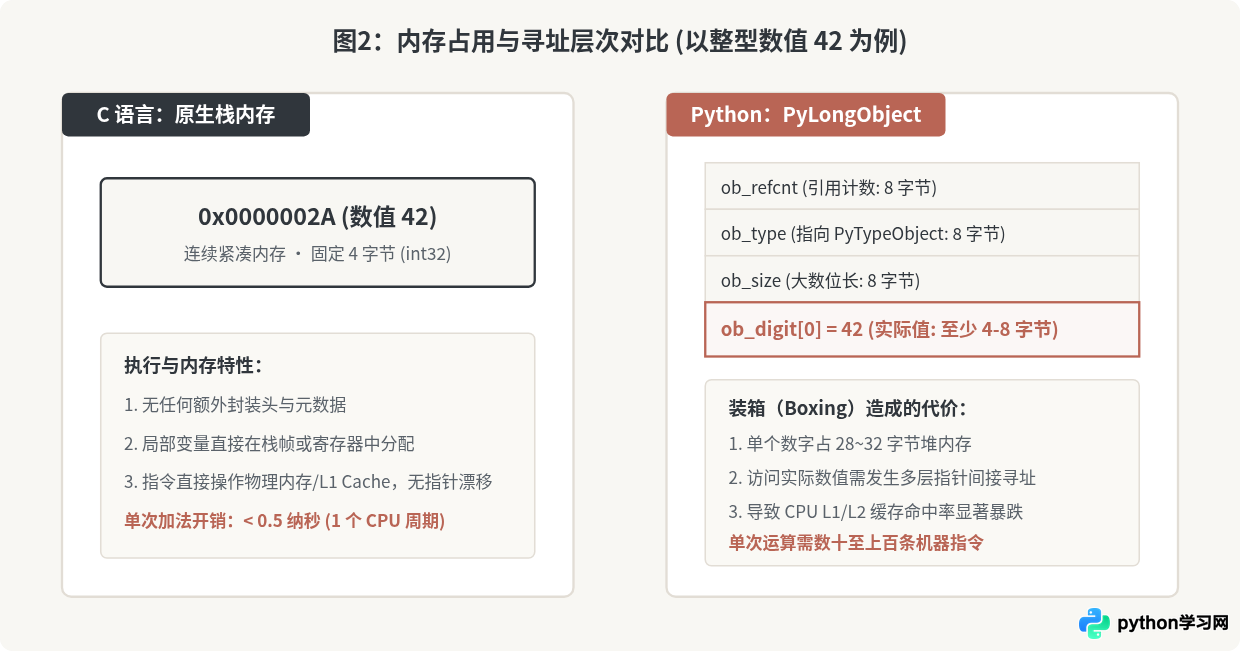
在标准的64位Linux系统上,编译器会将其严格映射为内存栈空间中一个固定的4字节(32位)区域,或者是直接存放在CPU寄存器(如 %eax)中。当执行加法操作 x + 1 时,编译器只需要发出一组简单的汇编指令:
movl  -4(%rbp), %eax
addl  $1, %eax
CPU在一个时钟周期内即可完成寄存器寻址并执行加法,几乎没有任何多余消耗。
然而在Python中,“一切皆对象”。当在Python中写下:
x = 42
变量 x 并不是一个纯粹的4字节数字,而是一个指向堆内存中 PyLongObject 结构体的指针。在标准CPython实现中,任何一个整型对象都至少包含:
- ob_refcnt(8字节):用于垃圾回收的引用计数器;
- ob_type(8字节):指向该对象类型元信息(
PyTypeObject)的指针; - ob_size(8字节):记录该大数包含的数字位元(digit)长度;
- ob_digit(至少4到8字节):实际存放数值的数组。
这意味着存储一个最基础的整数,Python就需要消耗至少28到32个字节的内存,是C语言的8倍之多。更严重的是,当在Python中执行 x + 1 时,虚拟机无法预知 x 当前到底是什么类型。它必须执行以下步骤:
- 沿着指针访问
x的内存地址; - 读取
ob_type,确认其是否为整数对象; - 解包提取
ob_digit中的真实底层数值; - 执行数值加法;
- 在堆上申请一块新的内存空间,构造一个新的
PyLongObject对象; - 填充新对象的类型、初始引用计数并将计算结果写入;
- 维护原对象的引用计数(若归零则触发释放逻辑)。
三、运行时代价:CPU流水线、分支预测与调度开销
计算机硬件并不是单独孤立地运行一行行代码,而是通过现代超标量CPU中的指令流水线、乱序执行单元和分支预测器来提升吞吐量。
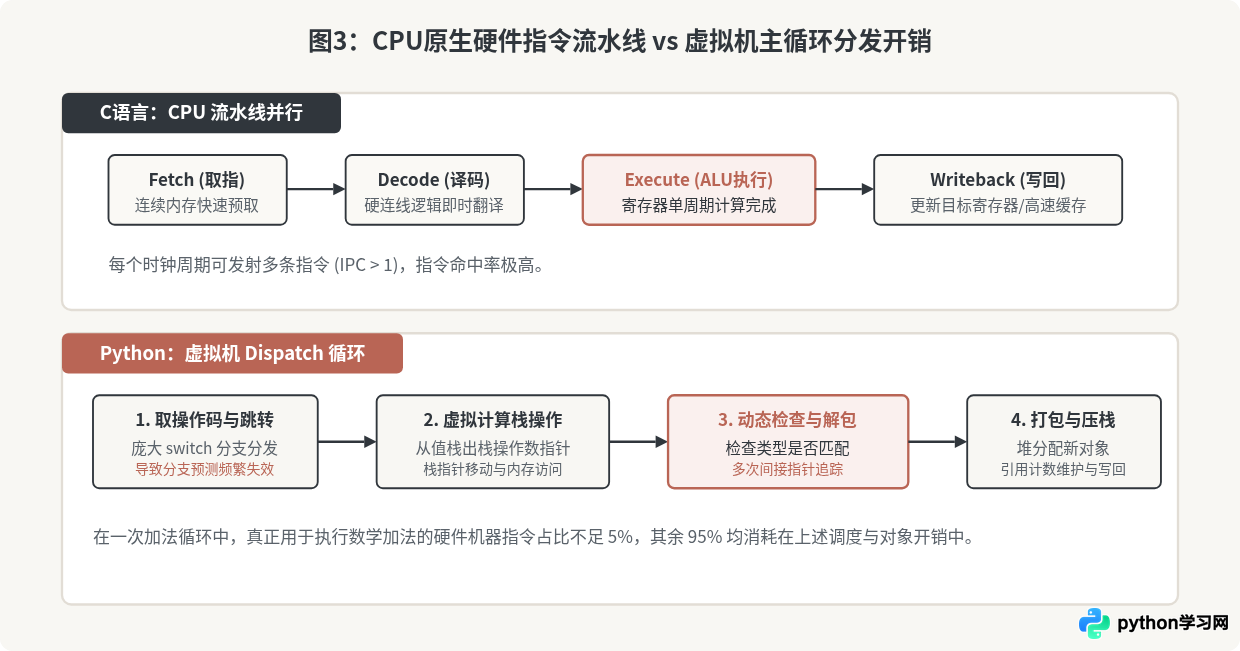
编译型语言生成的机器码高度契合现代CPU硬件架构:指令流在物理内存中通常是连续分布的,CPU的指令预取器(Instruction Prefetcher)能提前加载紧邻的指令块。在紧凑的循环计算中,分支预测命中率高达99%以上,CPU执行流水线可以保持满载运行。
然而在Python解释器的主循环中,情况完全不同:
- 指令分发开销(Dispatch Overhead):虚拟机执行一条简单的字节码,其开销中只有很小一部分是真正的算术逻辑,其余大部分时间都在做循环跳转、参数栈出栈压栈、函数调用与返回。
- 分支预测失常(Branch Misprediction):虚拟机的核心通常由庞大的
switch-case构成。因为相邻两行Python代码对应的字节码可能完全不同(如从赋值变为属性读取再变为循环判断),导致底层的间接跳转分支预测频繁落空,引起CPU流水线反复清空和重填(Pipeline Stall)。 - 全局解释器锁(GIL)与垃圾回收:在多线程环境下,标准CPython的GIL要求线程在执行字节码前获取锁,无法原生利用多核流水线;同时引用计数的增减与分代GC扫描也在随时争抢CPU周期。
四、代码实测对照:简单循环累加的性能反差
为了让这种抽象的架构差异变得具象,我们可以通过一段最基本的纯CPU密集型任务——一亿次整数累加来进行直观对比。
1. C语言版本实现
#include <stdio.h>
#include <time.h>

int main() {
    clock_t start = clock();
    long long sum = 0;
    for (long long i = 0; i < 100000000; i++) {
        sum += i;
    }
    clock_t end = clock();
    printf("Sum: %lld, Time: %.4f seconds\n", sum, (double)(end - start) / CLOCKS_PER_SEC);
    return 0;
}
在启用基本优化(gcc -O2 sum.c -o sum)后执行,该程序通常仅需约 0.0001 秒(如果编译器直接利用高斯公式或展开优化)至 0.05 秒(在完全无优化 -O0 时逐指令累加)。
2. Python原生版本实现
import time

start = time.time()
total = 0
for i in range(100_000_000):
    total += i
end = time.time()

print(f"Sum: {total}, Time: {end - start:.4f} seconds")
在标准CPython解释器下运行该代码,由于每一次 for 迭代都需要进行迭代器协议调用(tp_iternext)、生成新的整型对象并修改 total 的引用计数,执行时间通常长达 4.5 到 6.5 秒。
在纯CPU密集计算与无内建库加速的前提下,两者的执行耗时差距超过了 100 倍。
在数据科学与深度学习中,Python运行
numpy.dot() 或使用 PyTorch 训练模型时表现极其强悍。这是因为 NumPy 与 PyTorch 的底层计算内核全部是由 C、C++ 或 Fortran 编写的,数据存储在紧凑连续的C数组中(跳过了 PyObject 装箱),运算直接交由 OpenBLAS、MKL 等高度优化的原生底层库或 GPU 矩阵单元执行。在此类场景中,Python 仅充当了调度器和胶水语言,因此几乎感觉不到性能损耗。
五、工程实践中的选型平衡与性能弥合策略
了解两者的性能差异后,并不意味着在工程开发中应该一味追求C语言的高性能。软件工程的核心权衡在于:机器执行时间 vs 人力开发迭代时间。
C语言带来极致性能的同时,付出了极高的开发心智成本:手动内存分配释放(malloc/free)、缓冲区溢出风险、指针野指针悬挂、跨平台编译依赖复杂,且代码行数通常是同功能Python代码的数倍。
在实际生产环境中,现代软件架构通常采用组合策略来规避性能短板:
- 胶水架构:使用 Python 快速编写业务逻辑、API接口与工作流调度,将80%的通用逻辑在数天内交付。
- 局部下沉:通过性能剖析工具(如
cProfile)精确定位消耗超过80% CPU时间的极少数热点模块(Hotspots),将其重构为 C 扩展、Cython 或 Rust 模块。 - 即时编译(JIT):针对原生Python计算场景,引入 PyPy 或 Numba,在运行期动态推导类型并实时编译为机器码,通常可获得数倍至数十倍的性能提速。
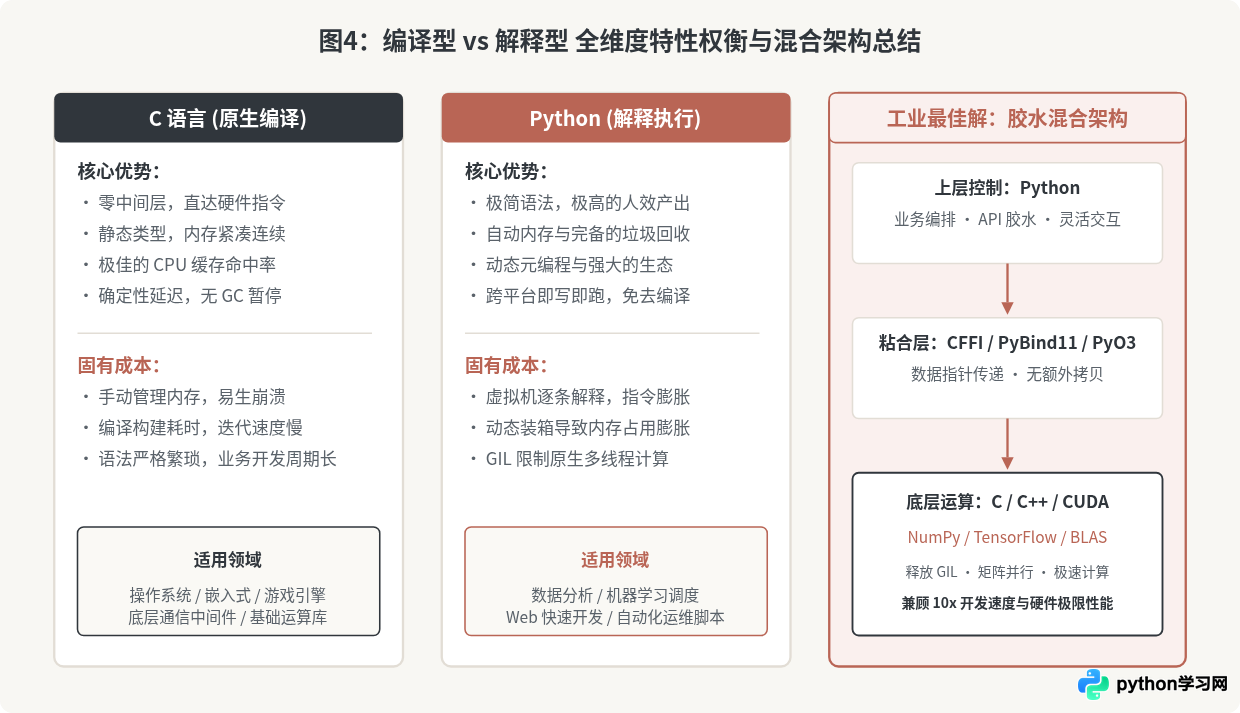
六、关键维度对比速查
为了便于在架构设计与技术评审时快速对照,下表总结了C语言与Python在性能与运行机制上的核心区别:
| 对比维度 | C 语言 (编译型) | Python (解释型 / CPython) | 性能影响结果 |
|---|---|---|---|
| 代码翻译时机 | 编译期一次性生成原生机器码 (AOT) | 运行期虚拟机逐条解释字节码 | C语言无运行期解释开销,指令吞吐高数十倍 |
| 类型确定时机 | 编译期静态确定,偏移量直接固化 | 运行期动态推导,随时可能变更 | Python每次操作均需做动态类型匹配检查 |
| 内存存储结构 | 紧凑原始字节(例如 int 为 4 字节) | 通用对象模型(PyLongObject 需 28+ 字节) | Python内存膨胀数倍,严重降低CPU高速缓存命中率 |
| 寻址与访问方式 | 寄存器直接寻址或栈基址固定偏移 | 多级指针解引用与堆对象间接追踪 | C语言通常单周期完成,Python需要几十个周期 |
| 硬件流水线适配 | 连续指令分布,分支预测极易命中 | 解释器循环分支繁杂,流水线易频繁打断 | C语言充分享受超标量CPU乱序并行计算收益 |
| 多核心扩展能力 | 原生支持操作系统线程,直接并发 | 受制于全局解释器锁 (GIL) | Python多线程无法原生加速CPU密集计算 |
综上所述,C语言比Python快并不是偶然的技术细节,而是**编译期确定性**与**运行期动态灵活性**之间的根本抉择。在不需要极端榨干硬件性能的场景下,Python以其极高的研发人效、丰厚的生态成为首选;而在性能瓶颈、延迟敏感与底层设施构建中,直接面向硬件的编译型语言依然具备不可替代的基石地位。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









