

Python能做什么?适合新手的3个实战小项目推荐
深入解析Python在自动化办公、数据提取与轻量分析中的实用价值,并精选3个仅用几十行代码即可落地的新手实战小项目,提供完整源码、逻辑拆解与避坑建议。
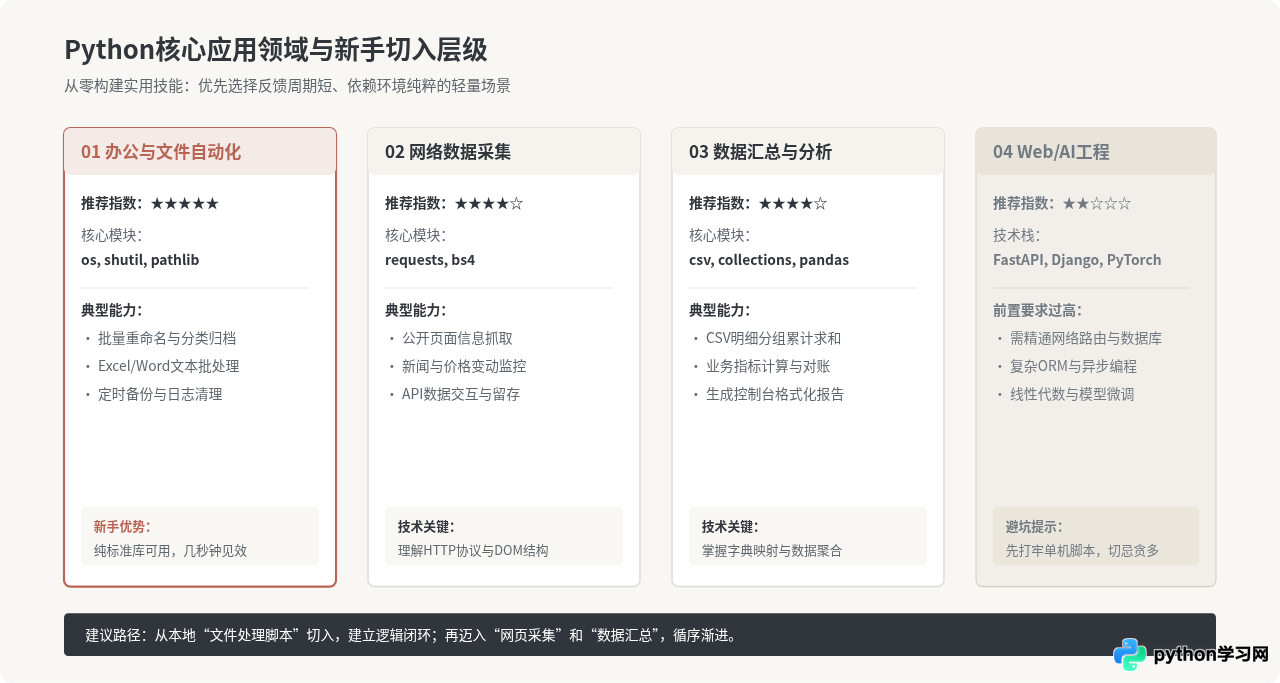
图1:Python应用领域分类与新手学习梯度对比图
一、Python能做什么?看清它的应用边界
Python是一门解释型、动态类型的高级编程语言。由于其语法极其贴近自然语言逻辑,并拥有庞大且成熟的开源模块库,它在工业界和日常办公中承担着非常多样的角色:
- 自动化批处理与效率工具:操作操作系统文件、批量转换图片尺寸、自动读写Word/Excel表格、定时发送邮件汇报。
- 数据提取与爬虫工程:从指定网站抓取公开商品标价、行业资讯、气象数据,自动清洗并存入本地或数据库。
- 数据分析与统计可视化:对海量交易流水、运营日志进行去重、分组统计、相关性计算,并生成可视化走势图表。
- 后端API与网络服务:使用轻量框架(如FastAPI、Flask)快速搭建企业内部管理接口或个人工具网站。
- 人工智能与科学计算:在学术科研、深度学习模型训练和自然语言处理管道中扮演标准交互胶水语言。
但对于初学者而言,一上来就啃Web全栈或深度学习往往会带来强烈的挫败感。最理想的起点是“解决身边具体的繁琐小事”。下面推荐的3个实战小项目,完全契合新手认知规律,仅需单文件即可运行并看到即时效果。
二、项目一:本地杂乱文件批量分类与归档脚本
在日常使用电脑时,下载文件夹(Downloads)或桌面经常堆满数以百计的文件:各类截图、PDF合同、安装包和压缩文件混合在一起,人工整理极其浪费时间。编写一个专门的文件规整脚本是理解Python文件系统I/O的最佳练兵场。
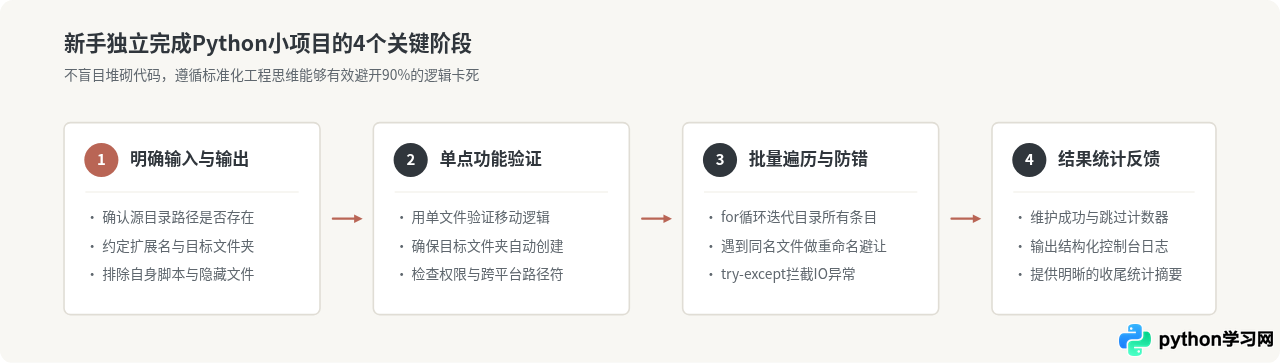
图2:从零实现小脚本的4步落地与防御性编码流程
1. 实现思路与依赖
该项目使用Python内置的 pathlib 库。相比古老的 os.path,面向对象的 pathlib.Path 能够跨平台自动处理 Windows(反斜杠)与 macOS/Linux(正斜杠)的路径差异,且无需通过 pip 安装任何第三方模块。
2. 完整实战代码
from pathlib import Path
import shutil

def organize_folder(target_dir_path: str):
    target_dir = Path(target_dir_path).expanduser().resolve()
    if not target_dir.exists() or not target_dir.is_dir():
        print(f"错误:指定路径不存在或不是文件夹:{target_dir}")
        return

    # 定义后缀名与归类目录的映射关系
    rules = {
        "Images": [".jpg", ".jpeg", ".png", ".gif", ".webp", ".svg"],
        "Documents": [".pdf", ".docx", ".doc", ".txt", ".xlsx", ".pptx", ".md"],
        "Archives": [".zip", ".tar", ".gz", ".rar", ".7z"],
        "Installers": [".dmg", ".exe", ".pkg", ".iso"]
    }

    stats = {category: 0 for category in rules}
    stats["Others"] = 0

    print(f"开始整理目录: {target_dir}\n" + "-" * 40)

    for item in target_dir.iterdir():
        # 跳过子目录、隐藏文件以及脚本自身
        if item.is_dir() or item.name.startswith(".") or item.name == "organize_files.py":
            continue

        ext = item.suffix.lower()
        matched_category = "Others"

        for category, extensions in rules.items():
            if ext in extensions:
                matched_category = category
                break

        # 确定目标目录并安全移动
        dest_folder = target_dir / matched_category
        dest_folder.mkdir(exist_ok=True)

        target_file_path = dest_folder / item.name
        # 避免重名覆盖:如果目标文件已存在,追加数字后缀
        counter = 1
        while target_file_path.exists():
            stem = item.stem
            target_file_path = dest_folder / f"{stem}_{counter}{item.suffix}"
            counter += 1

        try:
            shutil.move(str(item), str(target_file_path))
            stats[matched_category] += 1
            print(f"[已归档] {item.name} -> {matched_category}/")
        except Exception as e:
            print(f"[移动失败] {item.name}: {e}")

    print("-" * 40 + "\n整理完成!统计汇总:")
    for category, count in stats.items():
        if count > 0:
            print(f"· {category}: {count} 个文件")

if __name__ == "__main__":
    # 执行测试前,请替换为您本机实际存在的测试目录
    organize_folder("./test_folder")
----------------------------------------
[已归档] quarterly_report.pdf -> Documents/
[已归档] dashboard_shot.png -> Images/
[已归档] backup_2026.zip -> Archives/
[已归档] product_specs.docx -> Documents/
----------------------------------------
整理完成!统计汇总:
· Documents: 2 个文件
· Images: 1 个文件
· Archives: 1 个文件
test_folder,放进去几个无用的测试文件再运行。养成在安全沙箱环境下校验文件移动逻辑的习惯。
三、项目二:简易网页热点资讯提取器
爬虫并非遥不可及的高门槛技术,它的本质是“模拟客户端发送网络请求,并从返回的超文本字符串中抽取有效字段”。通过这个小项目,新手可以完整理解HTTP状态码、User-Agent请求头的作用,以及如何用选择器提取结构化数据。
1. 依赖库与准备工作
该项目使用工业界标准的两个轻量库:requests(用于发送网络请求)和 beautifulsoup4(用于解析HTML树)。在终端执行以下命令进行安装:
pip install requests beautifulsoup4
2. 完整实战代码
import csv
from typing import List, Dict
import requests
from bs4 import BeautifulSoup

def scrape_quotes_demo(output_csv: str = "quotes.csv") -> List[Dict[str, str]]:
    # 该网址为国际知名且永久开放的爬虫练习网站,无封禁风险
    target_url = "https://quotes.toscrape.com/"
    headers = {
        "User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36"
    }

    print(f"正在请求目标页面: {target_url}...")
    try:
        response = requests.get(target_url, headers=headers, timeout=10)
        # 严格检查状态码,非200直接抛出异常
        response.raise_for_status()
    except requests.RequestException as err:
        print(f"网络请求失败: {err}")
        return []

    # 解析HTML文本
    soup = BeautifulSoup(response.text, "html.parser")
    quote_elements = soup.select("div.quote")

    results = []
    for item in quote_elements:
        text_el = item.select_one("span.text")
        author_el = item.select_one("small.author")

        quote_text = text_el.get_text(strip=True) if text_el else "无正文"
        author_name = author_el.get_text(strip=True) if author_el else "匿名"

        results.append({
            "quote": quote_text,
            "author": author_name
        })

    # 将提取结果保存为标准CSV表格
    if results:
        with open(output_csv, mode="w", encoding="utf-8-sig", newline="") as f:
            writer = csv.DictWriter(f, fieldnames=["quote", "author"])
            writer.writeheader()
            writer.writerows(results)
        print(f"抓取成功!已将 {len(results)} 条记录保存至: {output_csv}")
    else:
        print("未抓取到有效内容,请检查选择器规则。")

    return results

if __name__ == "__main__":
    data = scrape_quotes_demo()
    # 打印前2条作为验证示例
    for idx, row in enumerate(data[:2], start=1):
        print(f"[{idx}] {row['author']}: {row['quote']}")
抓取成功!已将 10 条记录保存至: quotes.csv
[1] Albert Einstein: “The world as we have created it is a process of our thinking...”
[2] J.K. Rowling: “It is our choices, Harry, that show what we truly are...”
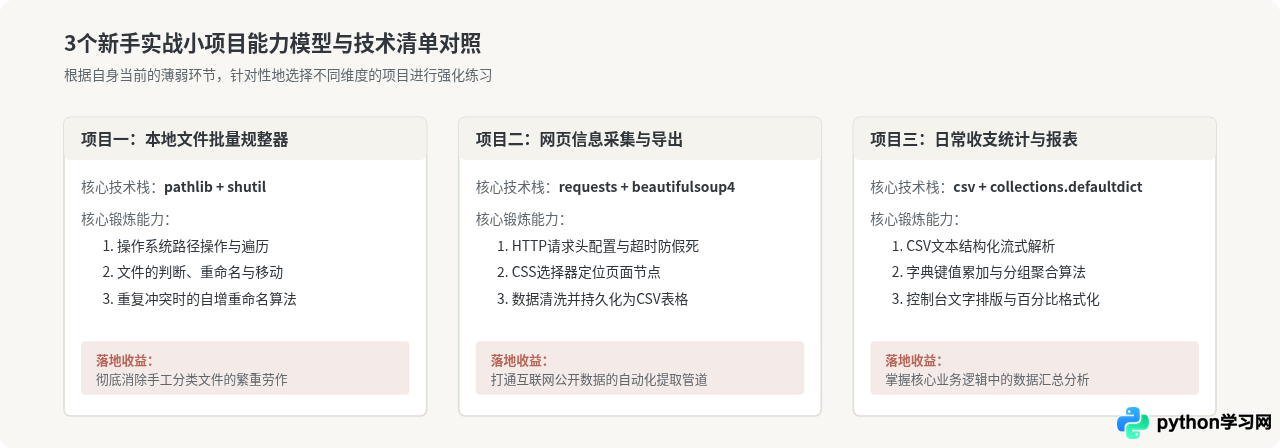
图3:三个推荐新手项目的技能维度与落地收益对照
四、项目三:个人日常开销统计与报表生成器
在企业中,数据分析师和后端工程师每天做的大量工作,就是把原始交易流水汇总成可读的报表。通过纯Python处理CSV账单,不依赖庞大的Pandas,就能深刻掌握列表推导、字典哈希映射以及格式化字符串的实际威力。
1. 模拟账单数据准备
在同级目录下创建一个名为 records.csv 的文本文件,填入如下模拟消费记录:
date,category,item,amount
2026-10-01,餐饮,早餐豆浆油条,12.5
2026-10-01,交通,地铁通勤充值,50.0
2026-10-01,办公,机械键盘按键帽,89.0
2026-10-02,餐饮,工作日商务午餐,35.0
2026-10-02,娱乐,周末电影票,45.0
2026-10-03,餐饮,晚间生鲜超市采购,128.6
2026-10-03,交通,打车返回住处,32.0
2. 完整实战代码
import csv
from collections import defaultdict
from pathlib import Path

def generate_expense_report(csv_file_path: str):
    file_path = Path(csv_file_path)
    if not file_path.exists():
        print(f"找不到账单文件:{csv_file_path}")
        return

    category_totals = defaultdict(float)
    total_amount = 0.0
    valid_count = 0

    with file_path.open(mode="r", encoding="utf-8") as f:
        reader = csv.DictReader(f)
        for row in reader:
            try:
                amount = float(row["amount"])
                cat = row["category"].strip()
                category_totals[cat] += amount
                total_amount += amount
                valid_count += 1
            except (ValueError, KeyError) as e:
                # 过滤异常行或缺少金额的脏数据
                continue

    if valid_count == 0 or total_amount == 0:
        print("未检测到有效开销记录。")
        return

    # 按支出金额从高到低排序
    sorted_categories = sorted(category_totals.items(), key=lambda x: x[1], reverse=True)

    # 打印格式化报表
    print("\n" + "=" * 52)
    print(" " * 16 + "个人消费明细统计报表")
    print("=" * 52)
    print(f"{'消费类别':<10} | {'总金额 (元)':>12} | {'占比':>8} | {'可视化分布'}")
    print("-" * 52)

    for cat, amount in sorted_categories:
        percent = (amount / total_amount) * 100
        # 简单字符柱状图,每5%一个格子
        bar = "■" * int(percent // 5)
        print(f"{cat:<12} | {amount:>14.2f} | {percent:>7.1f}% | {bar}")

    print("-" * 52)
    print(f"有效记录: {valid_count} 笔 | 总计支出: {total_amount:.2f} 元")
    print("=" * 52 + "\n")

if __name__ == "__main__":
    generate_expense_report("records.csv")
个人消费明细统计报表
====================================================
消费类别 | 总金额 (元) | 占比 | 可视化分布
----------------------------------------------------
餐饮 | 176.10 | 44.9% | ■■■■■■■■
办公 | 89.00 | 22.7% | ■■■■
交通 | 82.00 | 20.9% | ■■■■
娱乐 | 45.00 | 11.5% | ■■
----------------------------------------------------
有效记录: 7 笔 | 总计支出: 392.10 元
====================================================
五、从零进阶的3个核心避坑准则
在编写以上小项目的过程中,许多新手往往会因为不经意的编程习惯陷入调试死胡同。想要保证编写的代码安全、健壮,需要时刻遵守以下三条工程准则:
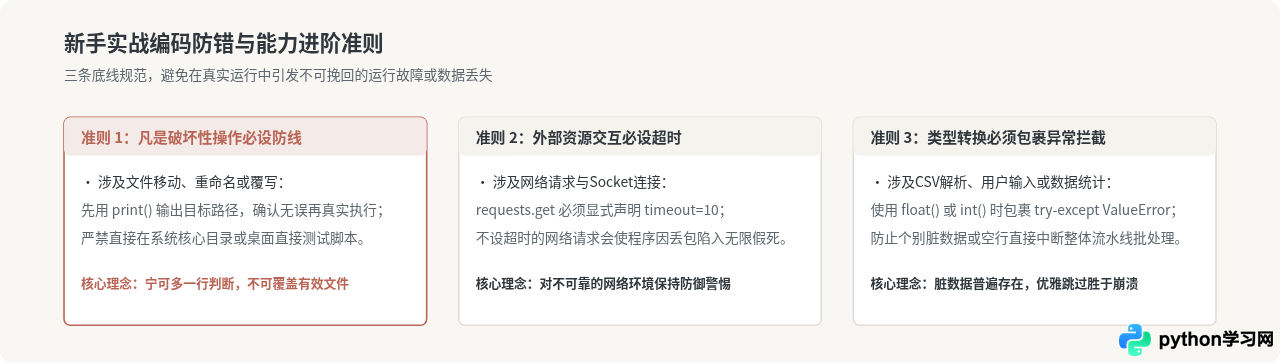
图4:新手编写实战脚本时需建立的三重防御性编程习惯
学习编程最忌讳的是“看懂了教程却从不动手敲”。只要把这3个小项目依次在本地建好文件夹、贴入代码、修改规则、观察运行反馈,你就已经完成了从“语法初学者”到“能写出可用工具的开发者”的关键转变。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









