

什么时候用元组,什么时候用列表?Python数据结构选型指南
深入对比Python中的元组(tuple)与列表(list),从语义规范、底层内存机制、哈希与字典键特性到实际运行开销,提供详尽的决策依据与实用选型指南。
在 Python 编程中,列表(list)与元组(tuple)是最常用的两种序列结构。初学者往往只看到“方括号与圆括号”、“能否修改”的表面差别,但在实际工程开发中,选型失当可能导致代码语义模糊、内存资源过度占用,甚至引发字典键哈希异常。本文将从设计语义、底层内存机制、哈希与字典键特性到运行开销,系统性解答这两种数据结构的选型边界与决策路径。
一、语义设计准则:异质记录与同质集合
在 Python 的设计哲学中,列表与元组的根本差异首先体现在语义模型上:
- 列表(
list)是同质、可变的数据集合:列表内部各个元素的语义通常是一致的,强调数据的集合性与先后排列顺序。例如待处理的订单列表、抓取到的 URL 集合、传感器时序读数等。程序随执行流程频繁追加(append)、删除(pop)或就地重排(sort)列表项。 - 元组(
tuple)是异质、不可变的结构化记录:元组内部各个元素的位置具有严格绑定的具体含义。元组中的不同索引往往代表不同属性,相当于一条固定模式(Schema)的单行记录。例如二维平面坐标(x, y)、RGB 颜色值(255, 128, 0)、或数据库单行记录(user_id, username, created_at)。
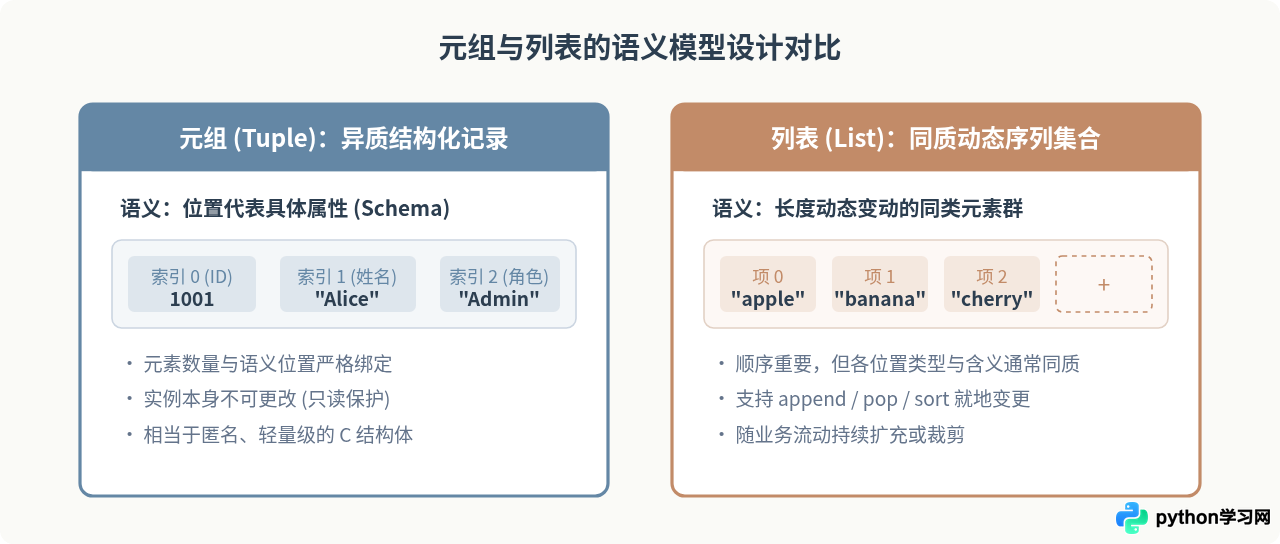
理解语义差异有助于编写自解释的代码。当你在函数签名中返回 (status_code, response_data) 时,任何阅读代码的工程师都能立刻明白:这是一个固定包含两项属性的结果快照,不应当被后续逻辑随意插入新元素。
二、底层机制与内存开销分析
除了表现层的可变性差异,元组与列表在 CPython 解释器内部的内存管理机制有着本质区别。
1. 内存紧凑性与过度分配(Over-allocation)
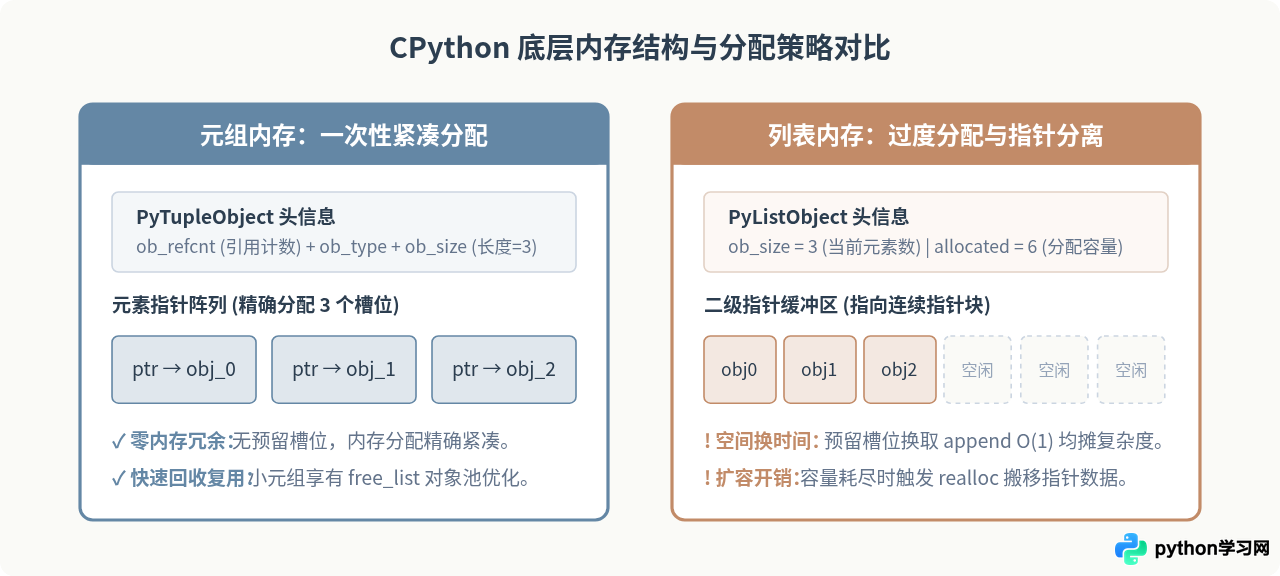
在 CPython 源码中,元组由 PyTupleObject 结构体实现。因为元组是不可变的,其长度在初始化时即固定。CPython 会一次性分配恰好容纳元素指针的连续内存空间,没有任何容量冗余。
列表由 PyListObject 实现。为了让 list.append() 获得平摊常数时间复杂度 \(O(1)\),列表采用了过度分配策略(Over-allocation)。当列表容量填满并追加新元素时,CPython 会分配一个比实际需求更大的底层指针数组,预留空闲插槽,以避免每次追加都触发系统级 realloc 搬迁。
2. 内存占用验证代码
我们可以使用标准库的 sys.getsizeof() 观察两者在不同规模下的字节占用差别:
import sys

# 测试环境:Python 3.10+ (64-bit CPython)
empty_tuple = ()
empty_list = []
print("空元组字节大小:", sys.getsizeof(empty_tuple))
print("空列表字节大小:", sys.getsizeof(empty_list))

t_items = (1, 2, 3, 4, 5)
l_items = [1, 2, 3, 4, 5]
print("5元素元组字节大小:", sys.getsizeof(t_items))
print("5元素列表字节大小:", sys.getsizeof(l_items))
运行结果示例:
空元组字节大小: 40
空列表字节大小: 56
5元素元组字节大小: 80
5元素列表字节大小: 120
解释:列表不仅自身结构体包含额外的容量指针与长度属性,在初始化 5 个元素时,底层还预留了额外的未分配槽位,因此单体占用显著高于元组。在处理千万级数据量(例如海量坐标点或日志特征)时,全量使用元组相比列表能直接节约 30% 到 50% 的堆内存。
三、核心特性与常见陷阱:哈希性与字典键
在 Python 中,字典(dict)的键和集合(set)的元素要求对象必须是可哈希的(Hashable),即实现了稳定的 __hash__() 与 __eq__() 方法。
1. 为什么列表不能作为字典的键?
列表是可变对象,可以在任何时刻修改内部元素。如果列表被用作字典的键,在键被修改后,其哈希值计算结果将发生改变,导致字典内部哈希桶寻址失效,数据将无法被正常查找。因此 Python 在语言层面直接禁用了可变对象的哈希支持:
# 尝试将列表作为字典键
try:
    point_dict = {[10, 20]: "Point A"}
except TypeError as err:
    print("错误提示:", err)

# 正确做法:使用元组作为字典键
coord_dict = {(10, 20): "Point A"}
print("元组键查询成功:", coord_dict[(10, 20)])
运行结果示例:
错误提示: unhashable type: 'list'
元组键查询成功: Point A元组本身的不可变性仅约束其持有的指针引用不可变,并不保证指针所指向的目标对象也是不可变的。如果一个元组内部包含了可变对象(如列表),该元组将无法计算哈希值,同样不能用作字典键:
# 元组包含列表
nested_t = (1, 2, [3, 4])

# 可以成功修改内部列表的内容
nested_t[2].append(5)
print("修改后的元组内容:", nested_t)

# 但是该元组无法被哈希
try:
    hash(nested_t)
except TypeError as err:
print("哈希失败:", err)输出:TypeError: unhashable type: 'list'。因此,当需要将元组作为键或放入集合时,务必确保元组内的所有级联元素皆为不可变类型(如数值、字符串、纯不可变元组)。
在 Python 中,单独的圆括号 (42) 会被解释器视为数学运算中的优先运算表达式,其类型依然是 int。要声明一个单元素元组,必须显式附加英文逗号:(42,)。
四、选型决策流程:四步判断法
在编写业务逻辑或定义数据结构时,可以遵循以下决策树快速确定选型:
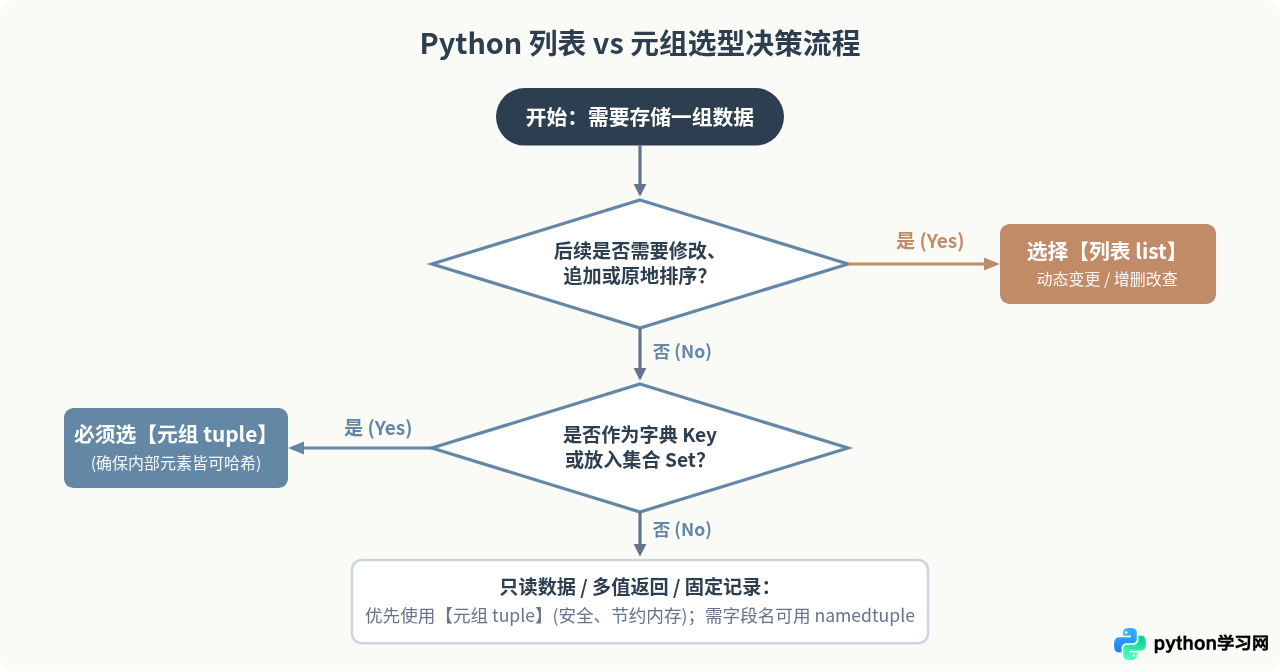
- 第一步:判断是否需要原地修改。如果业务需要随运行动态添加元素(
append、extend)、移除指定项、原地倒序(reverse)或排序(sort),唯一选择是列表。 - 第二步:判断是否需要映射为键。如果数据作为多维坐标缓存、复合查找键注入
dict,或者需要做去重运算放入set,必须使用全不可变元组。 - 第三步:评估数据规模与只读安全性。当数据在初始化后仅供循环遍历读取(例如全局配置项、常量对照表、函数多值返回),优先选择元组。它既能避免业务代码不小心调用
modify破坏状态,又能降低内存开销。 - 第四步:评估可读性需求。当元组字段超过 3 个且仅靠位置索引(如
user[0]、user[3])容易使代码难以维护时,应考虑向标准库的collections.namedtuple或@dataclass(frozen=True)进阶升级。
五、总结与速查对比表
综合以上各维度的技术细节,下表给出了列表与元组的核心指标全景对照:
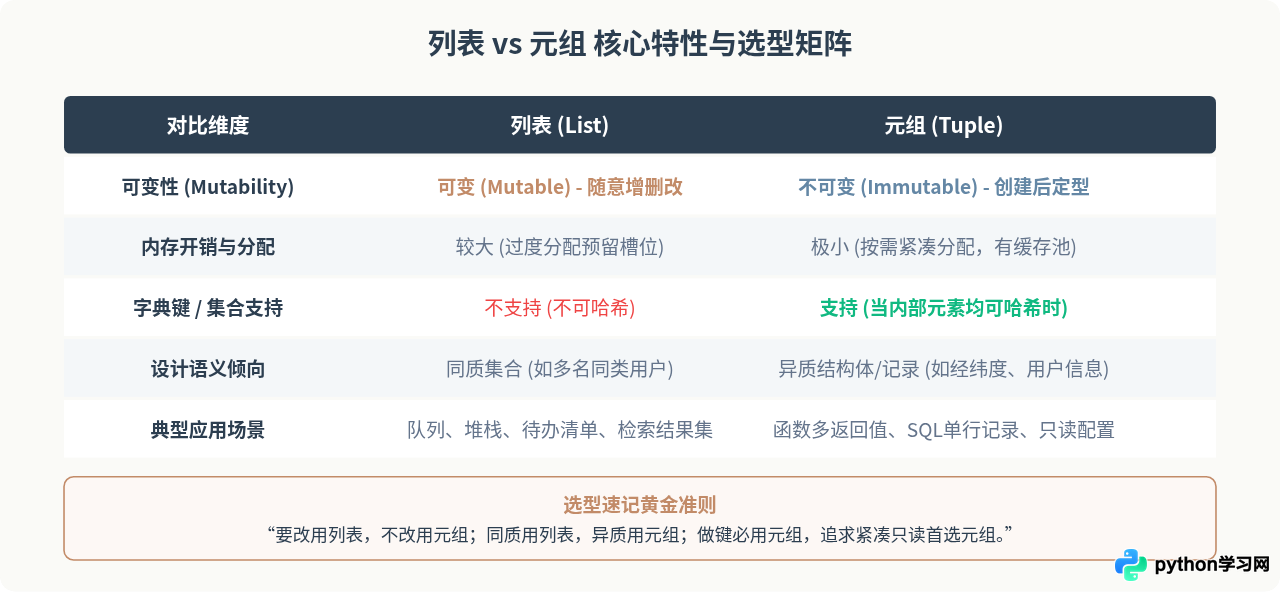
在日常开发中,建议开发者养成“默认审视不可变性”的习惯:如果一组数据从生成到消费完全不需要就地改动,优先将其定义为元组,不仅能清晰地向协作者传达“只读与结构化”的设计意图,还能在底层享受紧凑内存分配与解释器微优化带来的稳定收益。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









