

Python爬虫新手入门:从环境搭建到第一个静态页面抓取
面向新手的Python爬虫实操教程,系统讲解开发环境准备、依赖库安装、静态网页结构分析、数据请求与HTML解析提取全流程。
编写网络爬虫的核心任务,是使用程序模拟浏览器向指定服务器发送网络请求,获取服务器返回的响应内容,并从中抽取出有价值的目标数据。本文将从零开始,完整演示如何配置独立的 Python 开发环境、安装必要的支持库、使用浏览器开发者工具分析静态 HTML 结构,并编写一个健壮的静态页面抓取脚本。
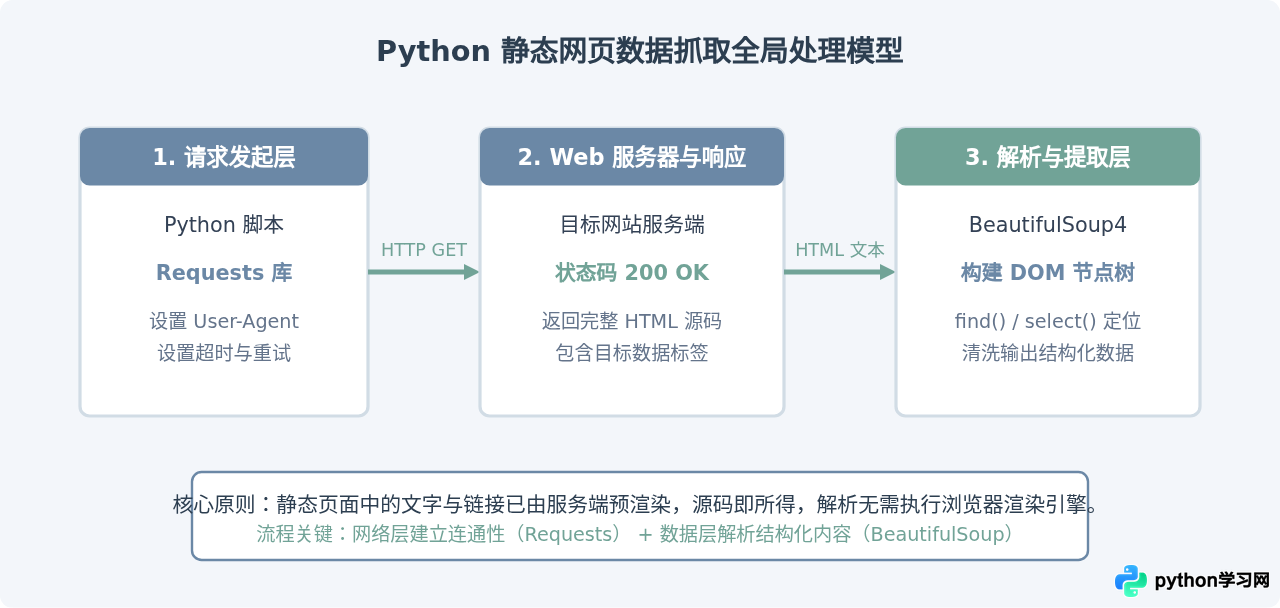
一、什么是静态网页与为什么适合新手入门
在开始编写代码前,必须厘清“静态网页”的概念。在网络爬虫语境下,静态网页指的是:客户端(浏览器或爬虫程序)发起 HTTP 请求后,服务器响应的主体内容就是最终排版渲染完毕的 HTML 字符串。所有的新闻标题、文章内容、作者列表等关键文本,都直接以纯文本标签形式存在于初始响应体中。
与此相对的动态网页,则是服务器仅返回基础的骨架页面,真实的数据依赖浏览器后续执行 JavaScript 脚本通过异步接口(如 AJAX / Fetch)加载,或者直接使用前端框架渲染 DOM。对于静态页面,我们无需安装体积庞大的无头浏览器(如 Selenium 或 Playwright),只需通过轻量级的 HTTP 客户端获取源码即可完成提取,是掌握网络协议与 DOM 解析最佳的起点。
二、开发环境搭建与第三方依赖安装
建议使用 Python 3.8 及以上版本。在实际工程中,为避免不同项目的依赖包版本互相冲突,推荐始终使用 Python 内置的 venv 模块创建隔离的虚拟环境。
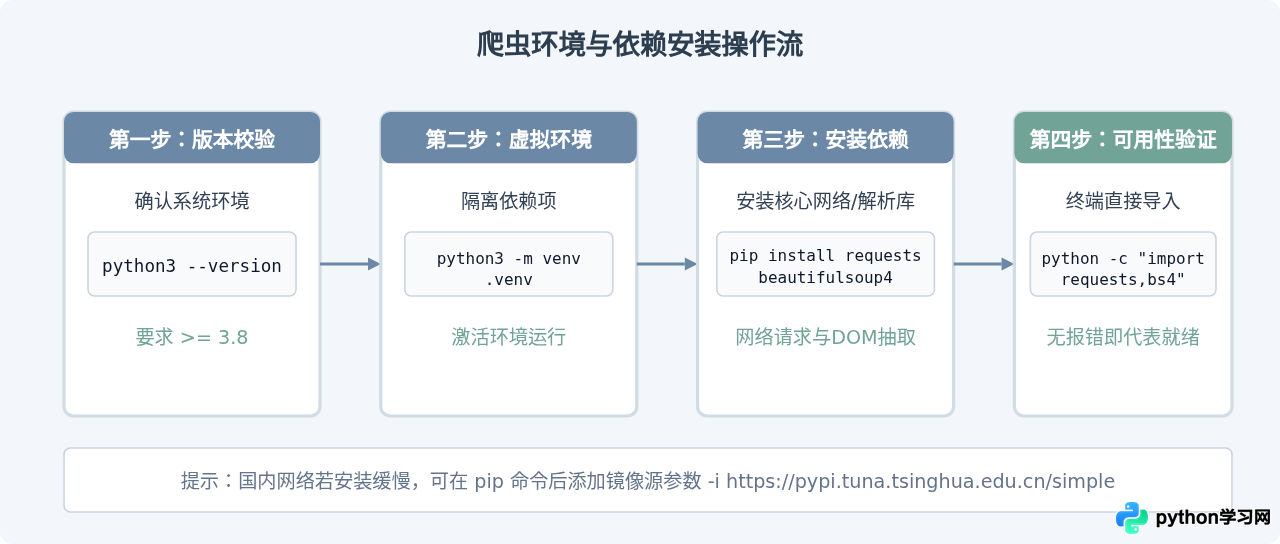
1. 初始化工程目录与虚拟环境
在你的工作磁盘中新建一个名为 my_first_crawler 的文件夹,进入该目录并创建虚拟环境:
# 1. 创建项目目录并进入
mkdir my_first_crawler
cd my_first_crawler

# 2. 创建独立的虚拟环境 .venv
python3 -m venv .venv

# 3. 激活虚拟环境
# macOS / Linux 平台:
source .venv/bin/activate
# Windows PowerShell 平台:
# .venv\Scripts\Activate.ps1
2. 安装第三方功能库
我们将使用两个经过社区长期验证的稳定依赖库:
- Requests:简洁优雅的 HTTP 客户端库,用于向网页发送请求并接收响应。
- BeautifulSoup4:Python 事实上的 HTML/XML 文档解析标准库,提供便捷的树形节点查找与遍历 API。
# 在已激活的虚拟环境中执行安装
pip install requests beautifulsoup4
安装完成后,可以在命令行中快速检验是否安装成功:
python -c "import requests, bs4; print('Environment Ready!')"
# 终端输出: Environment Ready! 即表明准备工作已就绪
三、使用浏览器开发者工具分析目标网页结构
在写哪怕一行爬虫代码之前,最重要的步骤是观察目标页面的 HTML 结构。以经典的练习类静态页面(例如展示图书列表或名言列表的展示页)为例,我们需要明确目标数据位于哪一个标签内,具有什么 CSS 类名或父子层级关系。
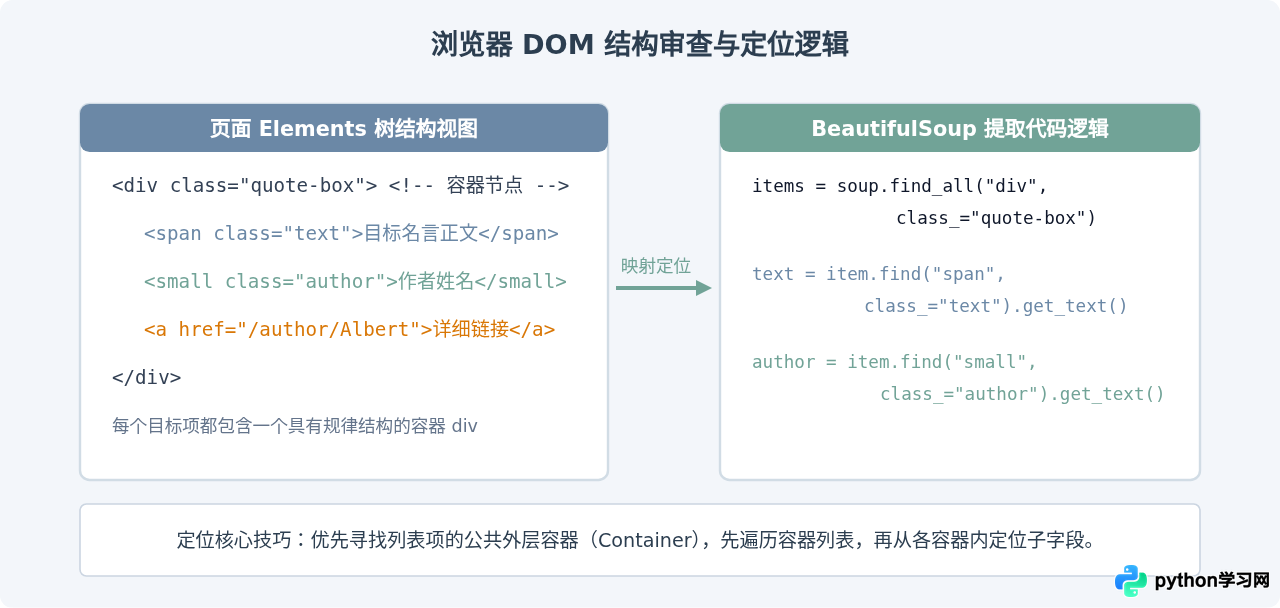
在浏览器中按下 F12(或在页面上右键选择“检查/Inspect”),切换到 Elements 面板。按以下步骤核对:
- 使用左上角的元素选择箭头,点击页面上感兴趣的数据文本。
- 在 Elements 面板中确认该文本所属的标签名(如
<span>、<h3>)以及它的属性值(如class或id)。 - 向上查找其父级容器节点,判断一组重复出现的条目是否有统一的容器类名(例如
class="quote"或class="book-item")。 - 至关重要的一步:按下快捷键
Ctrl+U(Mac 下Cmd+Option+U)查看网页源代码。搜索你在页面上看到的文字。如果源代码中存在该文字,则证实为静态网页;如果源代码中搜不到,说明数据是异步接口返回的动态数据。
四、编写第一个静态页面爬虫
掌握了结构之后,我们可以开始编写 Python 脚本。我们以公开的教学静态网站 https://quotes.toscrape.com/ 作为真实目标。这个网站专为爬虫初学者设计,结构清晰且稳定。
完整爬虫源码实现
在项目根目录新建名为 scraper.py 的文件,写入以下完整代码:
import requests
from bs4 import BeautifulSoup

def fetch_quotes():
    # 1. 目标 URL 地址
    url = "https://quotes.toscrape.com/"

    # 2. 设置合法的请求头(User-Agent),模拟真实桌面浏览器访问
    headers = {
        "User-Agent": (
            "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) "
            "AppleWebKit/537.36 (KHTML, like Gecko) "
            "Chrome/120.0.0.0 Safari/537.36"
        )
    }

    try:
        # 3. 发送 GET 请求,设置合理的超时时间(防止无限等待阻塞程序)
        response = requests.get(url, headers=headers, timeout=10)

        # 4. 检查响应状态码:若非 200 则主动触发异常
        response.raise_for_status()

        # 5. 指定响应编码,防止中文或特殊字符乱码
        response.encoding = response.apparent_encoding

    except requests.exceptions.RequestException as error:
        print(f"网络请求失败: {error}")
        return []

    # 6. 使用 BeautifulSoup 解析 HTML 文档
    soup = BeautifulSoup(response.text, "html.parser")

    # 7. 查找所有包含单条名言的外层容器 div(class 为 quote)
    quote_elements = soup.find_all("div", class_="quote")

    extracted_data = []

    for item in quote_elements:
        # 提取名言正文:定位 class 为 text 的 span 标签
        text_tag = item.find("span", class_="text")
        # 提取名言作者:定位 class 为 author 的 small 标签
        author_tag = item.find("small", class_="author")

        # 提取标签列表(可能包含多个标签)
        tag_elements = item.find_all("a", class_="tag")
        tags = [t.get_text(strip=True) for t in tag_elements]

        # 只有在关键标签均存在时才保存,增强脚本容错性
        if text_tag and author_tag:
            extracted_data.append({
                "quote": text_tag.get_text(strip=True),
                "author": author_tag.get_text(strip=True),
                "tags": tags
            })

    return extracted_data

if __name__ == "__main__":
    print("开始执行静态页面抓取...")
    results = fetch_quotes()
    print(f"成功抓取到 {len(results)} 条数据:\n")

    for index, data in enumerate(results[:3], start=1):
        print(f"[{index}] 作者: {data['author']}")
        print(f"    内容: {data['quote']}")
        print(f"    标签: {', '.join(data['tags'])}")
        print("-" * 50)
关键步骤逐行解析
| 代码片段 | 对应功能 | 技术细节与注意事项 |
|---|---|---|
headers={"User-Agent": ...} |
请求头伪装 | 许多服务器会拒绝默认的 Python 请求头(Python-requests/x.x.x),加上浏览器的 User-Agent 是爬虫的基本礼仪。 |
timeout=10 |
请求超时限制 | 如果目标服务器无响应,不设超时会导致程序卡死。必须养成显式指定 timeout 的习惯。 |
response.raise_for_status() |
状态校验 | 如果返回 404(不存在)或 500(服务器错误),此方法将抛出异常,进入异常处理分支,防止解析空页面。 |
BeautifulSoup(..., "html.parser") |
文档解析树构建 | html.parser 为 Python 内置解析器,免除额外 C 依赖,非常适合新手。 |
strip=True |
空白字符清理 | get_text(strip=True) 会自动清除文本首尾的换行符与多余空格。 |
在终端运行 python scraper.py,将输出类似如下的抓取结果:
开始执行静态页面抓取...
成功抓取到 10 条数据:

[1] 作者: Albert Einstein
    内容: “The world as we have created it is a process of our thinking...”
    标签: change, deep-thoughts, thinking, world
--------------------------------------------------
[2] 作者: J.K. Rowling
    内容: “It is our choices, Harry, that show what we truly are...”
    标签: abilities, choices
--------------------------------------------------
五、常见问题排查与新手避坑指南
在实际动手编写爬虫时,几乎所有人都会遇到以下几个经典问题。掌握排查思路比死记硬背代码更加重要:
-
问题一:抓取到的中文显示为乱码(如 é 或 \u4e2d\u6587)
原因:Requests 自动猜测的response.encoding与网页实际的charset不一致。
对策:在获取response.text之前,手动指定编码:response.encoding = "utf-8"或response.encoding = response.apparent_encoding。 -
问题二:
find()返回None,调用.get_text()抛出AttributeError
原因:选择器类名写错、标签未加载,或部分条目缺失某个字段。
对策:严禁直接连写soup.find(...).get_text(),一定要先判断返回值是否为None,再安全提取属性或文本。 -
问题三:抓取到的列表为空,但浏览器里明明看得到文字
原因:目标内容并非静态 HTML,而是前端 JavaScript 异步渲染生成。
对策:回到浏览器源码视图(Ctrl+U)核查。若源码中没有该数据,需要打开开发者工具的 Network(网络) 面板,筛选Fetch/XHR,直接寻找返回 JSON 数据的后端真实 API 接口。
六、规范与知识结构总结
编写爬虫程序时,应当严格遵守互联网道德与法律底线:始终阅读目标网站的 /robots.txt 协议,在循环请求多页时显式加入 time.sleep(1) 延迟,切勿发起无节制的并发请求对目标服务器造成拒绝服务攻击。
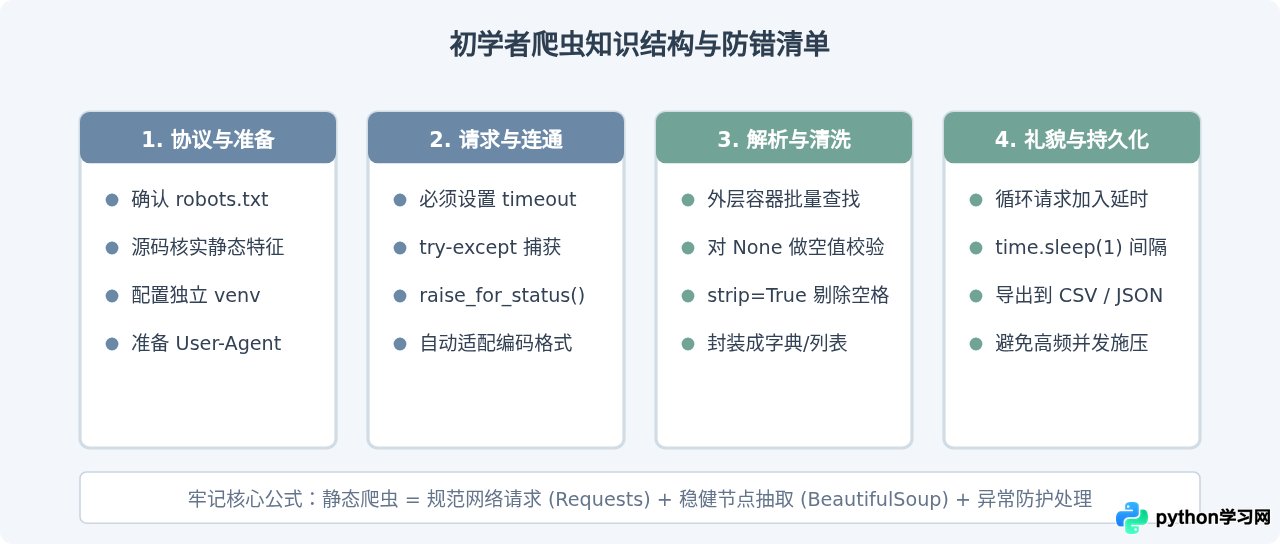
通过本文的步骤,你已经掌握了 Python 爬虫从零搭建环境、分析静态网页标签特征、发送带有伪装头的网络请求,以及使用 BeautifulSoup 稳健提取数据的全套核心技能。以此为基石,后续即可进一步拓展多页循环翻页抓取、数据持久化存储至 CSV 或 SQLite 数据库等更丰富的应用场景。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









