

Python全局变量与依赖注入方案对比
深入对比Python中全局变量与依赖注入方案的优劣,探讨状态共享、代码解耦、测试友好度与多并发环境下的实践差异,并提供详细的重构指南与架构选型建议。
一、为什么全局变量在早期容易被滥用?
在编写小型脚本或独立工具时,直接在模块顶层定义配置或共享客户端是最顺手的做法。Python的模块导入机制保证了同一个模块在整个进程中仅被初始化一次,并将对象缓存于 sys.modules 中。这使得模块级变量天然具备了“单例”属性,任何函数只需 import config 即可随时读取。
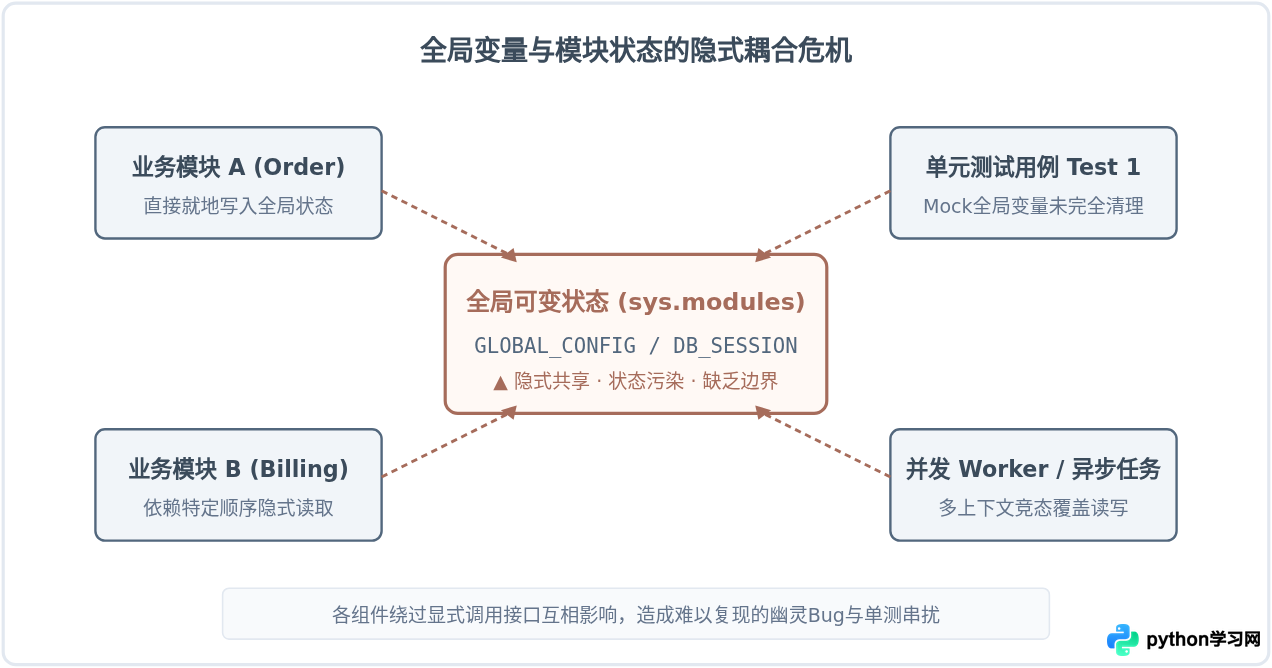
然而,当业务逻辑开始扩张,这种“随处可取”的便捷性就会转化为沉重的技术债务:
- 隐式依赖导致黑盒化: 函数签名中看不到任何入参,外部调用方根本无法预知该函数内部是否依赖了某个全局数据库连接或环境变量,调用契约严重失真。
- 测试夹具污染与难以隔离: 单元测试要求每个用例必须独立可重入。当多个测试用例并发或先后执行时,一个用例对全局状态的就地修改会不可逆地污染后续所有用例。
- 并发安全性丧失: 在异步(asyncio)或多线程环境下,共享的可变全局变量若缺乏严密锁机制,将直接引发竞态条件(Race Condition),导致业务数据错乱。
二、依赖注入(DI)的核心原理:从隐式拉取到显式推送
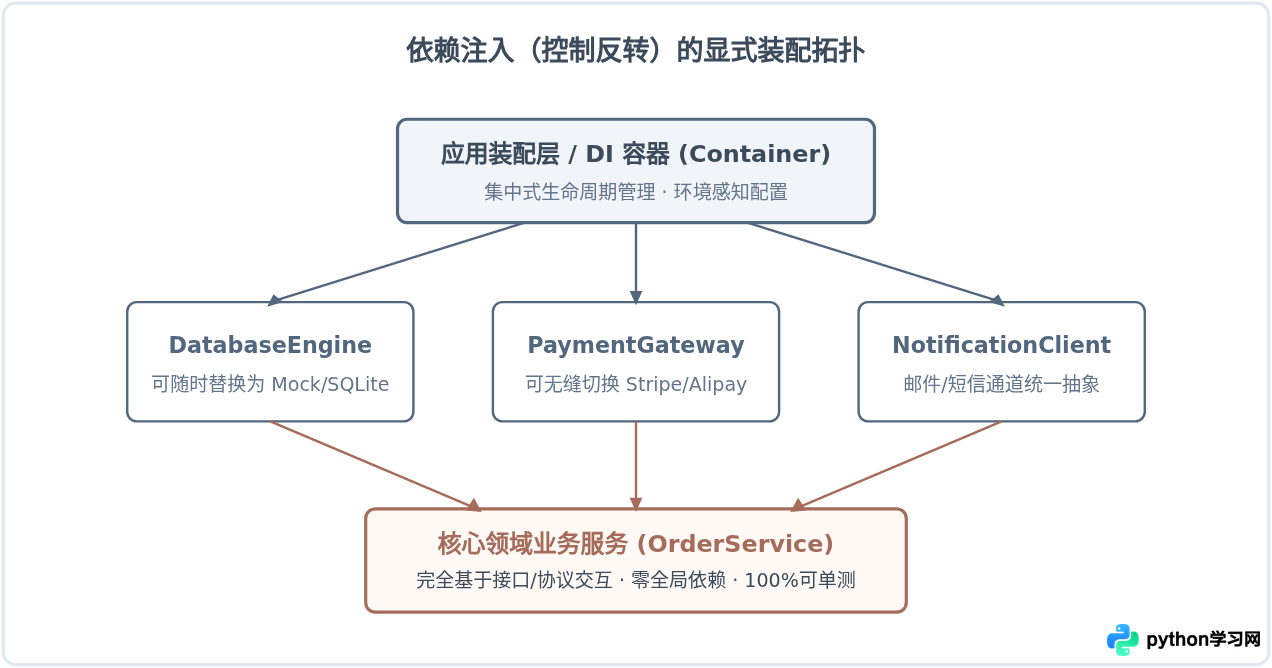
依赖注入并非Java等静态强类型语言所独有,其核心思想是控制反转(Inversion of Control, IoC)。
在传统全局变量模型中,消费者自身负责“寻找并获取”所需依赖(主动拉取);而在依赖注入模式下,消费者放弃主动寻找资源的控制权,转为被动接收外部装配者“推送”进来的依赖对象。
以 Python 代码为例,我们可以非常直观地看到这种控制权的转移:
# 方案一:全局变量模式(隐式拉取)
# config.py
DATABASE_URL = "postgresql://localhost:5432/prod_db"

# order_service.py
import config

class OrderService:
    def process_order(self, order_id: str):
        # 内部直接硬编码依赖全局变量
        engine = create_engine(config.DATABASE_URL)
        ...

# 方案二:依赖注入模式(显式接收)
# order_service.py
class OrderService:
    def __init__(self, db_engine: Engine):
        # 依赖通过构造函数显式注入
        self.db_engine = db_engine

    def process_order(self, order_id: str):
        with self.db_engine.connect() as conn:
            ...
在方案二中,OrderService 对外部运行环境一无所知,它不需要关心数据库连接串来自环境变量、本地INI文件还是云端配置中心;它唯一的职责就是根据入参提供的 Engine 完成订单处理。在单测时,只需传入一个基于内存 SQLite 的 Engine,即可彻底杜绝测试污染。
三、Python 中主流依赖管理方案对比
在实际工程中,团队往往面临三种维度的选择:原生轻量注入、现代框架级注入、以及独立DI容器。
1. 原生轻量注入(参数默认值与工厂模式)
Python 动态特性让轻量级注入变得异常简单,无需引入任何第三方库。最经典的做法是利用函数默认参数配合类型注解:
def get_user_profile(user_id: int, db: DatabaseSession = None) -> UserProfile:
    # 默认值回退到默认工厂,但允许单测时显式传入 Mock
    session = db or get_default_db_session()
    return session.query(UserProfile).filter_by(id=user_id).first()
这种方案改造成本极低,既保留了简单调用的便利,又留出了测试接缝(Test Seam)。
2. 框架原生依赖注入(以 FastAPI Depends 为例)
现代Web框架(如FastAPI、Litestar)内置了优雅的依赖解析机制。它借助类型提示与生成器实现了依赖树递归解析与请求级生命周期自动释放:
from fastapi import Depends, APIRouter

def get_db():
    db = SessionLocal()
    try:
        yield db
    finally:
        db.close()

router = APIRouter()

@router.get("/users/{user_id}")
def read_user(user_id: int, db: Session = Depends(get_db)):
    return db.query(User).get(user_id)
3. 企业级独立DI容器(以 dependency-injector 为例)
针对大型复杂后台、离线批处理或微服务架构,专用的依赖注入框架(如 dependency-injector)提供了工厂(Factory)、单例(Singleton)、配置绑定(Configuration)等全套容器能力,能够在应用启动时完成整张对象依赖图的静态拓扑校验。
| 对比维度 | 全局变量 / 模块单例 | 原生构造/参数注入 | 框架内置 (如 Depends) | 专业DI容器 (如 dependency-injector) |
|---|---|---|---|---|
| 初始化复杂度 | 极低(定义即用) | 低(手动传参) | 中等(需熟悉框架DSL) | 较高(需编写Providers定义) |
| 单测隔离难度 | 高(需手动打补丁并还原) | 极低(直接传入Mock实例) | 极低(覆盖 dependency_overrides) | 极低(声明式容器Mock替换) |
| 生命周期管理 | 进程级别全局常驻 | 随调用链自由决定 | 请求级别/会话级别可自动关闭 | 多级别可配(单例/瞬态/线程池) |
| IDE静态检查 | 容易丢失上下文感知 | 极强(完整类型提示推断) | 极强(FastAPI/Pydantic友好) | 良好(配合泛型提供类型提示) |
| 适用规模 | 1-3个文件的简单脚本 | 中小型项目、基础库开发 | RESTful API 与微服务 | 大型复杂系统、企业级单体应用 |
四、从全局变量平滑迁移到依赖注入的实操四步法
如果现有项目已经充斥着大量的模块级全局变量,强行一口气重构往往会导致系统崩溃。采用渐进式迁移策略可以在不破坏生产稳定性的前提下平稳落地。
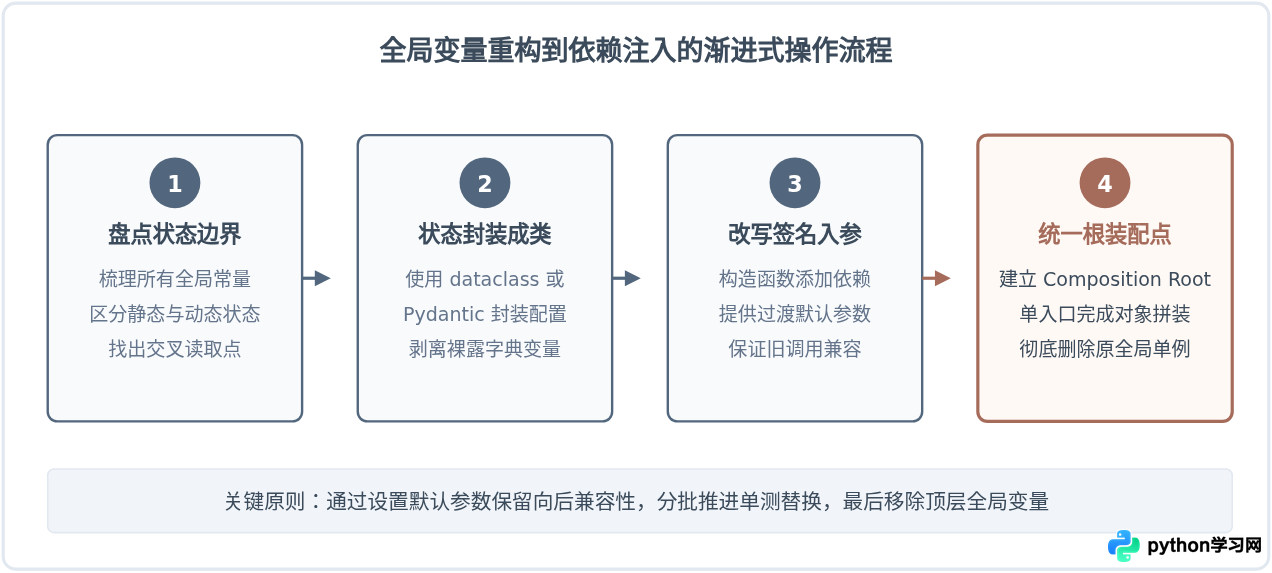
def __init__(self, client: HttpClient = None): self.client = client or default_client。这样既不会破坏现存成百上千处业务调用,又能让新编写的测试直接注入自建客户端;等到所有调用点均改造完毕,再将默认值彻底移除。
五、方案选型决策模型
并非所有Python项目都需要重型依赖注入框架。架构选型应严格服务于系统生命周期与工程规模,避免过度设计。下面的决策流程图展示了面对不同业务场景时的推荐选型路径:
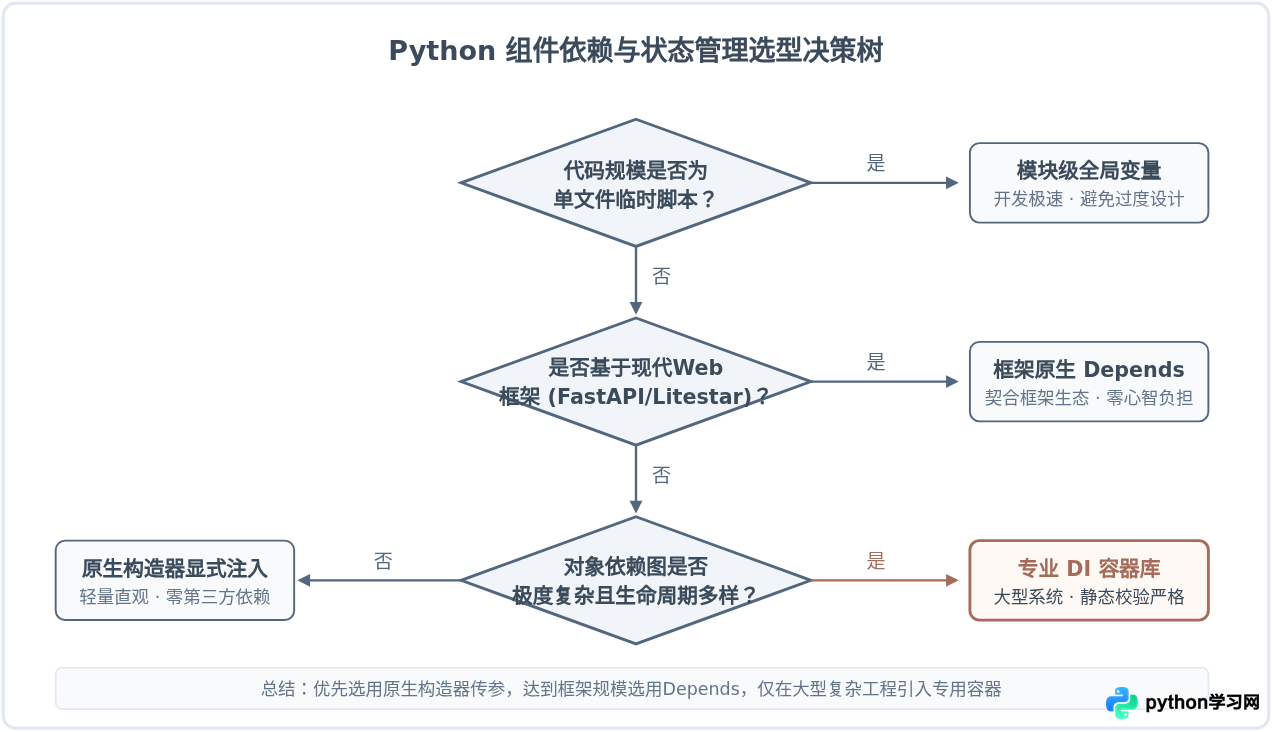
六、核心总结
Python 全局变量与依赖注入并不是绝对对立的非黑即白,而是针对不同复杂度的工程权衡。全局变量是一笔高利贷:它在项目最初的几小时内赋予开发者极速交付的快感,却在后续的单元测试、并发优化与逻辑解耦中收取昂贵的利息;而依赖注入在初期仅需多写几行构造参数,却能将组件的边界与输入输出契约严格约束,让项目始终保持易测试、高内聚、易扩展的健康状态。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









