

为什么Python选择用C语言作为主要实现语言?
深入解析Python为何选择C语言作为主要实现语言。从历史背景、系统级控制、运行效率、C扩展生态及架构权衡等维度,全面剖析CPython的设计逻辑与核心优势。
Python(其官方标准参考实现 CPython)选择使用 C 语言作为主要开发语言,是因为在 1989 年 Python 诞生时及后续的技术生态中,C 语言提供了无可替代的综合优势:与操作系统底层(尤其是 Unix/POSIX)无缝直通的能力、极其确定且近乎硬件极限的运行效率、无可匹敌的跨平台可移植性,以及能以极低阻力复用海量现有系统库的“胶水语言”粘合能力。这种架构让 Python 既获得了高级脚本语言的高开发效率,又拥有底层 C 语言的可靠性能支撑。
一、历史契机与问题溯源:ABC 语言的教训
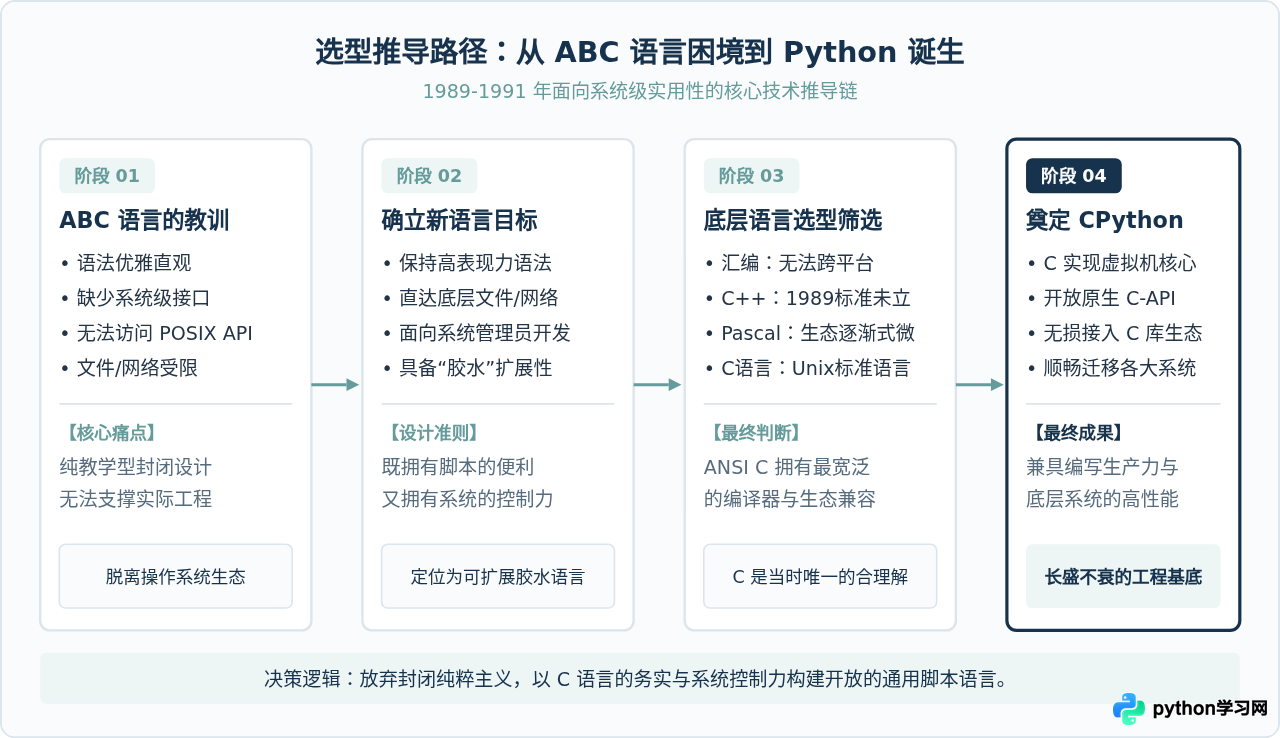
要理解 Python 为何选择 C 语言,首先需要回到 1989 年末 Python 创始人吉多·范罗苏姆(Guido van Rossum)所处的技术环境。在荷兰阿姆斯特丹的国家数学与计算机科学研究中心(CWI),吉多曾深度参与 ABC 语言的开发工作。
ABC 是一门为了教学和非专业程序员设计的优雅语言,具有简洁的高级语法结构、内置高阶数据类型以及良好的可读性。然而,ABC 在工业生产中遭遇了严重的推广困境。其核心缺陷在于过度封闭的黑盒设计:ABC 无法直接调用操作系统的底层系统调用(System Calls),无法自如地进行底层文件 I/O 控制、进程派生、终端操控或网络套接字通信。当开发者需要完成系统管理或工业级任务时,ABC 束手无策。
在汲取 ABC 的教训后,吉多决定设计一门新语言:它必须继承 ABC 优雅可读的语法,但底层必须完全对外敞开,能够自由操纵底层操作系统资源。而当时 Unix 环境中处于绝对统治地位的系统开发语言正是 C 语言。选择用 C 语言编写解释器,使得 Python 从诞生第一天起就原生具备了调用全部系统级接口的能力。
二、系统级掌控力与跨平台可移植性的平衡
解释器的实现本质上是一个复杂的系统级软件工程。设计者在编写运行时环境时,必须对内存布局、函数调用栈、信号处理及操作系统接口保持细粒度的控制。
在 1989 年,如果想实现这一目标,理论上只有两种选择:
- 汇编语言:执行性能极限,但指令集高度绑定特定硬件架构(x86、m68k、SPARC、MIPS 等)。一旦使用汇编编写,跨平台移植意味着彻底重写整个运行时,维护成本呈指数级膨胀。
- C 语言:作为“高级汇编语言”,C 语言允许开发者直接操作指针、手动管理内存并内联调用系统底层服务,同时又屏蔽了具体的硬件寄存器和指令差异。1989 年正值 ANSI C 标准(C89)发布,标准 C 编译器几乎已成为所有商用硬件平台的标配。
这为 Python 带来了极为关键的跨平台可移植性。只要一台机器上安装了符合标准的 C 编译器,CPython 源代码几乎无需修改即可直接编译运行。从早期的 Amoeba 分布式系统、各种 Unix 发行版,到 DOS、Windows 以及后来的 macOS、Linux 和各类嵌入式设备,C 语言构筑的底层抽象让 Python 迅速完成了全平台的渗透。
三、CPython 的核心运行机制:C 语言如何承载动态语言
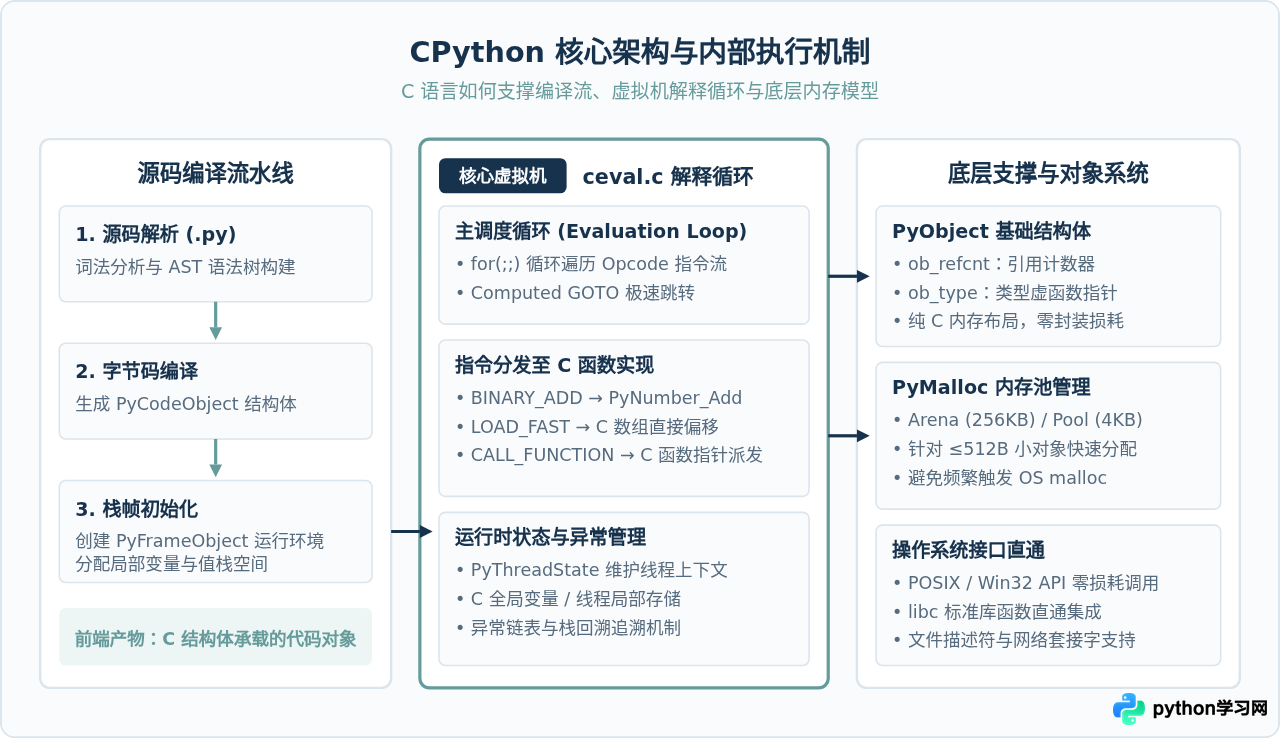
为了直观理解 C 语言是如何承载 Python 动态特性的,我们可以从 CPython 的内部源码结构展开。CPython 并没有把 Python 源码直接翻译成机器码,而是构建了一个完整的虚拟机体系,其核心完全由精简的 C 结构体和调度循环实现:
1. 统一的对象模型(PyObject)
在 Python 中,“一切皆对象”。在 C 语言层面,这个设计表现为一个极其简洁的结构体:
/* Include/object.h 中的核心定义简化示意 */
typedef struct _object {
    _PyObject_HEAD_EXTRA
    Py_ssize_t ob_refcnt;          /* 引用计数器:支撑 Python 的垃圾回收 */
    struct _typeobject *ob_type;   /* 类型对象指针:指示当前对象的类型与虚函数表 */
} PyObject;
不管是整数、字符串、列表还是自定义类实例,它们在内存中的首部都拥有相同的 PyObject 头。C 语言的结构体内存连续布局特性,使得任何 Python 对象指针都可以直接强转为 PyObject* 进行通用处理。引用计数增减(Py_INCREF / Py_DECREF)与类型方法动态派发(通过 ob_type->tp_as_number 等虚函数表)全部是在 C 语言指针级别完成的,开销极其微小。
2. 高效的虚拟机指令解释循环(ceval.c)
Python 源码在编译成字节码后,最终被送入 CPython 的核心执行引擎——ceval.c 中的 _PyEval_EvalFrameDefault。该函数本质上是一个庞大且被深度优化的 C 语言 switch-case 循环(在 GCC/Clang 下支持 computed goto 指令分发)。每一个字节码指令(Opcode)都直接对应一段紧凑的 C 指令操作,例如:
/* 字节码分发与执行逻辑示意 */
TARGET(BINARY_OP) {
    PyObject *right = POP();
    PyObject *left = TOP();
    PyObject *res = _PyNumber_BinaryOp(left, right, oparg);
    Py_DECREF(left);
    Py_DECREF(right);
    SET_TOP(res);
    DISPATCH();
}
3. 分级内存管理(PyMalloc)
频繁创建和销毁微小对象(如整数、单字符、短字符串)是动态脚本语言的典型特征。如果每次申请内存都直接调用操作系统的 malloc,不仅会导致频繁陷入内核态产生上下文切换开销,还会造成严重的内存碎片化。
CPython 使用 C 语言在标准 malloc 之上构建了一套名为 PyMalloc 的三级内存池架构(Arena 256KB、Pool 4KB、Block 8~512B)。对于小于等于 512 字节的小内存块申请,CPython 直接在预分配的内存池中以 C 指针位移快速分配与回收,将小对象的内存分配成本降低到了几十个 CPU 时钟周期级别。
四、“胶水语言”定位与低成本生态扩展
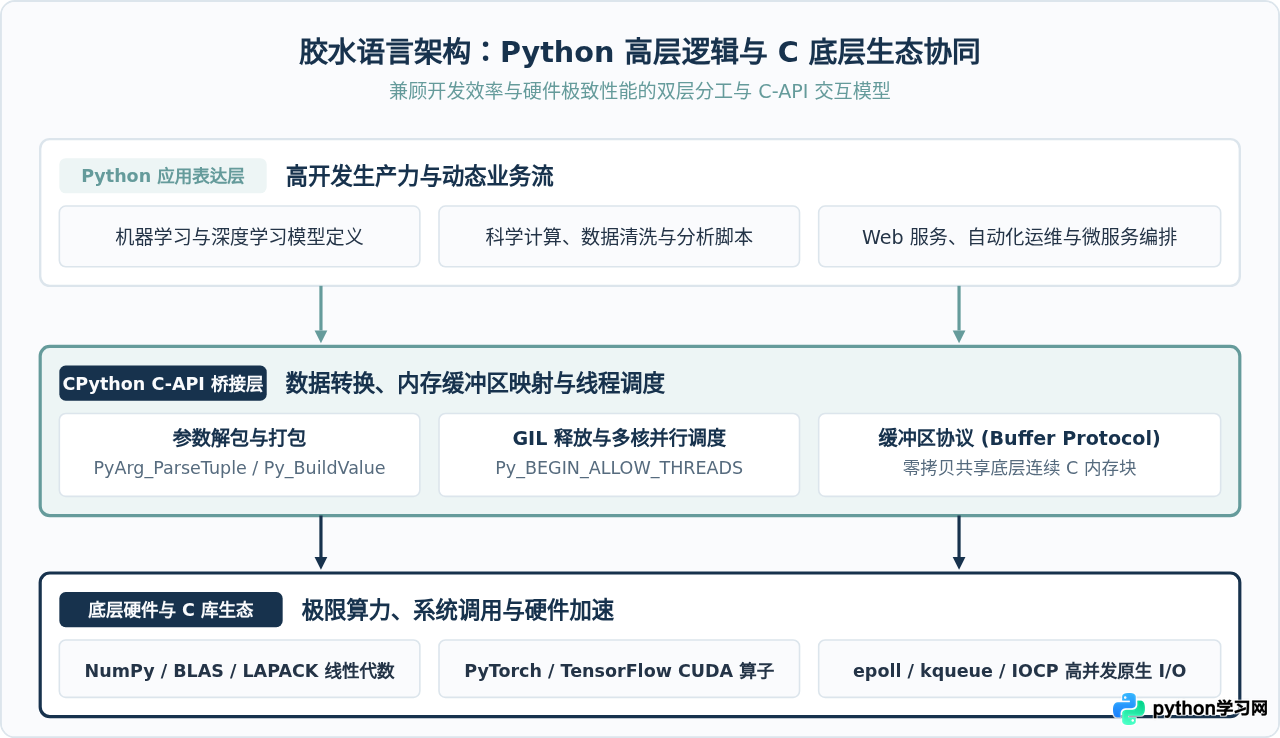
很多初学者容易将 Python 视为一门“运行较慢的动态语言”,但这种看法忽视了吉多最初对 Python 的定位——胶水语言(Glue Language)。
吉多非常清楚,动态类型和解释执行必然会在纯数值计算时引入类型检查和装箱拆箱开销。因此,Python 的设计哲学从一开始就不是“在解释器里用 Python 代码硬扛所有重度计算”,而是“用最容易阅读的语法协调逻辑,把密集计算交给最底层的 C/C++/Fortran 处理”。
1. 原生且极简的 C-API 机制
因为 CPython 本身就是纯 C 语言编写的,因此向 Python 暴露一个 C 函数或 C 模块没有任何中间桥接层(如 Java 的 JNI 或其他跨语言 FFI 的复杂封包开销)。开发者只需引入 Python.h,定义一个标准的 C 函数与方法注册表:
#include <Python.h>

/* C 扩展函数示例 */
static PyObject* fast_matrix_calc(PyObject* self, PyObject* args) {
    long n;
    if (!PyArg_ParseTuple(args, "l", &n)) {
        return NULL; /* 参数解析失败,返回 Python 异常 */
    }

    /* 直接调用纯 C/汇编进行极限性能运算 */
    long result = 0;
    for (long i = 0; i < n; i++) {
        result += i * i;
    }

    return PyLong_FromLong(result); /* 将 C 整型打包回 Python 对象 */
}
2. GIL 的关键作用:释放解释器锁并发运行 C 代码
在多线程环境下,CPython 的全局解释器锁(GIL)用于保护内部 PyObject 引用计数器的线程安全。但很多开发者不知道的是:在 C 扩展中执行计算密集型或阻塞型 I/O 操作时,可以随时通过宏释放 GIL:
Py_BEGIN_ALLOW_THREADS
/* 此处代码不持有 GIL,操作系统可以调度多个 CPU 核心真正并行运行 C 代码 */
compute_heavy_simd_task(data, size);
Py_END_ALLOW_THREADS
这也是为何 NumPy、SciPy、OpenCV、PyTorch 和 TensorFlow 能够在 Python 生态中蓬勃发展的根本原因。用户在 Python 代码中写下简洁的 a @ b 或 model.forward(),Python 仅负责解析指令,随后瞬间穿透至底层高度优化的 BLAS/LAPACK、C++ 算子甚至 CUDA 内核,以零开销运行在硬件极限速度上。
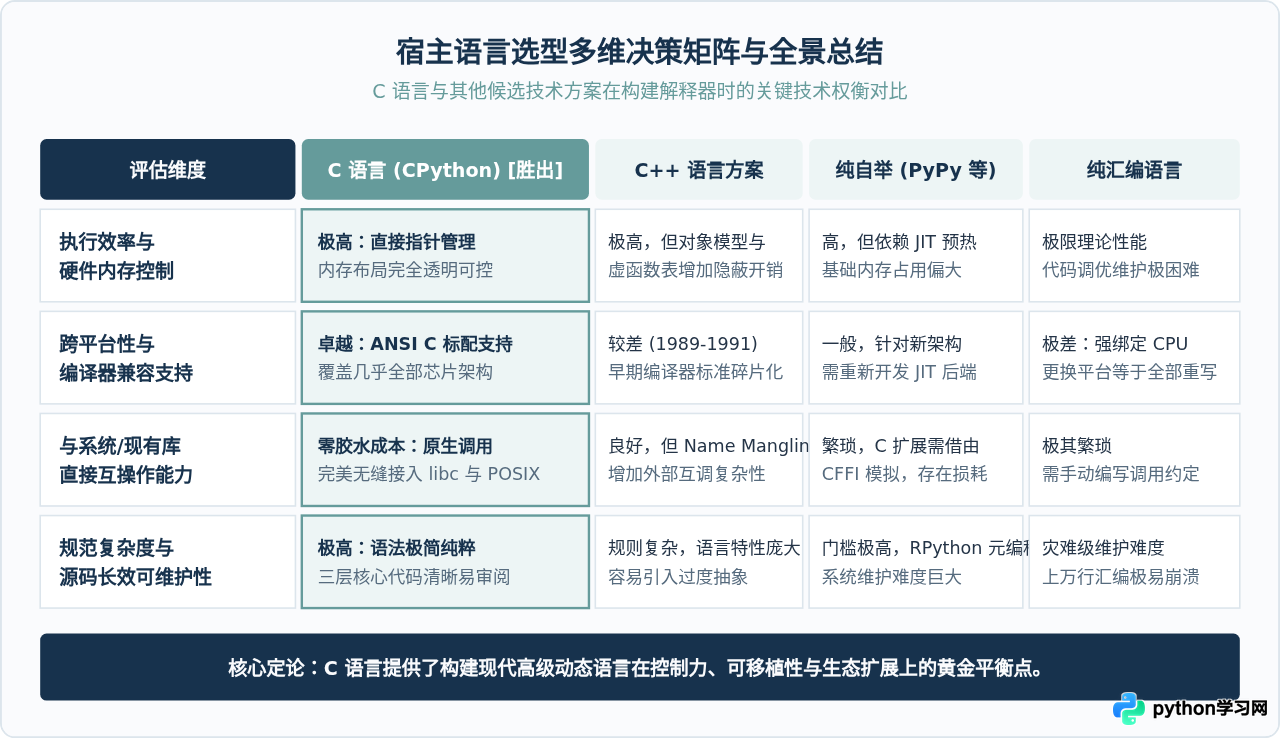
五、为什么不是其他语言?(技术选型的横向对比)
回顾计算机语言发展史,读者可能会好奇:除了 C 语言,当时或后来的其他语言能否作为 Python 的宿主语言?我们可以逐一进行工程维度的技术推演:
1. 为什么不用 C++?
1989 年至 1991 年间,C++ 尚处于萌芽和剧烈演进阶段(直到 1998 年 ANSI/ISO 才正式发布 C++98 标准)。当时的 C++ 存在诸多在系统级虚拟机实现中难以承受的短板:
- 编译器差异与混乱的 ABI:早期各大 Unix 厂商(如 Sun、SGI、IBM)的 C++ 编译器对类布局、符号修饰(Name Mangling)和虚函数表的实现各不相同,跨平台代码极难统一编译。
- 庞大的运行时开销:C++ 的异常展开机制(Stack Unwinding)和早期的 RTTI 带来了不可预测的二进制膨胀与性能不确定性。
- C 的纯粹与简洁:C 语言规范固定、语法紧凑,其内存布局一目了然,极度适合编写结构高度标准化的虚拟机核心。
2. 为什么不用纯自举(用 Python 写 Python)?
现代确实存在用 Python 子集自举的优秀项目——PyPy(使用 RPython 编写,并包含强大的 Tracing JIT 编译器)。PyPy 在纯 Python 代码的运算上性能极为优异,但它并未取代 CPython,原因在于:
- 启动开销与内存占用:JIT 编译器需要预热分析热点循环代码,内存占用显著高于 CPython,对于启动速度要求极高的命令行工具或短时任务极不友好。
- 对 C 扩展生态的兼容成本高昂:科学计算生态中的库深度依赖 CPython 的
PyObjectC 结构体内存布局。自举虚拟机要模拟这一套 C 内存布局,往往需要经历繁琐的兼容层代理,导致执行 C 扩展时的性能反倒不如原生 CPython。
六、现代视角下的 C 语言基底与未来演进
三十余年过去,随着 Rust、Go、Zig 等现代系统编程语言的崛起,Python 社区也曾多次讨论过是否要重写 CPython 核心。然而,CPython 官方团队依然坚定地以 C 语言为主线,并在此基础上持续进化:
- Faster CPython 优化计划:自 Python 3.11 起,在吉多与核心开发者的推动下,CPython 引入了专门化自适应解释器(Specializing Adaptive Interpreter)。通过在 C 级别针对特定运行期类型内联优化字节码(如快速属性查找与直接整数运算),在保留全部 C 兼容性的同时实现了 10%~60% 的基础性能提速。
- 自由线程(Free-threaded Python 3.13+):为逐步移除 GIL,CPython 在 C 级别重构了内存模型,引入模仿 Mimalloc 的三级线程安全分配器与基于偏向锁的并发引用计数(Mimalloc-based mimalloc-core),依然稳健地依托 C 语言的精细内存操控。
- 即时编译(Copy-on-Write JIT):Python 3.13 试验性引入的微型 JIT(Copy-and-Patch JIT),核心思路正是将编译好的 C 机器码模板在运行时直接拼接,完全建立在对 C 编译器生成的汇编二进制片段的精妙控制之上。
工程启示:Python 选择 C 语言作为主实现语言,绝不是一时冲动的历史巧合,也不是向性能妥协的无奈之举,而是一次极其深刻的系统工程取舍。它用 C 语言打造坚如磐石的“性能底座”与“互联管道”,把对开发者的友好度和灵活性全部留给上层 Python 语法。这种高低搭配、软硬互补的架构思想,正是 Python 历经三十年仍能在人工智能与全场景软件开发中屹立不倒的最底层驱动力。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









