

Python标准库参考手册怎么查更高效?搜索技巧与目录结构解析
深入解析Python官方标准库参考手册的目录分类逻辑与模块页面结构,分享版本锁定、精准URL直达、搜索引擎高级语法以及终端pydoc等高效查阅与避坑技巧。
高效查阅 Python 官方标准库参考手册的核心在于“先建立目录层级认知,再运用精准检索通道”。Python 官方文档(The Python Standard Library)涵盖了数百个内建模组和成千上万个函数,很多开发者在遇到问题时,往往直接在全局搜索引擎中漫无目的地翻找,容易被过时信息误导或迷失在复杂的参数列表中。本文将剖析标准库手册的分类逻辑、单模块页面结构,并提供可直接落地的检索技巧与避坑经验,帮助你建立清晰的查阅路径。
一、标准库目录结构的逻辑分层
Python 标准库的官方参考手册并非按照字母随意堆砌,而是按照计算机系统层次与实际开发应用场景自底向上组织的。理解这一结构分类,能帮助你在脑海中形成一个“模块功能地图”,在需要某种能力时迅速圈定查阅范围。
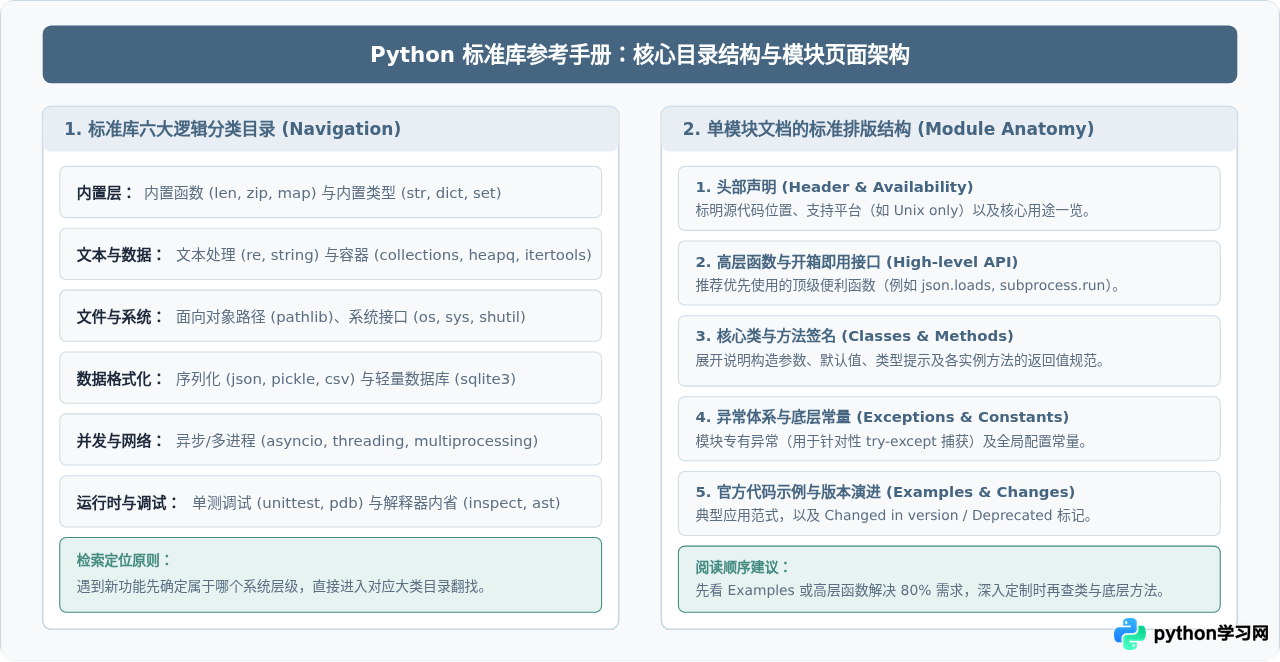
1. 顶层逻辑六大核心板块
- 内置对象(Built-in Functions & Types):
len()、enumerate()、zip()等全局可用函数以及str、list、dict的内置方法。无需任何import,是性能最高也是最基础的查阅对象。 - 文本与通用数据结构:
re(正则)、string、collections(高级容器)、itertools(迭代器生成)、heapq(堆队列)等。当你需要实现复杂数据流处理时,优先在此板块寻找轮子。 - 文件与操作系统接口:现代 Python 首选面向对象的
pathlib,搭配底层的os、sys、shutil(高阶文件操作)和subprocess(子进程管理)。 - 网络通信与网络数据交换:包含
json、sqlite3、csv等数据存储与交换格式,以及urllib、http.server、socket等网络协议库。 - 并发执行与异步框架:涵盖多线程
threading、多进程multiprocessing、并发池concurrent.futures以及现代异步 IO 核心asyncio。 - 测试、调试与语言运行时:包含单元测试
unittest、交互式调试器pdb、性能分析cProfile以及代码自省inspect。
2. 单模块文档的固定排版逻辑
官方文档每个具体模块页面均遵循高度统一的结构:
- 模块概述与 Availability:页面开头说明该模块的核心职责,并明确标出可用平台(如
Availability: Unix表示该接口在 Windows 上不可用)。 - 顶层函数(High-level Functions):通常呈现最直观、封装度最高的 API。例如在
subprocess模块中,开头重点推荐的是subprocess.run(),而不是底层复杂的Popen类。 - 类与其方法(Classes & Methods):详述内部对象的属性、构造器与方法定义。
- 示例小节(Examples):往往藏在页面中后段,提供最原汁原味的官方最佳实践代码。
- 版本变更标注(Version Directives):包括
New in version 3.x、Changed in version 3.x和Deprecated since version 3.x。这是避免踩坑的重要依据。
二、手册高效检索的四大实战技巧
直接在文档主页滚屏翻阅效率极低。掌握以下四项技巧,可以在数秒内直达目标内容。
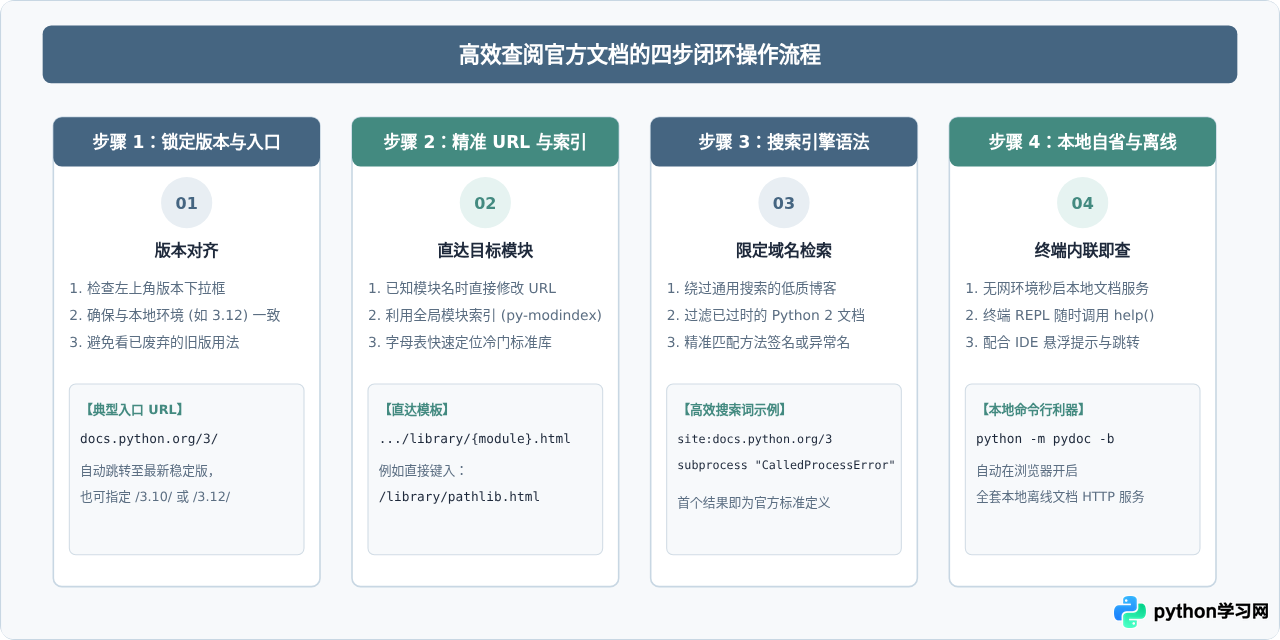
技巧一:URL 规则化直达,省去所有翻阅动作
Python 官方手册的 URL 具有极高的规律性。标准库所有模块均存放在 /library/ 路径下,格式为:
https://docs.python.org/3/library/{模块名}.html当你需要查 pathlib 时,无需从首页层层点击,直接在浏览器地址栏输入 docs.python.org/3/library/pathlib.html 即可。如果要查特定类或函数,页面锚点通常是 #{模块名}.{类或函数名},例如:
https://docs.python.org/3/library/subprocess.html#subprocess.run技巧二:善用全局模块索引(Global Module Index)
很多开发者不知道官方手册内置了一个按英文字母排序的完整模块索引表。其访问地址为:
https://docs.python.org/3/py-modindex.html页面将标准库内的所有顶级模块与子模块(如 os.path、urllib.parse)全部按 A-Z 列出。当你依稀记得模块拼写但不确定分类时,在该页面按下 Ctrl + F(或 Cmd + F)是最快的索引手段。
技巧三:搜索引擎精准限定(site: 语法)
使用通用搜索引擎查找 Python 知识时,前几条经常充斥着抄袭站点或未注明年份的零碎笔记。使用高级检索限定符能直接穿透干扰:
site:docs.python.org/3/ [模块或函数名] [核心诉求]
例如搜索:site:docs.python.org/3/ asyncio gather return_exceptions,结果的第一条必然是官方对该参数的权威解释与类型说明。
技巧四:利用 Python 内置的本地文档服务(pydoc)
在飞机上、内网开发环境或网络延迟较高时,无需依赖外网。Python 自带的 pydoc 模块可以直接把当前 Python 环境的文档渲染为本地 Web 服务:
# 在终端执行以下命令,会自动在本地随机端口启动 HTTP 服务并在默认浏览器打开
python3 -m pydoc -b

# 也可以指定固定端口
python3 -m pydoc -p 8088
该服务不仅能查标准库,还能查当前环境已安装的所有第三方三方库的 Docstring,检索速度为本地极速响应。
三、不同检索场景下的工具与方案对比
日常编码中,查阅文档的诉求分为“查参数定义”、“查模块选型”、“查使用样例”等。不同场景适合不同的查询媒介。
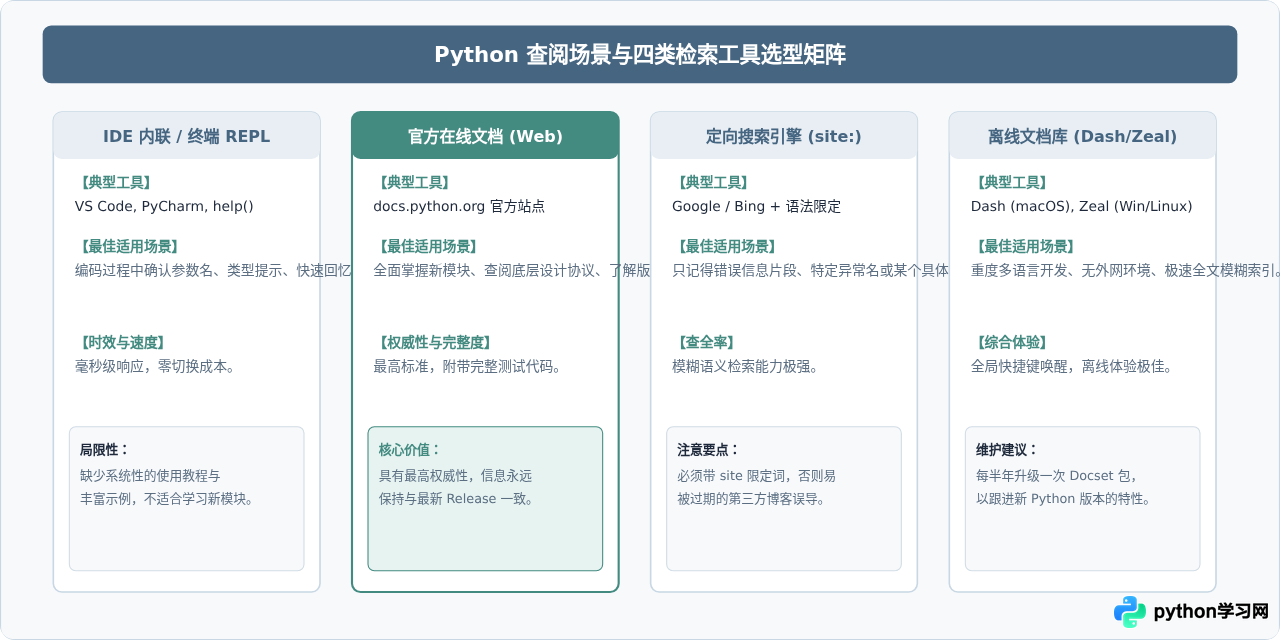
| 查询目标 | 推荐查询工具 | 具体操作方法 | 优势与注意事项 |
|---|---|---|---|
| 函数参数列表与默认值 | IDE 内联悬浮提示 / REPL | 输入函数名后触发提示,或终端执行 help(os.path.join) |
速度最快,但缺乏整体系统范例。 |
| 某类任务的通用解决方案 | 官方手册对应章节的 Examples | 直达 /library/{module}.html 拉到下方 Examples 区域 |
示例代码由核心开发者编写,规范度最高。 |
| 特定报错或异常类型 | 搜索引擎定向语法 | site:docs.python.org/3 "KeyError" |
可直达官方定义的继承层级与产生原因。 |
| 断网环境或高频查阅 | pydoc 服务 / Dash 离线包 |
终端执行 python -m pydoc -b |
零网络延迟,完整包含第三方库文档。 |
四、查阅官方手册避坑指南与常见问题
很多开发者在阅读文档时常常会因为细节疏漏产生困惑,以下是必须注意的典型陷阱:
1. 警惕版本割裂(Python 2 遗留与小版本新增)
搜索引擎有时会将权重极高的 Python 2.7 文档排在前列。若 URL 中包含 /2.7/,请立即停止阅读并切换到 /3/。此外,即使在 Python 3 内部,不同次版本也有关键区别。例如内置字典保持插入顺序在 3.6 是实现细节,在 3.7+ 成为语言规范;类型联合操作符 | 直到 Python 3.10 才被引入。若生产环境为 3.8,查阅 3.12 的文档时一定要看方法下方的 New in version 3.10 标签。
2. 辨析高层接口与底层协议
Python 库通常提供面向普通开发者的“高级便利接口”和面向底层扩展的“底层原始接口”。例如:
- 在执行外部命令时,应优先查阅
subprocess.run(),只有在需要管道重定向或异步流式交互时才需要研究subprocess.Popen。 - 在操作路径时,应优先查阅
pathlib.Path的对象方法,而非分散在os与os.path中的老式字符串函数。
3. 注意 Availability 平台限制声明
Python 是跨平台语言,但标准库部分模块底层依赖特定操作系统的系统调用(如 select.epoll 仅限 Linux,os.fork 不支持原生 Windows)。在查看对应函数定义时,若标题旁有显著的 Availability: Unix 标牌,说明该代码无法直接在跨平台脚本中使用,应提前考虑替代方案。
五、总结:高效查阅思维脑图与速查清单
建立高效查阅习惯的过程,本质上是从“被动搜索碎片答案”转向“主动通过权威手册建立系统认知”的过程。下方的总结脑图梳理了本文的核心要点:
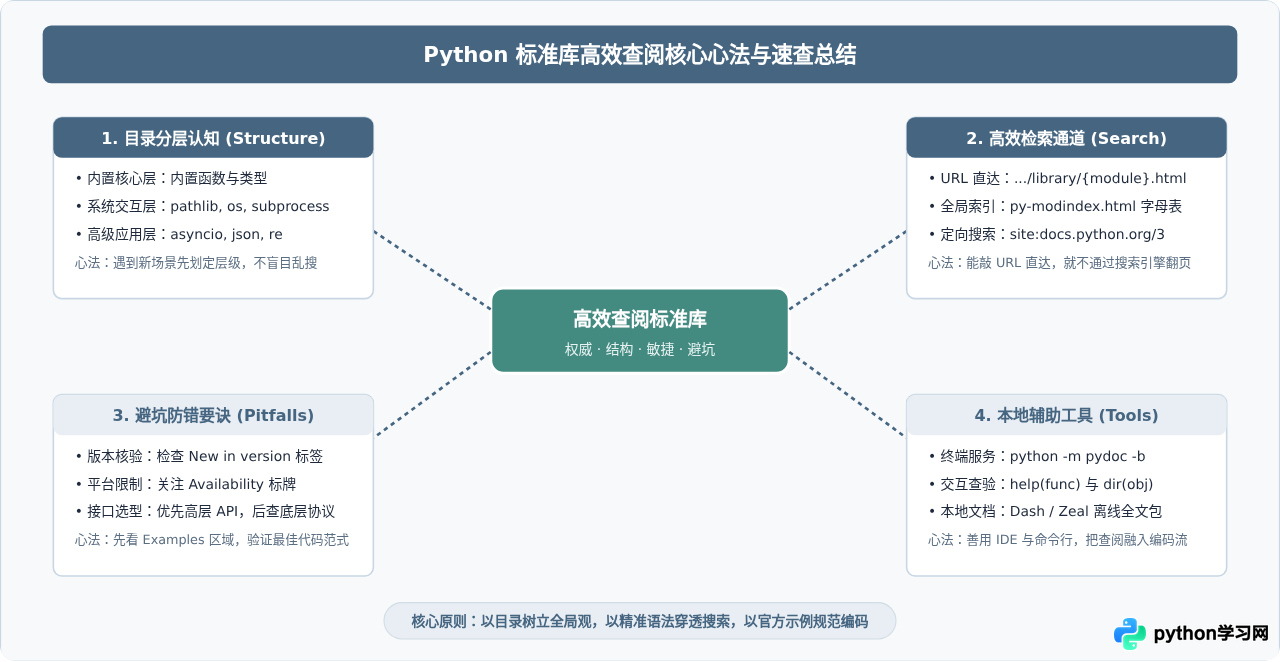
日常开发中,熟练运用以上方法,不仅能让你在几秒钟内定位到所需函数的准确规范与示例代码,更能培养直接从权威一手资料获取技术解答的良好工程习惯。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









