Python常用的50个第三方库清单:按Web、数据与AI领域分类

白榆
白榆
发布时间:2026-11-10| 15人浏览过
原创

按Web开发、数据处理与计算、人工智能与大模型三大领域分类整理的Python常用的50个第三方库实用清单。包含每个库的核心职责、典型场景、选型对比与代码示例,助您快速搭建高效技术栈。

一、Web 开发与网络服务领域常用库(16个)

在 Web 服务端开发中,Python 覆盖了从全功能后台、现代化异步微服务、契约化接口校验,到底层网络并发与海量爬虫提取的完整闭环。本节精选的 16 个库构成了 Python 在服务端与网络层的主要技术骨架。

Python常用的50个第三方库清单:按Web、数据与AI领域分类
图 1:Web 技术栈分层架构与网络请求流转协同机制

1. Django 全功能全栈框架

定位与核心功能:遵循“电池全包(Batteries-Included)”理念的企业级 Web 框架,提供开箱即用的 ORM、后台管理界面(Django Admin)、用户认证系统(Auth)、表单处理与 CSRF/SQL注入安全防护。

典型场景:企业管理系统(CMS/OA)、内容平台、需快速验证业务并自带管理后台的中大型项目。

# 安装命令:pip install django from django.http import JsonResponse from django.urls import path def hello_api(request): return JsonResponse({"status": "ok", "framework": "Django"}) urlpatterns = [path("api/hello/", hello_api)]

选型注意:架构相对重型,内置 ORM 在处理千万级深度关联时调优复杂,更适合标准业务场景。

2. Flask 极简轻量微框架

定位与核心功能:基于 Werkzeug 和 Jinja2 的微框架,内核仅保留路由、请求上下文与模板渲染,其余数据库、认证等能力完全交由插件自主组合。

典型场景:轻量级微服务、内部运维脚本工具、小型单体应用原型。

# 安装命令:pip install flask from flask import Flask, jsonify app = Flask(__name__) @app.route("/api/ping") def ping(): return jsonify({"message": "pong", "framework": "Flask"}) if __name__ == "__main__": app.run(port=5000)

选型注意:由于没有固定目录约束,大型团队协作若无统一规范,易导致代码风格混乱。

3. FastAPI 现代化异步API框架

定位与核心功能:基于 Starlette 和 Pydantic 的现代化高性能 API 框架。原生支持 Python 3.8+ 类型提示,提供自动 OpenAPI/Swagger 接口文档生成和强大的异步并发能力。

典型场景:微服务 RESTful API、前后端分离后端、AI 模型推理接口服务。

# 安装命令:pip install "fastapi[all]" from fastapi import FastAPI from pydantic import BaseModel app = FastAPI(title="Demo API") class Item(BaseModel): name: str price: float @app.post("/items/") async def create_item(item: Item): return {"status": "created", "data": item.dict()}

选型优势:开发效率极高,内置类型转换与参数拦截,是目前新微服务项目的首选。

4. Tornado 异步网络与长连接

定位与核心功能:非阻塞网络 I/O 驱动的 Web 框架和异步网络服务器,能在单进程内维持数万并发长连接。

典型场景:WebSocket 双向长连接服务、实时消息推送网关、高并发长轮询应用。

# 安装命令:pip install tornado import tornado.ioloop import tornado.web class MainHandler(tornado.web.RequestHandler): def get(self): self.write({"message": "Hello from Tornado"}) def make_app(): return tornado.web.Application([(r"/", MainHandler)]) if __name__ == "__main__": app = make_app() app.listen(8888) tornado.ioloop.IOLoop.current().start()

选型注意:随着标准库 asyncio 与 ASGI 生态成熟,普通 HTTP 接口开发已逐步让位于 FastAPI。

5. Requests 人性化HTTP客户端

定位与核心功能:“HTTP for Humans”,Python 生态使用最广泛的同步 HTTP 请求库,封装了底层 urllib3,支持优雅的会话保持(Session)、连接池、Cookie 和证书处理。

典型场景:第三方 REST 接口调用、常规爬虫采集、自动化部署脚本请求。

# 安装命令:pip install requests import requests with requests.Session() as session: resp = session.get("https://httpbin.org/get", params={"source": "test"}, timeout=5) if resp.status_code == 200: data = resp.json() print("Origin IP:", data.get("origin"))

选型注意:基于同步阻塞 I/O,在大批量并发网络调用场景下需结合线程池或改用异步客户端。

6. httpx 下一代异步HTTP客户端

定位与核心功能:完全兼容 Requests 接口风格的新一代客户端,原生提供标准的 async/await 异步客户端,并支持 HTTP/2 协议。

典型场景:FastAPI/异步服务内的外部微服务调用、高吞吐爬虫、HTTP/2 多路复用场景。

# 安装命令:pip install httpx import httpx import asyncio async def fetch(): async with httpx.AsyncClient(http2=True) as client: resp = await client.get("https://httpbin.org/get") print("Status:", resp.status_code) asyncio.run(fetch())

选型优势:平滑迁移现有 Requests 认知,同时享受异步高并发与 HTTP/2 性能红利。

7. aiohttp 异步HTTP全能框架

定位与核心功能:基于 asyncio 的异步 HTTP 客户端与服务端实现,擅长管理高并发网络连接会话。

典型场景:高并发异步网络爬虫、网关代理转发、轻量级异步内部服务器。

# 安装命令:pip install aiohttp import aiohttp import asyncio async def download_all(urls): async with aiohttp.ClientSession() as session: tasks = [session.get(url) for url in urls] responses = await asyncio.gather(*tasks) return [r.status for r in responses]

选型注意:API 细节相对丰富,Session 对象在退出时必须显式调用关闭,避免资源泄露。

8. Celery 分布式任务队列

定位与核心功能:基于分布式消息传递的异步任务队列,支持 Redis、RabbitMQ 等消息中间件,具备任务重试、流量控制、定时调度(Beat)与结果存储能力。

典型场景:耗时操作解耦(邮件短信发送、大文件导入导出、图片转码)、离线批处理作业。

# 安装命令:pip install "celery[redis]" from celery import Celery app = Celery("tasks", broker="redis://localhost:6379/0") @app.task def process_data(user_id): return f"User {user_id} processed successfully"

选型注意:需独立维护 Broker 与 Worker 进程集群,监控建议搭配 Flower 面板使用。

9. SQLAlchemy 工业级ORM与SQL工具

定位与核心功能:Python 事实上的数据库工业标准工具包,分为 Core(表达性 SQL 抽象层与连接池)与 ORM(基于 Unit-of-Work 模式的高阶对象映射)。2.0+ 版本全面支持原生异步。

典型场景:中大型企业复杂关系型数据库建模、多数据源连接管理、跨数据库引擎兼容系统。

# 安装命令:pip install sqlalchemy from sqlalchemy import create_engine, Column, Integer, String from sqlalchemy.orm import declarative_base, sessionmaker Base = declarative_base() class User(Base): __tablename__ = "users" id = Column(Integer, primary_key=True) name = Column(String(50)) engine = create_engine("sqlite:///app.db") Base.metadata.create_all(engine)

选型优势:高度完备,不仅解决基础 CRUD,更能安全掌控极其复杂的分析与联表 SQL。

10. Peewee 轻巧易用ORM

定位与核心功能:轻量、富有表现力的 Python ORM,设计原则是简单小巧、零过度抽象,几分钟内即可融入项目。

典型场景:SQLite 嵌入式应用、快速敏捷脚本、中小型桌面程序或独立工具。

# 安装命令:pip install peewee from peewee import SqliteDatabase, Model, CharField db = SqliteDatabase("lite.db") class Note(Model): content = CharField() class Meta: database = db db.connect() db.create_tables([Note]) Note.create(content="Quick record")

选型注意:对于复杂多表关联、多库事务与高并发连接池控制,表现力不及 SQLAlchemy。

11. Pydantic 数据校验与类型契约

定位与核心功能:基于标准类型注解的数据校验与设置管理库。V2 版本使用 Rust(pydantic-core)重写,性能较 V1 提升 5-20 倍。

典型场景:API 入参严格校验、配置项自动映射(pydantic-settings)、微服务实体契约定义。

# 安装命令:pip install pydantic from pydantic import BaseModel, EmailStr, Field class Account(BaseModel): username: str = Field(min_length=3, max_length=20) email: EmailStr is_active: bool = True account = Account(username="antigravity", email="dev@example.com") print(account.model_dump_json())

选型优势:已成为现代 Python 生态(FastAPI、LangChain 等)通用的数据模型基石。

12. BeautifulSoup4 (bs4) 网页DOM解析

定位与核心功能:专为从 HTML/XML 文件中提取数据设计的解析库,可搭配 lxml 或 html.parser,提供容错性极高的树形导航与标签检索。

典型场景:静态页面抓取、网页文本清洗、XML 配置文件数据抽取。

# 安装命令:pip install beautifulsoup4 lxml from bs4 import BeautifulSoup html = "<div class='content'><h2>Article Title</h2><p>Article body...</p></div>" soup = BeautifulSoup(html, "lxml") title = soup.find("h2").get_text() print("Parsed Title:", title)

选型注意:纯 Python 提取层;如果是动态 JavaScript 渲染页面,需搭配 Playwright 或 Selenium。

13. Scrapy 工业级爬虫框架

定位与核心功能:工业级高并发网络抓取框架,基于 Twisted 异步事件驱动,内置 Spider、Downloader Middleware、Item Pipeline 与调度器架构。

典型场景:全网级大规模结构化数据爬取、垂直电商/舆情监控系统。

# 安装命令:pip install scrapy import scrapy class QuoteSpider(scrapy.Spider): name = "quotes" start_urls = ["https://quotes.toscrape.com/"] def parse(self, response): for quote in response.css("div.quote"): yield {"text": quote.css("span.text::text").get()}

选型优势:自带限速、重试、缓存机制与流水线持久化,免去重复编写轮子的成本。

14. Playwright (Python) 现代无头浏览器自动化

定位与核心功能:微软出品的新一代跨浏览器自动化库,支持 Chromium、Firefox 和 WebKit。具备自动等待机制、网络拦截和极高执行速度。

典型场景:单页应用(SPA)动态渲染抓取、现代 Web 自动化测试、自动化截图与 PDF 生成。

# 安装命令:pip install playwright && playwright install from playwright.sync_api import sync_playwright with sync_playwright() as p: browser = p.chromium.launch(headless=True) page = browser.new_page() page.goto("https://httpbin.org") print("Page Title:", page.title()) browser.close()

选型优势:彻底告别传统 Selenium 的“固定 sleep 等待”和繁琐 Driver 匹配,极为稳定可靠。

15. Selenium 经典浏览器驱动测试

定位与核心功能:历史最悠久、企业级支持最广泛的浏览器自动化标准,使用 W3C WebDriver 协议直接操控物理浏览器。

典型场景:企业存量自动化 UI 回归测试、特殊环境(IE兼容模式/受限内网)自动化。

# 安装命令:pip install selenium from selenium import webdriver options = webdriver.ChromeOptions() options.add_argument("--headless") driver = webdriver.Chrome(options=options) driver.get("https://httpbin.org") print(driver.title) driver.quit()

选型注意:对于新启动的项目,Playwright 在 API 现代化程度和稳定性上普遍更占优势。

16. WebSockets 双向实时通信协议

定位与核心功能:构建在 asyncio 之上的专用 WebSocket 协议库,注重简洁、正确与鲁棒的 RFC 6455 协议实现。

典型场景:金融行情实时广播、在线协作白板、即时通讯服务端开发。

# 安装命令:pip install websockets import asyncio import websockets async def echo(websocket): async for message in websocket: await websocket.send(f"Echo: {message}") async def main(): async with websockets.serve(echo, "localhost", 8765): await asyncio.Future()

选型优势:零冗余依赖,协议解析严谨,是构建轻量实时管道的利器。

二、数据处理、分析与科学计算领域常用库(18个)

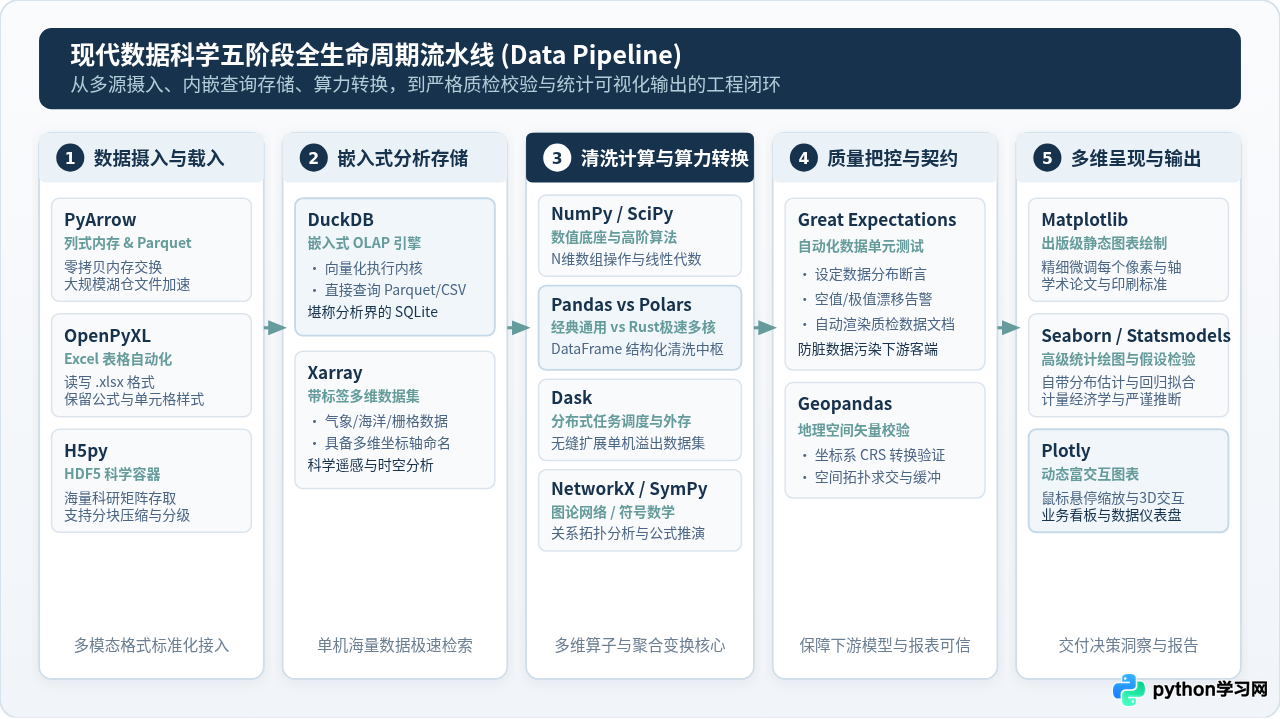
数据是 Python 真正统治工业与科研界的核心战场。从最底层的 C/Rust 列式内存存储、结构化数据清洗,到高级微积分优化、地理时空计算与自动化数据质量守卫,以下 18 个库协同构成了现代数据工程的完整流水线。
Python常用的50个第三方库清单:按Web、数据与AI领域分类
图 2:数据科学与工程五阶段全生命周期流水线 (Data Pipeline)

17. NumPy 科学计算多维数组基石

定位与核心功能:提供高性能 N 维数组对象(ndarray)及广播机制、矩阵算子与随机数生成。是后续 Pandas、SciPy、PyTorch 等一切数据科学库的共同物理基底。

典型场景:向量化数值运算、线性代数底层计算、图像像素矩阵操作。

# 安装命令:pip install numpy import numpy as np arr = np.array([[1, 2, 3], [4, 5, 6]]) # 向量化无循环加权求和 result = np.sum(arr * 2.5, axis=1) print("Row Sums:", result)

选型注意:由于底层是连续 C 内存块,避免在循环中频繁对 array 进行追加拼接(append),应预先分配空间。

18. Pandas 结构化表格分析瑞士军刀

定位与核心功能:数据分析领域无人不知的标准库,核心为 DataFrame 和 Series 结构,提供强大的分组聚合(groupby)、时序索引、数据透视与缺失值清洗能力。

典型场景:商业智能(BI)数据报表清洗、探索性数据分析(EDA)、特征工程前置处理。

# 安装命令:pip install pandas import pandas as pd df = pd.DataFrame({ "dept": ["IT", "Sales", "IT", "HR"], "salary": [12000, 9500, 15000, 8000] }) avg_salary = df.groupby("dept")["salary"].mean().reset_index() print(avg_salary)

选型注意:基于单线程执行且内存占用常为原始 CSV 的 3-5 倍;当数据达到几 GB 以上时,建议改用 Polars 或 DuckDB。

19. Polars Rust极速多线程DataFrame

定位与核心功能:由 Rust 编写的新一代 DataFrame 库,基于 Apache Arrow 列式内存规范,原生支持多核 CPU 并发、惰性执行(LazyFrame)与查询计划自动优化。

典型场景:千万级至上亿行单机数据极速清洗、内存受限环境的高性能批处理。

# 安装命令:pip install polars import polars as pl # 惰性执行:自动谓词下推与列投影优化 lazy_query = ( pl.scan_csv("large_data.csv") .filter(pl.col("amount") > 100) .group_by("category") .agg(pl.col("amount").sum().alias("total_sales")) )

选型优势:执行速度较传统 Pandas 常有 5-20 倍提升,且内存释放及时,是目前数据处理领域的最强黑马。

20. SciPy 高级数学与工程算法

定位与核心功能:基于 NumPy 的工程算法集,涵盖数值积分(integrate)、最优化求解(optimize)、信号处理(signal)和统计分布(stats)。

典型场景:物理仿真建模、曲线拟合、参数极值优化、假设检验检验量计算。

# 安装命令:pip install scipy from scipy import optimize # 寻找目标函数极小值 result = optimize.minimize(lambda x: (x - 3)**2 + 5, x0=[0.0]) print("Optimal x:", result.x[0])

选型优势:底层为成熟的 Fortran/C 高度优化数学库,数值计算稳定性与精度极佳。

21. Matplotlib 经典2D可视化底层

定位与核心功能:Python 可视化生态的宗师级库,提供类似于 MATLAB 的面向对象绘图接口,支持精确控制图表每个像素、图层与刻度样式。

典型场景:科研学术论文插图制作、标准静态图表生成、离线 PDF 报表渲染。

# 安装命令:pip install matplotlib import matplotlib.pyplot as plt fig, ax = plt.subplots(figsize=(6, 3)) ax.plot([1, 2, 3, 4], [10, 20, 25, 30], marker="o", color="#17324D") ax.set_title("Performance Trend") fig.savefig("trend.png") plt.close(fig)

选型注意:代码偏底层且繁琐,日常统计绘图建议优先使用更高层的 Seaborn。

22. Seaborn 统计数据可视化

定位与核心功能:基于 Matplotlib 的高级统计绘图库,紧密集成 Pandas DataFrame,几行代码即可绘制复杂的分布直方图、箱线图、热力图与成对关系图。

典型场景:数据探索与统计建模前置相关性分析、变量分布探查。

# 安装命令:pip install seaborn import seaborn as sns import pandas as pd df = pd.DataFrame({"cat": ["A", "B", "A", "B"], "val": [10, 15, 12, 18]}) sns.boxplot(x="cat", y="val", data=df)

选型优势:内置现代美学配色方案,自动完成置信区间估计与离群点标记。

23. Plotly (plotly.py) 交互式动态Web图表

定位与核心功能:基于 Plotly.js 的交互式可视化库,原生输出 HTML+JavaScript,支持缩放、平移、悬停提示(Tooltip)与 3D 图形交互。

典型场景:企业业务看板、数据分析报告交付、Streamlit/Dash 可视化大屏开发。

# 安装命令:pip install plotly import plotly.express as px df = px.data.iris() fig = px.scatter(df, x="sepal_width", y="sepal_length", color="species", title="Iris Scatter Plot")

选型优势:免除前端开发成本即可将图表转化为高沉浸感的用户可操作报表。

24. OpenPyXL Excel自动化读写

定位与核心功能:专门读写 Excel 2010+ xlsx/xlsm 格式的 Python 库,能够完整保留和修改工作表公式、单元格样式、边框与批注。

典型场景:办公自动化、财务报表批量生成、复杂格式 Excel 模板填充。

# 安装命令:pip install openpyxl from openpyxl import Workbook wb = Workbook() ws = wb.active ws.title = "Financial Report" ws["A1"] = "Revenue" ws["B1"] = 100000 wb.save("report.xlsx")

选型注意:对于纯数值的大批量数据导入导出,使用 Pandas/Polars 配合 CSV 或 Parquet 速度更快。

25. PyArrow 列式内存标准与Parquet

定位与核心功能:Apache Arrow 的 Python 绑定,提供高效的跨语言内存列式格式,以及极速的 Parquet/Feather 文件读写与零拷贝内存共享机制。

典型场景:现代湖仓文件格式互通、大规模中间数据持久化、分布式引擎通信。

# 安装命令:pip install pyarrow import pyarrow as pa import pyarrow.parquet as pq table = pa.Table.from_arrays([pa.array([1, 2, 3])], names=["id"]) pq.write_table(table, "data.parquet", compression="snappy")

选型优势:Parquet 压缩比远超 CSV,且具备列裁剪与统计下推特性,是现代数据流水线的标配存储格式。

26. DuckDB (Python API) 嵌入式OLAP分析引擎

定位与核心功能:“分析型数据库中的 SQLite”,单文件嵌入式运行,基于向量化执行引擎,可直接用标准 SQL 高性能查询 CSV、Parquet 及 Pandas/Polars 对象。

典型场景:单机复杂 SQL 分析、微型数仓、轻量级 ETL 流水线搭建。

# 安装命令:pip install duckdb import duckdb # 直接在 SQL 中即席分析 Parquet 文件 sql = "SELECT count(*), avg(salary) FROM 'staff_*.parquet' WHERE age > 25" res = duckdb.query(sql).fetchall()

选型优势:零服务端部署,无需启动复杂集群即可体验每秒扫描千万行数据的分析快感。

27. Dask 分布式扩展与外存计算

定位与核心功能:灵活的并行计算库,提供与 NumPy、Pandas 几乎完全一致的 API(Dask DataFrame / Array),利用动态任务图将计算调度到多核或集群上,解决“数据量大于物理内存(Out-of-Core)”的难题。

典型场景:百 GB 级单机超限数据清洗、私有服务器集群分布式计算。

# 安装命令:pip install "dask[dataframe]" import dask.dataframe as dd ddf = dd.read_csv("data_*.csv") mean_val = ddf["amount"].mean().compute()

选型注意:对于纯单机多核场景,Polars 的内存效率通常高于 Dask;Dask 更擅长集群级伸缩。

28. Statsmodels 统计建模与计量经济学

定位与核心功能:专注于严谨统计模型估计与推断的科学库,涵盖普通最小二乘法(OLS)、广义线性模型(GLM)、时间序列分析(ARIMA/SARIMAX)与全面假设检验。

典型场景:因果推断、经济计量分析、时间序列平稳性检验(ADF Test)。

# 安装命令:pip install statsmodels import statsmodels.api as sm import numpy as np X = sm.add_constant(np.array([1, 2, 3, 4])) y = np.array([2, 3.8, 6.1, 8.2]) model = sm.OLS(y, X).fit() # print(model.summary())

选型优势:相比纯预测导向的 scikit-learn,Statsmodels 更注重参数的可解释性与统计显著性。

29. SymPy 符号数学代数计算

定位与核心功能:全功能纯 Python 编写的计算机代数系统(CAS),能够执行符号微积分求导、定积分求解、方程精确解析解推导及矩阵符号运算。

典型场景:算法公式推导验证、数学建模科研、物理学理论符号求解。

# 安装命令:pip install sympy from sympy import symbols, diff, sin x = symbols("x") expr = sin(x) * x**2 derivative = diff(expr, x) print("Derivative:", derivative)

选型优势:给出绝对精确的解析解,彻底避免浮点数精度漂移困扰。

30. NetworkX 复杂网络图论分析

定位与核心功能:图论与复杂网络分析专用库,内置最短路径(Dijkstra)、PageRank、中心度计算、社区发现算法等核心图论算法。

典型场景:社交网络拓扑分析、知识图谱关系推理、风控反洗钱团伙挖掘。

# 安装命令:pip install networkx import networkx as nx G = nx.Graph() G.add_edge("UserA", "UserB", weight=1.5) G.add_edge("UserB", "UserC", weight=2.0) path = nx.shortest_path(G, "UserA", "UserC") print("Shortest Path:", path)

选型注意:纯 Python 结构适合中小规模图分析;千万节点以上图谱建议结合图数据库或 GPU 加速方案。

31. Geopandas 地理空间矢量数据分析

定位与核心功能:将 Pandas 的表格能力扩展至地理空间数据,封装了 Shapely 几何引擎、Fiona 文件驱动与 PyPROJ 坐标系转换系统,核心对象为 GeoDataFrame。

典型场景:GIS 地图空间求交计算、行政区划热力图绘制、物流配送网格划分。

# 安装命令:pip install geopandas import geopandas as gpd from shapely.geometry import Point gdf = gpd.GeoDataFrame({"city": ["Beijing"]}, geometry=[Point(116.40, 39.90)], crs="EPSG:4326") gdf_proj = gdf.to_crs(epsg=3857)

选型优势:让地理空间分析完全融入标准数据科学栈,极大降低 GIS 学习门槛。

32. H5py HDF5大规模科学数据存取

定位与核心功能:HDF5(Hierarchical Data Format 5)二进制文件格式的官方 Python 接口,支持在磁盘上像字典一样组织多级数据集,并按需进行分块切片读写。

典型场景:大规模实验传感器采样数据、深度学习大矩阵预处理暂存、神经电生理与雷达数据管理。

# 安装命令:pip install h5py import h5py import numpy as np with h5py.File("experiment.h5", "w") as f: dset = f.create_dataset("sensor_1", data=np.zeros((1000, 1000)), compression="gzip") dset[0, :10] = 42.0

选型优势:支持跨语言大文件存储,无需一次性将数十 GB 文件载入内存即可实现高效切片。

33. Xarray 带标签多维时空栅格数据

定位与核心功能:类似于“带有坐标轴维度名称的 N 维 NumPy 数组”,无缝打通 NetCDF、HDF5 与 Zarr 格式,并与 Dask/Pandas 原生协同。

典型场景:气象预报、卫星遥感多光谱栅格、海洋洋流时空四维连续模拟。

# 安装命令:pip install xarray import xarray as xr import numpy as np ds = xr.Dataset( {"temp": (["lat", "lon"], np.random.rand(10, 10))}, coords={"lat": np.linspace(20, 30, 10), "lon": np.linspace(100, 110, 10)} ) sub = ds.sel(lat=slice(22, 28))

选型优势:彻底告别记错多维数组索引位置(如到底是 axis=0 还是 axis=2)的困境。

34. Great Expectations 数据质量与契约校验

定位与核心功能:现代数据工程自动化质检事实标准。通过声明式断言(Expectations)对数据分布、唯一性、空值率与范围进行管道式持续验证,并自动渲染 HTML 质检报告。

典型场景:生产级 ETL 质检卡点(防止脏数据流入下游模型)、数仓上游数据契约保障。

# 安装命令:pip install great_expectations # 核心思想:声明断言规则 # validator.expect_column_values_to_not_be_null("user_id") # validator.expect_column_values_to_be_between("age", min_value=0, max_value=120)

选型优势:让数据团队像软件工程编写单测一样对待数据质量,从源头杜绝线上数据污染事故。

三、人工智能、机器学习与大模型领域常用库(16个)

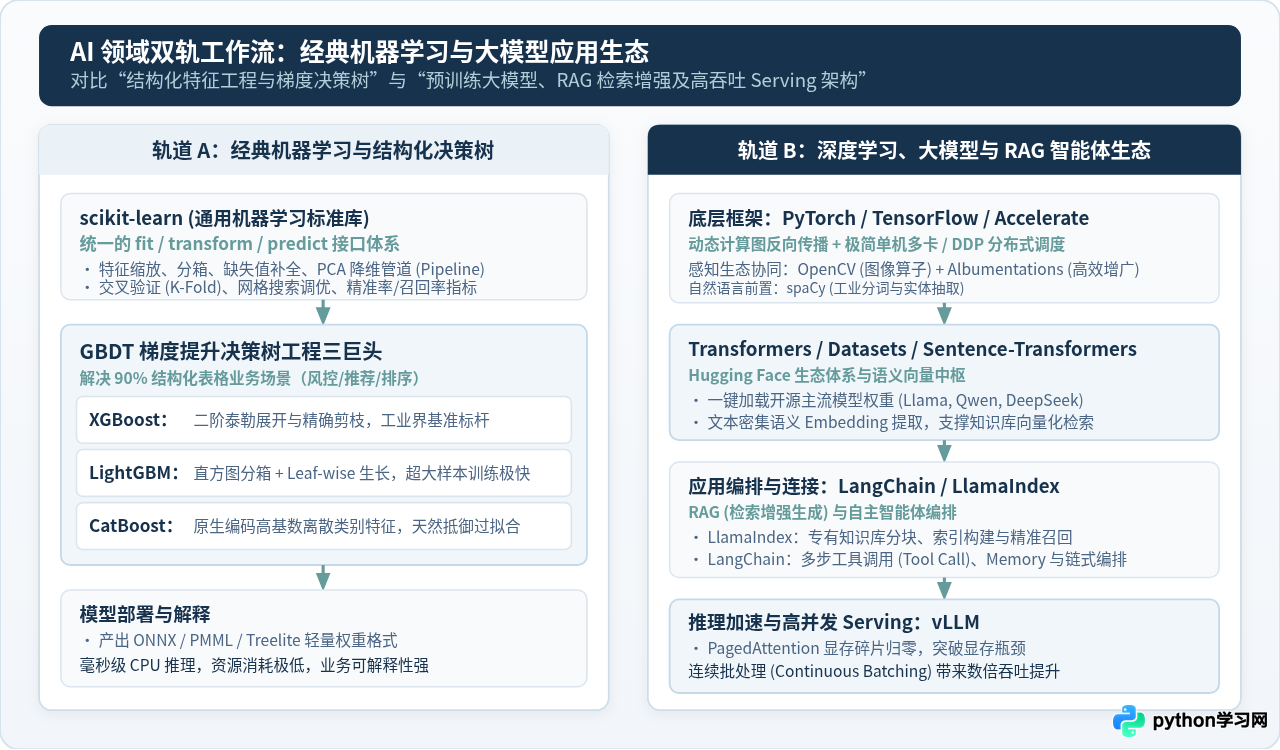
随着深度学习与大语言模型(LLM)的全面普及,AI 领域的软件栈经历了翻天覆地的迭代。如今的架构不仅包含传统的表格梯度提升算法与基础深度学习框架,更形成了覆盖 Hugging Face 生态、RAG 向量检索编排、以及前沿 vLLM 高并发推理引擎的全栈体系。
Python常用的50个第三方库清单:按Web、数据与AI领域分类
图 3:人工智能与机器学习双轨工程架构图:经典算法与大模型生态协同

35. PyTorch 深度学习主流框架

定位与核心功能:由 Meta 主导的动态计算图(Dynamic Computation Graph)深度学习框架。凭借 Pythonic 的接口风格、强大的自动微分机制(autograd)和极佳的调试体验,已成为全球科研界与工业界最主流的底层框架。

典型场景:计算机视觉、自然语言处理、多模态前沿模型预训练与微调。

# 安装命令:pip install torch torchvision import torch import torch.nn as nn class MLP(nn.Module): def __init__(self): super().__init__() self.net = nn.Sequential(nn.Linear(128, 64), nn.ReLU(), nn.Linear(64, 2)) def forward(self, x): return self.net(x) x = torch.randn(8, 128) model = MLP() out = model(x) print("Output Shape:", out.shape)

选型优势:生态活跃度无出其右,几乎所有最新的 AI 论文与开源权重均首选 PyTorch 源码发布。

36. TensorFlow 工业级端到端平台

定位与核心功能:由 Google 开源的端到端机器学习平台,具备完备的模型导出(SavedModel)、移动端轻量化(TFLite)与高并发工业部署服务(TF Serving)。高层接口为 Keras。

典型场景:企业老牌工业推荐排序模型系统、大规模移动端嵌入式设备部署。

# 安装命令:pip install tensorflow import tensorflow as tf from tensorflow import keras model = keras.Sequential([ keras.layers.Dense(64, activation='relu', input_shape=(128,)), keras.layers.Dense(1, activation='sigmoid') ]) model.compile(optimizer='adam', loss='binary_crossentropy')

选型注意:新学术研究与大模型领域使用率有所放缓,但其生产部署稳定性依然受到工业界认可。

37. scikit-learn 经典机器学习通用标准

定位与核心功能:Python 经典机器学习事实标准,封装了分类、回归、聚类(K-Means)、降维(PCA)以及特征工程标准化、交叉验证评估标准工具链。

典型场景:基准模型(Baseline)快速验证、特征筛选管道构建、传统中小型数据集建模。

# 安装命令:pip install scikit-learn from sklearn.datasets import load_iris from sklearn.model_selection import train_test_split from sklearn.ensemble import RandomForestClassifier X, y = load_iris(return_X_y=True) X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42) clf = RandomForestClassifier(n_estimators=50).fit(X_train, y_train) print("Test Accuracy:", clf.score(X_test, y_test))

选型优势:极其优美的 Pipeline API 规范,彻底规避了训练集与测试集间的数据穿越风险。

38. XGBoost 梯度提升决策树工业标杆

定位与核心功能:可扩展的端到端梯度提升系统(GBDT),对目标函数进行了二阶泰勒展开,并结合正则项与列抽样,树分裂剪枝极具鲁棒性。

典型场景:Kaggle 等数据竞赛金牌方案、金融风控信用评分、电商搜索排序。

# 安装命令:pip install xgboost import xgboost as xgb from sklearn.datasets import make_classification X, y = make_classification(n_samples=1000, n_features=20) model = xgb.XGBClassifier(n_estimators=100, max_depth=5, learning_rate=0.1) model.fit(X, y)

选型优势:结构化表格数据领域的统治级算法,准确率极高且自带特征重要性评估机制。

39. LightGBM 高性能轻量级直方图提升树

定位与核心功能:微软开源的高效梯度提升框架,采用基于直方图(Histogram)的分箱算法和带深度限制的单侧叶子生长策略(Leaf-wise with depth limit)。

典型场景:超大规模结构化表格数据离线/实时训练、高维稠密特征广告点击率(CTR)预估。

# 安装命令:pip install lightgbm import lightgbm as lgb from sklearn.datasets import make_classification X, y = make_classification(n_samples=1000, n_features=20) gbm = lgb.LGBMClassifier(n_estimators=100, num_leaves=31) gbm.fit(X, y)

选型优势:训练速度比原生 XGBoost 快数倍,内存占用低,非常适合大数据量下的快速迭代调优。

40. CatBoost 专攻高基数类别特征

定位与核心功能:Yandex 开源的梯度提升决策树,核心优势在于原生高效编码高基数离散类别特征(Categorical Features),并采用对称树(Oblivious Trees)防止预测过拟合。

典型场景:包含海量类别字段(如城市、用户 ID、行业标签)的表格建模与预测任务。

# 安装命令:pip install catboost from catboost import CatBoostClassifier cb = CatBoostClassifier(iterations=100, verbose=0) cb.fit([[1, "北京"], [2, "上海"], [3, "北京"]], [0, 1, 0], cat_features=[1])

选型优势:免去繁琐的人工类别特征 One-Hot 或 Target-Encoding,默认参数即具备极佳泛化能力。

41. Hugging Face Transformers 预训练大模型核心生态

定位与核心功能:当今 AI 生态使用最广泛的大模型中枢库,统一抽象了 AutoModel、AutoTokenizer 与 Pipeline 接口,支持数千种开源主流架构(Llama、Qwen、BERT、Whisper 等)。

典型场景:大模型离线推理、前沿开源模型权重加载、下游微调(PEFT/LoRA)。

# 安装命令:pip install transformers from transformers import AutoTokenizer, AutoModelForCausalLM tokenizer = AutoTokenizer.from_pretrained("Qwen/Qwen2.5-0.5B") # model = AutoModelForCausalLM.from_pretrained("Qwen/Qwen2.5-0.5B")

选型优势:真正消除了各家开源模型代码接口不兼容的痛点,几行代码即可切换基座模型。

42. Datasets (Hugging Face) 大规模AI语料流式处理

定位与核心功能:专为 AI 训练打造的轻量高效数据集库,底层依托 Apache Arrow 实现零拷贝内存映射与流式读取(Streaming),避免几百 GB 语料撑爆内存。

典型场景:大语言模型预训练语料预处理、Tokenization 分词映射、模型微调数据加载。

# 安装命令:pip install datasets from datasets import load_dataset # 流式加载超大在线语料库,不占用本地大容量磁盘 dataset = load_dataset("imdb", split="train", streaming=True) sample = next(iter(dataset)) print("Sample Label:", sample["label"])

选型优势:自带高效的多进程缓存机制,大幅缩短模型训练前的数据预处理耗时。

43. Accelerate 极简分布式训练工具

定位与核心功能:Hugging Face 出品的 PyTorch 分布式简化工具,无需重写复杂的 DDP(Distributed Data Parallel)底层通信代码,即可一键在单机单卡、多卡、TPU 或混合精度(FP16/BF16)间平滑切换。

典型场景:自研深度学习模型多卡训练、大模型 LoRA 显存优化加速微调。

# 安装命令:pip install accelerate from accelerate import Accelerator accelerator = Accelerator() # model, optimizer, dataloader = accelerator.prepare(model, optimizer, dataloader)

选型优势:极大简化分布式样板代码,让研究人员专注于模型架构本身。

44. LangChain 大语言模型应用编排

定位与核心功能:LLM 时代的框架中枢,通过 LCEL(LangChain Expression Language)提供提示词模板管理、输出解析器、工具调用(Tool Calling)与自主智能体(Agent)状态链编排。

典型场景:多步骤复杂 Agent 流程、自动化工作流编排、企业多大模型网关路由。

# 安装命令:pip install langchain langchain-core from langchain_core.prompts import PromptTemplate prompt = PromptTemplate.from_template("Translate the following {tech} term into Chinese: {term}") formatted = prompt.format(tech="Python", term="List Comprehension") print(formatted)

选型注意:框架迭代迅速,部分封装层次较深;简单任务可直接原生调用模型 API,复杂智能体推荐结合 LangGraph。

45. LlamaIndex 专业RAG数据连接框架

定位与核心功能:专为检索增强生成(RAG)打造的数据连接器框架,涵盖多格式文档切片(Chunking)、元数据提取、语义与关键词混合检索(Hybrid Search)以及重排(Rerank)。

典型场景:企业私有知识库问答、本地技术文档检索机器人、多源数据上下文增强。

# 安装命令:pip install llama-index from llama_index.core import VectorStoreIndex, Document documents = [Document(text="Python 3.13 introduces experimental free-threaded mode.")] index = VectorStoreIndex.from_documents(documents) query_engine = index.as_query_engine()

选型优势:在数据索引构建、检索策略与召回精度控制上比通用框架更加专注深入。

46. vLLM 高吞吐大模型推理加速引擎

定位与核心功能:伯克利团队开源的高吞吐高并发大模型推理和服务引擎,首创 PagedAttention 机制消除 KV Cache 显存碎片,搭配连续批处理(Continuous Batching),吞吐量达到传统 Hugging Face 接口的 5-10 倍。

典型场景:高并发生产级私有大模型 API 服务化部署、低延迟企业级推理网关。

# 安装命令:pip install vllm (需 CUDA 环境) from vllm import LLM, SamplingParams sampling_params = SamplingParams(temperature=0.7, top_p=0.95, max_tokens=100) # llm = LLM(model="Qwen/Qwen2.5-7B-Instruct")

选型优势:已成为开源大模型 Serving 的生产事实标准,自带极佳的显存利用率与并发处理能力。

47. OpenCV (opencv-python) 计算机视觉工业标准

定位与核心功能:计算机视觉领域的元老级底层库,提供图像几何变换、颜色空间转换、边缘检测、图像形态学与视频流逐帧捕获处理。

典型场景:摄像头实时视频流分析、模型输入图像预处理、工业质检视觉缺陷检测。

# 安装命令:pip install opencv-python import cv2 import numpy as np img = np.zeros((200, 400, 3), dtype=np.uint8) cv2.putText(img, "Vision Core", (50, 100), cv2.FONT_HERSHEY_SIMPLEX, 1, (255, 255, 255), 2)

选型注意:OpenCV 默认图像通道顺序为 BGR,与 Matplotlib 及现代神经网络常用的 RGB 顺序相反,处理时需注意显式转换。

48. Albumentations 极速视觉数据增强

定位与核心功能:针对计算机视觉深度学习专门优化的高性能图像增强库,支持复杂的裁剪、旋转、色彩扰动、模糊仿射,且能同步更新目标检测框(Bounding Box)与语义分割掩膜(Mask)。

典型场景:目标检测、图像分类与分割模型的训练集离线/在线动态增广。

# 安装命令:pip install albumentations import albumentations as A transform = A.Compose([ A.HorizontalFlip(p=0.5), A.RandomBrightnessContrast(p=0.2), ])

选型优势:基于优化 C++ 底层加速,执行性能大幅超越 torchvision 自带变换,是视觉竞赛与工业落地标配。

49. spaCy 工业级自然语言处理管道

定位与核心功能:专为工业化落地设计的实用 NLP 库,具备极速的分词(Tokenization)、词性标注(POS)、依存句法分析与命名实体识别(NER)流水线。

典型场景:长文本非结构化信息抽取、实体命名匹配、法律/医疗文档关键词定位。

# 安装命令:pip install spacy import spacy # 载入工业预训练管道 # nlp = spacy.load("en_core_web_sm") # doc = nlp("Apple is looking at buying U.K. startup for $1 billion")

选型优势:相比科研风格的 NLTK,spaCy 追求高吞吐生产可用与单一最佳算法实现,工程整合度极高。

50. Sentence-Transformers 密集文本语义向量表征

定位与核心功能:基于 BERT/RoBERTa 等架构计算句子与段落密集嵌入向量(Dense Embedding)的专用库,生成的向量天然适用于余弦相似度计算与语义检索。

典型场景:向量数据库数据入库、语义去重、文本相似度召回、FAQ 智能客服匹配。

# 安装命令:pip install sentence-transformers from sentence_transformers import SentenceTransformer, util model = SentenceTransformer("all-MiniLM-L6-v2") emb1 = model.encode("How is the weather today?") emb2 = model.encode("Is it sunny outside?") similarity = util.cos_sim(emb1, emb2) print("Cosine Similarity:", float(similarity))

选型优势:直接产出高质量定长句向量,是现代所有 RAG 与知识库向量化环节不可或缺的基础设施。

四、技术选型决策与工程组合实践(总结)

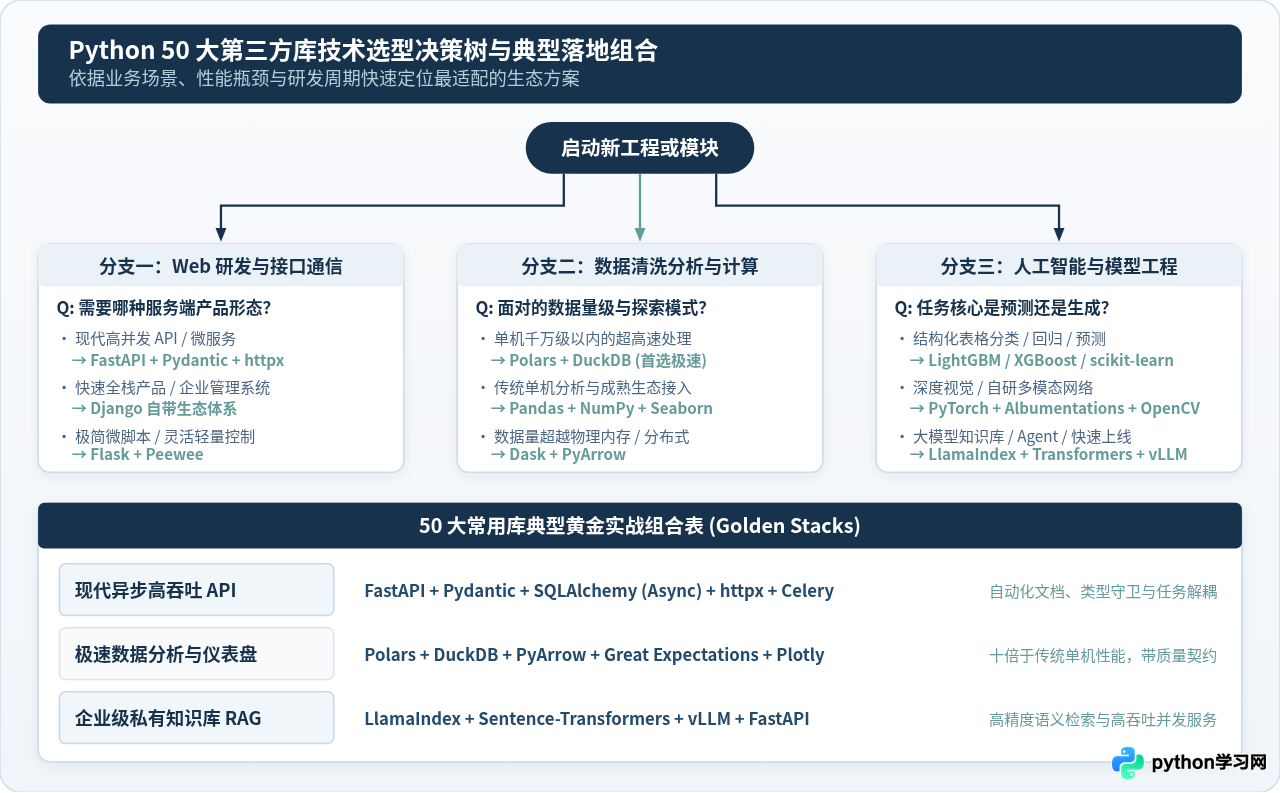
在软件工程中,任何单独的库都无法独自交付系统价值,核心竞争力在于技术栈的合理组合与约束管理。面对上述 50 个主流库,开发者应当根据项目核心矛盾(是研发速度、单机吞吐、长连接并发,还是模型准确度)进行清晰选型。
Python常用的50个第三方库清单:按Web、数据与AI领域分类
图 4:Python 50 大第三方库技术选型决策逻辑与典型黄金落地组合

生产实践三大“黄金工程组合”推荐

  • 1. 现代化微服务与高性能 API 组合:FastAPI + Pydantic + SQLAlchemy (Async) + httpx + Celery
    适用场景:前后端分离企业系统、中台数据接口与 AI 算法在线服务。由 Pydantic 保证入参出参数据安全,FastAPI 提供原生异步并发与 OpenAPI 交互文档,Celery 负责解耦大文件导出与耗时通知。
  • 2. 千万级数据极速分析与洞察组合:Polars + DuckDB + PyArrow + Great Expectations + Plotly
    适用场景:单机数据分析、业务看板与本地微型数仓。借助 Polars 的多核并行与 DuckDB 的向量化 SQL,突破传统 Pandas 的性能瓶颈;通过 Great Expectations 进行质量校验,保障清洗结果无脏数据。
  • 3. 企业级私有知识库与 RAG 问答组合:LlamaIndex + Sentence-Transformers + vLLM + FastAPI
    适用场景:内部智能问答、知识库文档检索与 Agent 应用。Sentence-Transformers 完成向量表征,LlamaIndex 实现分块检索召回,vLLM 负责底座模型高并发吞吐推理,全链路经由 FastAPI 封装输出给端侧。
工程避坑与依赖治理提醒:
  1. 严格使用虚拟环境:生产环境强烈推荐使用现代化工具(如 uv 或 Poetry)锁定确定版本号(poetry.lock),坚决杜绝在全局系统 Python 环境下随意 pip install。
  2. 警惕 C/C++ 与 CUDA 底层编译冲突:NumPy、PyTorch、OpenCV 与 vLLM 均重度依赖底层编译与 GPU 驱动。在容器化镜像构建时,务必提前锁定 CUDA Toolkit、cuDNN 与 Python 次版本号,优先拉取官方预编译 Wheel,避免线上触发动态编译失败。
  3. 性能瓶颈的转移原则:当单机 Pandas 发生 OOM(内存溢出)时,先不要盲目上 Spark 分布式集群,优先评估改写为 Polars 或使用 DuckDB 磁盘流式查询,通常能以极其低廉的单机硬件成本平息性能问题。

免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。

Python 相关产品和应用

全部下载
Selenium

Selenium

4.51.0 · Windows

用于浏览器自动化和 Web 测试的 Python 工具。

scikit-learn

scikit-learn

1.9.1 · Windows

常用 Python 机器学习算法与模型评估工具库。

Black

Black

26.10.1 · Windows

强调一致性的 Python 自动代码格式化工具。

Ruff

Ruff

0.17.1 · macOS

由 Rust 编写的高速 Python 代码检查和格式化工具。

pytest

pytest

9.1.1 · Windows

简洁而强大的 Python 自动化测试框架。

FastAPI

FastAPI

0.146.0 · Windows

高性能 Python API 框架,支持类型提示和自动接口文档。

Flask

Flask

3.1.3 · Windows

轻量灵活的 Python Web 应用框架。

Django

Django

6.1.2 · Windows

成熟的 Python Web 框架,适合构建内容站点和业务系统。

Spyder

Spyder

6.1.7 · Windows

面向科学计算与数据分析的 Python 集成开发环境。

SciPy

SciPy

1.18.1 · Windows

面向科学、工程和技术计算的 Python 算法库。