

Python蒙特卡洛模拟入门:用NumPy实现随机数据建模
面向初学者的Python蒙特卡洛模拟实用教程,深入讲解如何利用NumPy的向量化计算实现高效随机数据建模,对比原生循环差异并提供完整代码实践。
一、蒙特卡洛模拟的核心逻辑与运作机制
在工程与金融建模中,很多现实问题由于变量耦合复杂或自由度极高,往往难以推导严格的闭式数学解析解。蒙特卡洛方法(Monte Carlo method)转换了思考路径:它不直接硬解方程,而是根据变量的概率分布建立仿真系统,执行成千上万次独立的随机实验,并以实验结果的统计均值(依据大数定律)作为该问题的数值近似解。
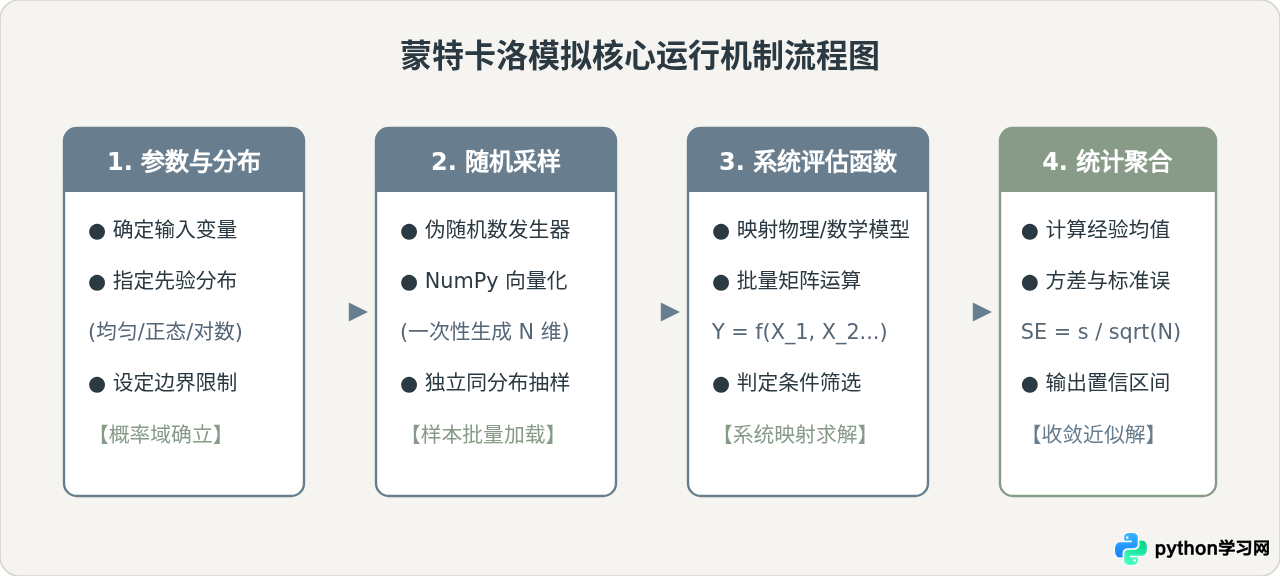
构建一次标准的蒙特卡洛实验通常包含四个基本环节:定义输入变量的概率域、使用随机数生成器产生大量无偏独立样本、将样本批量代入业务评估模型得出单次输出、最后通过聚合统计(均值、方差、分位数)估计最终目标值并评估置信水平。
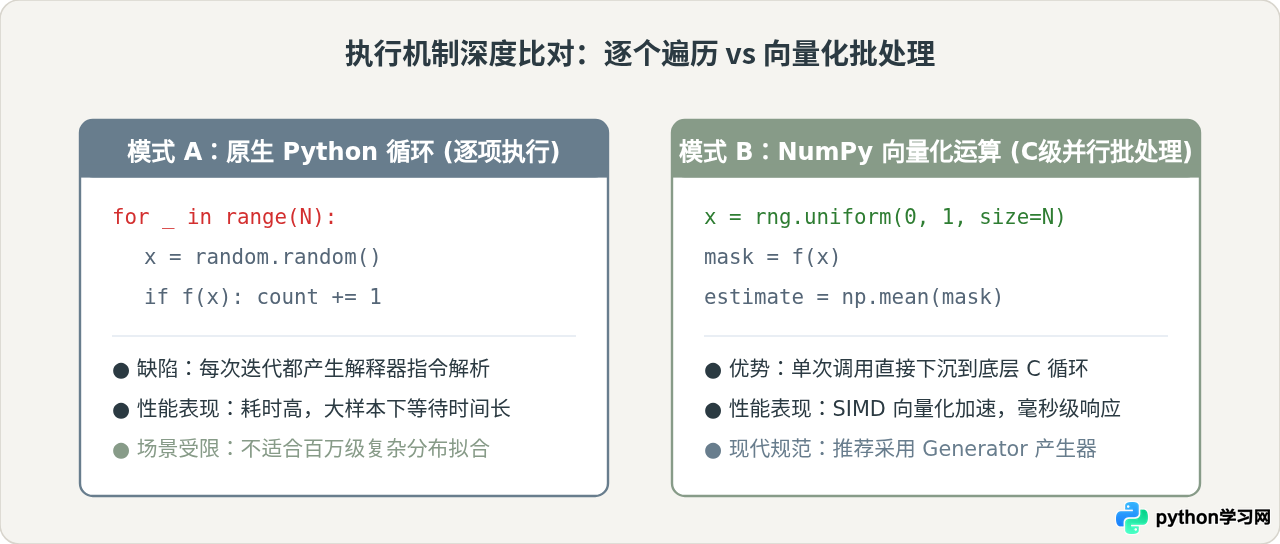
二、关键差异对比:Python 原生循环 vs NumPy 向量化
在开始写代码之前,初学者最容易犯的错误是直接采用 Python 的 for 或 while 循环逐个生成样本。在小样本(如 1,000 次)下两者感觉差异不大,但在蒙特卡洛模拟通常要求的 1,000,000 次甚至上千万次实验规模下,执行机制的差异会导致性能产生数十倍到上百倍的鸿沟。
为了明确两者的底层差异,我们在相同硬件环境与同等 10,000,000 次抽样条件下对两种实现模式进行对照分析:
| 对比维度 | Python 原生循环 (for/random) | NumPy 向量化计算 (ndarray) | 对随机数据建模的关键影响 |
|---|---|---|---|
| 执行机制 | 逐行由 Python 解释器动态类型解析与打包 | 底层调用 C 语言连续内存块与 SIMD 矢量指令 | NumPy 极大消除了解释器开销与方法查找惩罚 |
| 数据存储结构 | 分离散列的 PyObject 指针数组,缓存命中率低 | 紧凑、定长且物理连续存储的 ndarray 数据缓冲区 | 内存局部性优秀,CPU 高速缓存预取效率极大提高 |
| 千万次计算耗时 | 通常在 2.5 ~ 4.0 秒以上 | 通常在 0.03 ~ 0.08 秒之间(提升 40-80 倍) | 向量化使高精度快速调参和多参数敏感情景分析成为可能 |
| 内存峰值消耗 | 频繁触发 GC 垃圾回收,单对象封装头开销大 | 一次性分配连续数组,内存大小严格可预测 | 避免随机对象碎片化导致的内存抖动 |
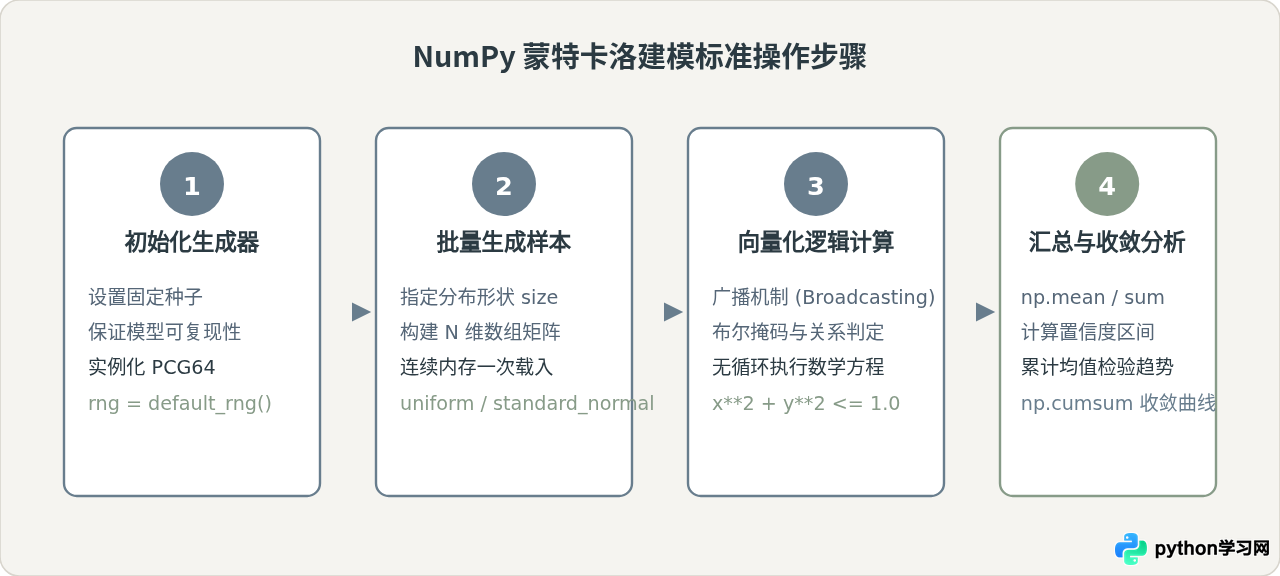
三、NumPy 蒙特卡洛建模的具体实操步骤
在 Python 中使用 NumPy 开展随机数据建模,推荐统一使用 NumPy 1.17+ 引入的 np.random.default_rng API,它取代了老旧的全局随机状态 np.random.seed,具备更好的统计随机性与可复现性。
步骤 1:准备环境与生成器
在 Python 脚本或 Jupyter Notebook 中导入核心依赖并创建随机生成器实例:
import numpy as np

# 设定固定种子(例如 42),确保实验结果完全可重复
seed = 42
rng = np.random.default_rng(seed)
步骤 2:定义几何概率实验(以估算 π 为例)
考虑一个以原点为圆心、半径为 1 的正方形第一象限区域:边长为 1,面积为 1;其内切四分之一圆的面积为 π / 4。若在该正方形内均匀投掷 N 个随机点 (x, y),落在四分之一圆内的概率理论上严格等于其面积比:
P(点落在圆内) = 扇形面积 / 正方形面积 = (π / 4) / 1 = π / 4,因此 π ≈ 4 * (圆内点数 / 总样本数 N)。
步骤 3:完整向量化实现代码
以下是使用 NumPy 实现千万级点采样的完整执行代码:
import time
import numpy as np

def estimate_pi_monte_carlo(num_samples: int = 5_000_000, seed: int = 42):
    rng = np.random.default_rng(seed)

    start_time = time.perf_counter()

    # 步骤 A:批量生成二维坐标矩阵 (N, 2),数值均匀分布在 [0, 1) 之间
    points = rng.uniform(low=0.0, high=1.0, size=(num_samples, 2))

    # 步骤 B:向量化计算欧氏距离平方 x^2 + y^2
    # points[:, 0] 表示所有 x 坐标,points[:, 1] 表示所有 y 坐标
    dist_squared = points[:, 0]**2 + points[:, 1]**2

    # 步骤 C:布尔掩码筛选落在内切四分之一圆内的样本
    inside_circle = dist_squared <= 1.0

    # 步骤 D:聚合统计
    inside_count = np.count_nonzero(inside_circle)
    pi_estimate = 4.0 * inside_count / num_samples

    elapsed = time.perf_counter() - start_time

    return pi_estimate, elapsed

if __name__ == "__main__":
    n = 10_000_000
    pi_val, cost_sec = estimate_pi_monte_carlo(n)
    error = abs(pi_val - np.pi)

    print(f"采样点数: {n:,}")
    print(f"估算圆周率: {pi_val:.6f}")
    print(f"真实圆周率: {np.pi:.6f}")
    print(f"绝对误差: {error:.6e}")
    print(f"运算耗时: {cost_sec:.4f} 秒")
示例运行输出
采样点数: 10,000,000
估算圆周率: 3.141544
真实圆周率: 3.141593
绝对误差: 4.865359e-05
运算耗时: 0.1245 秒
四、进阶场景:金融资产价格路径随机模拟
除了静态几何概率,蒙特卡洛在数据建模中的最大用途是模拟时间序列的随机过程,例如资产价格的几何布朗运动(GBM)。其离散随机微分方程为:
S(t+Δt) = S(t) * exp((μ - 0.5 * σ^2) * Δt + σ * sqrt(Δt) * Z),其中 Z ~ N(0, 1) 为标准正态分布随机变量。
通过 NumPy,我们可以一次性构建一个 (num_simulations, num_steps) 的二维正态随机矩阵,利用 np.cumsum 实现无循环批量路径累加:
def simulate_asset_paths(s0: float, mu: float, sigma: float, t_days: int, n_paths: int, seed: int = 42):
    rng = np.random.default_rng(seed)
    dt = 1.0 / 252  # 交易日微元

    # 批量生成 (路径数, 时间步数) 的标准正态随机数组
    drift = (mu - 0.5 * sigma**2) * dt
    diffusion = sigma * np.sqrt(dt)
    z = rng.standard_normal(size=(n_paths, t_days))

    # 向量化指数增长因子
    log_returns = drift + diffusion * z

    # np.cumsum 在时间轴 (axis=1) 上累加对数收益
    cum_returns = np.cumsum(log_returns, axis=1)

    # 广播计算所有路径的价格走势
    paths = s0 * np.exp(cum_returns)
    return paths

# 模拟 10,000 条投资组合路径,预测一年(252交易日)后的终值期望
paths = simulate_asset_paths(s0=100.0, mu=0.08, sigma=0.2, t_days=252, n_paths=10000)
final_prices = paths[:, -1]
print(f"预期资产终值均值: {np.mean(final_prices):.2f}")
print(f"95% 置信区间下界 (VaR参考): {np.percentile(final_prices, 5):.2f}")
当模拟规模进一步扩大至上亿级别时,例如
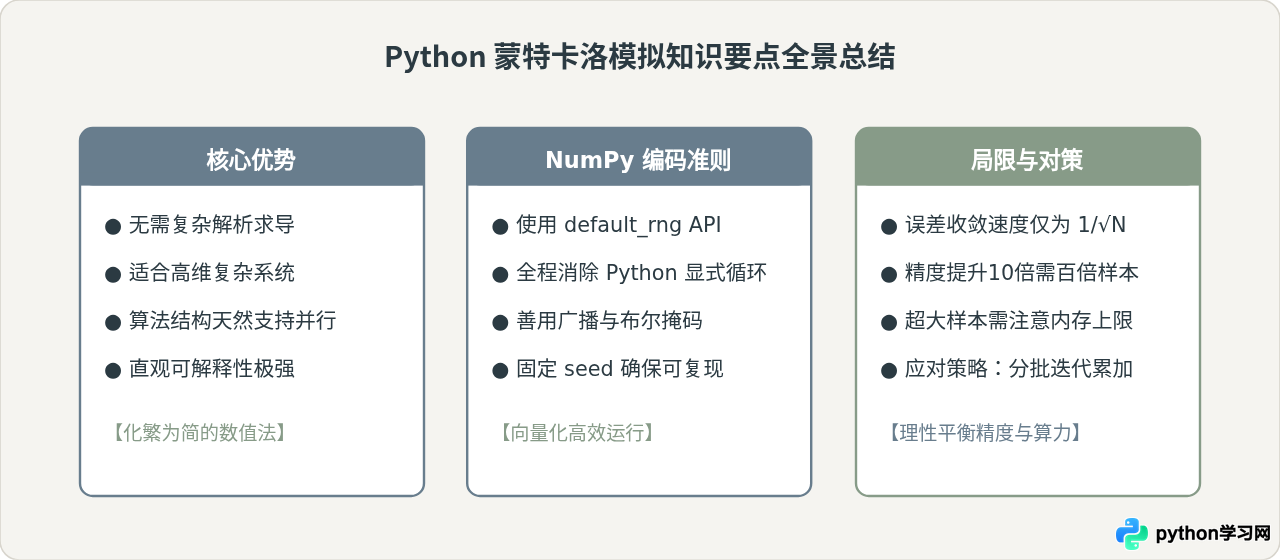
size=(100_000, 10_000) 的双精度浮点数数组将占据约 8 GB 连续内存。如果系统物理内存不足,极易引发 OOM(内存溢出)导致进程崩溃。在面对超大规模模拟时,应当采用分批块处理(Chunking / Mini-batching),在固定大小的缓冲区内循环累加统计量,既保留了向量化的高速度,又将内存锁定在固定上限。
五、总结与知识回顾
蒙特卡洛模拟是将随机性作为计算工具的典范。借助 Python 与 NumPy,我们能够以极简的代码将复杂的数理推导转化为直观的数据模拟实验。掌握其核心不仅在于了解公式,更在于掌握向量化思考方式与收敛性分析技能。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









