

Python怎么指定读取Excel的特定Sheet或列范围
详细讲解在Python中使用pandas与openpyxl精准读取Excel特定Sheet工作表及指定列范围的方法,包含参数详解、代码示例、范围控制技巧与常见问题排查。
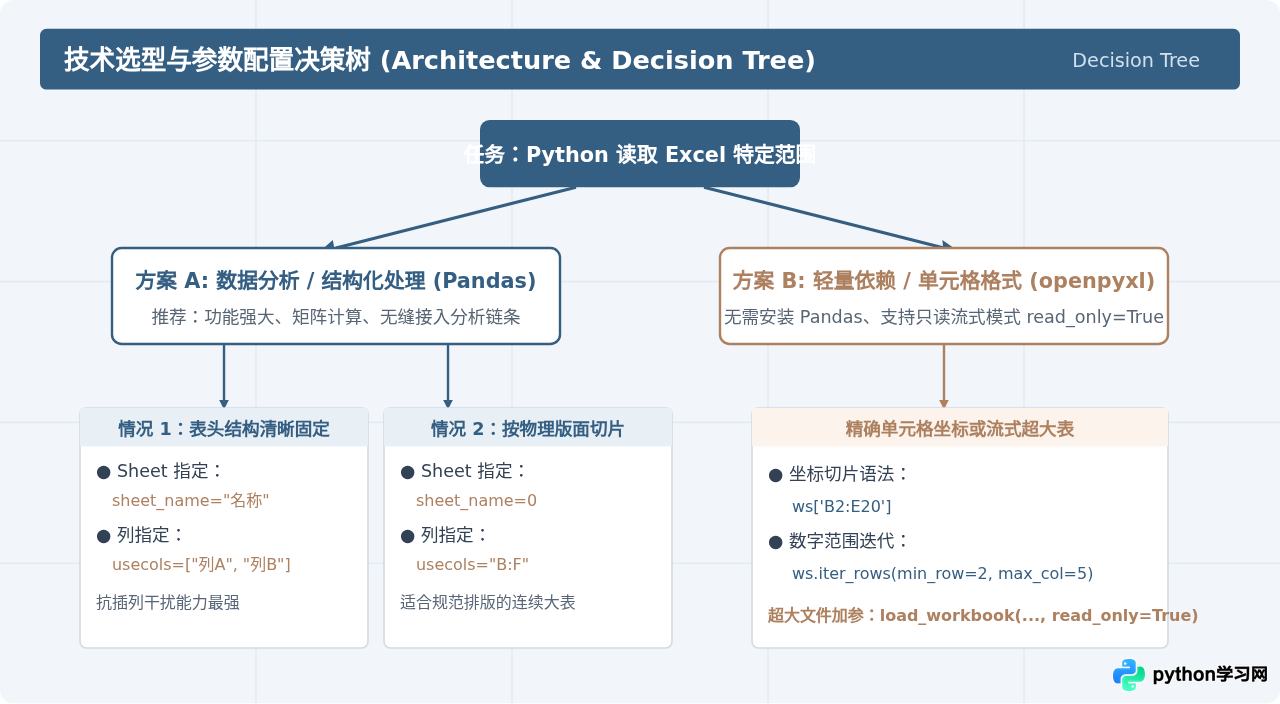
在日常数据处理与自动化报表开发中,Excel文件往往包含多个工作表,或者单张工作表拥有数十乃至上百列数据。如果直接全量读取,不仅会消耗大量内存、拖慢加载速度,还会引入许多无关字段。在Python生态中,最常用且高效的方案是使用 pandas 库的 pd.read_excel() 函数,配合 sheet_name 与 usecols 两个核心参数精确定位目标数据;针对不依赖 Pandas 或需要底层精细控制的轻量场景,也可以使用 openpyxl 进行单元格区域切片。本文将系统讲解这两种方案的具体语法、使用场景与避坑要点。
一、指定读取特定的 Sheet(工作表)
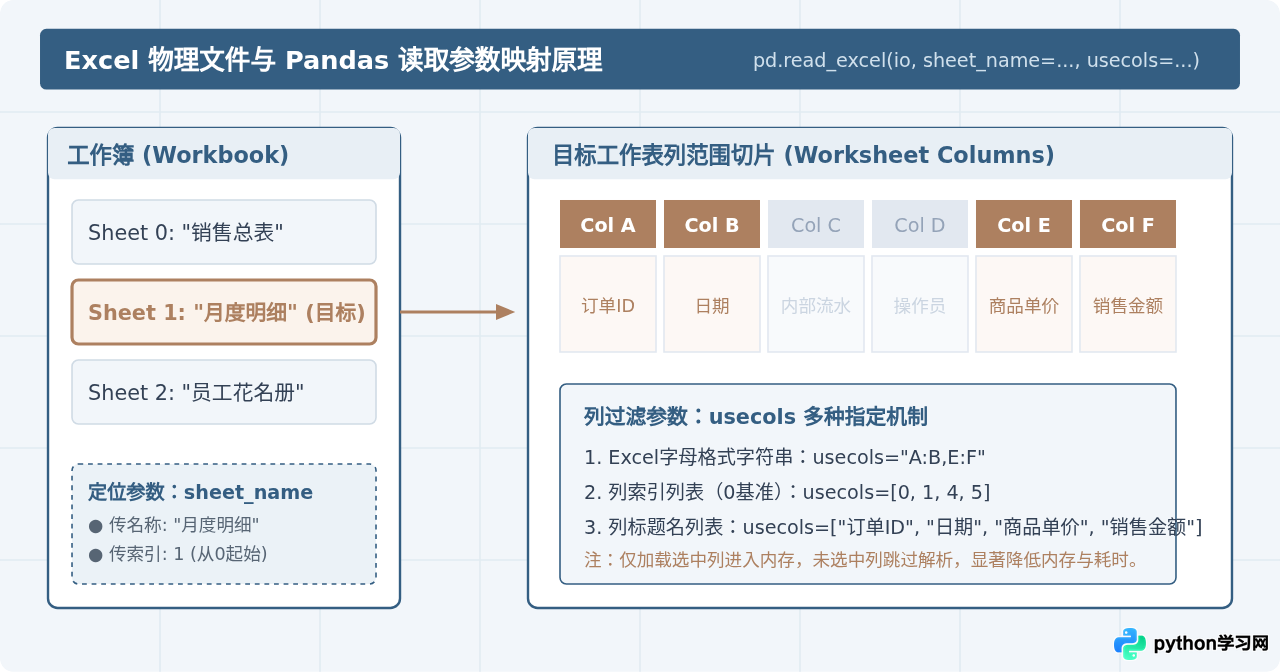
默认情况下,pd.read_excel('data.xlsx') 只会读取 Excel 文件中的第 1 个工作表(索引为 0)。如果目标数据位于其他 Sheet,可以通过参数 sheet_name 进行灵活指定。
1. 按工作表名称读取
直接传入工作表的名称字符串。这种写法语义最为明确,即便工作表在工作簿中的前后顺序被其他人拖动改变,只要名称不变,代码依然能准确定位。
import pandas as pd

# 读取名为 "月度明细" 的 Sheet
df = pd.read_excel('sales_data.xlsx', sheet_name='月度明细')
print(df.head())
2. 按工作表索引(位置)读取
传入整数索引值,从 0 开始计数。例如 0 代表第 1 个工作表,1 代表第 2 个工作表。适用于工作表名称经常变动(如按日期命名“2026-10-16”),但物理排位固定的场景。
# 读取第 2 个工作表
df = pd.read_excel('sales_data.xlsx', sheet_name=1)
3. 一次性读取多个 Sheet 或全部 Sheet
当需要同时加载多个表格时,sheet_name 允许传入列表,或者传入 None:
- 传入列表:如
sheet_name=['Sheet1', 'Sheet2']或sheet_name=[0, 1],返回值为一个字典(Dictionary),字典的键为 Sheet 名或索引,值为对应的DataFrame。 - 传入 None:
sheet_name=None将读取整个工作簿中的所有 Sheet,返回以各 Sheet 名为键的完整字典。
# 同时读取多个指定 Sheet,返回字典
sheets_dict = pd.read_excel('sales_data.xlsx', sheet_name=['1月', '2月'])
df_jan = sheets_dict['1月']
df_feb = sheets_dict['2月']

# 读取全部 Sheet
all_sheets = pd.read_excel('sales_data.xlsx', sheet_name=None)
for sheet_title, sheet_df in all_sheets.items():
    print(f"工作表【{sheet_title}】包含 {sheet_df.shape[0]} 行、{sheet_df.shape[1]} 列")
前置提示:在读取之前,如果你不确定 Excel 内部包含哪些 Sheet,可以使用 pd.ExcelFile 获取工作表清单,避免盲猜报错:
excel_file = pd.ExcelFile('sales_data.xlsx')
print(excel_file.sheet_names)  # 输出: ['销售总表', '月度明细', '员工花名册']
二、指定读取特定的列范围
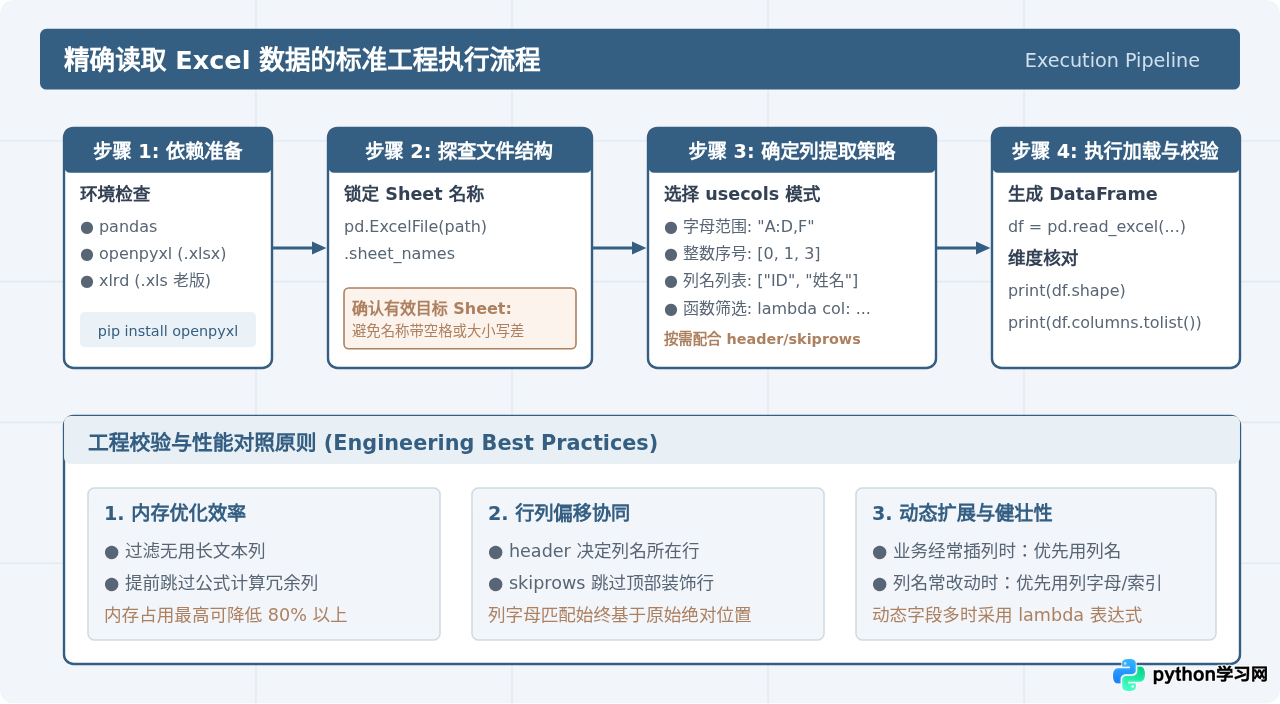
通过参数 usecols,可以告诉 Pandas 只解析并加载所需的列。Pandas 支持 4 种指定列范围的语法格式,读者可根据实际数据特征进行选择。
1. 方式一:使用 Excel 列字母范围字符串(推荐,最直观)
在日常与 Excel 交互时,大家最熟悉的是 A、B、C 等列号。Pandas 允许直接传入类似于 Excel 范围语法的字符串:
usecols="A:D":连续读取 A 列至 D 列(包含 A、B、C、D 共 4 列)。usecols="A,C,E:G":同时组合离散列与连续区间,读取 A 列、C 列以及 E 到 G 列。
import pandas as pd

# 读取指定 Sheet,且只加载 A 列到 D 列,以及 F 列
df = pd.read_excel('sales_data.xlsx', sheet_name='月度明细', usecols='A:D,F')
print(df.columns)
2. 方式二:使用列索引整数列表
传入整数列表,代表所读取列的物理序号,索引从 0 开始。例如 0 对应 A 列,1 对应 B 列,3 对应 D 列。
# 读取第 1 列(索引 0)、第 3 列(索引 2)和第 5 列(索引 4)
df = pd.read_excel('sales_data.xlsx', sheet_name='月度明细', usecols=[0, 2, 4])
这种方式特别适合通过 Python 代码进行程序化生成列序号,例如 usecols=list(range(0, 10, 2))(每隔一列读取一列)。
3. 方式三:使用具体的列名称列表
如果 Excel 表格的第一行是清晰的字段名(Header),并且你只关心特定几个指标,直接传入列名字符串列表是最具可读性的方式:
# 明确指定需要加载的字段名称
target_columns = ['订单ID', '客户姓名', '实付金额', '下单时间']
df = pd.read_excel('sales_data.xlsx', sheet_name='月度明细', usecols=target_columns)
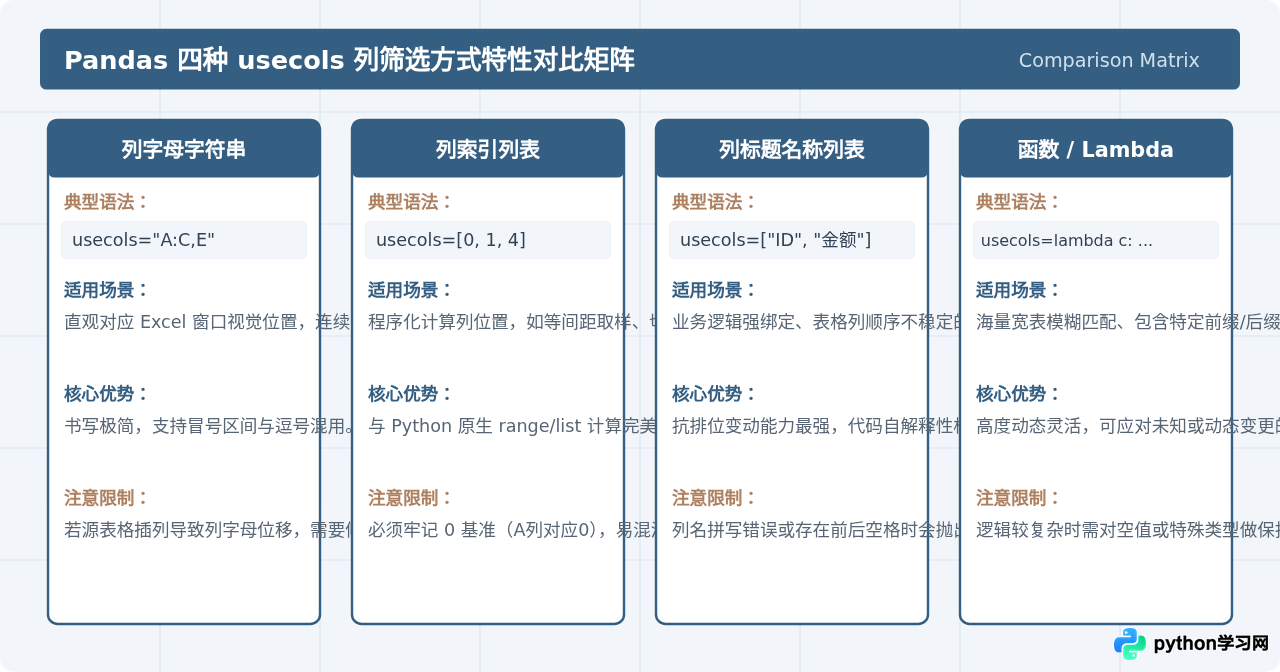
优点:即使他人后期在 Excel 表格中间插入或删除了某些列,导致列字母或列序号发生位移,只要目标字段名没有改变,程序依然能够准确无误地读取数据。
4. 方式四:使用可调用对象(Callable / Lambda 函数)
当列数非常庞大,且列名具有某种命名模式时,可以传入一个接收列名为参数、返回布尔值(True / False)的函数:
# 场景:只读取列名中包含 "金额" 或以 "ID" 结尾的列
df = pd.read_excel(
    'sales_data.xlsx',
    sheet_name='月度明细',
    usecols=lambda col_name: '金额' in str(col_name) or str(col_name).endswith('ID')
)
三、协同控制行范围:精准截取目标数据块
现实中的 Excel 文件常常在顶部放置报表标题、制表人信息或空行,而在底部放置合计行。为了与 usecols 配合实现特定区域的精准截取,需要结合行级参数:
| 参数名称 | 取值类型 | 作用与示例 |
|---|---|---|
header |
int 或 list | 指定哪一行作为列名(从0开始)。例如 header=2 表示将第3行作为列标题。 |
skiprows |
int 或 list | 跳过开头的指定行数。如 skiprows=3 跳过前3行;也可传入列表 skiprows=[0, 1, 4]。 |
nrows |
int | 仅读取指定的行数。如 nrows=100 表示加载有效数据的前100行。 |
# 综合示例:读取“月度明细”Sheet,跳过前2行说明文字,将第3行作为表头,读取B到E列,且只读50行
df_block = pd.read_excel(
    'sales_data.xlsx',
    sheet_name='月度明细',
    skiprows=2,       # 跳过前2行说明行
    header=0,         # 跳过之后,当前的第一行作为表头
    usecols='B:E',    # 只读取 B, C, D, E 列
    nrows=50          # 只截取前 50 行有效数据
)
四、备选方案:使用 openpyxl 进行底层范围切片
如果不需要进行复杂的数据分析,不想安装庞大的 Pandas 库,或者只需要读取某几个固定坐标的单元格(例如仅仅读取 B2:D10 区域),可以直接使用轻量级的 openpyxl 库。
1. 单元格区域切片方式
from openpyxl import load_workbook

# 加载工作簿(data_only=True 保证读取的是公式计算结果而非公式本身)
wb = load_workbook('sales_data.xlsx', data_only=True)

# 1. 指定读取特定 Sheet
ws = wb['月度明细']

# 2. 直接使用 Excel 坐标切片语法
cell_range = ws['A1:C5']
for row in cell_range:
    row_values = [cell.value for cell in row]
    print(row_values)

wb.close()
2. 使用 iter_rows 精确指定行列范围
ws.iter_rows() 允许用显式的数字下标精确控制范围(注意:openpyxl 的行号和列号是从 1 开始计数):
# 读取第 2 行到第 10 行,第 1 列 (A) 到第 4 列 (D) 的数据
data = []
for row in ws.iter_rows(min_row=2, max_row=10, min_col=1, max_col=4, values_only=True):
    data.append(row)

# 转换为列表查看
print(data[0])  # 第 1 行有效数据
五、常见问题与避坑要点
1. 为什么指定了 usecols=['姓名', '电话'] 却报错 ValueError?
当提示某些列名不在文件中时,最常见的原因有两个:
- Excel 表头存在不可见空格:很多业务表格导出的表头其实是
"姓名 "(末尾有空格),直接写"姓名"无法匹配。解决办法是先读取一行表头,查看df.columns.tolist(),或者使用usecols=lambda c: '姓名' in str(c)做模糊匹配。 - 表头不在第一行:如果表头前面有报表标题行,请务必指定
header=1或相应的实际行号,否则 Pandas 会将第一行的说明文字误当作表头,导致指定的列名全都不匹配。
2. 提示 Missing optional dependency 'openpyxl' 错误
在较新版本的 Pandas 中,读取 .xlsx 文件默认使用 openpyxl 引擎。如果运行报错缺少依赖,请在终端执行安装:
pip install openpyxl
如果是较老的 .xls 格式(Excel 97-2003),则需要安装 xlrd(注意 xlrd 2.0+ 仅支持 xls 文件)。
3. 列字母范围(如 "A:C")与 skiprows 组合时如何计算?
usecols="A:C" 始终代表原 Excel 工作表物理上的 A 列、B 列、C 列,它的定位是绝对的,不受 skiprows 参数的影响。因此,无需担心跳过行后列字母发生偏移的问题。
总结
在 Python 中读取 Excel 的特定 Sheet 或列范围,优先采用 pandas.read_excel():
- 指定 Sheet:使用
sheet_name="表名"或sheet_name=0(索引)。 - 指定列范围:连续列使用字母范围如
usecols="A:D";离散关键字段使用列名列表如usecols=['ID', '金额'];复杂规律使用lambda函数。 - 轻量级或固定区域:使用
openpyxl的ws['A1:D10']或iter_rows()进行原生遍历。
合理配置上述参数,能让程序只载入真正需要的数据切片,大幅减少内存开销并提升数据处理流程的健壮性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









