

Python长代码或长字符串怎么优雅换行
深入讲解Python长代码与长字符串的优雅换行技巧,覆盖括号隐式行延续、PEP 8对齐规范、长SQL与多行字符串处理、避坑指南及专业图解说明。
textwrap.dedent 等机制,核心解决路径是:优先使用圆括号包裹实现自然换行,尽量避免使用易引入空白符隐患的反斜杠,并根据长字符串的最终格式需求选择字面量拼接或模板函数。
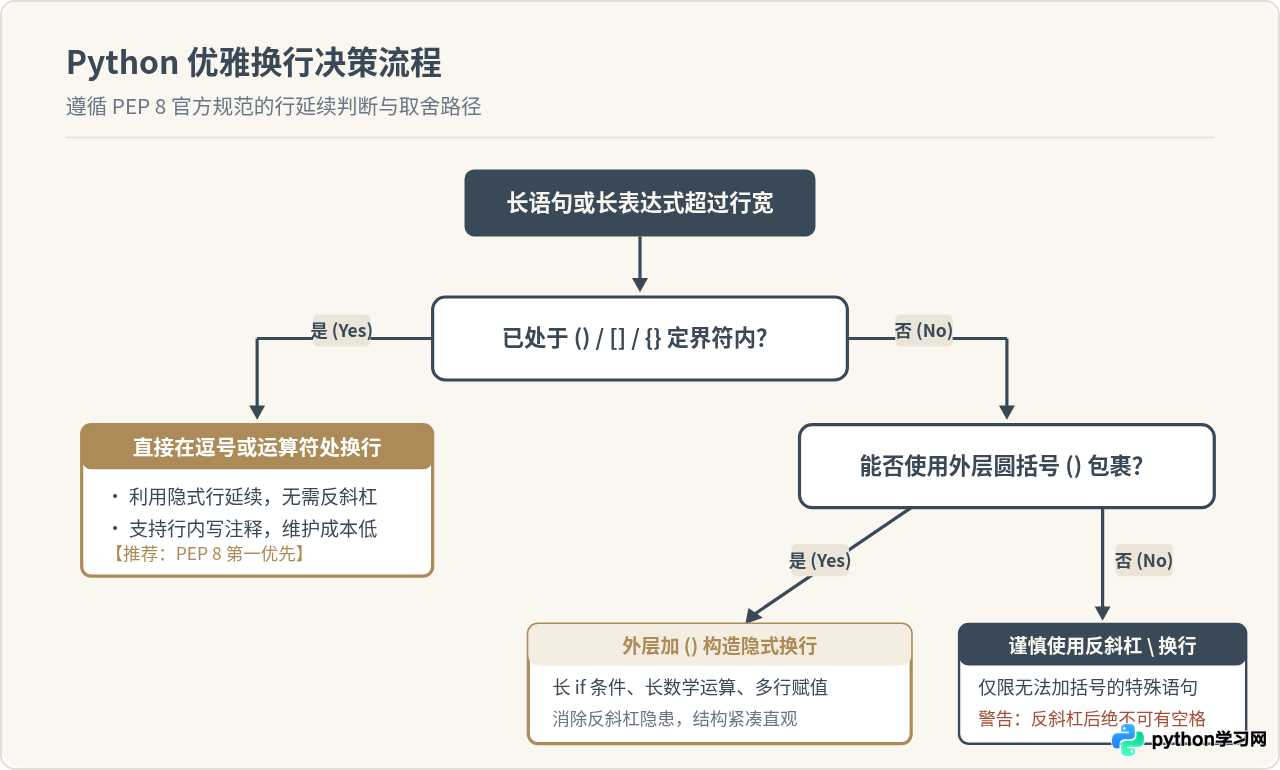
一、长代码换行的核心原则:圆括号隐式延续
Python 官方规范 PEP 8 建议每行代码的最大长度不超过 79 个字符(现代工程团队或格式化工具 Black 常放宽至 88 或 100 个字符)。当一条语句超出该长度时,最优雅的解决方案不是使用转义字符,而是利用 Python 的隐式行延续(Implicit Line Joining)特性。
在 Python 语法中,任何位于圆括号 ()、方括号 [] 或花括号 {} 内部的代码,都可以直接跨越多行书写,无需任何特殊换行标记。与行尾反斜杠 \ 相比,括号内部换行允许直接插入行内注释,不会因行尾意外键入看不见的空格而导致语法错误。
二、长代码常见场景的换行与对齐规范
长代码换行时,若缩进组织不当,容易造成与后续执行代码块混淆。PEP 8 推荐两种经典的对齐方式:垂直对齐(Vertical Alignment)与悬挂缩进(Hanging Indent)。
1. 长函数定义与参数调用
当函数参数较多时,推荐使用悬挂缩进。在首行只保留函数名与开括号,参数从下一行开始缩进 4 个空格,闭括号单独占一行并与定义语句的行首相齐:
# 推荐:悬挂缩进,清晰统一
def send_notification_email(
    recipient_email,
    email_subject,
    template_name,
    context_data=None,
    retry_count=3,
):
    # 函数体缩进 4 格,与闭括号边界分明
return mailer.dispatch(recipient_email, email_subject)2. 复杂布尔条件判断
在长 if 语句中,用外层圆括号将所有条件包裹起来,并把二元逻辑运算符(and、or)放在新行的行首。这是高德纳(Donald Knuth)著名的排版建议,已被 PEP 8 正式采纳。运算符置于行首便于读者视线垂直扫描所有判断逻辑:
# 推荐:外层括号包裹,运算符位于行首
if (
    user.is_authenticated
    and user.has_active_subscription
    and not user.is_account_suspended
):
    allow_access()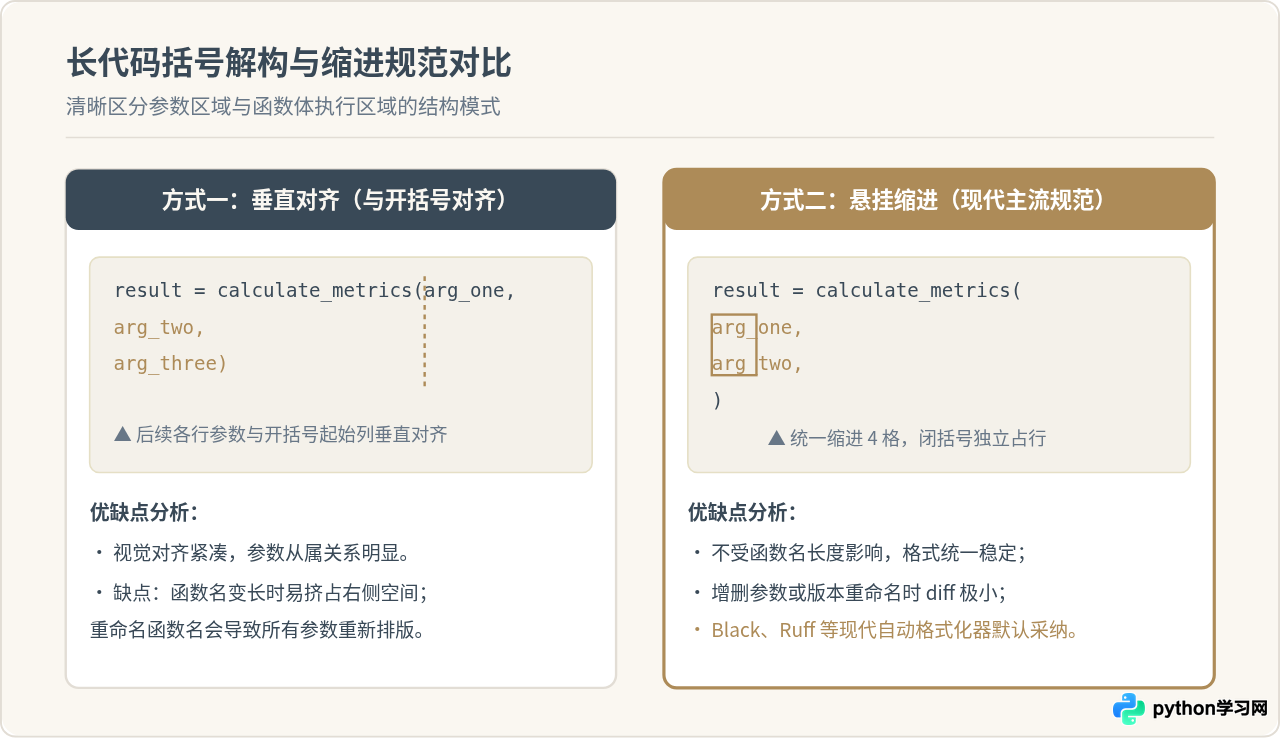
三、长字符串的三种优雅换行方案
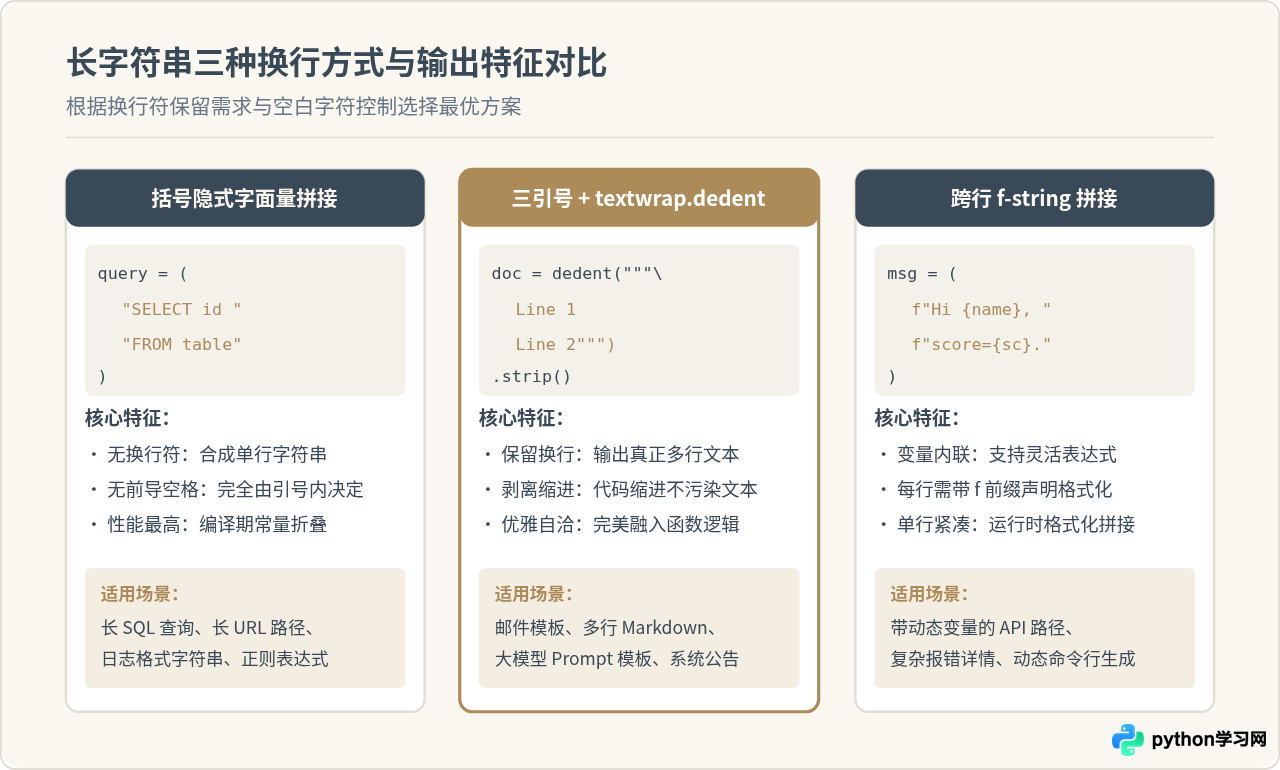
长字符串(如长 SQL 查询语句、URL 链接、大段提示词 Prompt、长异常日志信息)的处理往往比代码换行更为敏感,因为换行方式会直接决定生成的字符串内部是否包含意外的换行符 \n 或前导缩进空格。
1. 隐式字符串字面量拼接(零运行时开销)
在圆括号内部,两个或多个相邻书写的字符串字面量,会在 Python 源码编译为字节码阶段自动合并为一个连续的单行字符串。它不会引入换行符,也不会引入代码缩进的空格,非常适合长 SQL 或长 URL:
# 推荐:编译期自动合并为一个无换行、无多余空格的字符串
sql_query = (
    "SELECT id, username, email, created_at, status "
    "FROM app_user_account "
    "WHERE status = 'active' AND last_login_time > :cutoff_date "
    "ORDER BY created_at DESC "
    "LIMIT 50;"
)
2. 三引号多行字符串搭配 textwrap.dedent
如果文本本身就需要保留段落换行(如模板邮件、Markdown 提示词),使用三引号 """ 是最直观的做法。但若在类或函数内部直接使用三引号,每行前面的代码缩进会被作为实际空格写入字符串中。
优雅的解法是引入标准库 textwrap.dedent()。它会自动去除多行字符串中所有行共有的前导空格,允许我们将文本与函数内部代码对齐,同时得到干净的内容:
import textwrap

def generate_report_markdown(user_name, score):
    # 使用 textwrap.dedent 剥离统一缩进
    template = textwrap.dedent(f"""\
        # 成绩通知单
        尊敬的 {user_name} 同学:
        您本次阶段考核评分为:{score} 分。
        请查收附件中的详细试卷分析。
    """).strip()
return template"""\ 可以消除三引号立即换行带来的空行首;末尾链式调用 .strip() 能够清除首尾多余空白,保证文本纯净。
3. 长 f-string 的跨行拆分
当字符串包含多个动态插值变量时,同样可以在圆括号中将多个小段 f"..." 并列书写,Python 会在求值后合并:
api_url = (
    f"https://{api_host}:{port}"
    f"/v2/organizations/{org_id}"
    f"/projects/{project_name}"
    f"?api_key={secret_token}&format=json"
)
四、避坑指南:长代码与换行的常见隐患
在实际编写多行代码或长字符串时,有几个常见的隐蔽陷阱需要特别警惕:
1. 容器中遗漏逗号导致“隐式拼接 Bug”
由于相邻字符串会自动拼接,如果在列表、元组或集合中换行书写元素时忘记在行末写逗号,Python 不会报语法错误,而是将两行字符串悄悄拼接成一个元素:
# 严重隐患:第二行末尾少了一个逗号
fruits = [
    "apple",
    "banana"    # 注意此处漏掉了逗号!
    "orange",   # 实际上被合并为 "bananaorange"!
    "grape",
]
print(len(fruits)) # 输出结果为 3,而非预期的 4!防范策略:在多行列表或元组中,每一项末尾务必加上逗号,包括最后一个元素;配置 flake8 或 ruff 等代码静态检查工具能够及时警示该隐患。
2. 反斜杠后存在不可见的空格
如果在反斜杠 \ 后面不小心敲入了空格或制表符,Python 解释器会尝试将反斜杠作为普通字符转义空格,从而抛出 SyntaxError: unexpected character after line continuation character。这种肉眼难以辨识的错误排查成本极高,这也是为什么工业界全面拥抱括号隐式换行、排斥反斜杠的核心原因。
3. 长链式调用(Method Chaining)的换行
在数据分析(如 Pandas)、ORM 查询(如 SQLAlchemy)中经常出现连续调用的长代码。务必将整体表达式放在一对小括号内,并在每个点号 . 前面换行:
# 推荐:圆括号包裹链式调用,点号在行首
df_cleaned = (
    raw_dataframe
    .dropna(subset=["user_id", "email"])
    .rename(columns={"created_at": "signup_date"})
    .query("age >= 18")
    .sort_values(by="signup_date", ascending=False)
)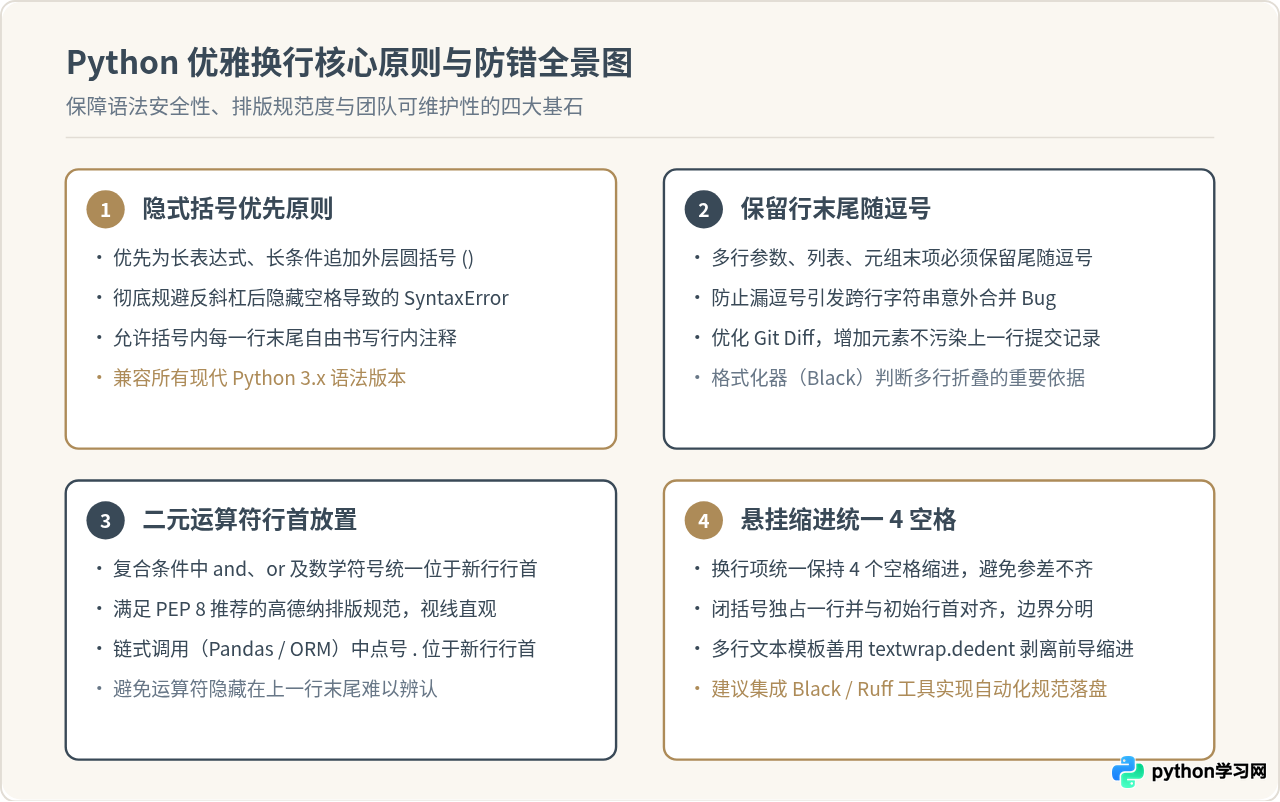
五、工程建议与总结
优雅换行的精髓在于利用语言自身的隐式规则消除冗余语法符号。在日常工程实践中,建议遵循以下清单:
- 长代码换行:优先在外层添加圆括号,把换行点放在逗号或二元运算符之前,采用 4 空格悬挂缩进;
- 单行长字符串:使用圆括号包裹相邻的字符串字面量(如
("part1" "part2")),交由编译器在编译期合并; - 多行格式文本:采用三引号搭配
textwrap.dedent(),既保留结构化排版,又保持代码层级的整洁美观; - 工具链保障:在 IDE 与 CI 流程中配置
black或ruff format,让代码格式的整理自动化完成,彻底解放团队的人工心智负担。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









