

Python和C语言应用场景对比:嵌入式开发 vs 数据科学与Web

一、执行模型与资源开销的底层差异
评估一门语言为何适用于特定场景,首先要厘清其执行模型与系统资源的消耗特征。C语言属于传统的静态编译型语言,源代码经过预处理、编译、汇编与链接后,直接转换为目标架构 CPU 能够执行的机器指令代码。在此过程中,变量的内存偏移量在编译或运行时栈帧中精确确定,函数调用直接映射为机器级别的调用指令,没有额外的运行时虚拟机介入。
Python(以最主流的 CPython 实现为例)则采用字节码解释运行机制。编写的 .py 脚本被编译为 .pyc 字节码,随后由虚拟机内部的求值循环(evaluation loop)逐条分派解释。更为关键的是,Python 中的每一个整数、浮点数或字符串都是一个完整的堆分配对象(PyObject)。一个简单的 C 语言 32 位整型仅占用 4 字节栈空间,而等值的 Python 整数对象在 64 位系统上通常占用 28 字节以上,包含了类型指针、引用计数器以及动态长度字段。
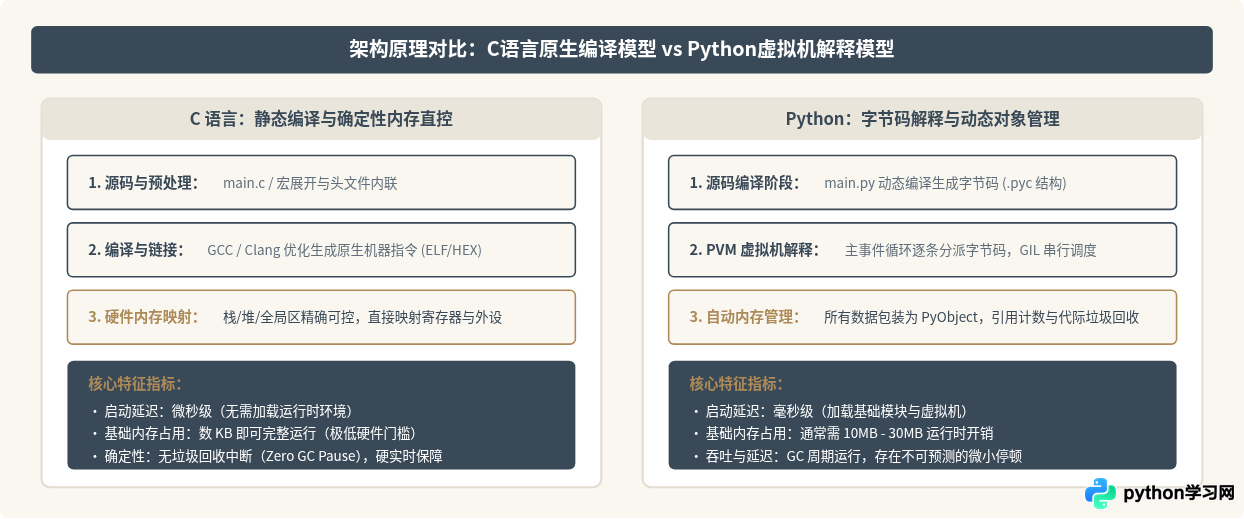
这种底层差异直接决定了两者的应用边界:在存储空间仅有数十 KB 的单片机中,Python 的解释器本身甚至无法被完整载入;而在内存充裕的高性能服务器或开发机上,Python 提供的动态灵活性与无需手动管理内存的安全性,显著降低了开发人员的心智负担。
二、嵌入式开发场景深度剖析:C语言的基石地位与边界
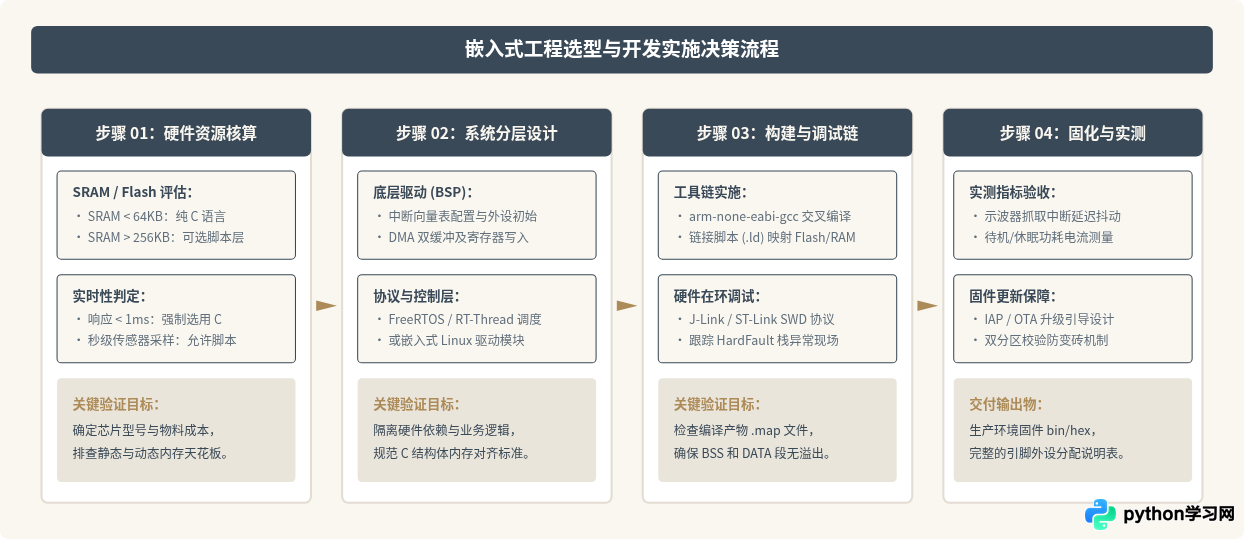
嵌入式开发的核心约束通常是物理硬件极限:受限的闪存(Flash ROM)、严格受限的随机存取存储器(SRAM)、电池供电下的极低能耗要求,以及工业控制中的硬实时(Hard Real-Time)响应。
1. 为什么 C 语言是嵌入式不可替代的基石
在主流微控制器(如 ARM Cortex-M0/M3/M4 系列)中,开发者经常需要直接操作芯片特定地址的外设寄存器。例如配置定时器、DMA 通道或 GPIO 引脚状态。C 语言允许通过绝对地址指针直接读写硬件寄存器,且编译器不会引入任何多余的操作指令:
// 示例:C语言直接对STM32 GPIO端口寄存器进行位操作
#define GPIOA_BASE       (0x40020000UL)
#define GPIOA_ODR_OFFSET (0x14UL)
#define GPIOA_ODR        (*(volatile uint32_t *)(GPIOA_BASE + GPIOA_ODR_OFFSET))

void toggle_pin5(void) {
    // 异或操作精准翻转第5引脚电平,对应单条机器指令
    GPIOA_ODR ^= (1UL << 5);
}
这段代码在开启编译器优化后,会被翻译为极简的汇编指令序列(载入寄存器基地址、异或立即数、存回内存),执行时间以纳秒计算。此外,中断服务程序(ISR)要求在硬件触发后的几微秒甚至数百纳秒内完成现场保护并执行响应,C 语言配合汇编启动代码能够给出严格可预测的时序保证。
2. MicroPython 与嵌入式 Python 的适用边界
近年来 MicroPython 和 CircuitPython 降低了硬件入门门槛,在 ESP32、树莓派 RP2040 等具备数百 KB SRAM 的现代芯片上获得了广泛使用。然而,工程团队必须清醒认识其适用边界:
- 内存碎片与垃圾回收停顿:MicroPython 的堆内存管理依赖 Mark-Sweep 垃圾回收算法。当内存紧张触发 GC 时,程序可能会出现毫秒级的不可控暂停,这在电机闭环控制、数字电源和安全制动系统中是致命的。
- 执行速度差距:纯 Python 计算速度通常比优化后的 C 代码慢 10 到 50 倍。对于高频采样信号的数字滤波(如 FIR/IIR),解释器的开销会导致吞吐量严重不足。
- 推荐适用场景:智能家居传感器的数据上报、低频次物联网状态机监控、交互式硬件原型验证(通过 REPL 实时输入调试指令)。
三、数据科学与Web应用:Python的统治力与底层真相
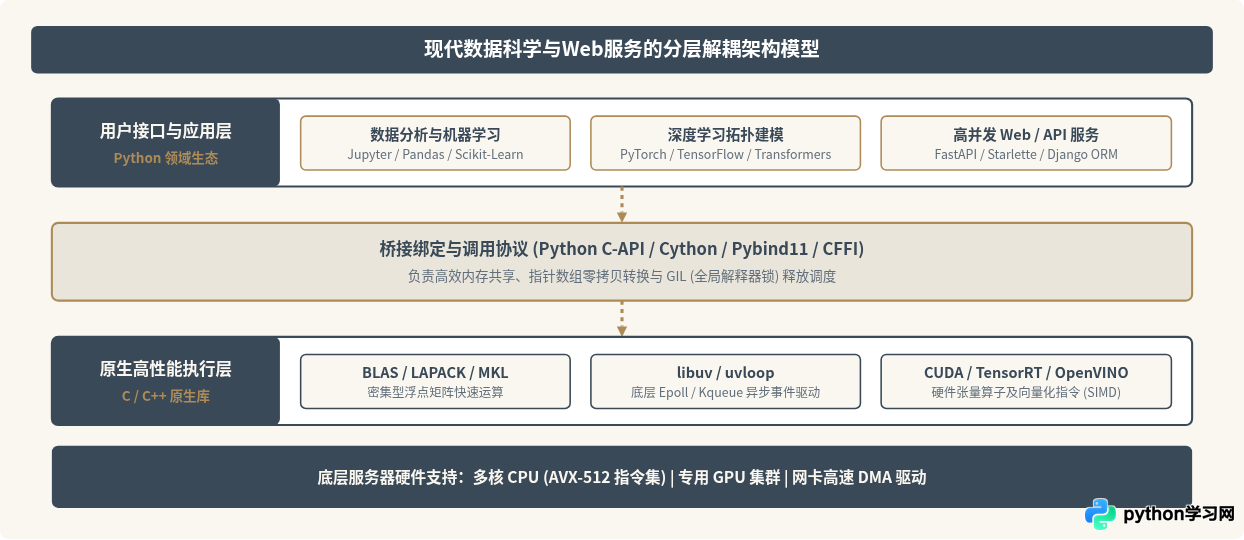
如果说嵌入式领域是 C 语言统治的物理防线,那么数据科学(Data Science)与现代 Web 开发则是 Python 统治力最为显著的舞台。但这背后的原因绝非“Python 运行速度快”,而是源于“研发吞吐量(Developer Productivity)”与“底层 C 扩展生态”的完美协同。
1. 数据科学的真实架构:以 Python 为胶水,以 C/C++ 为引擎
在数据科学中,处理矩阵运算、图像张量或数据表清洗时,开发者编写的通常是简洁的 Python 表达式。例如通过 Pandas 和 NumPy 进行大规模向量化计算:
import numpy as np

# Python 仅负责调用接口声明,实际计算完全脱离 Python 解释器
data = np.random.randn(1000000)
result = np.exp(data) * 2.5 + 1.0
如果使用纯 Python 的 for 循环逐个计算一百万个元素的指数,由于每次迭代都需要进行动态类型解包、操作符重载查找与引用计数调整,耗时通常在数百毫秒以上。而上述 NumPy 语句实际执行时间通常仅需数毫秒。
原因在于:NumPy 底层数据存储是一段连续的 C 语言内存缓冲区(C-contiguous buffer),其计算核心直接调用由 C 语言与 Fortran 编写的高性能线性代数库(BLAS/LAPACK、Intel MKL 或 OpenBLAS)。在深度学习框架 PyTorch 和 TensorFlow 中,这一架构更为极端——Python 仅用于定义网络拓扑图与调度训练参数,正向传播与反向求导的实际张量计算由 C++、CUDA 原生核心接管。
2. Web 服务场景下的生产力与高并发模型
在 Web 后端领域,使用 C 语言编写 HTTP 业务系统(如直接基于 Linux epoll 与 socket 库)虽然可以达到极致的单机 QPS,但面临巨大的维护代价:字符串缓冲区易发生溢出、JSON 解析与序列化代码冗长、关系型数据库 ORM 映射困难,且极易出现内存泄漏导致线上崩溃。
Python 社区通过 ASGI 规范(如 FastAPI、Uvicorn)和 asyncio 异步事件循环,彻底改变了 Web 开发生态。Web 业务的核心瓶颈往往是网络 I/O、数据库查询延迟或外部微服务调用,而非 CPU 密集型计算。在 I/O 等待期间,Python 协程会主动让出控制权,单进程即可承载数以万计的并发连接,同时提供了极高可读性的接口定义与自动文档生成:
四、混合工程实践:C语言实现算子,Python编排调用
在实际生产环境中,资深工程师很少将 Python 与 C 割裂对待,而是根据性能分析(Profiling)结果采用“混合开发模型”:系统骨架与上层接口采用 Python 快速构建,针对局部计算热点(Hotspot)使用 C 语言重写并编译为共享库。
1. C 语言编写高性能计算动态库
以下是一个简单的平滑移动平均滤波算法,使用纯 C 语言编写并保存为 fast_filter.c:
// fast_filter.c
#include <stddef.h>

// 针对连续浮点数组进行快速计算,由外部确保内存有效性
void moving_average(const double* input, double* output, size_t length, int window_size) {
    if (length == 0 || window_size <= 0) return;

    double current_sum = 0.0;
    for (int i = 0; i < window_size && i < (int)length; i++) {
        current_sum += input[i];
        output[i] = current_sum / (i + 1);
    }

    for (size_t i = window_size; i < length; i++) {
        current_sum += input[i] - input[i - window_size];
        output[i] = current_sum / window_size;
    }
}
在 Linux 或 macOS 终端下,通过 GCC 命令将其编译为共享动态库:
gcc -O3 -shared -fPIC -o libfast_filter.so fast_filter.c2. Python 借助 ctypes 实现无缝高效调用
在 Python 端,利用标准库 ctypes 加载动态库,直接传递 NumPy 数组指向的连续内存地址(ctypes.data_as),既避免了数据复制,又享有了 C 语言的循环展开与向量化性能:
import ctypes
import numpy as np

# 1. 显式加载编译好的 C 共享库
lib = ctypes.CDLL("./libfast_filter.so")

# 2. 声明 C 函数的参数与返回值类型,防止内存误操作
lib.moving_average.argtypes = [
    ctypes.POINTER(ctypes.c_double),
    ctypes.POINTER(ctypes.c_double),
    ctypes.c_size_t,
    ctypes.c_int
]
lib.moving_average.restype = None

# 3. 准备数据并直接传递底层指针
raw_data = np.random.randn(500000).astype(np.float64)
result_data = np.empty_like(raw_data)

input_ptr = raw_data.ctypes.data_as(ctypes.POINTER(ctypes.c_double))
output_ptr = result_data.ctypes.data_as(ctypes.POINTER(ctypes.c_double))

# 4. 执行 C 原生计算
lib.moving_average(input_ptr, output_ptr, len(raw_data), 10)
1. 内存归属原则:谁分配,谁释放。在 Python 与 C 混合交互中,尽量由 NumPy 分配好连续内存并传入指针,避免在 C 扩展中使用 malloc 分配后由 Python 回收,否则极易诱发静默内存泄漏或 Double Free 崩溃。
2. GIL 释放时机:如果 C 函数内部执行超过 1 毫秒的重计算,在编写标准 CPython 扩展时务必包裹 Py_BEGIN_ALLOW_THREADS 与 Py_END_ALLOW_THREADS,主动释放全局解释器锁,允许其他 Python 线程并发响应。
五、全维度选型对照与工程总结
综上所述,Python 和 C 语言并不是彼此替代的竞争对手,而是分布在计算机抽象层级两端的互补工具。正确的工程选型应当基于项目的核心约束条件:
| 评估维度 | C 语言 | Python | 选型裁定关键条件 |
|---|---|---|---|
| 执行效率与延迟 | 纳秒/微秒级响应,零额外损耗 | 毫秒级解释开销,受 GIL 约束 | 是否有硬实时控制与高频低抖动要求 |
| 内存资源占用 | 极小(KB 级别,无运行时包袱) | 较大(数十 MB 起步,对象开销大) | 芯片 SRAM/Flash 物理容量是否受限 |
| 业务迭代速度 | 慢(手动管理内存、指针排错复杂) | 极快(动态类型、高度抽象语法) | 业务需求变动频率与产品交付上线周期 |
| 典型优势领域 | MCU 固件、OS 内核、通信协议栈底座 | 数据分析、AI 建模、异步 Web 后端 | 是属于“硬件控制密集型”还是“业务编排型” |
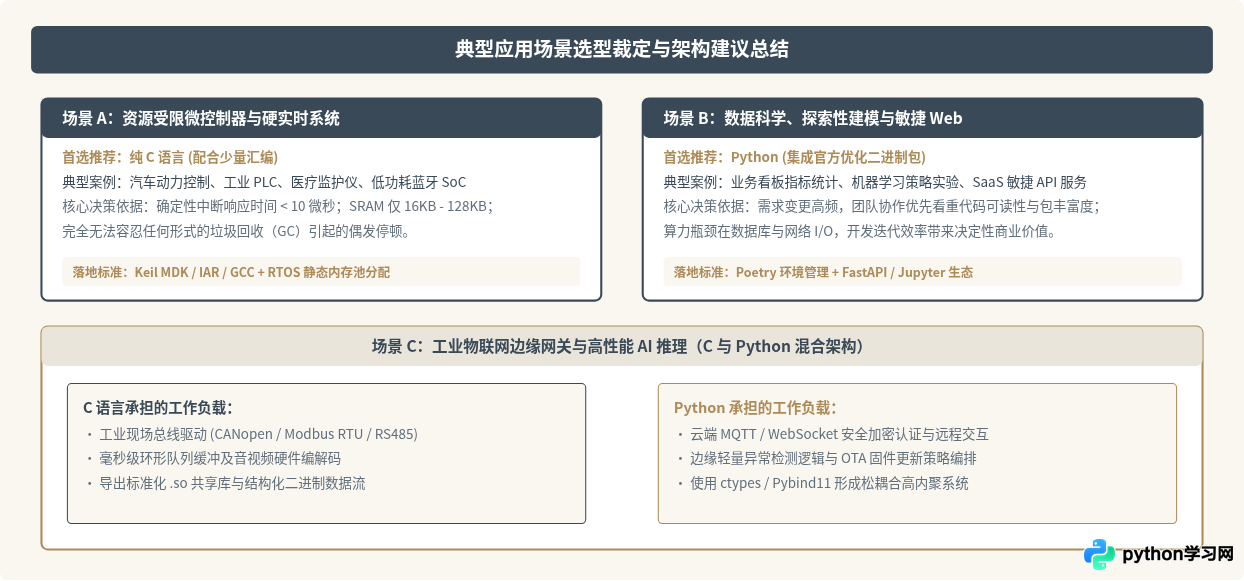
理解两者的强项与软肋,并在实际工程中各取所长,是现代软件架构设计的成熟标志。掌握 C 语言能让你看清计算机系统的物理底线,而善用 Python 则能赋予你快速将想法转化为工程实物的生产力。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









