

Python三双引号和三单引号有什么区别
深入对比Python三双引号与三单引号的异同,从语法底层解析、引号嵌套免转义规则、PEP 257文档字符串规范以及实际工程选型四个维度,全面解答二者的本质区别与最佳实践。
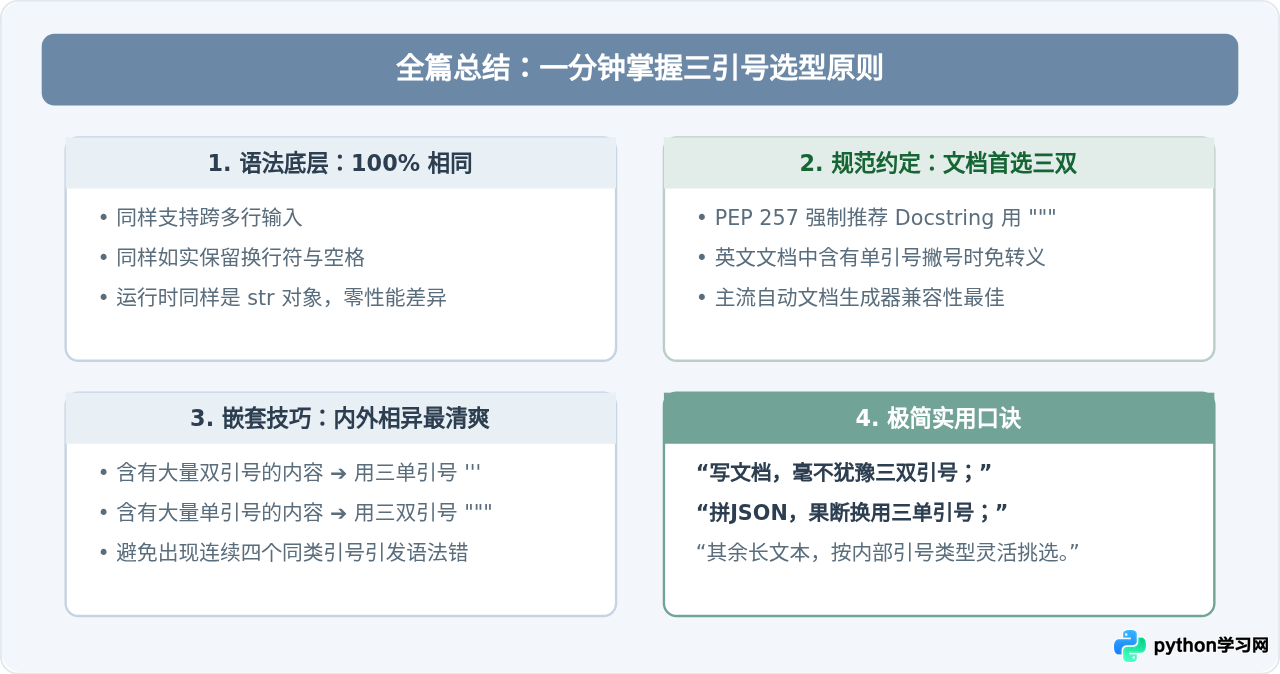
"""...""")与三单引号('''...''')没有任何功能与性能上的差异。它们都是 Python 中的“三引号字符串字面量”,都可以跨越多行,都会完整保留文本中的换行与空格。二者的真正区别仅体现在两个方面:内部嵌套单双引号时的免转义便利性,以及官方社区标准(PEP 257 与 PEP 8)对文档字符串(Docstring)的书写规范。
一、底层原理:解析器眼中的完全等价性
初学者常常会产生疑问:既然 Python 提供了两种形式的三引号,它们在编译后会不会有类型差异,或者对内存与运行速度产生影响?答案是完全不会。
Python 词法分析器(Tokenizer)在扫描源代码字符流时,只要遇到连续三个单引号或三个双引号,都会进入多行字符串匹配模式,直到遇到同类型的闭合三引号为止。在语法分析树(AST)中,二者都会被构造成完全一致的 Constant 字符串节点,并在编译阶段生成同样的字节码操作指令 LOAD_CONST。
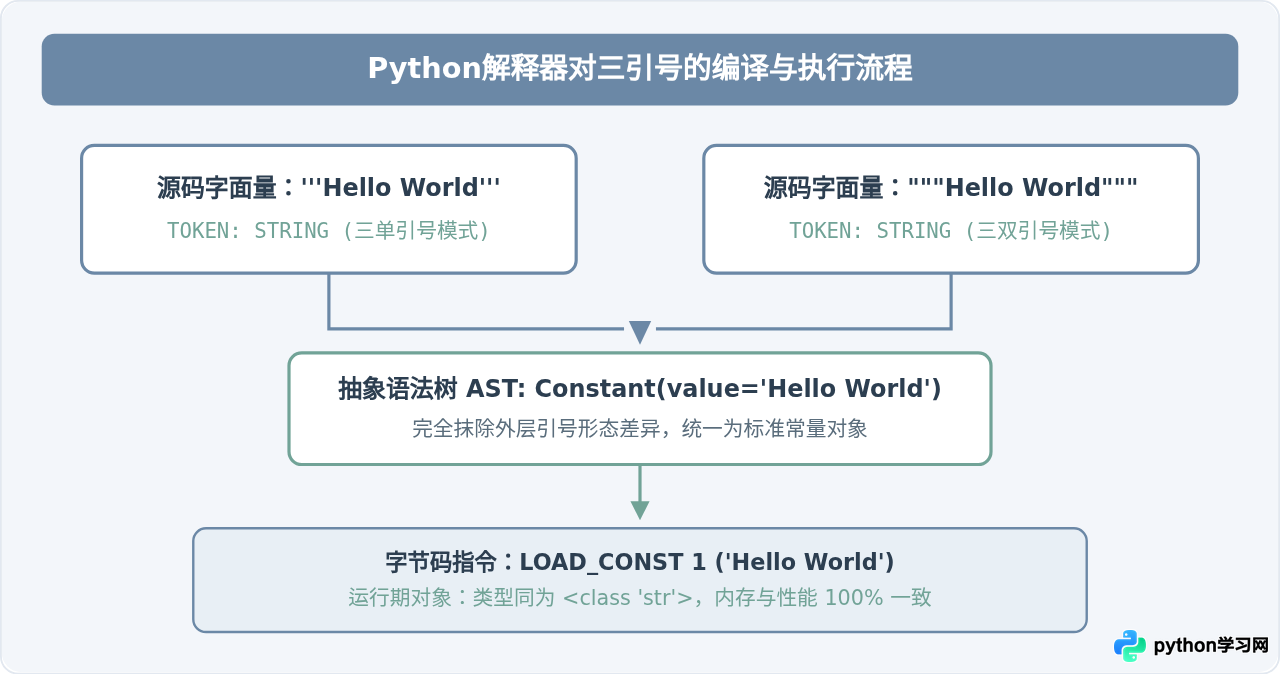
无论是用 type() 检查数据类型,还是用 id()、dis 模块查看字节码指令,两种书写方式生成的结果都是一模一样的普通字符串对象:
# 示例:两种书写方式在运行时的等价性验证
s_single = '''Python 字符串'''
s_double = """Python 字符串"""

print(s_single == s_double)       # 输出: True
print(type(s_single))             # 输出: <class 'str'>
print(type(s_double))             # 输出: <class 'str'>
二、实用差异:引号嵌套与免转义规则
既然在底层完全一样,为什么还要区分单双两种形式?最直接的实用价值在于字符串内部包含引号时的免转义处理。
在 Python 中,如果字符串内部出现的引号与最外层界定符相同,就必须使用反斜杠 \ 进行转义,否则解释器会提前结束字符串并报语法错误 SyntaxError。三引号同样遵循这一原则:
- 三双引号(
"""...""")内:可以直接书写单个或两个连续的单引号('),无需任何转义;如果包含连续三个双引号则需要转义。 - 三单引号(
'''...''')内:可以直接书写单个或多个双引号("),无需任何转义;如果包含连续三个单引号则需要转义。
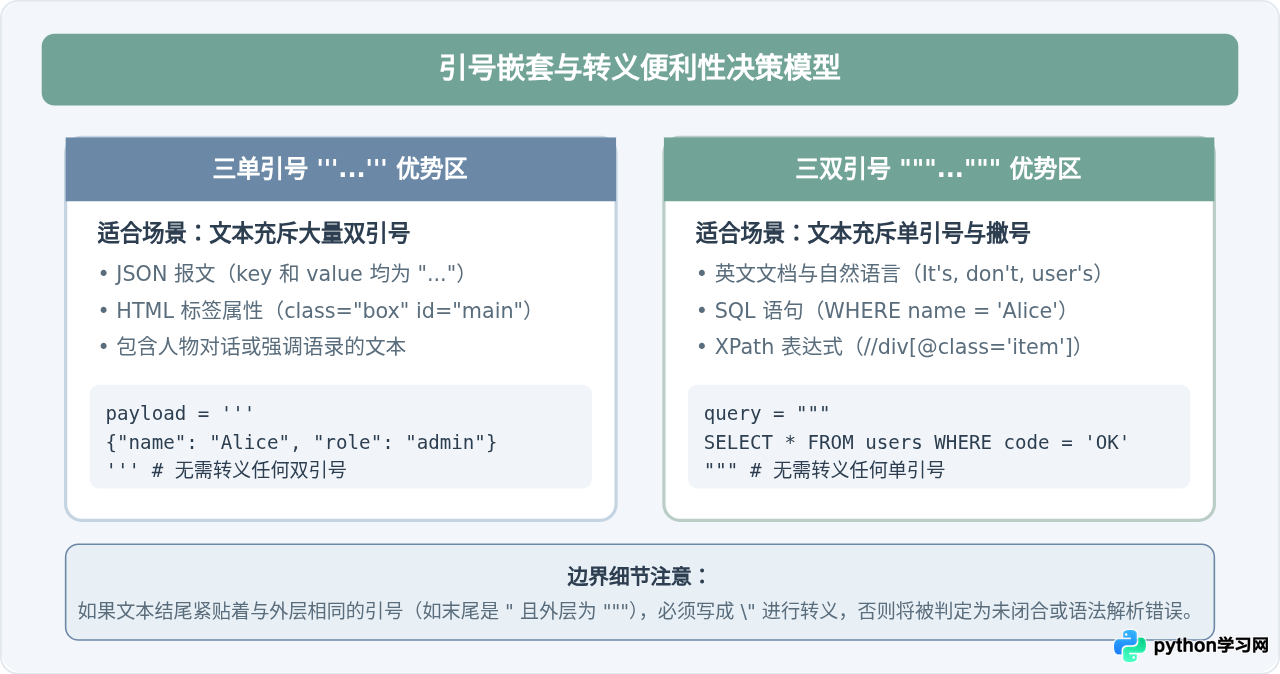
通过合理选择界定符,可以避免在文本中堆砌反斜杠,使代码具有最佳的可读性。以下是一个具体的边界对比示例:
# 示例 1:包含 JSON 文本时,三单引号更简洁
json_str = '''{
    "user_id": 1001,
    "user_name": "Antigravity",
    "status": "active"
}'''

# 示例 2:末尾引号的转义陷阱
# 错误写法:"""He said "hello"""" -> 导致 4 个双引号相连,引发 SyntaxError
# 正确做法 1:末尾双引号进行反斜杠转义
safe_str1 = """He said "hello\""""
# 正确做法 2:切换为三单引号包裹,免除转义麻烦
safe_str2 = '''He said "hello"'''
三、规范约定:PEP 257 对文档字符串的强制偏好
在实际企业级开发中,绝大多数团队的规范检查工具(如 Flake8、Pylint、Black、Ruff)都会对三引号提出明确要求:编写函数、类、模块的文档字符串(Docstring)时,一律统一使用三双引号 """..."""。
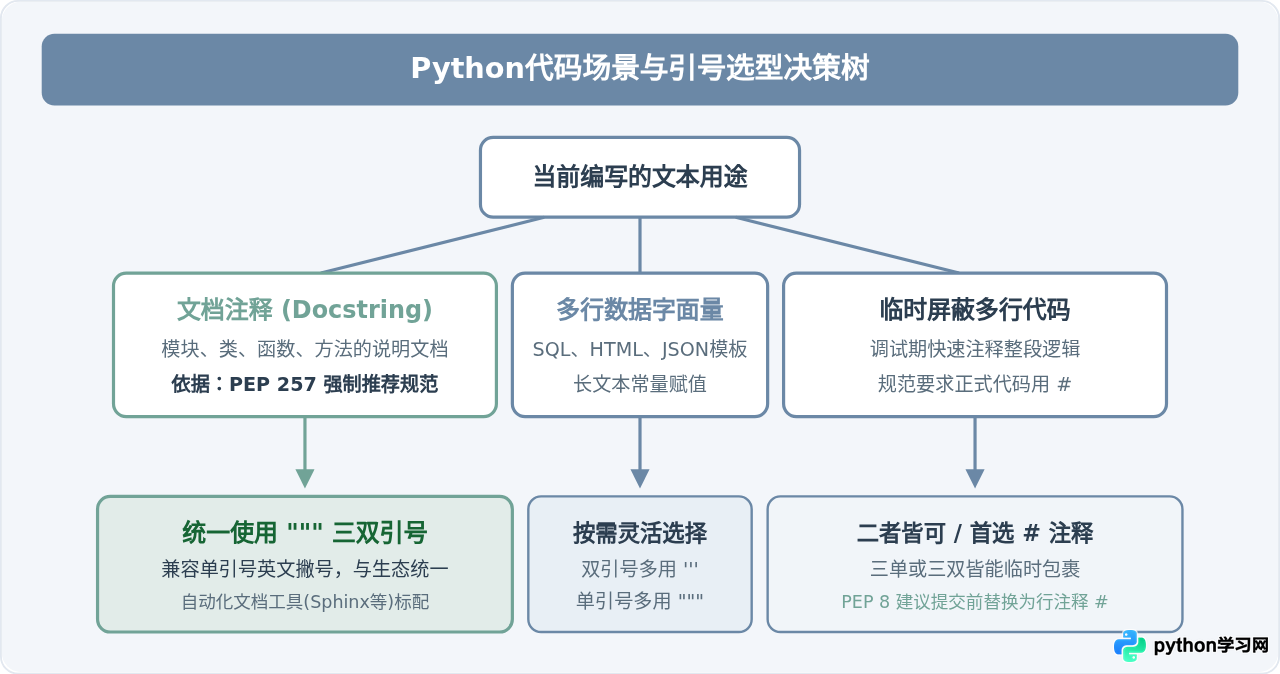
官方标准做出这一规定的原因主要有两个:
- 自然语言书写习惯:在英文技术文档与注释中,单引号(
')作为所有格(如user's input)和缩写词(如it's,don't,can't)的撇号极其常见。如果使用三双引号包裹文档,这些英文标点完全不需要反斜杠转义,书写和阅读极为流畅。 - 生态与工具一致性:Python 官方内置的
help()函数、__doc__属性,以及 Sphinx、MkDocs、IDE(如 VS Code、PyCharm)的代码提示解析器,都是以三双引号作为第一规范进行测试和展示的。遵循这一规范能保证团队内部代码风格完全统一。
def calculate_discount(price: float, rate: float) -> float:
    """计算商品折后价格。

    Args:
        price: 原价,必须大于0。
        rate: 折扣率,范围在 0.0 到 1.0 之间。

    Returns:
        float: 计算后的最终价格。
    """
    return price * rate
四、多行文本通用陷阱与避坑指南
在使用三引号(无论是三单引号还是三双引号)定义多行文本时,开发者常遇到以下两个常见问题,需要特别注意:
1. 首尾意外换行与缩进保留
三引号会严格忠实于你在代码中输入的所有换行符和空格缩进。如果你在三引号开头的下一行才开始写字,或者为了代码整齐添加了缩进,这些都会直接成为字符串内容的一部分。
# 陷阱:文本开头多了一个空换行,每行前带有了4个空格缩进
text_dirty = """
    line 1
    line 2
"""

# 解决方式:使用标准库 textwrap.dedent 清理缩进,首行紧贴或 strip() 消除空行
import textwrap

text_clean = textwrap.dedent("""
    line 1
    line 2
""").strip()
2. 所谓“多行注释”的内存占用真相
Python 原生并没有专门的 /* ... */ 块注释语法。很多开发者习惯用独立的三单引号或三双引号来临时注释一段不需要的代码。需要注意的是:
- 如果三引号未赋值给任何变量,且不在函数首行作为 Docstring,Python 编译器在优化时通常会将其作为孤立表达式忽略;
- 但如果缩进不合规,或者在某些交互式环境中,它依然会作为一个字符串常量被加载到内存并参与语法校验。因此对于长期保留的代码注释,请严格遵循 PEP 8 规范,使用
#进行逐行注释。
五、总结:核心特性速查与选用建议
为了便于在实际编码中快速查阅和做决断,下表概括了 Python 三单引号与三双引号的核心异同:
| 比较维度 | 三双引号("""...""") |
三单引号('''...''') |
|---|---|---|
| 语法地位 | 标准多行字符串字面量 | 标准多行字符串字面量(完全等价) |
| 执行性能 / 内存 | 完全一致,生成相同的字节码 | 完全一致,生成相同的字节码 |
| PEP 257 Docstring | 官方强烈推荐标准 | 合法但不符合社区主流规范 |
| 内部单引号免转义 | 原生免转义(直接书写 ') |
连续三个单引号或结尾单引号需转义 |
| 内部双引号免转义 | 连续三个双引号或结尾双引号需转义 | 原生免转义(直接书写 ") |
| 典型最佳应用 | 文档注释、SQL 语句、英文长文本 | JSON 报文、HTML/XML 片段、双引号字符串 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









