

Python主流翻译库对比:googletrans vs deep-translator
全面对比Python主流开源翻译库googletrans与deep-translator的架构设计、API调用、多引擎支持及稳定性差异,并提供详细代码示例与选型指南。
在 Python 中实现多语言批量翻译或自动化文本本地化时,googletrans 与 deep-translator 是开发者最常评估的两个开源工具。前者长期以来作为调用 Google 翻译网页端接口的事实标准库存在,而后者则是一套设计现代化的多引擎聚合器,支持无缝切换 Google、DeepL、Bing、Libre 等十余种翻译服务。本文从底层机制、API 易用性、多引擎支持以及反爬稳定性四个核心维度展开详尽对比,帮助读者在具体业务中做出合理选型。
一、底层机制与架构设计对比
理解两个库的工作方式是判断其长期可用性的第一步。两者的核心差异并不单纯在于支持的引擎数量,更在于底层的网络抽象与接口封装理念。
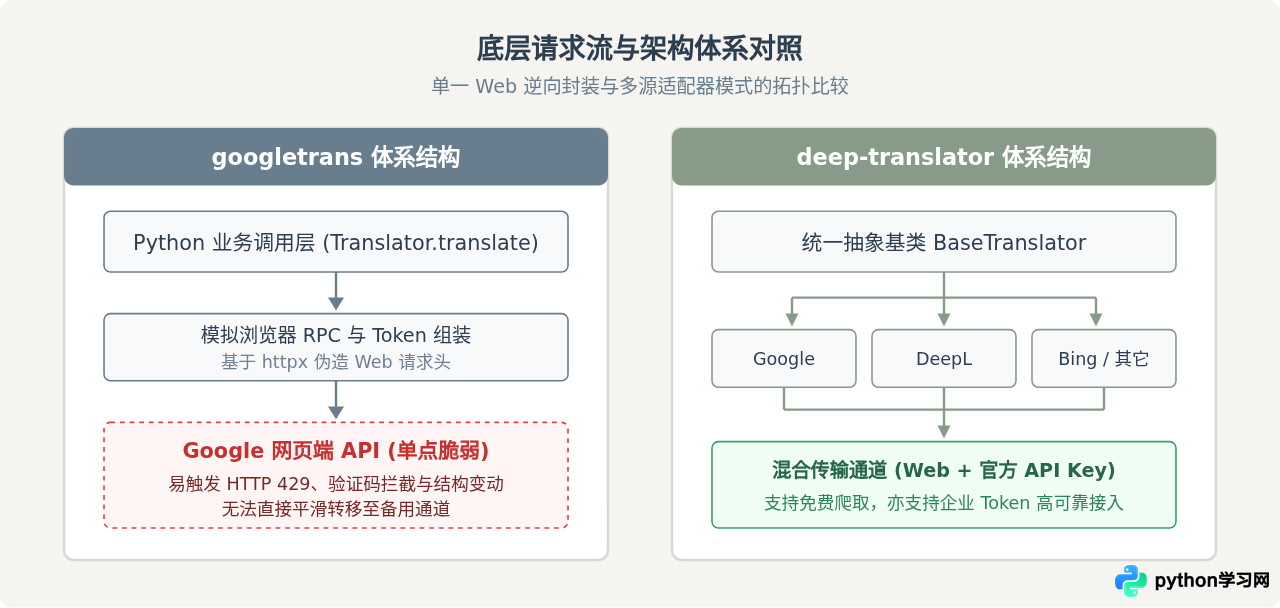
googletrans 是一个专注于 Google 翻译 web 端的反向封装库。它的底层早期基于 requests,后在 4.0.0-rc1 分支中重构为异步友好的 httpx。该库通过模拟浏览器环境向 Google 翻译的公开 RPC 接口发送数据,并内置计算参数(如历史版本的 TKK token)。这种单一模式虽然免去了所有配置,但完全受制于 Google 网页前端的接口变动与频次限制。
deep-translator 采用基于适配器(Adapter)的多后端聚合架构。它在顶层抽象出通用的 BaseTranslator,针对每家供应商(包括 Google Translate、DeepL、Microsoft Translator、MyMemory、Pons、Linguee 等)分别实现具体的抓取器或官方 API 客户端。不仅允许直接调用免费抓取通道,还允许直接传入商业 API Key。当某一个公共通道受限时,调用方无需重构业务代码即可切换到底层实现。
二、安装与基础使用对比
在环境配置方面,两个库有明显的安装注意事项。尤其是 googletrans,若直接运行 pip install googletrans,PyPI 默认拉取的是过时的 3.0.0 版本,该版本在面对当前的 Google 页面时几乎必然抛出 AttributeError: 'NoneType' object has no attribute 'group'。必须手动指定预发布候选版本。
1. 依赖安装与版本要求
# 安装 googletrans (必须指定 4.0.0-rc1,否则极易报错)
pip install googletrans==4.0.0-rc1

# 安装 deep-translator (安装最新发布版即可)
pip install deep-translator
2. 核心调用示例
以下分别展示使用两个库将英文句子“Hello world, this is a test.”翻译为中文的基础代码:
googletrans 调用代码:
from googletrans import Translator

# 初始化翻译器
translator = Translator()

# 执行翻译:src 为可选参数,dest 指定目标语言
result = translator.translate("Hello world, this is a test.", src="en", dest="zh-cn")

# 输出翻译结果与源语言
print("翻译文本:", result.text)
print("检测语言:", result.src)
示例输出:
翻译文本: 你好世界,这是一个测试。
检测语言: en
deep-translator 调用代码:
from deep-translator import GoogleTranslator

# 初始化指定源语言与目标语言
translator = GoogleTranslator(source="en", target="zh-CN")

# 直接获取译文纯文本
translated_text = translator.translate("Hello world, this is a test.")

print("翻译文本:", translated_text)
示例输出:
翻译文本: 你好世界,这是一个测试。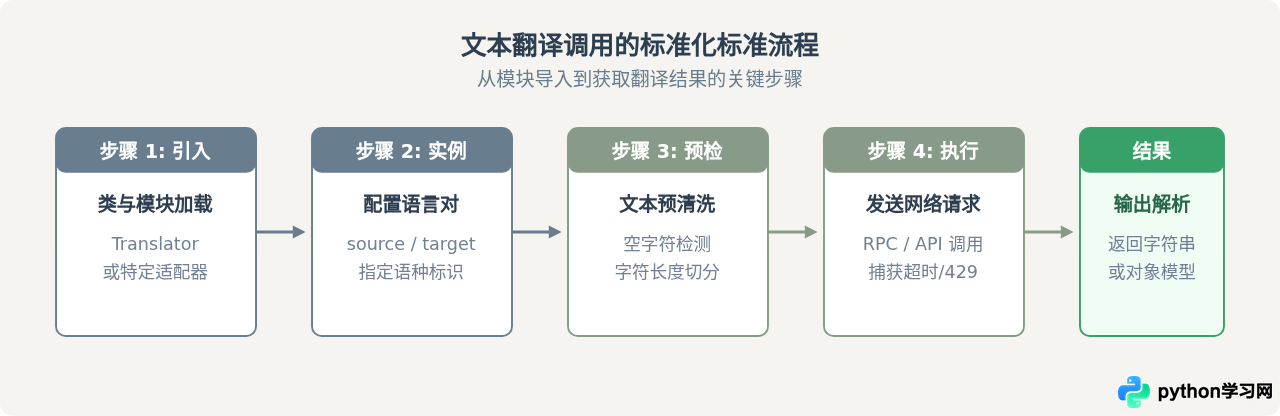
三、核心差异维度深度分析
1. 多引擎生态与切换成本
googletrans 从名字上就已经锁定了后端,它无法调用除 Google 以外的任何翻译引擎。如果你的网络环境访问 Google 节点受到限制,或者对中文-德文等小语种翻译质量有更高要求(如倾向于使用 DeepL),该库完全无能为力。
deep-translator 则具备显著的引擎解耦特性。在保持代码结构不变的情况下,仅通过导入不同的子模块即可更换引擎:
from deep-translator import (
    GoogleTranslator,
    DeeplTranslator,
    MicrosoftTranslator,
    MyMemoryTranslator
)

# 使用 Google
res_google = GoogleTranslator(source='auto', target='zh-CN').translate("Good morning")

# 平滑切换至 DeepL (使用 API 认证)
res_deepl = DeeplTranslator(api_key="your_deepl_api_key", source="en", target="zh", use_free_api=True).translate("Good morning")

# 平滑切换至 MyMemory (无需 key,带每日词数配额)
res_mymemory = MyMemoryTranslator(source='en-GB', target='zh-CN').translate("Good morning")
2. 稳定性与反爬限制处理
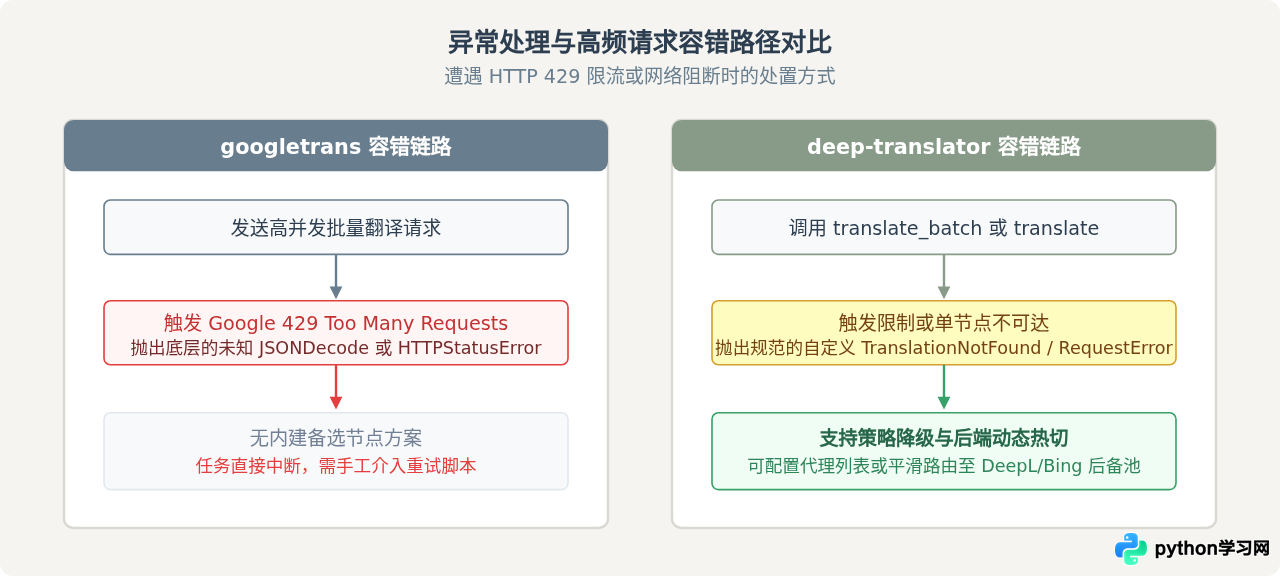
稳定性是绝大多数开发者从 googletrans 迁移到 deep-translator 的根本原因。由于两者抓取免费通道的原理都是向公共端点发包,当遇到短时间高密度的请求时,两者的容错机制差异明显:
- HTTP 429 请求过多:
googletrans在遇到限流时通常直接抛出底层httpx.HTTPStatusError或 JSON 解码异常,用户必须自己在最外层编写重试与退避算法。 - 节点切换与代理:
deep-translator提供了更内聚的批量翻译辅助方法,并对请求超时有更为规范的自定义异常封装(如ElementNotFoundInGetException,RequestError等),方便精细化捕获。 - 批量翻译接口:
deep-translator内置了translate_batch(list_of_strings)与translate_file(path)方法,内部自动切分行与处理序列,比手动循环写调用更为稳妥。
3. 综合特性对照矩阵
| 功能特性 | googletrans (4.0.0-rc1) | deep-translator (最新版) |
|---|---|---|
| 核心定位 | 针对 Google Translate 的单一专用封装 | 多后端翻译服务的抽象与聚合器 |
| 支持后端 | 仅 Google Translate | Google, DeepL, Microsoft, Libre, Baidu 等 10+ 款 |
| 商业 API 鉴权 | 不支持(仅支持模拟网页请求) | 原生支持(如 DeepL API Key, Microsoft Azure 等) |
| 底层网络依赖 | httpx / httpcore | requests / beautifulsoup4 |
| 文件直接翻译 | 需手动读取文本后传参 | 内置 translate_file() 支持 |
| 异步支持 | 新版具备 AsyncTranslator | 主要为同步阻塞,需配合 asyncio/多线程 |
| 社区维护活跃度 | 更新周期长,版本发布不稳定 | 持续维护,频繁跟进各翻译商前端结构变化 |
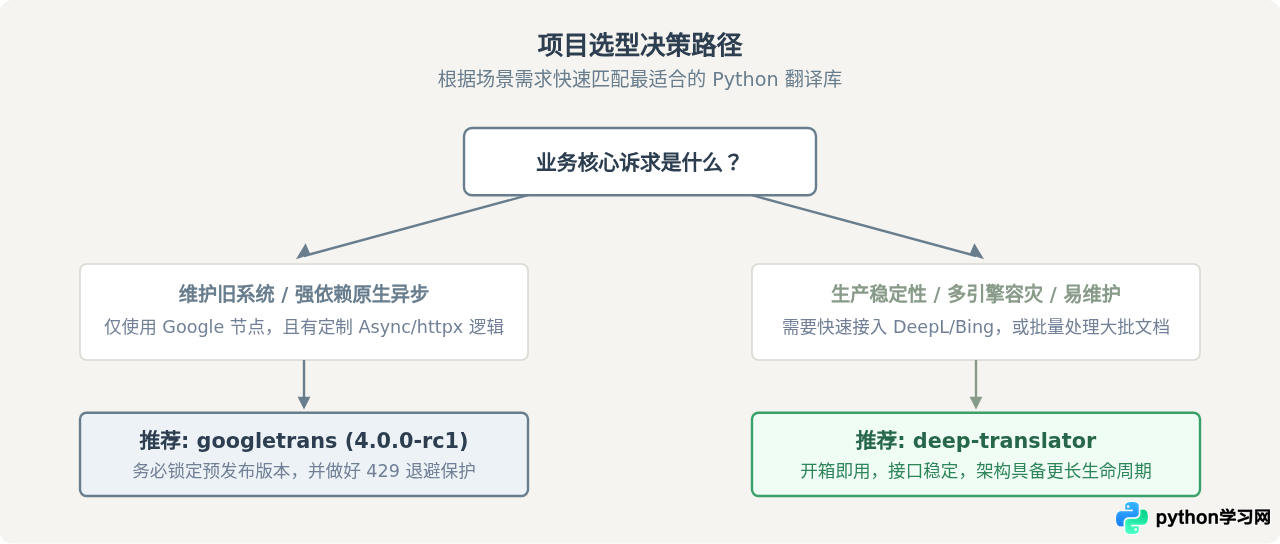
四、实践建议与选型决策指南
通过上述技术层面的拆解,可以得出明确的使用原则:
- 优先选择 deep-translator 的场景:
- 生产环境自动化流水线: 需要保障长期稳定运行,能够容纳后端不可用时的降级重试。
- 专业翻译质量需求: 需要接入 DeepL 等对技术文档、欧洲小语种表现更佳的高级引擎。
- 格式多样化任务: 需要直接对文本文件(.txt 等)进行快速整篇本地化转换。
- 可考虑 googletrans 的场景:
- 纯异步高并发探索: 已经在完全基于
asyncio+httpx的技术栈中,需要利用其AsyncTranslator进行实验性探索。 - 存量代码维护: 维护旧项目中已经深度绑定了其返回对象(
Translated对象模型及其元数据属性)的代码库。
- 纯异步高并发探索: 已经在完全基于
五、批量处理场景的防封控操作要点
无论选用哪一个库,如果调用的是免费公共端点,都必须遵循基础的网络爬虫礼仪。以下是两个核心的防封控编码准则:
1. 加入随机延迟与分批机制:
import time
import random
from deep-translator import GoogleTranslator

translator = GoogleTranslator(source='auto', target='zh-CN')
sentences = ["Text line 1", "Text line 2", "Text line 3"]

translated_results = []
for item in sentences:
    try:
        translated_results.append(translator.translate(item))
        # 强制休眠 0.5 到 1.5 秒,避免高频触发端点封锁
        time.sleep(random.uniform(0.5, 1.5))
    except Exception as e:
        print(f"翻译失败: {item}, 错误: {e}")
        # 遇错时延长休眠后重试
        time.sleep(5)
2. 统一代理配置(Proxy): 当在服务器部署时,可通过传递标准 HTTP/HTTPS 代理字典隐藏源 IP 或使用住宅轮换代理规避 429 封禁。
对于绝大多数新启动的 Python 自动化项目,deep-translator 是更为稳健、可维护性更高的选择。它不仅免去了 googletrans 历史遗留的版本锁定困扰,其模块化的适配器设计也为日后业务升级商业翻译 API(如 DeepL、Azure)预留了平滑演进空间。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









