

Python map函数常见报错及None作为参数的特殊用法
深入解析Python map函数的运行机制、高频TypeError报错原因与排查方案,并详解None作为map参数在Python 2与Python 3中的行为差异与现代替代方案。
在 Python 开发中,map() 是高阶函数中应用频率极高的一员。它通过将指定逻辑批处理映射到可迭代对象上,提供了优雅且高效的函数式编码体验。然而在实际工程与日常编码中,不少开发者常会遭遇 TypeError: 'map' object is not subscriptable、TypeError: <func>() missing required positional argument 等异常,或者在重构老代码时困惑于 map(None, ...) 的奇异语法。本文将系统拆解 map() 在 Python 3 中的核心运行模型,逐一剖析常见高频报错的触发原因与排查路径,并深入解析 None 作为参数的历史渊源与现代替代方案。
一、Python 3 中 map() 的底层机制与运行模型
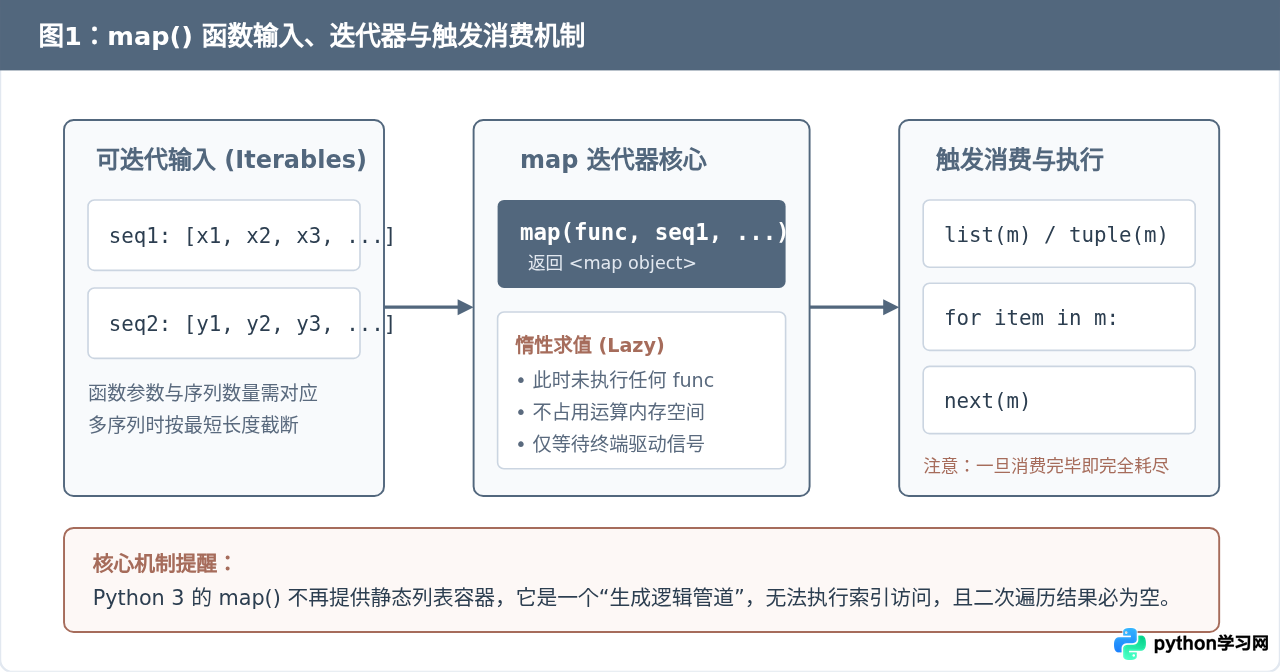
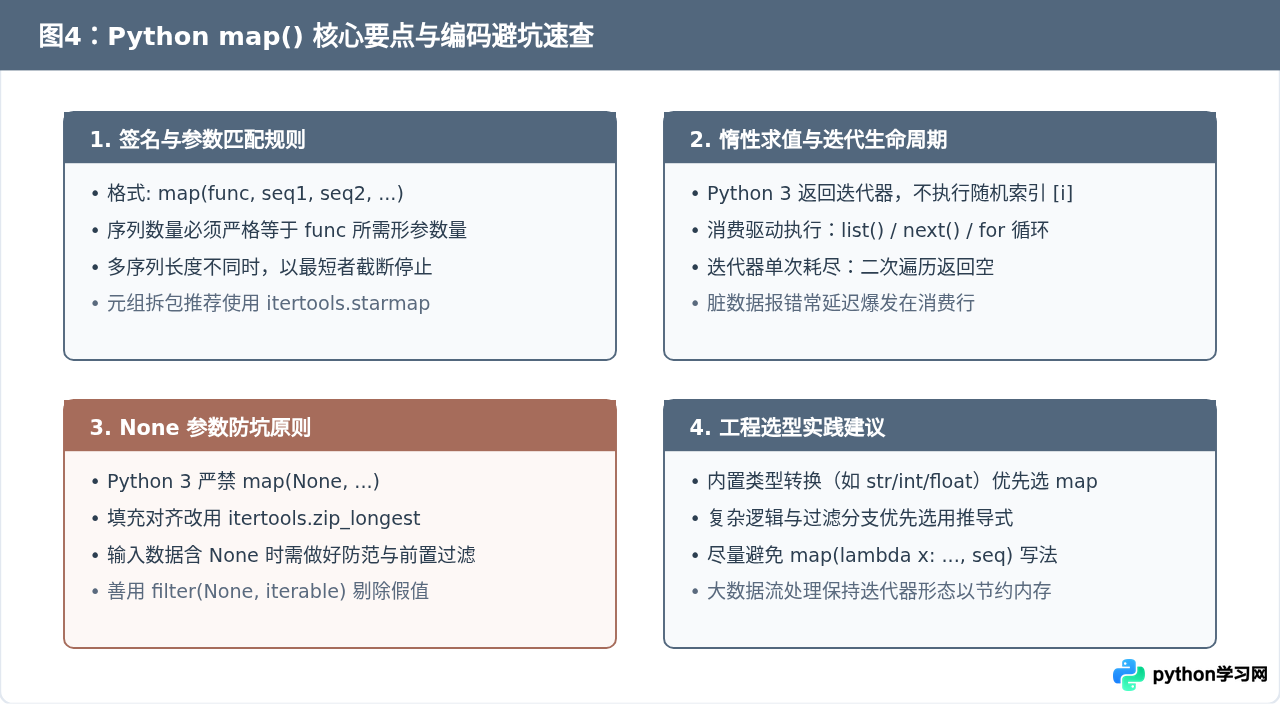
理解 map() 引发各类报错的前提,在于理清其在不同 Python 版本中的返回值定义与求值机制。在 Python 2 中,map() 执行完毕后会直接在内存中生成并返回一个真实的 list 列表;但自 Python 3 起,为了避免大容量数据集造成的内存剧烈开销,map() 被全面重构成基于生成器协议的惰性求值(Lazy Evaluation)迭代器。
其标准函数签名定义如下:
map(function, iterable, *iterables)当调用 map(func, data) 时,Python 解释器在当下并不会遍历 data,也没有立即执行任何一次 func 逻辑,它仅仅返回了一个封装好的 map object。真正的函数计算完全被推迟到了“下游消费”阶段(例如执行 for 循环、调用 next() 或通过 list() 显式转换时)。
二、map() 常见高频报错与精准排查方案
在日常使用中,因对迭代器特性或参数签名规则理解偏差,往往会遇到以下几类典型报错。
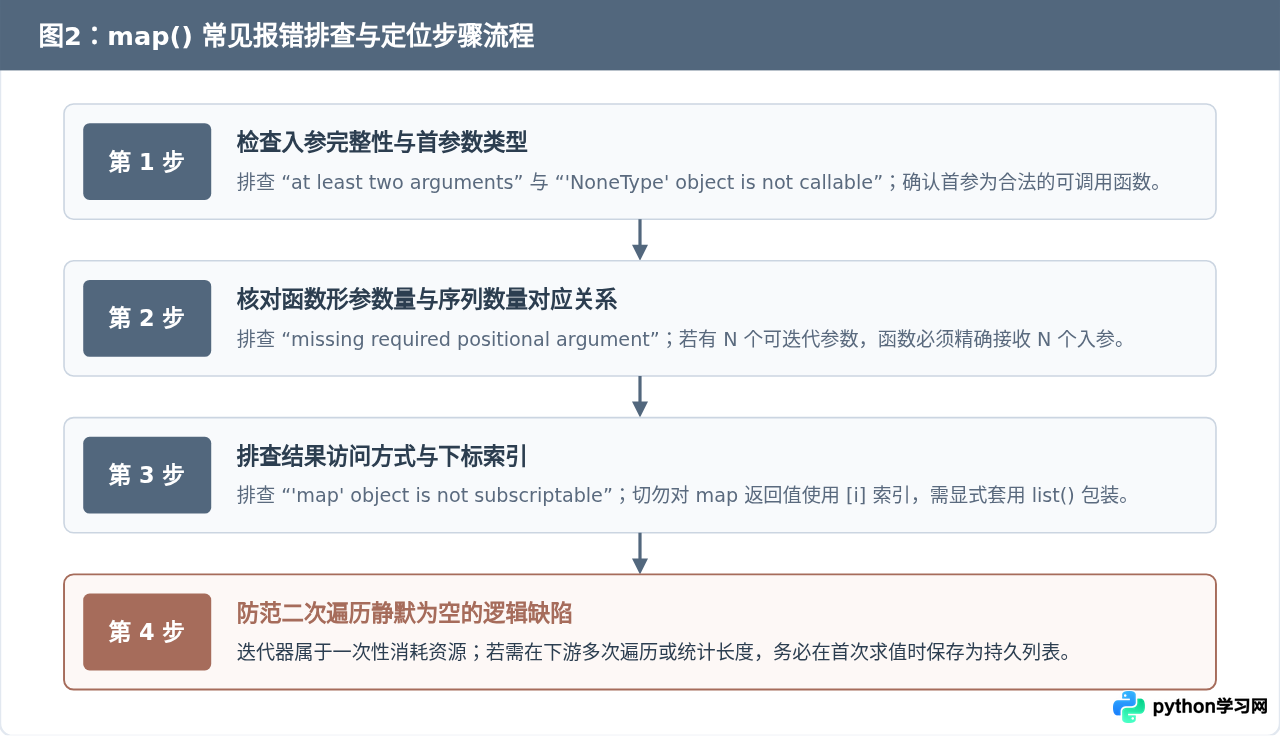
1. TypeError: 'map' object is not subscriptable
报错表现:试图通过下标索引或切片访问 map() 的返回值时触发异常。
nums = [10, 20, 30]
res = map(str, nums)
first_item = res[0] # 触发 TypeError: 'map' object is not subscriptable根本原因:只有实现了 __getitem__ 协议的序列类型(如 list、tuple、str)才支持通过索引 [0] 或切片 [1:3] 访问。而 map 仅实现了迭代器协议(__iter__ 与 __next__),内部并不缓存数据,因此无法进行随机定位或按索引回溯。
修复方案:若必须使用下标或获取总体长度 len(),需显式将其转换为列表,或使用 next() 步进提取首项:
# 方案 A:需要频繁索引或切片
res_list = list(map(str, nums))
first_item = res_list[0]

# 方案 B:仅提取第一项
first_item = next(res)
2. TypeError: <func>() missing required positional argument 或 takes X positional arguments but Y were given
报错表现:在多序列调用或自定义函数调用时,出现参数数量不匹配的报错。
def add(x, y):
    return x + y

# 错误示例 1:只传了一个序列,但函数需要 2 个参数
# 抛出 TypeError: add() missing 1 required positional argument: 'y'
res = list(map(add, [1, 2, 3]))

# 错误示例 2:传入了 2 个序列,但函数只接收 1 个参数
# 抛出 TypeError: abs() takes exactly one argument (2 given)
res = list(map(abs, [-1, -2], [1, 2]))根本原因:当向 map(func, seq1, seq2, ... seqN) 传入 N 个可迭代对象时,map 在每次迭代中会同时从这 N 个序列各取出一个元素,并以位置参数的形式并发传给 func,即等价于执行 func(seq1[i], seq2[i], ... seqN[i])。如果序列的个数与 func 的形参个数不严格相等,就会发生调用签名冲突。
修复方案:确保传递的可迭代对象数量与目标函数的形参定义完全匹配;若入参是包含元组的单一序列,应结合 starmap 或解包逻辑使用:
# 正确的多序列并行映射:
a = [1, 2, 3]
b = [10, 20, 30]
result = list(map(add, a, b))  # 输出 [11, 22, 33]

# 若数据本身是配对元组列表 [(1, 10), (2, 20)],推荐使用 itertools.starmap
from itertools import starmap
pairs = [(1, 10), (2, 20)]
result = list(starmap(add, pairs))
3. TypeError: map() must have at least two arguments
报错表现:在调用 map() 时少传了参数(例如仅传了函数名,或未传可迭代对象)。
res = map(str) # 抛出 TypeError: map() must have at least two arguments根本原因:map 至少需要接收一个映射函数与一个可迭代对象,参数数量不足 2 个时会在解析期直接中断。
4. 数据内部异常与隐蔽的“空值陷阱”(二次消费失效)
除了显式的语法与调用异常,map() 还有两个容易让人陷入困惑的运行特征:
- 数据脏值延迟爆发:因为惰性求值特性,包含错误数据(如
map(int, ['1', '2', 'abc']))的map语句在定义行不会报任何错误,而在数百行后的某个for循环中才突然抛出ValueError,容易误导排查方向。 - 迭代器单次消耗陷阱:
map对象在遍历一次后指针便停在末尾。若后续再次对该变量执行遍历或list(),将直接返回空列表[],不报任何错误但导致业务逻辑静默失效。
三、None 作为参数的特殊用法与版本演进
在阅读历史遗留代码或特定算法题解时,常常会见到形如 map(None, list1, list2) 的写法。这是 Python 语言发展史上一个极具代表性的特殊语法设计。
1. Python 2 中 map(None, ...) 的特殊行为
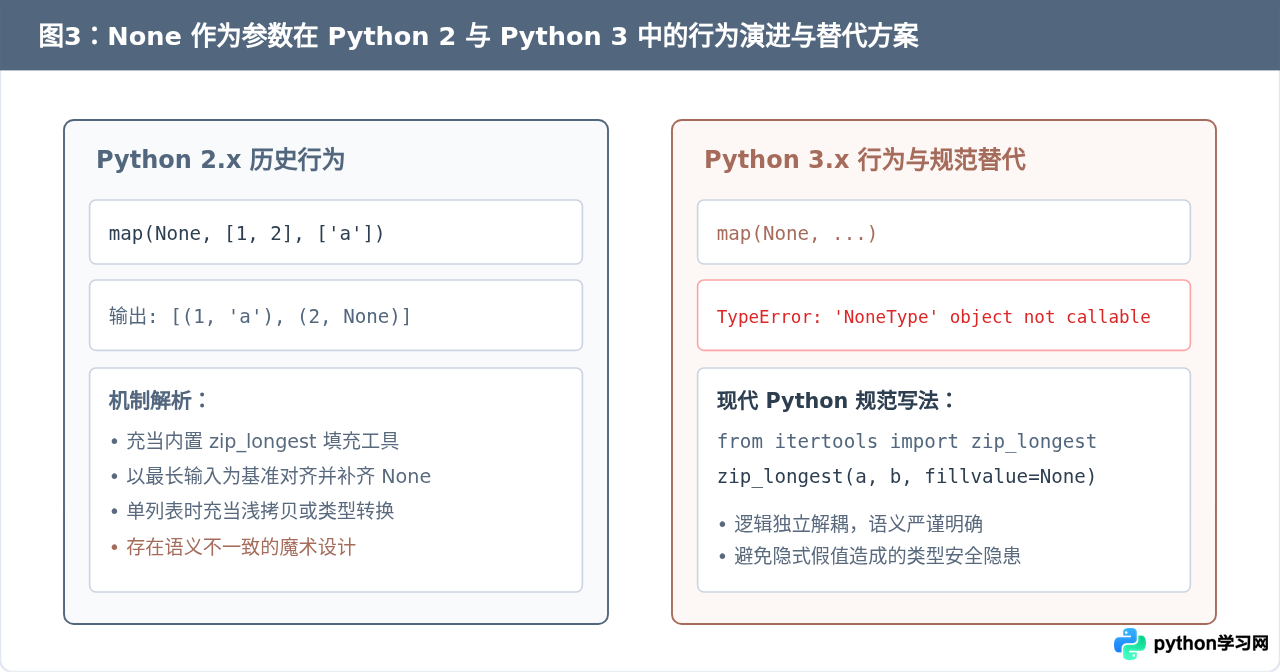
在 Python 2 中,当传入 None 作为 map() 的第一个函数参数时,它具有内置的特殊语义:
- 单序列场景:若仅传一个序列
map(None, [1, 2, 3]),它相当于恒等映射(Identity function),将可迭代对象直接转换为等长列表。 - 多序列对齐场景(核心特性):当传入多个序列时,
map(None, seq1, seq2)的作用类似于“能够用None自动填充短序列”的并行拉链操作。
在 Python 2 下的执行效果如下:
# Python 2 运行环境示例
>>> a = [1, 2, 3]
>>> b = ['x', 'y']
>>> map(None, a, b)
[(1, 'x'), (2, 'y'), (3, None)]
与内置 zip() 遇到短序列即截断的策略不同,Python 2 的 map(None, ...) 会以最长序列为准,自动将较短序列不足的位置填充为 None。在当时缺乏专用标准库工具的背景下,这是实现不等长数据对齐与矩阵转置的经典黑魔法技巧。
2. Python 3 中的行为断裂与报错
在 Python 3 中,语言设计哲学强调“显式优于隐式”与语法的纯粹性。官方废弃了 None 隐式作为恒等映射和填充函数的魔术行为,要求 map 的第一个参数必须是严格满足可调用协议的函数(Callable)。
如果在 Python 3 中依然执行 map(None, ...),解释器将在消费阶段直接抛出致命错误:
# Python 3 运行环境
>>> a = [1, 2]
>>> b = ['x', 'y']
>>> res = list(map(None, a, b))
Traceback (most recent call last):
  File "<stdin>", line 1, in <module>
TypeError: 'NoneType' object is not callable
3. Python 3 的标准现代替代方案
若在 Python 3 中需要实现原 Python 2 下 map(None, ...) 的数据对齐功能,标准做法是使用标准库 itertools.zip_longest:
from itertools import zip_longest

a = [1, 2, 3]
b = ['x', 'y']

# 使用 zip_longest 精准还原历史行为,缺失项默认以 None 填充
aligned = list(zip_longest(a, b, fillvalue=None))
print(aligned)
# 示例输出:[(1, 'x'), (2, 'y'), (3, None)]与“函数位传入 None”不同,如果数据序列本身含有
None(例如 data = [1, None, 3, None]),调用数学运算或类型转换 map(int, data) 必然抛出 TypeError: int() argument must be a string, a bytes-like object or a real number, not 'NoneType'。此时可使用 filter(None, data) 预先过滤所有假值(包括 None、0、空字符串),或通过条件函数做兜底回退:
safe_mapped = [x if x is not None else 0 for x in data]
四、map() 核心避坑指南与写法选型总结
在现代 Python 代码中,列表推导式(List Comprehension)与 map() 在绝大部分映射任务中都具备互换性。如何权衡二者的使用场景,并在编写时避开常见隐患?以下是具体选型建议与速查原则:
- 优先使用
map()的场景:当目标映射逻辑是一个现成的已命名函数或内置 C 扩展函数(例如map(str, nums)、map(int, lines))时,map()不需要创建临时闭包和帧堆栈,其性能表现往往优于列表推导式;同时,处理海量流式数据时,利用map()的惰性计算可以极大降低内存占用。 - 优先使用列表推导式的场景:当涉及复杂的
lambda表达式、多层条件过滤或需要多次索引结果切片时,列表推导式(如[x * 2 for x in nums if x > 0])语法直观易读,且生成的列表直接常驻内存,规避了迭代器一次性耗尽的隐式缺陷。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









