

Python 3语言参考手册与Python 2的主要区别及迁移注意事项
深入解析Python 3语言参考手册相对Python 2的核心底层变革与语法规范差异,梳理文本与字节解耦、迭代器优化、除法与异常等演进,并提供工程化迁移步骤与避坑检查指南。
Python 3 与 Python 2 最本质的演进并不止于简单的语法糖或库重构,而是官方《Python 语言参考手册》中对于底层对象模型、类型系统边界及运算语义的系统化纠偏。其中最核心的变动包括:彻底解耦文本与二进制数据、规范化内置语句为通用函数、严格收紧异类比较语义以及全面推进惰性迭代。将存量 Python 2 资产迁移至 Python 3,首要任务是识别隐式编码混用的陷阱、修正被废弃的语言结构,并通过标准工程化步骤实现稳健切换。本文系统梳理两代解释器的核心语言规范差异,并给出完整的代码迁移实践指南。
一、核心语言规范与语法层面的根本变化
官方在制定 Python 3 规范时,明确了“显式优于隐式”与“拒绝猜测”的设计哲学。这一原则直观体现在类型系统的底层重构与基础语法的收敛中。
1. 文本(Text)与字节(Bytes)的严格解耦
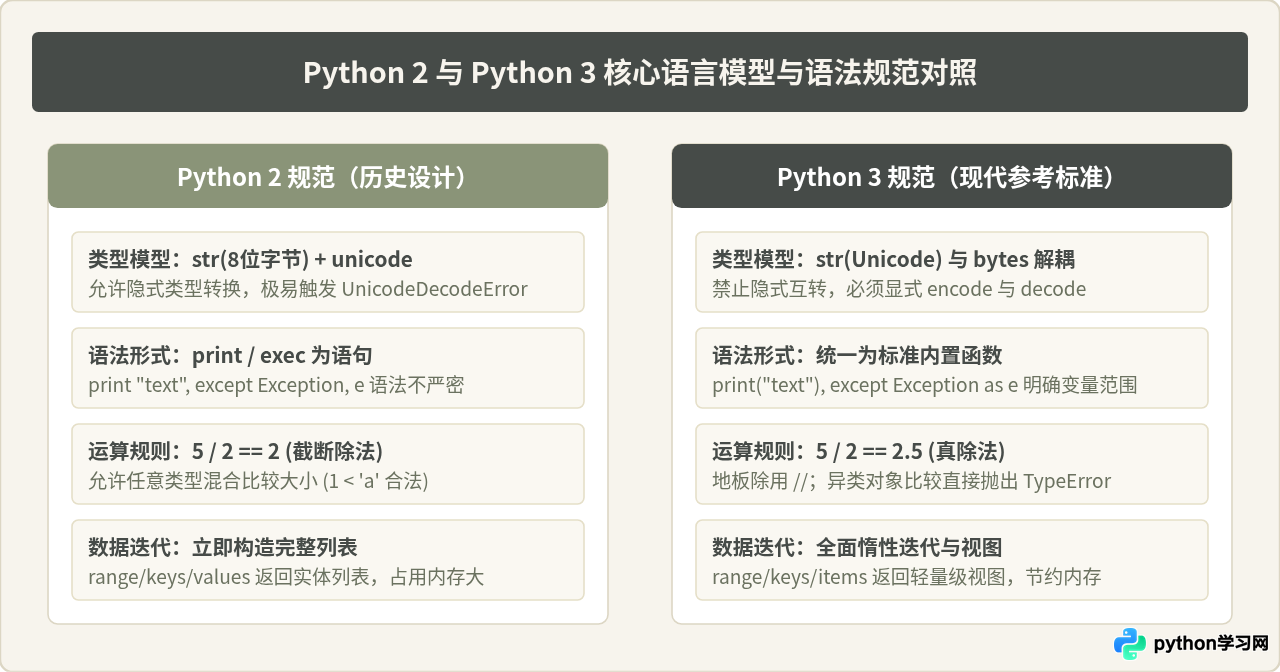
在 Python 2 语言规范中,str 类型本质上是 8 位字节串,而 unicode 代表多字节宽字符序列。解释器允许两者在不显式转码的情况下进行拼接或比较,当代码中包含非 ASCII 字符时,底层会依据 sys.getdefaultencoding()(默认通常为 ascii)进行隐式解码,从而频繁触发不可预测的 UnicodeDecodeError。
Python 3 彻底重构了该对象模型:str 变为纯粹的 Unicode 字符序列,而纯二进制数据由 bytes 与 bytearray 承载。两者属于互不兼容的独立类型,无法直接做 + 操作,也无法直接相互比较。这种设计将编码转换责任明确限制在系统的外部 I/O 边界上。
2. 语法元素与内置操作的规范化
Python 2 中存在若干以独立语句(Statement)形式存在的关键字,在 Python 3 中被重构为标准的内置函数(Built-in Functions):
- print 语句变更为内置函数:Python 2 采用
print "message";Python 3 统一规范为print(*objects, sep=' ', end='\n', file=sys.stdout, flush=False),这使得格式控制、参数定制和函数引用更加一致。 - exec 语法规范:Python 2 允许
exec code in scope;Python 3 将其统一为函数调用形式exec(object[, globals[, locals]])。 - 异常捕获语法收敛:Python 2 允许使用逗号分隔异常与目标变量
except Exception, e:,在多异常捕获时极易造成语义混淆;Python 3 强制要求使用as关键字,即except Exception as e:。
3. 除法运算语义的精确区分
在 Python 2 中,/ 操作符对于两个整型操作数执行的是地板除(Floor Division),即 5 / 2 == 2;若要获得精确浮点结果,必须显式引入浮点数参与运算。而在 Python 3 语言参考手册中:
- 单斜杠
/统一为真除法(True Division),无论操作数是否为整型,均返回浮点结果(例如5 / 2 == 2.5)。 - 双斜杠
//专用于截断取整的地板除(例如5 // 2 == 2)。
4. 异类对象比较与排序规则收紧
Python 2 允许对完全不同类型的对象执行大小比较,例如整数可以与字符串直接比较大小(1 < 'a' 会根据内部类型名称进行排序并返回布尔值),这常在复杂数据排序时掩盖潜藏的逻辑错误。Python 3 取消了无内在次序的异类比较,执行 1 < 'a' 将直接抛出 TypeError: '<' not supported between instances of 'int' and 'str'。
二、深入剖析:文本编码模型转变与常见认知辨析
字符编码是 Python 迁移过程中出现回归错误最频繁的领域。理解 Python 3 的内存数据模型不仅有助于规避 Bug,也是理解标准库 I/O 设计的基础。
# -*- coding: utf-8 -*- 并引入 from __future__ import unicode_literals,就能获得与 Python 3 完全一致的字符串处理表现。”分析与修正:这种说法在“源文件字面量解析为 Unicode”这一单点上确实成立,但并不等同于 Python 3 的行为。在 Python 2 下,即使启用了
unicode_literals,标准库与第三方库中的许多底层 API(如 os.environ、socket.recv 或基于 C 扩展的模块)仍然期望接收原生的 str(即 8 位字节序列)。当把 unicode 传递给这些接口时,解释器仍会隐式尝试使用 ASCII 进行降级编码,最终同样会抛出错误。真正的 Python 3 环境实现了全生命周期的类型分离,这不仅是字面量定义的改变,更是整个标准库体系的重写。
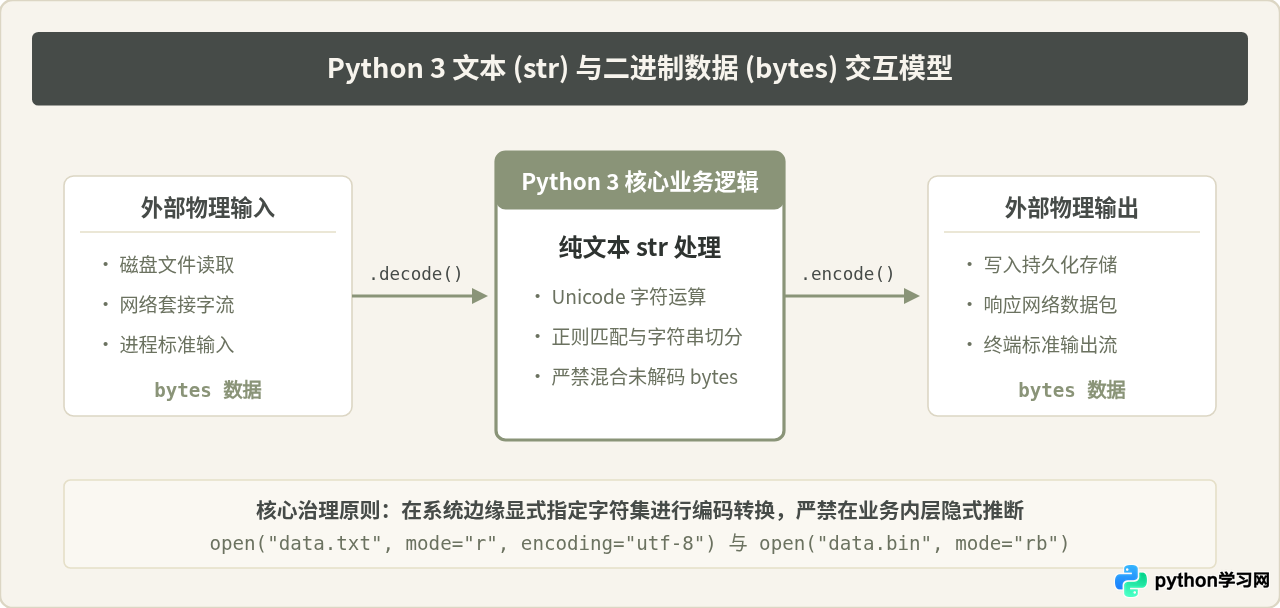
在 Python 3 中构建健壮程序,应遵循通用的“Unicode 三明治”(Unicode Sandwich)原则:
- 输入端尽早解码:当从文件、网络套接字或外部进程读取原始字节序列时,应在进入核心逻辑的最外层通过
bytes.decode(encoding)转换为纯文本。 - 核心业务层纯粹运算:程序内部所有业务算法、数据清洗及格式化拼装只操作
str对象,绝不夹杂任何原始字节序列。 - 输出端晚期编码:只有在将数据序列化持久化至磁盘文件或通过网络发送时,才通过
str.encode(encoding)输出为具体协议要求的bytes。
三、代码迁移标准化实施流程
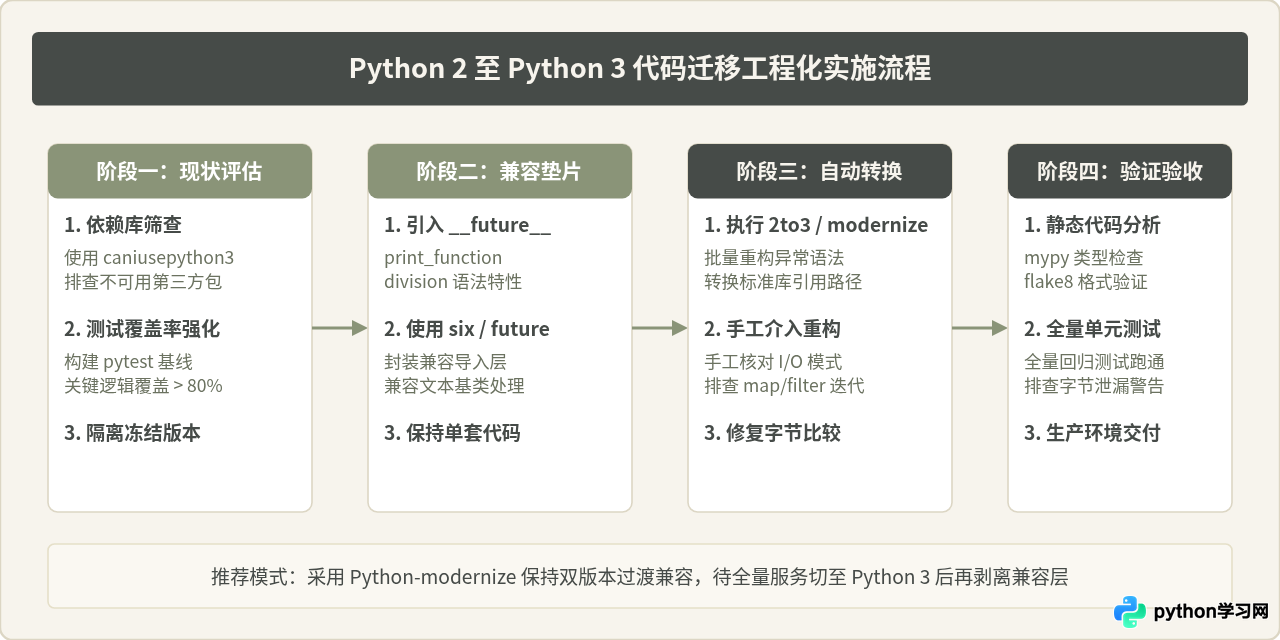
将 Python 2 代码库迁移至 Python 3 不宜采取直接全量重写的粗暴方式,而应遵循循序渐进的工程化流水线,确保在每个迁移节点均有测试用例作为安全保障。
步骤一:评估与环境准备
在开始动工修改代码前,首先确认所有第三方扩展模块均已支持 Python 3。可通过命令工具快速检测依赖状态:
# 在激活的 Python 2 虚拟环境中评估依赖就绪度
pip install caniusepython3
caniusepython3 -f requirements.txt
输出示例(仅供参考):
Finding dependencies...
Not everything has been ported to Python 3!
Blocking dependencies:
  legacy-crypto (upgrade to pycryptodome)
若存在未适配 Python 3 的依赖库,必须寻找现代替代品(例如用 Pillow 替代 PIL,用 pycryptodome 替代 pycrypto)。同时,需确保现有单元测试全部通过,并作为迁移基线。
步骤二:编写双版本兼容层
若项目处于大型维护期,无法瞬间完成全链路切换,推荐使用 six 或 future 工具库维护单套源码(Single Source Python 2/3)。在 Python 2 代码头部声明现代语法特性:
# 引入 Python 3 关键语法行为
from __future__ import absolute_import, division, print_function

import sys
import six

# 统一文本基类判断
if isinstance(data, six.text_type):
    process_text(data)
elif isinstance(data, six.binary_type):
    process_binary(data)
步骤三:自动化转换工具辅助重构
官方提供了 2to3 自动化工具,可通过规则修复器(fixers)批量处理语法差异。执行转换前建议先生成差异补丁审查变动:
# 生成语法差异补丁,不直接覆写源文件
2to3 -d path/to/project

# 批量执行修改并保留原文件备份
2to3 -w -n path/to/project
对于希望保留 Python 2/3 兼容性的系统,更推荐使用 python-modernize:
pip install modernize
python-modernize -w -f default path/to/project
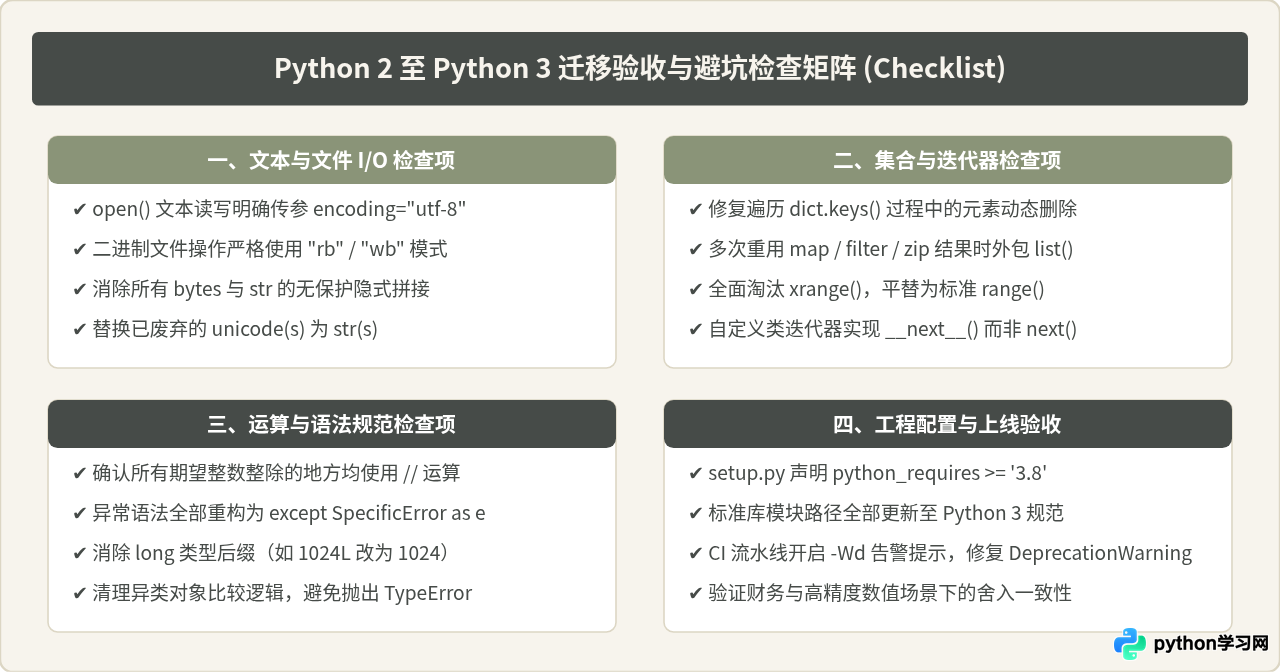
四、关键细节陷阱与迁移避坑检查清单
在完成基础的语法替换后,通常仍有若干难以被自动化工具识别的隐式语义陷阱。开发团队需要针对这些特性进行专项排查。
1. 字典迭代器与视图属性
在 Python 2 中,dict.keys()、dict.values() 和 dict.items() 均返回独立的内存列表。而在 Python 3 中,它们返回的是字典动态视图(Dictionary Views)。如果代码在遍历视图的过程中直接修改字典本身(如 del d[k]),Python 3 会抛出 RuntimeError: dictionary changed size during iteration。必须显式将其转为独立列表:list(d.keys())。
2. map、filter 与 zip 的返回值惰性化
Python 3 中 map()、filter() 和 zip() 不再返回列表,而是返回一次性消费的迭代器对象。在多轮遍历或需要切片访问时必须显式调用 list():
# Python 2 中有效,Python 3 中产生类型错误
res = map(lambda x: x * 2, [1, 2, 3])
print res[0] # Python 3: TypeError: 'map' object is not subscriptable

# Python 3 标准兼容写法
res = list(map(lambda x: x * 2, [1, 2, 3]))
print(res[0])
3. round() 舍入规则变化(银行家舍入)
Python 2 中的 round() 采用传统的四舍五入算法(Away from zero),而 Python 3 采用了 IEEE 754 推荐的“四舍六入五成双”(Round half to even,银行家舍入法)。当待舍入小数处于中间值时,向最近的偶数取整:
# Python 2
round(2.5) == 3.0
round(3.5) == 4.0

# Python 3
round(2.5) == 2
round(3.5) == 4
如果业务系统涉及财务核算或特定统计口径,必须使用 decimal 模块显式配置 ROUND_HALF_UP,避免计算结果产生系统性偏差。
4. 标准库模块重命名对照
Python 3 对分散的标准库模块进行了归集与结构整理:
| Python 2 模块名 | Python 3 对应规范路径 | 主要用途 |
|---|---|---|
urllib, urllib2 |
urllib.request, urllib.parse, urllib.error |
网络请求与 URL 处理 |
ConfigParser |
configparser |
配置文件解析 |
cPickle, pickle |
pickle(底层已自动使用 C 优化) |
对象序列化 |
Queue |
queue |
线程安全同步队列 |
SocketServer |
socketserver |
网络服务端基类 |
__builtin__ |
builtins |
内置命名空间 |
五、总结
从 Python 2 走向 Python 3,本质上是遵循更加严谨、明确且安全的语言设计规范。完成语言层面的适配不仅消除了安全隐患与生态断代风险,更使系统能够充分利用 Python 3 在类型提示(Type Hints)、异步编程(asyncio)以及底层性能优化上的长期收益。遵循“现状摸底、测试固化、边缘转码、工具重构与全量验收”的完整路径,便能够平稳实现老旧工程的现代化升级。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









