

学Python有出路吗?当前就业市场真实需求与行业趋势分析
客观深入分析当前Python在就业市场的真实需求现状、岗位分化趋势、企业招聘能力标准及切实可行的四阶段突围学习路径,帮助求职者与转行者认清定位、理性决策。
一、当前就业市场的供需现状:从“通用普及”转向“深度复合”
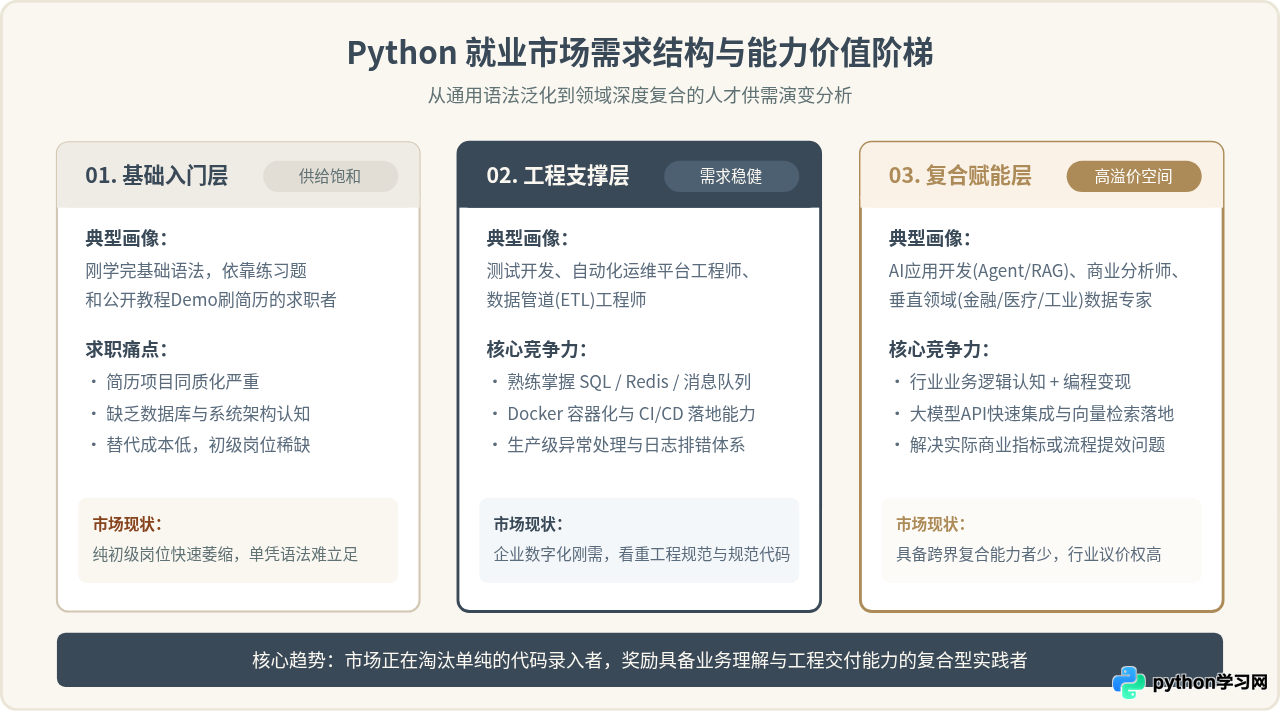
在过去数年中,Python以其清晰简洁的语法特性在高校、职业培训以及自学者群体中迅速普及。然而,这种低学习门槛也带来了求职端初级人才的严重堆积。打开各大招聘软件可以直观发现,标有“Python开发工程师”的初级纯业务开发岗位明显缩减,而要求“Python + SQL + 业务数据建模”、“Python + LangChain + RAG检索增强”、“Python + Linux + 测试平台开发”的复合型岗位数量与薪资溢价却保持稳定。
从企业雇主的招聘诉求来看,市场需求已经形成三个截然不同的层次:
- 基础脚本与初级爬虫层:面临严重的供大于求。随着网络风控与数据合规门槛提升,仅掌握简单Requests与BeautifulSoup调用的初学者很难直接满足商业数据采集的安全与稳定性要求。
- 工程底座与数据支撑层:需求稳健且门槛明确。主要覆盖自动化测试开发、DevOps平台构建、数据清洗与ETL管道维护,企业看重应聘者的代码规范、数据库性能调优及持续集成经验。
- AI与智能化赋能层:随着大语言模型(LLM)与生成式技术的落地,企业需要大量能够使用Python调用模型接口、搭建Agent工作流、管理向量数据库以及编写本地评测系统的工程师,形成新的高溢价需求窗口。
二、为什么单纯掌握语法难以获得面试机会?
很多学习者在完成几门语法教程后,往往会产生“我已经掌握了Python”的错觉,但投递简历时却屡屡碰壁。企业在技术筛选时,重点关注的并不是候选人能否背诵列表推导式、字典遍历或装饰器写法,而是以下三项核心工程指标:
-
生产级代码组织规范:教程中的代码通常只有一个简单的
main.py脚本,缺少清晰的模块划分、类型注解(Type Hints)、配置分离、结构化日志以及单元测试。企业维护的是大型持久系统,需要的是能融入团队协作规范的代码,而不是一次性的演示脚本。 - 对底层计算机基础的综合掌握:Python作为高级解释型语言,掩盖了底层细节,但这不代表底层不重要。在实际工作中,网络协议(HTTP/TCP状态码与长连接)、关系型数据库核心概念(SQL多表关联、索引失效原因、事务隔离级别)、Linux环境操作(进程排查、文件权限、Shell脚本)是判断候选人能否独立排错的试金石。
- 真实业务场景的闭环经验:简历中常见的“学生信息管理系统”、“个人博客”或“简单天气爬虫”缺乏商业价值,面试官难以从中看出候选人应对网络异常、数据倾斜、并发瓶颈或数据持久化容灾的处理思路。
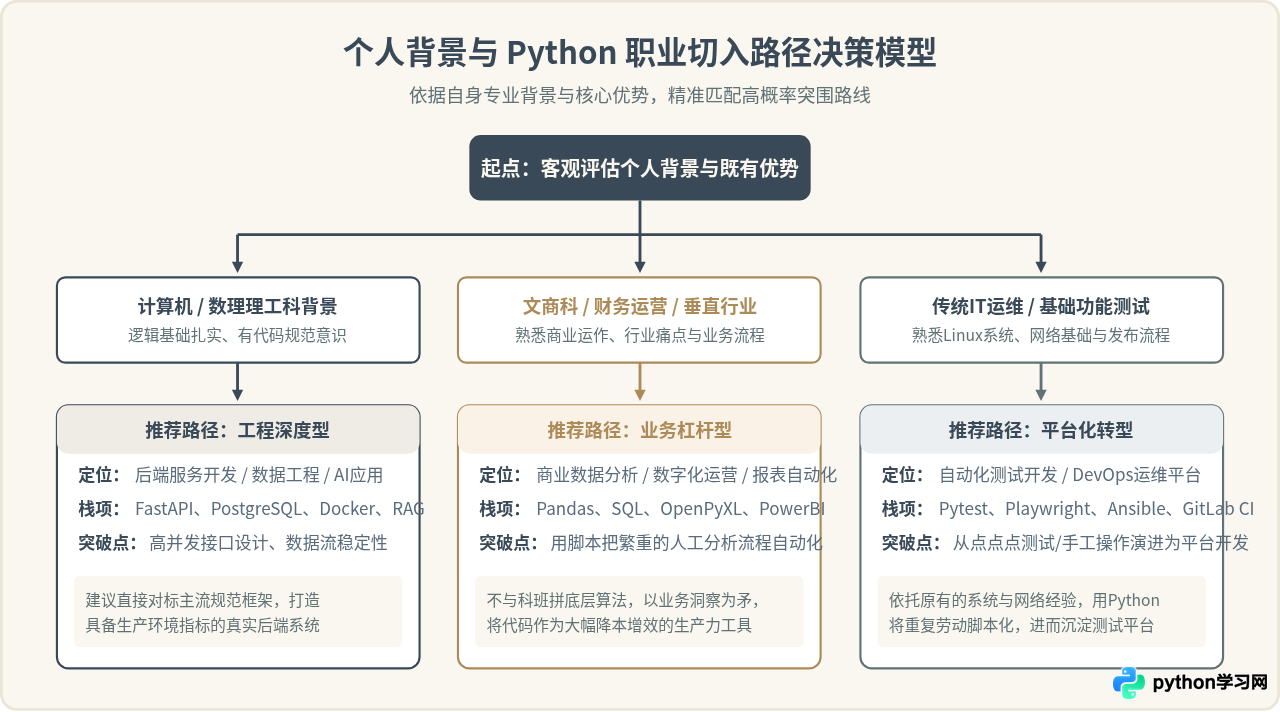
三、个人背景与方向选择决策:找准你的差异化生态位
学Python不是为了成为“只会Python的人”,而是为了解决目标行业的问题。根据自身学历背景、逻辑基础与既有工作经验,理性选择切入方向,是避免盲目内卷的关键。
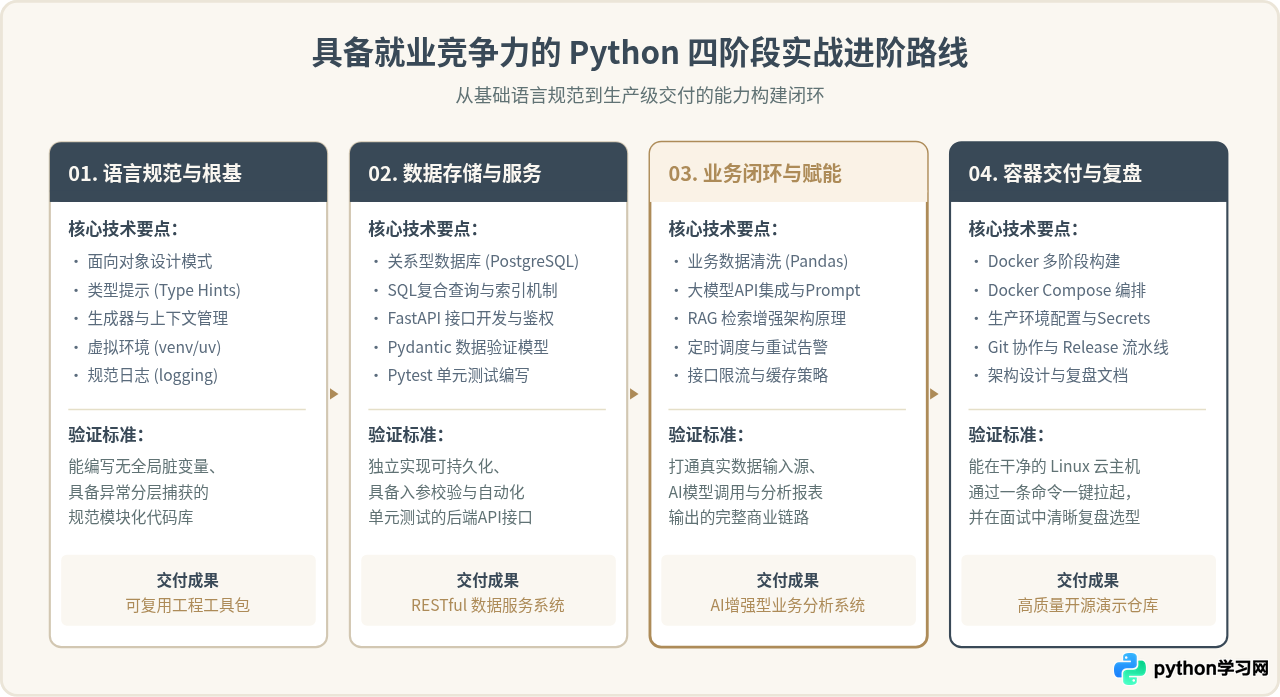
四、具备就业竞争力的实操学习四阶段路线
摆脱“收藏很多视频却写不出独立系统”的有效方法,是以“产出验证”驱动学习。以下四阶段路线明确了每个阶段的核心任务与检验标准:
五、可落地的实战案例示范:企业数据自动化与智能洞察系统
为了让面试官看到真实的工程能力,项目不能仅停留在“算法解题”或“基础CRUD”。下面以一个结合了业务数据清洗、指标聚合与大模型API智能摘要的自动化分析管道为例,展示符合企业要求的工程结构与核心实现。
1. 规范的项目工程目录
企业工程看重模块边界清晰与配置解耦,推荐目录结构如下:
sales_pipeline/
├── config/
│   └── settings.py          # 环境变量与配置定义 (基于 pydantic-settings)
├── core/
│   ├── database.py          # 数据库连接池与会话管理
│   └── logger.py            # 统一结构化日志输出
├── models/
│   └── schemas.py           # 数据入参/出参校验模型
├── services/
│   ├── data_aggregator.py   # Pandas 业务指标计算与离群值排查
│   └── ai_reporter.py       # 大模型 API 结构化 Prompt 与摘要生成
├── tests/
│   └── test_aggregator.py   # 核心业务逻辑的单元测试用例
├── Dockerfile               # 容器化镜像构建配置
├── requirements.txt         # 严格锁定版本号的依赖清单
└── main.py                  # 自动化调度主入口
2. 核心分析与摘要逻辑代码实现
以下代码展示了如何编写具备类型约束、异常兜底与可配置化的大模型业务数据分析模块:
import os
import json
import logging
from typing import Dict, Any, List
import pandas as pd
from pydantic import BaseModel, Field

# 配置结构化日志
logging.basicConfig(
    level=logging.INFO,
    format="%(asctime)s [%(levelname)s] %(name)s - %(message)s"
)
logger = logging.getLogger("SalesAnalyzer")

class AnalysisResult(BaseModel):
    """业务分析输出模型,强制字段类型与校验"""
    total_revenue: float = Field(..., description="当月总销售额")
    top_region: str = Field(..., description="营收最高区域")
    anomaly_count: int = Field(..., description="异常订单笔数")
    ai_summary: str = Field(..., description="AI生成的趋势分析建议")

class SalesReportPipeline:
    def __init__(self, data_file_path: str):
        self.file_path = data_file_path

    def load_and_clean_data(self) -> pd.DataFrame:
        """加载原始销售记录,处理缺失值与类型转换"""
        if not os.path.exists(self.file_path):
            logger.error(f"指定数据文件不存在: {self.file_path}")
            raise FileNotFoundError(f"文件未找到: {self.file_path}")

        df = pd.read_csv(self.file_path)
        logger.info(f"成功读取数据行数: {len(df)}")

        # 清洗:去除金额为空记录,填充默认类别
        df = df.dropna(subset=["amount"])
        df["amount"] = pd.to_numeric(df["amount"], errors="coerce").fillna(0.0)
        df["region"] = df["region"].fillna("未分类区域")
        return df

    def compute_metrics(self, df: pd.DataFrame) -> Dict[str, Any]:
        """计算关键业务指标"""
        total_rev = round(float(df["amount"].sum()), 2)
        region_group = df.groupby("region")["amount"].sum()
        top_reg = str(region_group.idxmax()) if not region_group.empty else "无"

        # 简单离群判定:单笔金额超过均值 3 倍标准差视为异常监控订单
        mean_val = df["amount"].mean()
        std_val = df["amount"].std() if len(df) > 1 else 0
        threshold = mean_val + 3 * std_val
        anomalies = int((df["amount"] > threshold).sum())

        logger.info(f"指标计算完成: 总营收={total_rev}, Top区域={top_reg}, 异常订单数={anomalies}")
        return {
            "total_revenue": total_rev,
            "top_region": top_reg,
            "anomaly_count": anomalies
        }

    def generate_executive_summary(self, metrics: Dict[str, Any]) -> str:
        """调用大模型生成面向业务负责人的分析综述 (示例逻辑)"""
        # 实际生产中应注入真实 API Client 并配置超时与重试机制
        prompt_context = (
            f"销售总额: {metrics['total_revenue']} 元;"
            f"营收贡献最高区域: {metrics['top_region']};"
            f"监控到超大额/异常订单: {metrics['anomaly_count']} 笔。"
        )
        logger.info("正在构造 Prompt 并请求大模型分析摘要...")

        # 模拟稳定返回的业务摘要文本
        mock_summary = (
            f"本周期业务稳健,{metrics['top_region']} 区域保持主导地位。"
            f"系统识别出 {metrics['anomaly_count']} 笔离群大额订单,"
            f"建议财务与运营团队针对性复核交付进度与履约风险。"
        )
        return mock_summary

    def run(self) -> AnalysisResult:
        """执行端到端处理流水线"""
        raw_df = self.load_and_clean_data()
        metrics = self.compute_metrics(raw_df)
        summary = self.generate_executive_summary(metrics)

        result = AnalysisResult(
            total_revenue=metrics["total_revenue"],
            top_region=metrics["top_region"],
            anomaly_count=metrics["anomaly_count"],
            ai_summary=summary
        )
        logger.info("流水线执行完毕,生成结构化交付成果。")
        return result

if __name__ == "__main__":
    # 示例运行逻辑
    pipeline = SalesReportPipeline("sample_sales.csv")
    try:
        output = pipeline.run()
        print(output.model_dump_json(indent=2))
    except Exception as exc:
        logger.critical(f"执行异常退出: {exc}", exc_info=True)
并非考察语法多么高深,而是考察类型安全(Type Hints与Pydantic)、工程健壮性(FileNotFoundError明确抛出与清洗异常兜底)、以及可测试性。应聘者如果在面试中能够从容解释“当数据量激增至千万级时,如何用分块加载(Chunking)或 DuckDB 替代全量内存加载”,这就是超越初级应聘者的决定性证据。
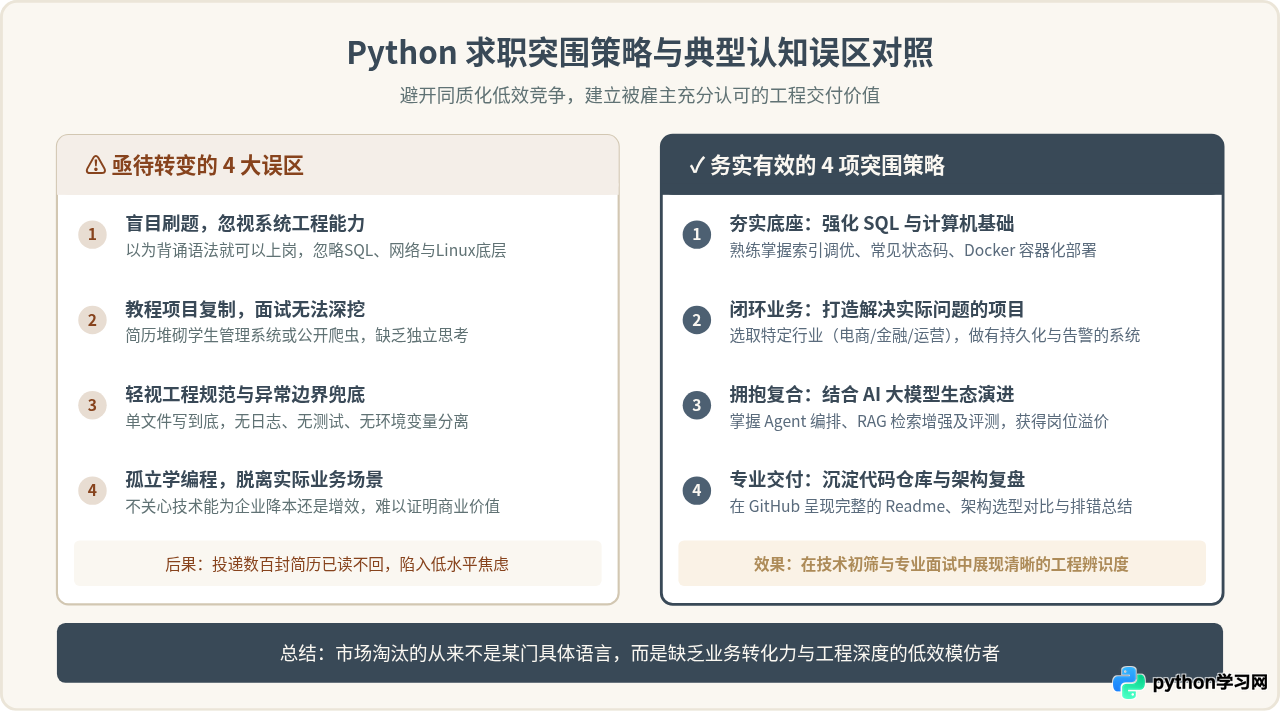
六、求职避坑指南与突围策略对照
为了在激烈的求职竞争中建立高辨识度,学习者需要时刻审视自己的学习重点是否与雇主诉求偏离。下表梳理了最常见的4大误区与实操应对策略:
| 维度 | 低效/同质化做法(常见误区) | 高效突围策略(企业偏好) |
|---|---|---|
| 学习焦点 | 反复在各种平台刷语法基础题,背诵冷门API参数 | 掌握核心语法后,迅速进阶 SQL、网络基础、Linux和Git规范协作 |
| 项目选题 | 照抄视频教程中的“电商博客”、“通用学生管理系统” | 针对特定真实业务(如自动化报表分析、LLM文档智能问答)设计全流程项目 |
| 代码质量 | 单个几百行的巨型脚本,无异常捕获,print调试全文 | 清晰模块分层、结构化日志输出、配置解耦、编写核心单元测试 |
| 交付展示 | 仅在简历中罗列技术名词,GitHub仓库没有运行说明 | 提供Docker一键运行说明(README)、架构设计图与选型调优复盘文档 |
七、总结:学Python的出路究竟在哪里?
回到标题的问题:“学Python有出路吗?”
答案依然是肯定的。但学习者必须清醒认识到,技术发展的趋势已经从“普及期”进入了“沉淀期”。把Python当作目的,每天背诵语法规则,出路只会越来越窄;而把Python当作放大器和杠杆,结合具体的业务领域、工程底座或AI技术,出路依然宽广。
只要你的代码能够为团队解决真实存在的业务繁琐问题、能够提供稳定可靠的服务接口、或者能够借助大模型帮助企业提升决策效率,那么你所掌握的Python技术就具备不可替代的市场价值。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









