

Python嵌套循环的执行流程是怎么的
深入解析Python嵌套循环的底层执行机制与流程,通过具体示例、单步状态推导与执行流图解,清晰呈现外层与内层循环的步进过程、break与continue的作用范围及性能优化方法。
Python 嵌套循环的核心运行逻辑可以用一句话概括:外层循环每推进一次迭代,内层循环就完整地从头到尾遍历执行一整轮。这类似于机械钟表中“时针”与“分针”的关系——时针向前跳动一小格(外层迭代一次),分针必须在表盘上完整旋转360度(内层执行完所有可能的值)。理解这种分步推进与嵌套重置的机制,是掌握多维数据处理、矩阵遍历及算法优化的基础。
一、双层循环的结构与时序递进机制
在 Python 中,当一个循环结构放置在另一个循环的代码块内部时,就构成了嵌套循环。无论使用的是 for 循环还是 while 循环,控制流都严格遵循逐层进入、内层闭环、外层步进的次序。
我们来看一个典型的两层 for 循环代码示例:
# 双层 for 循环示例
for i in range(2):
    print(f"[外层开始] i = {i}")
    for j in range(3):
        print(f"    [内层运行] i = {i}, j = {j}")
    print(f"[外层结束] i = {i}\n")
运行该代码,终端会输出以下结果:
[外层开始] i = 0
    [内层运行] i = 0, j = 0
    [内层运行] i = 0, j = 1
    [内层运行] i = 0, j = 2
[外层结束] i = 0

[外层开始] i = 1
    [内层运行] i = 1, j = 0
    [内层运行] i = 1, j = 1
    [内层运行] i = 1, j = 2
[外层结束] i = 1
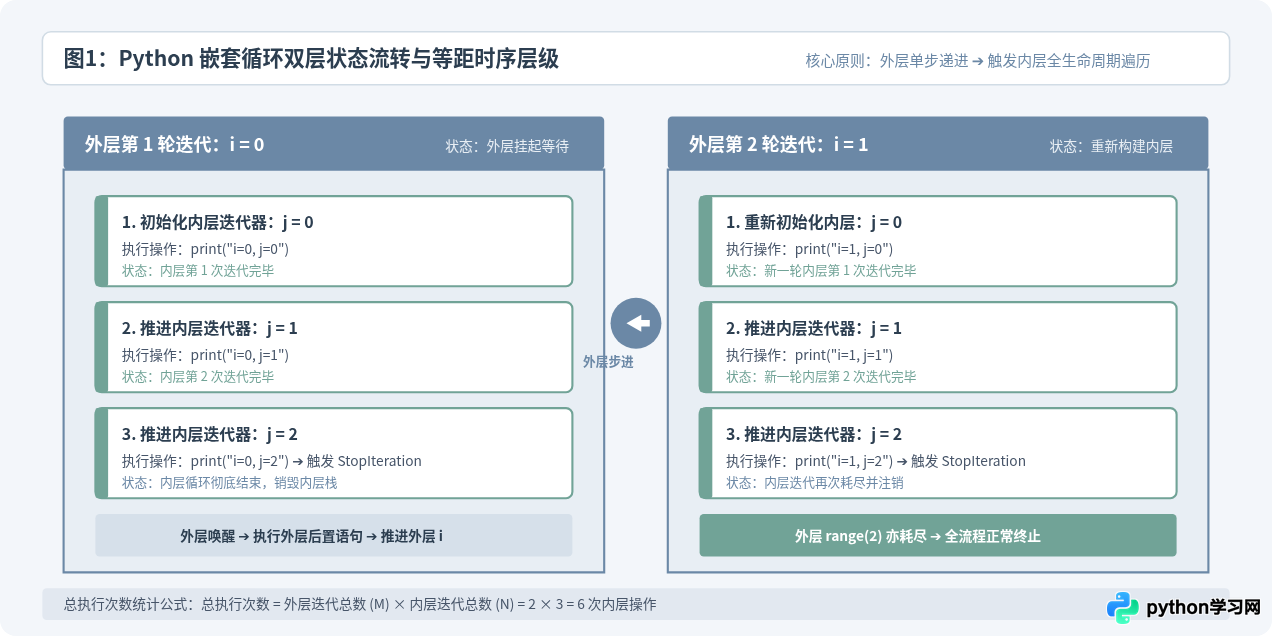
从输出顺序可以清晰地看到:外层循环在 i = 0 时挂起外层的后续动作,转入内层循环。内层循环从 j = 0 开始,依次执行 j = 1、j = 2,直到可迭代对象 range(3) 耗尽。此时内层循环退出,外层循环恢复执行剩余语句,并进入下一轮 i = 1,随后内层循环再次被创建并重新执行完整的一轮。
二、单步执行状态推导与执行栈分析
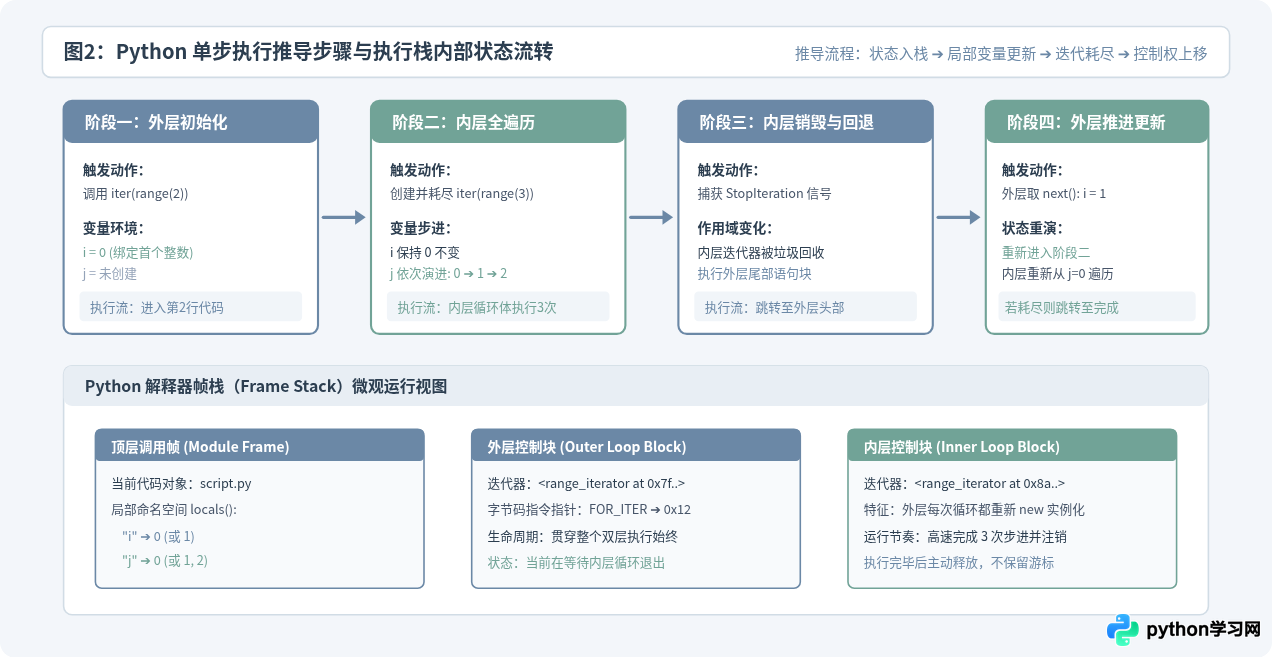
为了看清解释器在每一微观时刻的具体动作,我们可以将 Python 执行器内部的状态变化分解为离散的时钟序列。以下表格展示了执行器在每一步的代码行号、当前活跃作用域、变量绑定的值以及标准输出的变化:
| 时序步骤 | 当前执行指令 | 外层变量 i | 内层变量 j | 内部控制状态与输出 |
|---|---|---|---|---|
| 步骤 1 | for i in range(2) |
0 | 未定义 | 获取外部迭代器首个元素,绑定 i = 0 |
| 步骤 2 | for j in range(3) |
0 | 0 | 创建内层迭代器,进入内层循环体,输出 i=0, j=0 |
| 步骤 3 | for j in range(3) |
0 | 1 | 内层迭代器取下一个元素,输出 i=0, j=1 |
| 步骤 4 | for j in range(3) |
0 | 2 | 内层迭代器取最后一个元素,输出 i=0, j=2 |
| 步骤 5 | for j in range(3) |
0 | 2 | 内层抛出 StopIteration,内层循环退出,返回外层 |
| 步骤 6 | for i in range(2) |
1 | 保留原值 | 外层迭代器步进,更新绑定 i = 1 |
| 步骤 7 | for j in range(3) |
1 | 0 | 重新创建全新的内层迭代器,重置 j = 0,输出 i=1, j=0 |
| 步骤 8 | for j in range(3) |
1 | 1 ~ 2 | 依序完成 j=1 与 j=2,内层再次结束 |
值得特别注意的关键点在步骤 7:内层循环在每次外层迭代到来时,都是通过重新调用 iter() 函数生成全新的迭代器对象。这意味着内层循环不会“记住”上一轮迭代的结束状态,而是从头完整重演。
三、控制语句的作用域:break 与 continue 的影响边界
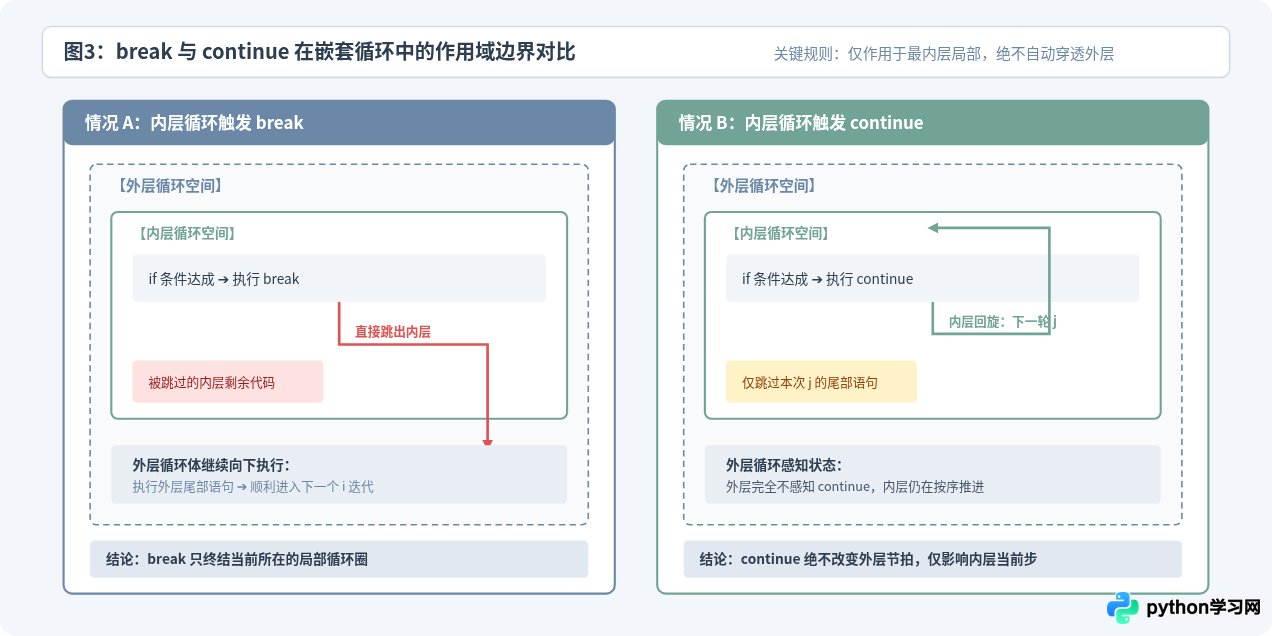
在嵌套循环中,控制流跳转语句 break 和 continue 极易引发逻辑错误。Python 语法规则对两者的作用范围做出了绝对严格的限制:break 和 continue 只会作用于直接包裹它的那一层循环,绝对不会自动穿透到外层循环。
1. 内层 break 的执行表现
当内层循环触发 break 时,解释器会立即中断内层当前的全部迭代,并跳出内层循环体。但对于外层循环而言,这仅仅等价于“内层循环已经执行完毕”,外层循环会继续正常推进到下一次迭代。
# 内层 break 示例
for i in range(3):
    print(f"外层开始 i = {i}")
    for j in range(3):
        if j == 1:
            print("    [内层 break 触发]")
            break
        print(f"    内层运行 j = {j}")
    print(f"外层继续 i = {i} 完成\n")
输出结果为:
外层开始 i = 0
    内层运行 j = 0
    [内层 break 触发]
外层继续 i = 0 完成

外层开始 i = 1
    内层运行 j = 0
    [内层 break 触发]
外层继续 i = 1 完成

外层开始 i = 2
    内层运行 j = 0
    [内层 break 触发]
外层继续 i = 2 完成
可以看到,虽然内层循环在 j = 1 时被终止,但外层循环依然完整走完了 i = 0, 1, 2 全部三轮。
2. 内层 continue 的执行表现
当内层循环遇到 continue 时,它仅仅跳过当前内层迭代的后续代码,立即进入内层的下一个 j 值,既不会终止内层循环,更不会对外层循环的执行造成任何阻断。
1. 封装为独立函数:直接使用
return 返回结果,解释器会立即销毁整个函数的栈帧;
2. 使用循环标志变量或 for...else 语法:内层 break 时设置
found = True,外层检测到标志后再次 break。
四、while 嵌套与混合嵌套的典型陷阱
相比于 for 循环自动管理迭代器的特性,while 循环依赖手动维护的循环条件和计数器。在 while 循环嵌套中,最容易出现的严重缺陷就是内层计数器重置位置错误。
计数器位置错误导致的逻辑失效
请看以下错误代码与正确代码的对比:
# ❌ 常见错误写法:内层计数器放在外层之前初始化
i = 0
j = 0  # 错误位置!
while i < 2:
    while j < 3:
        print(f"i={i}, j={j}")
        j += 1
    i += 1
在上面的错误代码中,当 i = 0 执行完后,j 的值已经变成了 3。进入下一轮 i = 1 时,由于 j < 3 条件始终为假,内层循环将彻底不会执行,导致后续数据全部被静默遗漏。
正确的做法是:内层循环所依赖的计数器或指针,必须在外层循环体内、内层循环开始前完成重置:
# ✔️ 正确写法:在每次外层迭代开始时重置内层计数器
i = 0
while i < 2:
    j = 0  # 正确:每轮外层进入时重新归零
    while j < 3:
        print(f"i={i}, j={j}")
        j += 1
    i += 1
五、性能特征与工程优化思维模型
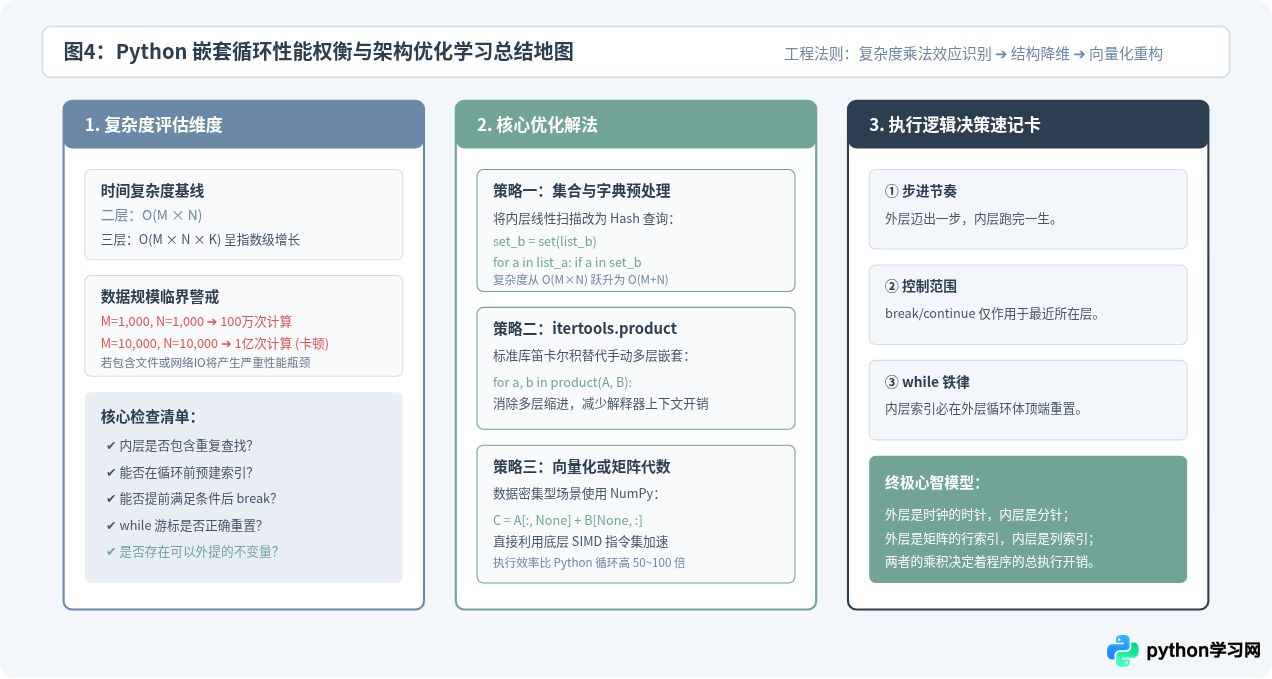
嵌套循环的根本计算代价由乘法法则决定:若外层迭代次数为 \(M\),内层迭代次数为 \(N\),最内层代码的总执行次数就是 \(M \times N\)。如果嵌套层级达到三层,复杂度将进一步飙升至 \(O(M \times N \times K)\)。当数据规模达到千级或万级时,朴素的嵌套循环极易造成程序卡死。
在工程实践中,遇到嵌套循环时应遵循以下优化评估路径:
- 查找降维(哈希表预处理):如果内层循环是在列表或元组中进行线性查找(如
for item in list_b: if item == target:),应在进入外层前将list_b转换为set或dict。这样内层的查找耗时直接由 \(O(N)\) 降至 \(O(1)\),整体运行时间由 \(O(M \times N)\) 直降为 \(O(M + N)\)。 - 笛卡尔积扁平化:如果只是需要生成所有组合对,使用标准库
itertools.product可以减少代码缩进层级,利用 C 底层迭代器提高代码执行速度。 - 向量化替换:在科学计算或批量数据处理中,优先使用 NumPy 的广播机制或 Pandas 的矢量化操作,避免在 Python 解释器层面执行密集的手写循环。
六、要点总结
掌握 Python 嵌套循环的执行流程,核心在于建立精准的执行流空间感:
- 顺序与重置:外层循环主导总轮次,每轮进入内层时,解释器都会重新生成内层迭代序列,并在内层完全耗尽后才将控制权交回外层。
- 跳出隔离性:
break只终结所在的那一层循环,若要同时终结所有层,应考虑封装为函数并使用return,或引入标志位协同控制。 - 规模防膨胀:始终关注嵌套带来的 \(O(N \times M)\) 乘法效应,在处理大数据集合时,优先借助哈希集合查询或矢量化计算来降低算法复杂度。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









