

Python 2的cmp函数在Python 3中为什么被移除
深入解析Python 2中的内置cmp函数与比较机制在Python 3中被彻底移除的核心技术原因、排序性能差异及现代代码迁移方案。
在 Python 2 中,内置的 cmp(x, y) 函数及其在排序接口中接受的 cmp=... 回调参数曾是序列比较的标准方案。然而在 Python 3 中,全局内置的 cmp()、特殊方法 __cmp__() 以及排序函数中的 cmp 参数被彻底移除。这一变动并非简单的语法精简,而是源于核心设计层面的三大推动力:基于 key 机制的排序性能倍增、PEP 207 引入富比较协议后的功能冗余,以及消除跨类型无意义比较所带来的类型安全要求。
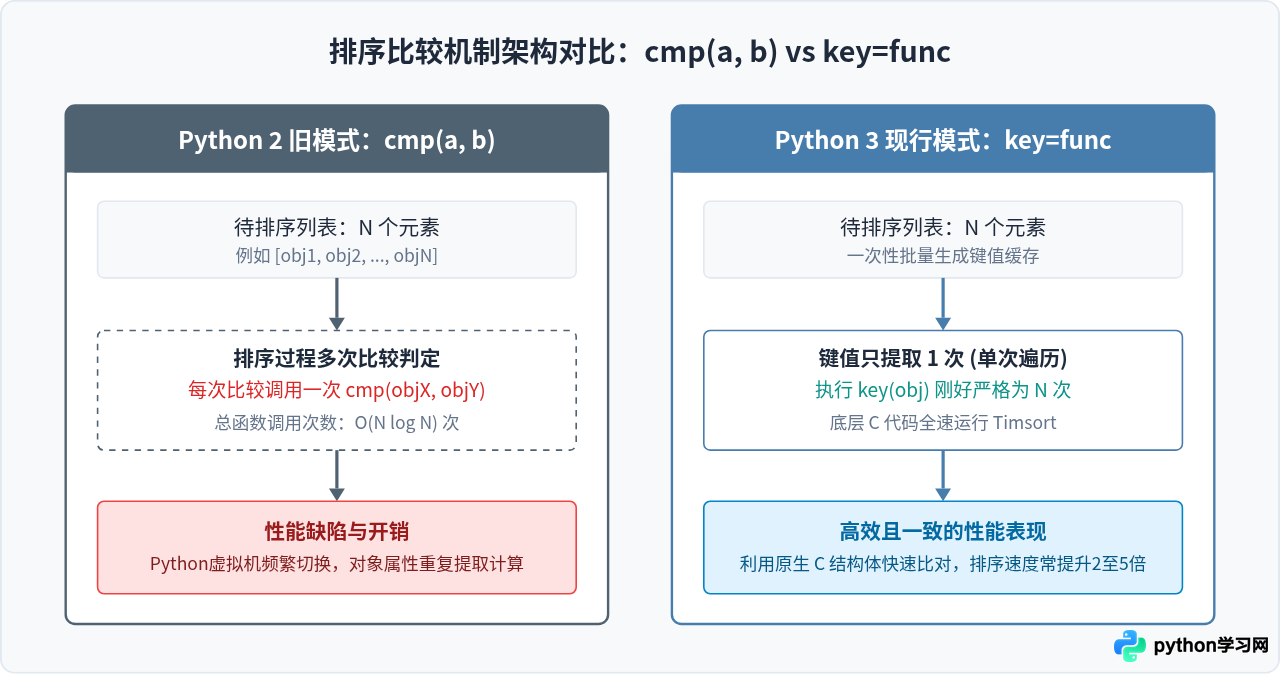
一、排序运行机制差异:cmp 与 key 的底层推导
在 Python 2 的早期版本中,如果需要对复杂对象列表(例如字典、自定义类实例)进行自定义规则排序,开发者通常需要编写一个接收两个元素并返回 -1、0 或 1 的比较函数。在排序算法运行期间,每次需要确定两个元素的前后顺序时,都会重复触发该 Python 函数调用。
而在 Python 2.4 引入并在 Python 3 成为唯一标准的 key 函数机制(基于 Schwartzian 变换演进),每个待排序元素仅在开始阶段计算一次键值,随后底层的 Timsort 算法完全依赖预先提取的键值进行高速原生比较。
二、Python 3 决定移除 cmp 的核心动因
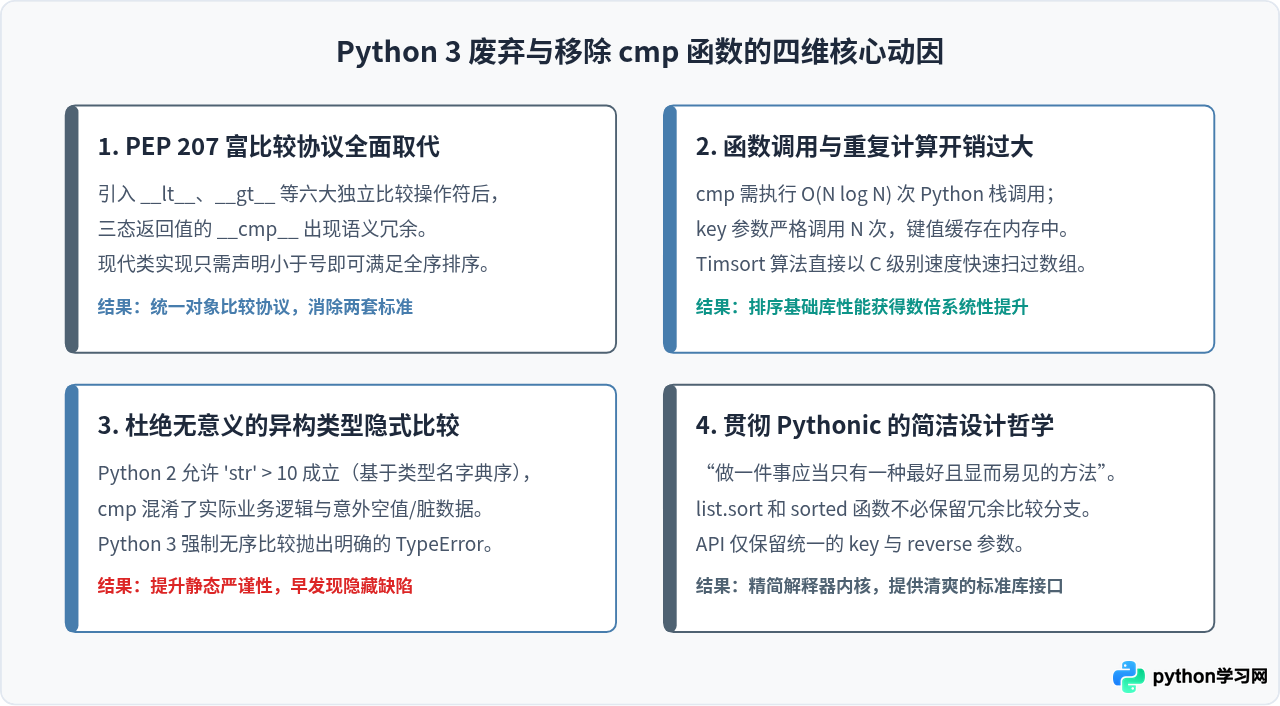
官方在 Python 3 中彻底移除 cmp 系列接口,是语言设计者经过长期工程验证后的系统性决策,主要集中在以下四个核心原因:
1. 富比较协议(Rich Comparisons, PEP 207)的成熟
在 Python 2.1 之前,类只能通过重写 __cmp__(self, other) 来定义所有比较逻辑。该函数返回负数代表小于,0 代表等于,正数代表大于。这种机制无法表达数学上的偏序关系(例如矩阵或复数不可直接比大小),且在集合包含或非标对象相等性判定上极不灵活。PEP 207 引入了 __lt__、__le__、__eq__、__ne__、__gt__、__ge__ 等富比较方法,使每个运算符都可以独立重载与返回相应类型。富比较成为事实标准后,传统的 __cmp__ 已经沦为维护成本高昂的旧包袱。
2. 类型安全:禁止异构类型的任意比较
在 Python 2 中,由于 cmp() 必须为任意两个对象给出一个确定性的数值判断,即使是毫无逻辑关系的类型也可以任意比大小:
# Python 2 允许异构比较(结果按类型名称字典序返回,毫无业务逻辑可言):
>>> cmp("hello", 123)
1
>>> "hello" > 123
True
这在实际项目中会导致极难排查的 Bug。例如列表内由于疏忽混入了 None 或数字,在 Python 2 下依然能够悄无声息地完成排序,却给后续业务逻辑留下了隐藏炸弹。而在 Python 3 中,尝试对字符串和数字进行比较会立即抛出 TypeError: '<' not supported between instances of 'str' and 'int',在执行的第一时间拦截错误。
三、现代 Python 3 排序与替代实践操作指南
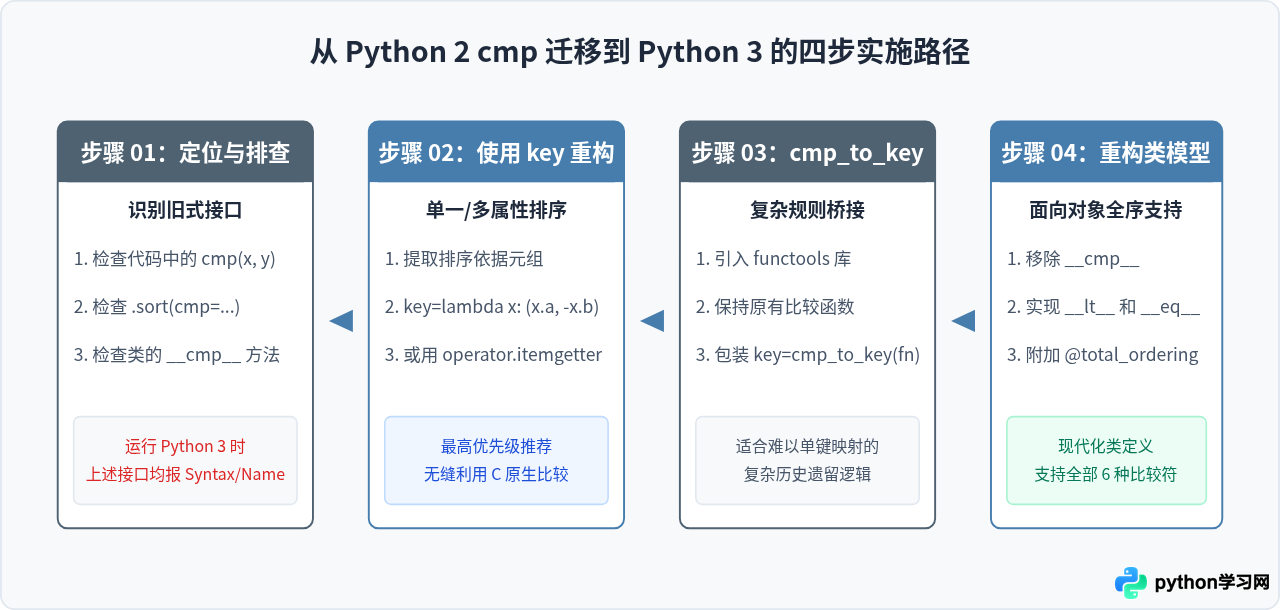
在迁移旧 Python 2 项目或编写新 Python 3 代码时,原先依赖 cmp 的逻辑需要平滑过渡到现代替代方案。以下提供明确的迁移演进步骤:
场景 1:原生替换为 key 函数(推荐模式)
在绝大多数场景下,自定义比较的目的只是按特定字段、属性或长度排序。使用 key 函数不仅语法直观,而且享受 C 级别的优化:
# 示例:按学生年龄升序、成绩降序排序
students = [
    {"name": "Alice", "age": 20, "score": 92},
    {"name": "Bob", "age": 19, "score": 85},
    {"name": "Charlie", "age": 20, "score": 96}
]

# Python 3 推荐做法:通过元组指定主次键
sorted_students = sorted(
    students,
    key=lambda s: (s["age"], -s["score"])
)
场景 2:复杂历史逻辑使用 functools.cmp_to_key 桥接
如果现有代码中有一个极其复杂的双对象比较函数(例如涉及动态上下文关联判定),无法直接提炼为单一的 key 映射,标准库提供了适配器函数 functools.cmp_to_key:
from functools import cmp_to_key

def legacy_compare(a, b):
    # 保持原有的三态判断逻辑:小于返回 -1,等于返回 0,大于返回 1
    if a % 2 != b % 2:
        return -1 if a % 2 != 0 else 1  # 奇数排在偶数前
    return (a > b) - (a < b)            # 同奇偶时按大小升序

numbers = [4, 7, 2, 9, 1, 8, 6]

# 通过 cmp_to_key 自动构造包装类,传递给 key 参数
result = sorted(numbers, key=cmp_to_key(legacy_compare))
# 输出: [1, 7, 9, 2, 4, 6, 8]
场景 3:自定义类重构为富比较与 total_ordering
对于业务领域模型,不要再尝试模拟 __cmp__。只需实现 __eq__ 与 __lt__,配合 functools.total_ordering 装饰器,即可自动补全所有比较运算符:
from functools import total_ordering

@total_ordering
class Task:
    def __init__(self, priority, title):
        self.priority = priority
        self.title = title

    def __eq__(self, other):
        if not isinstance(other, Task):
            return NotImplemented
        return self.priority == other.priority and self.title == other.title

    def __lt__(self, other):
        if not isinstance(other, Task):
            return NotImplemented
        # 优先级数值越大,排序越靠前
        return self.priority > other.priority

tasks = [Task(2, "修复Bug"), Task(5, "上线部署"), Task(1, "编写文档")]
tasks.sort()  # 自动调用 __lt__ 排序
四、方案对比与技术决策建议
针对不同开发场景与工程要求,选择合适的比较与排序方案可以达到开发效率与运行性能的最优平衡:
| 技术方案 | 调用次数 (N为元素量) | 适用场景 | 工程建议 |
|---|---|---|---|
| key 参数 (Lambda/内置) | 严格为 N 次 | 90% 以上的标准业务排序 | 首选推荐。代码最为精炼,且 Timsort 能全速运行。 |
| operator.itemgetter / attrgetter | 严格为 N 次 | 字典键或类属性字段排序 | 高性能推荐。完全避免了 Python 级函数调用开销。 |
| functools.cmp_to_key | 约 O(N log N) 次包装比较 | 历史老项目无痛迁移、复杂相对规则 | 过渡方案。虽引入包装对象开销,但能够完全保留原算法逻辑。 |
| @total_ordering 类定义 | 依比较次数而定 | 实体对象之间的自然全序关系 | 规范面向对象设计。兼顾直观的 `<`、`>=` 等日常运算支持。 |
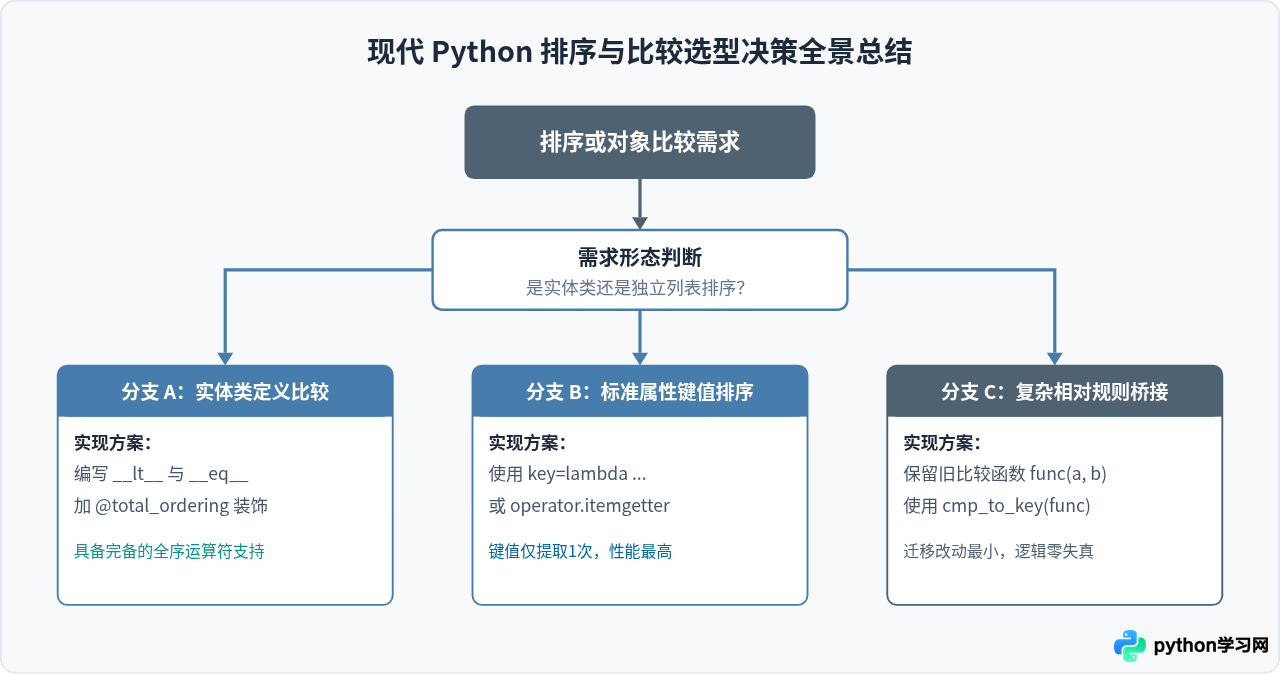
总结:Python 3 移除 cmp 并非放弃比较能力,而是将两套混乱重叠的旧标准,收敛为“单次提取的 key 缓存模式”与“精细可控的富比较协议”。这一改动让排序性能大幅度攀升,并在编译与运行期彻底阻断了隐式类型比较缺陷,是 Python 迈向成熟、高效与安全语言的必经之路。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









