

通义千问网页版支持上传哪些文件格式
全面梳理通义千问网页版支持上传的文件格式,包括文本文档、电子表格、演示文稿、多模态图像及代码配置文件,提供操作步骤、解析机制与规格限制说明。
通义千问网页版提供了完备的文件解析与知识增强能力,支持上传文本文档、电子表格、演示文稿、常见多模态图像以及开发代码与配置文件五大核心类别。用户只需在对话界面点击附件按钮或直接拖拽文件,即可将本地资料注入大模型的上下文窗口,完成内容总结、关键信息抽取、数据统计、图表分析及代码调试等任务。
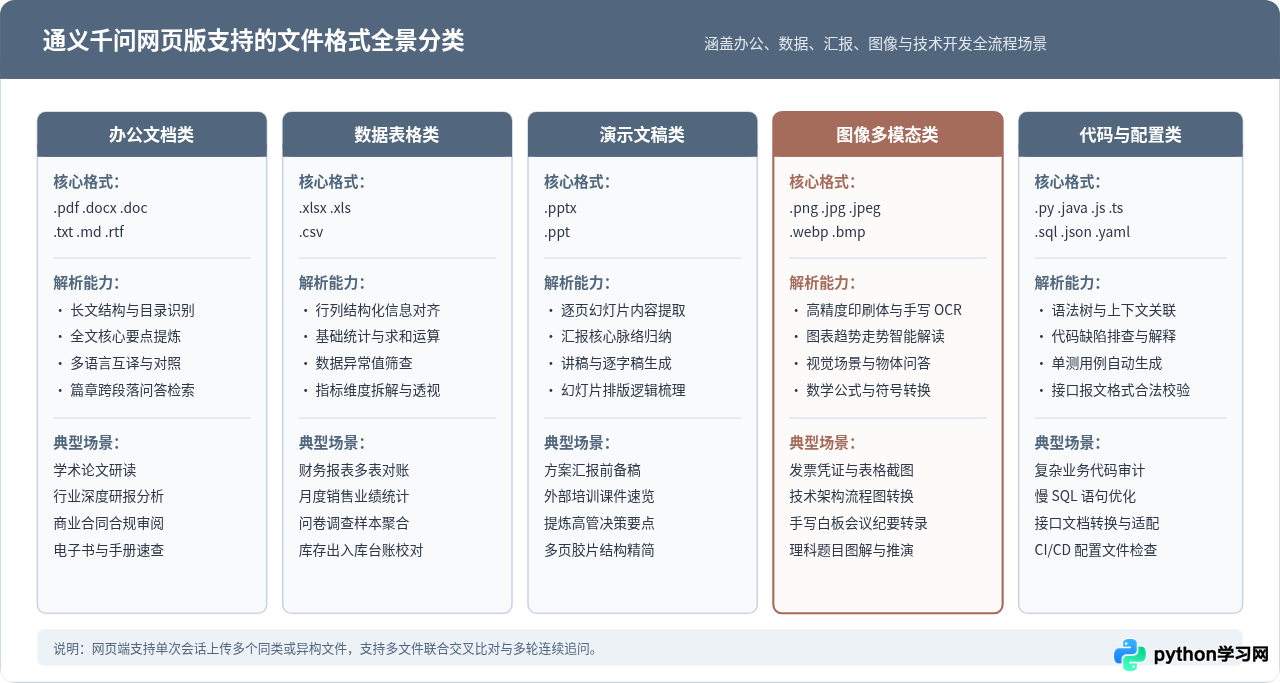
一、支持的文件格式分类详解
为了兼顾日常办公检索、数据处理与技术开发等多元场景,通义千问网页版对主流格式进行了细致的兼容。不同文件类型在上传后会调用针对性的解析链路,以保障文本排版和结构化数据的完整还原。
1. 办公文本文档
办公文档是日常提问与资料研读中最为高频的类型。通义千问能够自动识别层级目录、段落结构与正文引言:
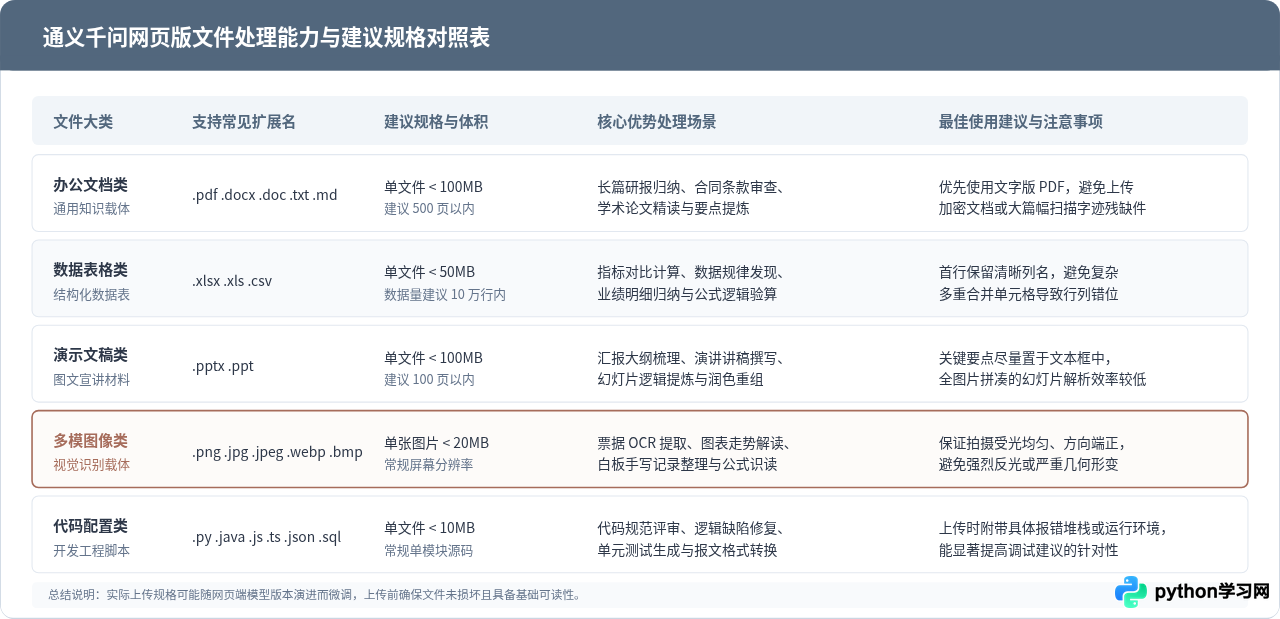
- PDF 格式(.pdf):支持常见的文字型 PDF 与双层排版文档。模型能够解析目录架构、跨页正文以及页面中的表格,适合研读行业研报、学术论文、法律合同与技术规范手册。
- Word 文档(.docx、.doc):支持微软 Word 常用格式,能保持段落缩进、标题级别及列表关系,适合快速提炼会议纪要、方案草案或长篇撰写材料。
- 纯文本与轻量排版(.txt、.md、.markdown、.rtf):原生编码友好,响应迅速,适合作为知识片段、读书笔记或聊天记录整理的输入。
2. 数据与电子表格
数据表格的处理侧重于行列拓扑识别与单元格关联计算:
- Excel 工作簿(.xlsx、.xls):支持多工作表识别,模型能读取表头字段、数值单元格并理解多维透视关系,可用于趋势计算、利润核对及异常值初筛。
- 纯文本逗号分隔表(.csv):轻量级结构化数据载体,模型解析无格式干扰,在大批量数据记录归纳时表现出较高的稳定性与准确率。
3. 演示幻灯片
演示文稿通常图文混排密集且文字相对简短:
- PowerPoint 幻灯片(.pptx、.ppt):逐页抽取页面文本框内容、版块标题和演讲备注,帮助快速梳理宣讲大纲、撰写配套演讲稿或提炼重点汇报议程。
4. 图像与多模态文件
通义千问网页版具备多模态视觉理解能力,支持针对图像内容发起图文混答:
- 常见位图(.png、.jpg、.jpeg、.webp、.bmp):涵盖手机拍摄、截屏或扫描图。系统通过视觉模型与高精 OCR 双重技术,实现票据文字识别、手写体转录、技术架构图解读以及试题公式提取。
5. 代码与开发配置
针对软件工程与系统运维场景,网页端对纯文本代码及数据交换格式提供了良好的支持:
- 常用编程语言脚本:包括 .py、.java、.c、.cpp、.js、.ts、.go、.sql、.sh 等,支持直接上传并针对整段源码进行逻辑审查、Bug 定位与用例编写。
- 数据交换与配置文件:包括 .json、.xml、.yaml、.yml 等,可辅助验证语法有效性、转换层级数据结构或编写解析脚本。
二、网页版上传与交互操作步骤
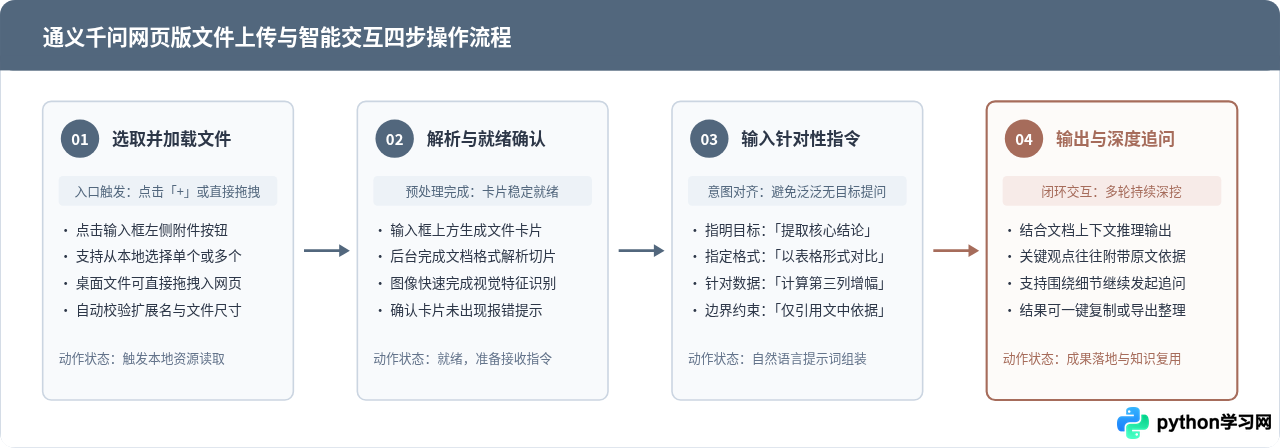
通义千问网页版将文件上传流程与自然语言交互紧密融合。从选取文档到获得针对性回答,通常只需完成四个清晰的步骤:
- 触发上传入口:在页面底部的对话输入框左侧,找到「+」号图标或回形针样式的附件按钮点击打开系统文件管理器,或者直接将本地文件拖拽至浏览器聊天区域。
- 等待解析与就绪状态:文件添加后,输入框上方会立即显示对应的文件胶囊卡片,包含文件名与图标。系统后台会在秒级时间内完成文档上传与文本切片,当卡片状态稳定且未显示报错时,即代表解析完毕。
- 输入明确的指令(Prompt):不要只上传文件而不输入文字。结合你的实际目标,在输入框中明确给出需要大模型执行的动作(如提炼总结、指出矛盾、提取表格数据等)。
- 发起交互与按需追问:点击发送按钮,模型即会结合文档全文进行检索并在几秒内生成结构化回答。如果不满足于初步总结,可以直接就文档中的细节进一步深入追问。
三、后台解析与多模态处理机制
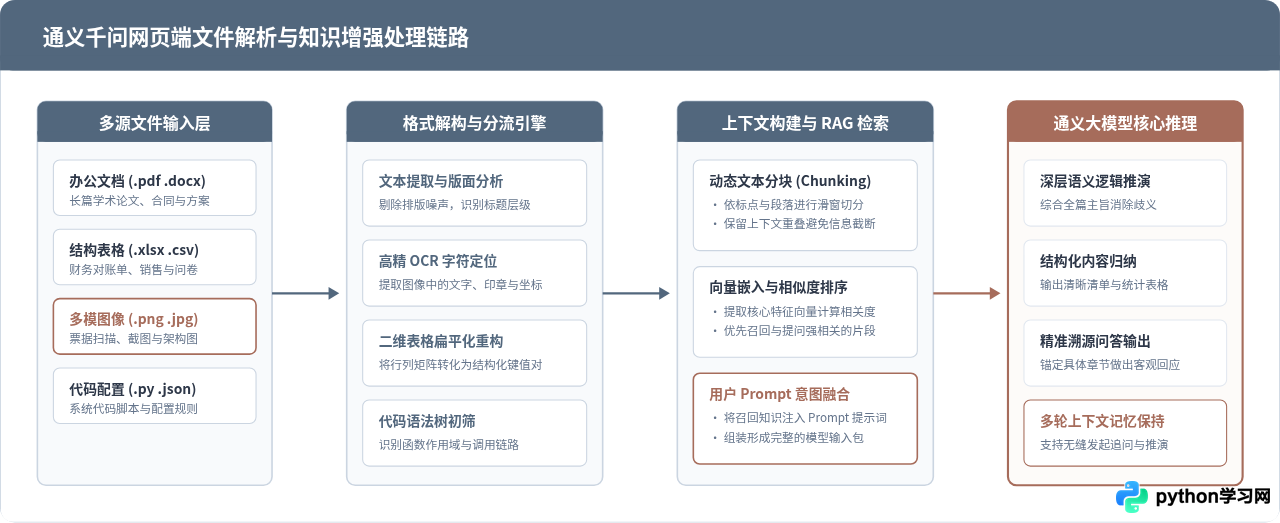
理解模型在后台如何消化文件,有助于写出更高质量的提问提示词。通义千问针对不同介质的文件,采用了差异化的预处理与增强链路:
- 文档与长文本切片(RAG 机制):对于大型 PDF 或数十页的 Word 报告,模型通常采用检索增强生成(Retrieval-Augmented Generation)技术。文档首先在后台被结构化解析,按章节与语义边界切分为多个文本块(Chunks),并生成语义向量。当用户提出具体问题时,系统会快速匹配关联度最高的信息片段注入模型推理,保证在控制上下文消耗的同时准确定位细节。
- 表格数据结构扁平化:Excel 与 CSV 表格在解析时,算法会自动识别第一行或第一列作为特征表头,将二维表格矩阵转换为带语义标签的键值对或 Markdown 规范表格,确保大模型能感知数值之间的归属与层级关系。
- 视觉多模态与高精 OCR 融合:当用户上传图片或包含复杂图表的扫描件时,多模态视觉模型会与光学字符识别引擎协同工作。先由 OCR 引擎精确读取文本与排版坐标,再由多模态网络分析图像所表达的视觉趋势、物体空间关系或构图意图。
四、上传规格、限制条件与实用建议
在实际使用通义千问网页版上传文件时,了解其边界限制和处理特性,可以有效避免上传失败或解析失真:
1. 避免上传加密文件:带有密码保护或禁止复制权限的 PDF/Word 文档,后台解析服务无法解密读取,请先在本地解除密码后再上传。
2. 扫描件 PDF 优先确认清晰度:纯图片扫描制成的 PDF 虽然支持 OCR,但如果字迹模糊、反光或倾斜严重,可能导致关键术语与数字识别错误。
3. 复杂表格保持表头清晰:Excel 表格中避免大面积多重跨行跨列合并,保留首行规范字段名能大幅提升数据汇总准确度。
1. 文件体积与页数规模
通义千问网页版对于常见办公文档与数据表格,单文件大小一般建议控制在 100MB 以内(图片通常在 20MB 以内)。对于页数极多的超大 PDF(如超过 500 页的整本技术年鉴),建议按章节进行适当拆分后再上传,以保障文本召回与阅读理解的专注度。
2. 多文件联合分析技巧
通义千问支持在同一轮对话中添加多个文件。在处理对比类任务时非常高效,例如同时上传两份不同季度的财务报表(.xlsx)或者合同的新旧版本(.docx),并在提示词中明确要求「请对比附件 1 与附件 2 中的核心条款差异,列出新增和删除内容」,模型即可完成交叉审校。
五、总结
通义千问网页版对多格式文件的原生支持,使其从一个单纯的聊天窗口转变为能够处理实际业务资料的生产力工作台。无论是研读数十页的 PDF 文档、核对 Excel 财务明细、识别票据截图,还是审查 Python/SQL 脚本,用户都可以直接通过上传附件将原始数据输入模型。掌握清晰的格式边界、规避扫描与加密陷阱,并结合具体的提示词要求,即可最大化发挥通义千问的文档解析与多轮追问价值。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









