

Python requests.get发送HTTP GET请求及参数配置指南
全面讲解Python requests.get发送HTTP GET请求的实操方法与核心参数配置,涵盖params查询参数、headers请求头、timeout超时控制、cookies、身份认证与响应安全解析。
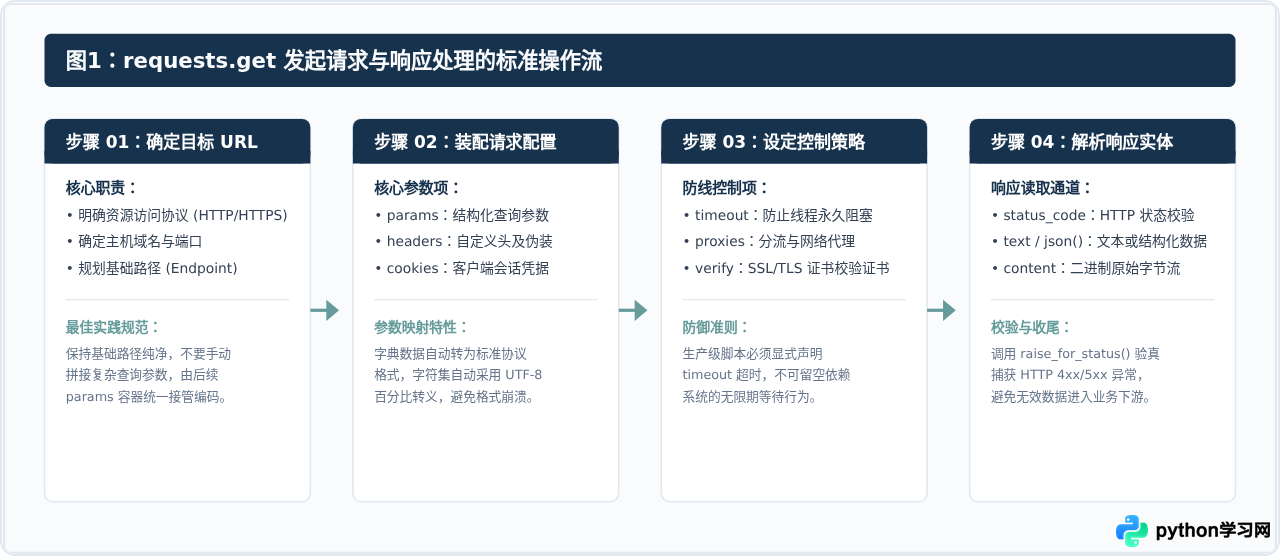
在 Python 网络编程与数据获取任务中,requests.get() 是发起 HTTP GET 请求最为普遍且便捷的方法。本文将系统梳理使用 requests.get() 发送请求的完整流程,深入解析 params 查询参数、headers 请求头、timeout 超时控制、cookies 凭据传递等核心参数的具体配置规范与底层运作原理,帮助读者构建安全、健壮且高效的网络调用代码。
一、发起第一个 HTTP GET 请求与基本响应处理
HTTP GET 方法主要用于向指定服务端获取资源。在 Python 中,通过三方库 requests 提供的 get() 函数,开发者只需传入目标 URL 即可发起标准的网络请求,并同步接收返回的响应对象(Response)。
在开始编写代码前,需确保运行环境中已安装 requests 库。可通过终端命令完成安装:
pip install requests
安装完成后,调用 requests.get() 的基础语法示例如下:
import requests

# 目标地址(示例公网测试接口)
url = "https://httpbin.org/get"

# 发起 GET 请求
response = requests.get(url)

# 检查响应状态码
print("状态码:", response.status_code)

# 查看服务端返回的文本内容
print("响应内容:", response.text)
在这段最简代码中,requests.get(url) 内部完成了 DNS 解析、建立 TCP 连接、构造 HTTP 报文、接收服务端响应数据等一系列底层操作,最终返回封装良好的 Response 实例。掌握整个请求生命周期,有助于我们理解后续参数如何在各个环节发挥作用。
二、URL 查询参数配置:params 参数与自动编码机制
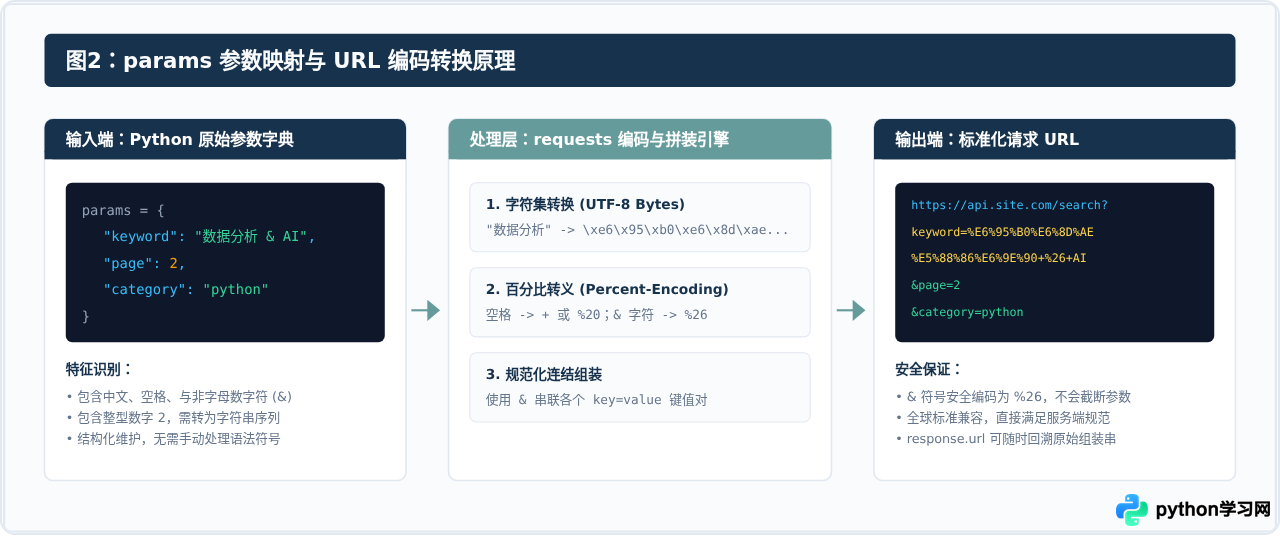
在 HTTP 规范中,GET 请求的参数通常以 Query String 的形式追加在 URL 末尾,格式形如 ?key1=value1&key2=value2。初学者常习惯使用字符串格式化(如 f-string 或加号连接)来构造带有参数的 URL,但这种做法极易带来隐患:
- 若参数值中包含空格、中文、特殊字符(如
&、?、=、/等),手动拼接容易破坏 URL 的原有语法结构。 - 特殊字符需要严格遵照 RFC 3986 规范执行百分比编码(Percent-Encoding),手工处理极易疏漏或产生双重编码。
requests.get() 提供了专用的 params 参数。我们可以直接把查询参数组织为 Python 字典、元组列表或键值映射传递给 params,requests 库内部会自动处理键值转义、编码及连接符组装。
import requests

base_url = "https://httpbin.org/get"

# 组织结构化参数字典
query_params = {
    "keyword": "Python网络爬虫",
    "page": 1,
    "limit": 20,
    "status": "active"
}

# 传入 params 参数
response = requests.get(base_url, params=query_params)

# 查看 requests 最终发起的完整 URL
print("最终组装的完整 URL:")
print(response.url)
运行上述代码后,打印出来的 response.url 会呈现如下结构:
https://httpbin.org/get?keyword=Python%E7%BD%91%E7%BB%9C%E7%88%AC%E8%99%AB&page=1&limit=20&status=active
可以看到,中文字符“Python网络爬虫”已被自动按 UTF-8 规则转义为了标准的十六进制编码,且各个键值对之间使用了 & 进行合法连接。
1. 同一个键对应多个值:如果接口要求形如
tags=python&tags=backend,可将字典的值设置为列表:{"tags": ["python", "backend"]}。
2. 过滤空值:若字典中某个键的值显式设为
None,requests 在拼装 URL 时会自动忽略该键,不会将其拼入查询字符串中。
三、请求头与身份伪装:headers 与 cookies 参数
默认情况下,requests.get() 发送的 HTTP 请求头中,User-Agent 会包含诸如 python-requests/2.x.x 的标识。许多现代 Web 服务器或 API 网关为了防止自动化程序滥用资源,会对默认的 Python 请求头进行拦截,直接返回 403 Forbidden 错误。
为了让请求更接近真实浏览器的交互行为,或者传递服务端校验所必需的元数据,必须使用 headers 参数定制请求头。
1. 常用自定义请求头配置
import requests

url = "https://httpbin.org/headers"

# 构造请求头字典
custom_headers = {
    # 模拟常见现代浏览器的 User-Agent
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36",
    # 声明可接收的响应数据格式
    "Accept": "application/json, text/plain, */*",
    # 声明偏好语言
    "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8",
    # 携带自定义鉴权凭据或 API Token
    "Authorization": "Bearer your_access_token_here",
    # 模拟访问来源页面
    "Referer": "https://example.com/search"
}

response = requests.get(url, headers=custom_headers)
print(response.text)
2. 会话凭据:cookies 参数的使用
HTTP 是无状态协议,许多网站依靠 Cookie 标识用户的登录状态。如果服务端无需复杂的 Session 会话池,仅需在单词 GET 请求中带入特定 Cookie,可通过 cookies 参数传递字典:
import requests

url = "https://httpbin.org/cookies"

# 定义 Cookie 键值对
user_cookies = {
    "session_id": "ab789xyz1234",
    "theme": "dark"
}

response = requests.get(url, cookies=user_cookies)
print(response.json())
四、可靠性与安全防线:timeout 超时控制与重定向处理
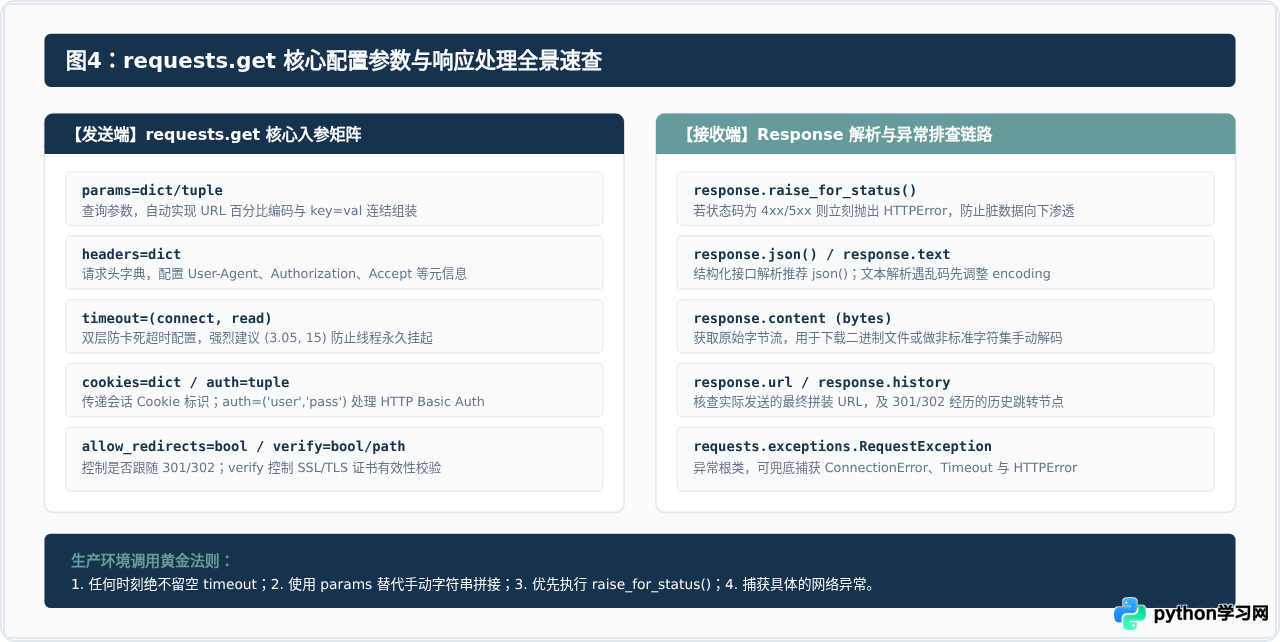
在生产环境和自动化脚本中,网络环境存在天然的不确定性。如果发起请求时不显式配置 timeout,当目标服务器宕机、丢包或网络路由故障时,程序可能会永久挂起(挂死),耗尽系统的连接句柄和执行线程。
1. timeout 超时配置机制(单值 vs 元组)
timeout 参数支持两种传参方式:
- 单浮点数/整数:如
timeout=5.0,表示整个请求生命周期中,无论是建立底层连接还是等待服务端返回数据,单次等待的最大秒数均为 5 秒。 - 元组双值精细控制:形如
timeout=(connect_timeout, read_timeout),例如timeout=(3.05, 15)。connect_timeout(连接超时):客户端与服务器建立底层 TCP 套接字连接(包括 TLS 握手)的最大允许耗时。根据网络协议特性,推荐设置为略大于 3 秒的数值(如 3.05),避开 TCP 握手的默认重传周期。read_timeout(读取超时):连接成功建立后,客户端在两次连续数据包接收之间允许等待的最大间隔时间(并非总下载时间)。
import requests
from requests.exceptions import Timeout, ConnectionError, RequestException

url = "https://httpbin.org/delay/2"

try:
    # 设定连接超时为 3.05 秒,读取数据超时为 5 秒
    response = requests.get(url, timeout=(3.05, 5))
    print("请求成功,状态码:", response.status_code)
except Timeout as err:
    print("触发超时异常:", err)
except ConnectionError as err:
    print("网络连接失败,DNS 或目标不可达:", err)
except RequestException as err:
    print("通用请求异常:", err)
2. HTTP 重定向控制:allow_redirects 与历史追踪
默认情况下,requests.get() 会自动跟随所有 301(永久重定向)、302(临时重定向)或 307/308 跳转。在特定场景下(例如需要抓取登录拦截跳转的目标地址,或验证 URL 的初始重定向链路),可以通过 allow_redirects=False 禁用自动跳转:
import requests

url = "http://github.com"  # 该地址通常会 301 重定向到 https://github.com

# 禁用自动重定向,捕获第一跳结果
response = requests.get(url, allow_redirects=False)

print("原始响应码:", response.status_code)  # 通常为 301
print("目标重定向地址:", response.headers.get("Location"))

# 如果允许重定向(默认行为),可查看中间经历的重定向链条
follow_response = requests.get(url, allow_redirects=True)
print("最终落地状态码:", follow_response.status_code)  # 200
print("重定向历史列表:", [res.status_code for res in follow_response.history])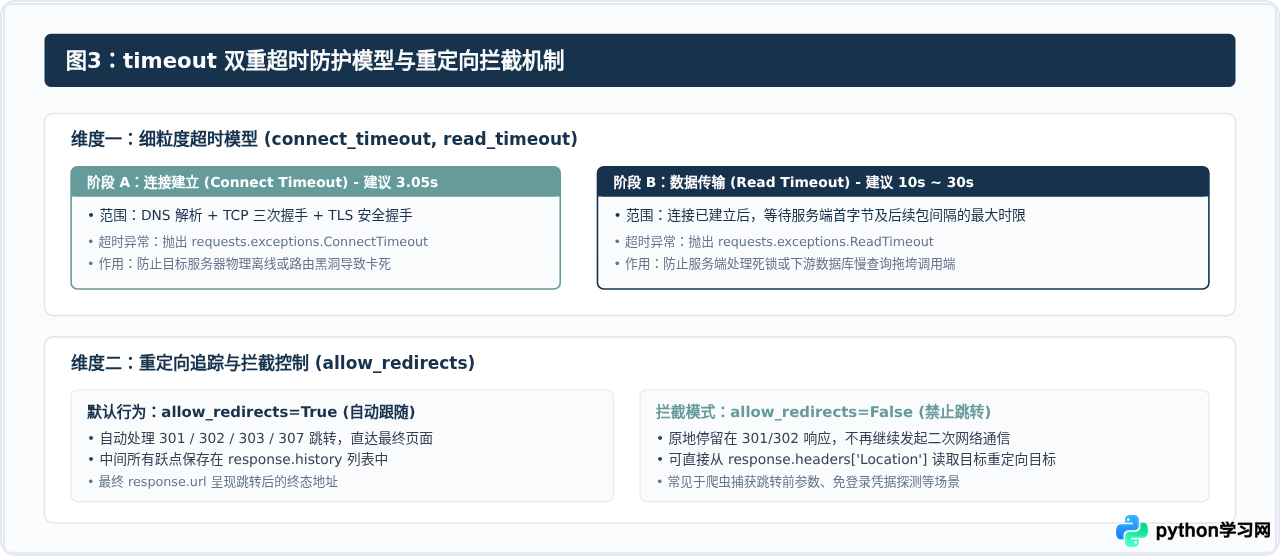
五、响应对象安全读取与异常处理
向服务端发送请求并收到 Response 对象后,需根据业务类型选择正确的属性提取数据,同时对网络状态与数据格式进行防御性校验。
1. 响应内容获取方法对比
| 属性/方法 | 返回类型 | 核心原理与适用场景 |
|---|---|---|
response.text |
str |
自动根据 HTTP 标头或 apparent_encoding 推测字符集并解码为 Unicode 字符串。适用于 HTML、普通文本、XML 等内容提取。
|
response.json() |
dict / list |
内置 JSON 解析器。若响应内容为合法 JSON 串,直接反序列化为 Python 对象;若非 JSON 会抛出 requests.exceptions.JSONDecodeError。
|
response.content |
bytes |
返回原始未解码的二进制字节流。适用于图片、音频、PDF、压缩包下载,或文本编码混乱需要手动指定解码器的场景。 |
response.status_code |
int |
返回 HTTP 状态码(如 200, 404, 500 等)。 |
2. 中文乱码问题的根本成因与修复
当访问某些国内老旧站点时,使用 response.text 可能会出现类似 æ°æ® 的乱码。其根本原因在于:如果 HTTP 响应头未显式声明 charset,根据 HTTP/1.1 标准规范,requests 会默认采用 ISO-8859-1 编码解析文本。
解决中文乱码的标准做法是利用 chardet 分析实际字节特征,重设解码编码:
import requests

url = "http://example.com/gbk_page"
response = requests.get(url, timeout=5)

# 自动推测实际内容使用的真实字符编码(如 GBK 或 UTF-8)
response.encoding = response.apparent_encoding

# 此时再使用 text 读取,中文恢复正常
print(response.text)
3. 状态码强校验:raise_for_status()
很多开发者容易忽略:即使服务端返回 404 Not Found 或 500 Internal Server Error,requests.get() 也不会主动抛出 Python 异常,而是正常返回包含对应状态码的 Response 对象。
如果不做状态检查直接调用 response.json(),代码往往会在下游抛出奇怪的解析错误。通过调用 response.raise_for_status(),可以在遇到 4xx 或 5xx 状态码时立刻抛出 HTTPError,使逻辑流转清晰可控。
六、生产级健壮 GET 请求函数模板
结合前文涉及的各项核心参数与异常防护规则,以下提供一个适合直接在生产脚本中复用的封装函数模板。该函数涵盖了自定义请求头、结构化参数传递、细粒度超时、自动状态检验以及完整的异常捕获:
import logging
from typing import Any, Dict, Optional
import requests
from requests.exceptions import ConnectionError, HTTPError, RequestException, Timeout

# 配置基础日志记录
logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(levelname)s] %(message)s")

def safe_http_get(
    url: str,
    params: Optional[Dict[str, Any]] = None,
    headers: Optional[Dict[str, str]] = None,
    timeout: tuple = (3.05, 10.0),
    max_retries: int = 1
) -> Optional[requests.Response]:
    """
    健壮的 HTTP GET 请求执行函数
    :param url: 目标基础 URL
    :param params: 查询参数字典
    :param headers: 自定义请求头
    :param timeout: 超时元组 (connect_timeout, read_timeout)
    :param max_retries: 失败重试次数
    :return: 成功返回 Response 对象,彻底失败返回 None
    """
    default_headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36",
        "Accept": "application/json, text/plain, */*"
    }

    # 合并传入的自定义请求头
    final_headers = {**default_headers, **(headers or {})}

    for attempt in range(1, max_retries + 1):
        try:
            logging.info(f"发起 GET 请求 (第 {attempt} 次): {url}")

            response = requests.get(
                url=url,
                params=params,
                headers=final_headers,
                timeout=timeout,
                allow_redirects=True
            )

            # 校验 HTTP 状态码是否为 2xx
            response.raise_for_status()

            # 自动纠正文本编码
            if response.encoding == "ISO-8859-1":
                response.encoding = response.apparent_encoding

            return response

        except Timeout as e:
            logging.warning(f"请求超时 (第 {attempt} 次): {e}")
        except ConnectionError as e:
            logging.warning(f"网络连接失败 (第 {attempt} 次): {e}")
        except HTTPError as e:
            logging.error(f"HTTP 服务端状态异常: {e.response.status_code}")
            # 服务端明确返回 4xx/5xx 时,通常不需要盲目重试,可直接跳出
            break
        except RequestException as e:
            logging.error(f"遭遇未知网络异常: {e}")
            break

    logging.error(f"请求最终失败,无法获取有效响应: {url}")
    return None

# ================= 实际调用示例 =================
if __name__ == "__main__":
    api_endpoint = "https://httpbin.org/get"
    search_args = {"type": "article", "id": 1024, "tag": "python"}

    resp = safe_http_get(api_endpoint, params=search_args)
    if resp:
        print("调用成功,返回 JSON 数据:")
        print(resp.json())
七、总结
requests.get() 封装了极度易用的高级 API,但在构建严肃的自动化与工程任务时,不能仅停留在 requests.get(url) 这种最简形式。
通过本文的梳理,我们明确了以下核心准则:使用 params 参数委托库完成 RFC 规范的字符集编码,避免手动拼装带来的语法破损;通过 headers 显式声明 User-Agent 和业务鉴权头以保障接口可通达性;始终配置 timeout=(3.05, 15) 元组防止系统线程因网络中断永久挂死;最后配合 raise_for_status() 与异常捕获体系对响应进行安全消费。遵循这套规范,便能编写出稳定、高效且具备高容错能力的 Python 网络请求代码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









