

Python序列数据类型有哪些:list、tuple、str等7种内置类型
全面解析Python标准库中的7种内置序列数据类型:list、tuple、range、str、bytes、bytearray与memoryview。深入解析内存结构、可变性差异、切片与零拷贝机制及工程选型指南。
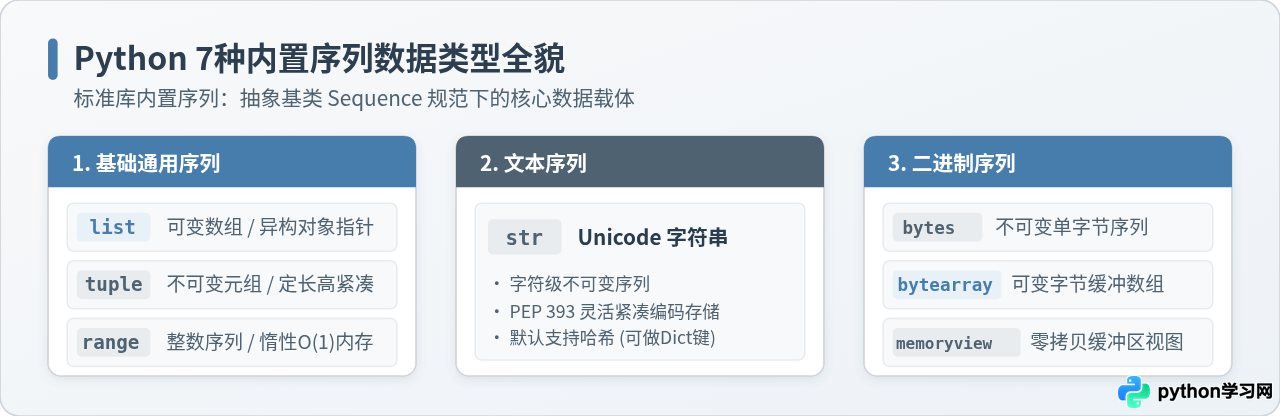
list、tuple、range)、1 种文本序列(str)以及 3 种二进制数据序列(bytes、bytearray、memoryview)。这些类型均原生实现了序列协议抽象,但在可变性、元素类型约束、底层存储机制与内存复制行为上各自有着明确的分工。
一、Python序列协议的核心特征与7种类型分类全景
在 Python 的数据模型(Data Model)中,一个对象之所以被称为“序列”,是因为它遵循了内置的序列操作规范。任何序列对象都具备以下基础操作能力:
- 按索引顺序定位:支持通过从
0开始的正向索引(如s[0])以及从-1开始的反向索引(如s[-1])以 $O(1)$ 时间复杂度快速获取对应位置的元素。 - 分片截取操作:支持形如
s[start:stop:step]的切片语法,能按设定的步长截取连续或间隔子序列。 - 确定长度与成员检查:通过内置函数
len(s)获取包含的元素个数,支持使用item in s执行成员包含性判断。 - 迭代遍历与计数查找:可直接用于
for循环迭代,且自带s.index(x)(查找首个匹配元素索引)和s.count(x)(统计元素出现次数)内置方法。
虽然这 7 种类型共同遵循上述序列协议,但从架构抽象上看,它们在抽象基类 collections.abc.Sequence 的基础上延伸出了可变(Mutable)与不可变(Immutable)两大分支:
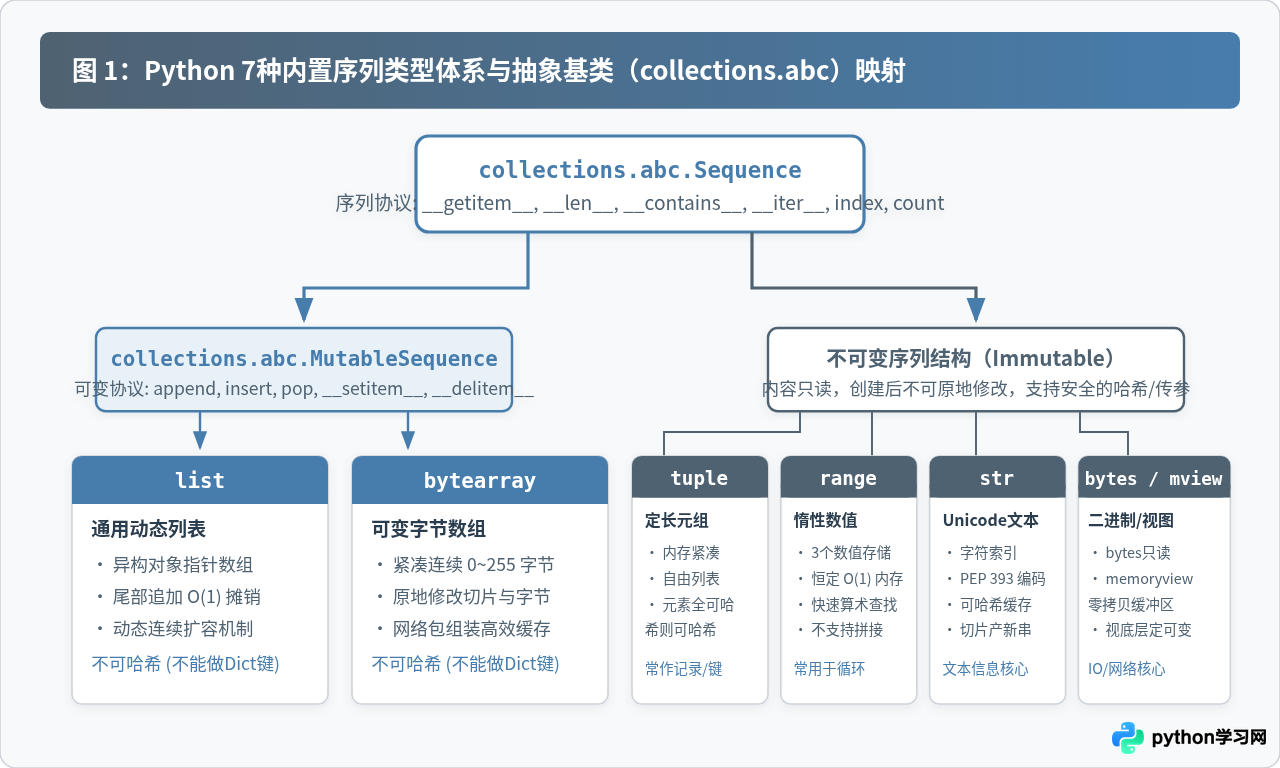
如上图所示,7 种内置序列按承载的数据内容与设计目标可清晰划分为三大阵营:
- 通用基础序列(3种):
list(动态列表)、tuple(只读元组)、range(惰性数值范围)。它们可承载通用对象或纯数值范围。 - 文本字符序列(1种):
str(Unicode 文本字符串)。专门承载人类可读的文字字符,按码点单位进行管理。 - 二进制缓冲序列(3种):
bytes(只读字节串)、bytearray(可变字节数组)、memoryview(零拷贝缓冲区视图)。专职处理 8 位原始字节数据与底层 IO。
二、三大基础通用序列:list、tuple、range 的底层机制
在通用数据组织场景中,list、tuple 和 range 构成了 Python 编程中最核心的顺序容器组合。尽管它们都能以索引遍历数据,但底层数据排布与内存生命周期完全不同。
1. list:动态可变对象指针数组
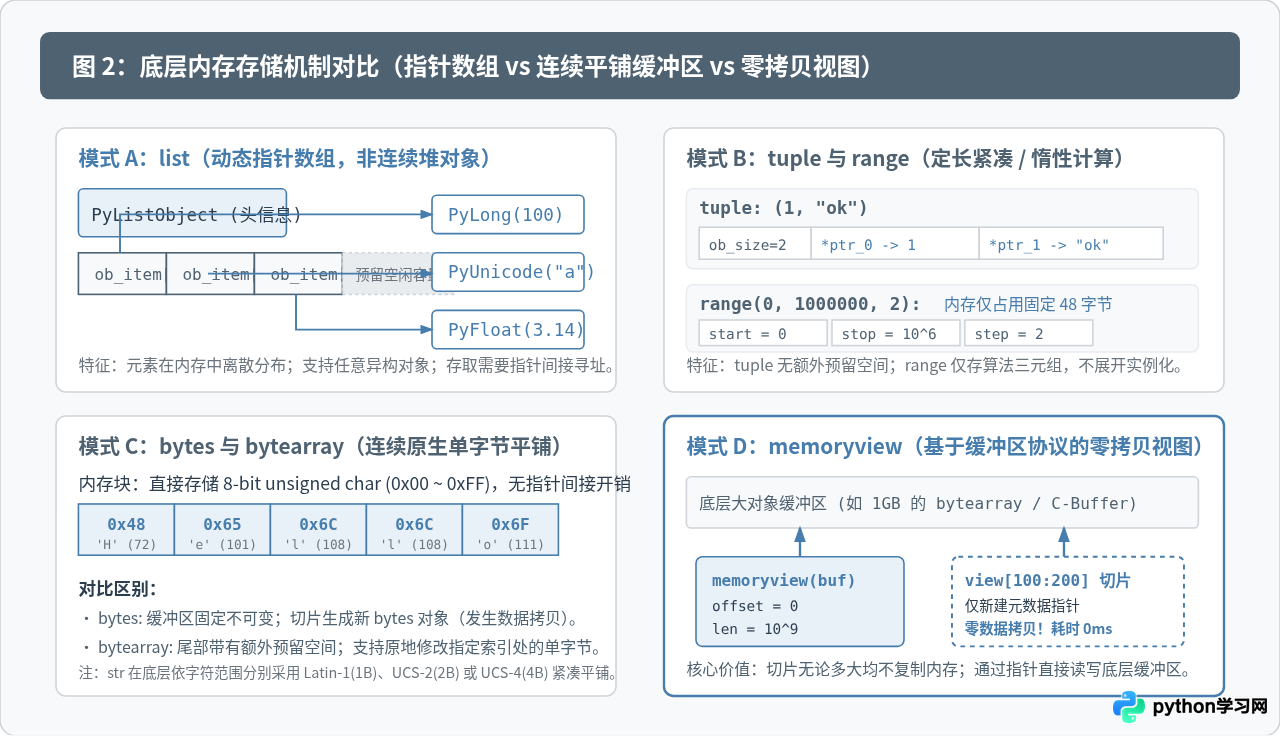
list 是 Python 内部使用频率最高的数据结构。其本质是一个动态数组,底层由一块连续的内存空间构成,该内存空间存放的并非元素本身,而是指向堆内存中各 Python 对象的指针(即 C 语言层面的 PyObject*)。
- 异构支持:由于存储的是引用指针,列表同一个实例内可以同时混合存放整数、字符串、自定义对象甚至另一个列表。
- 扩容机制:为了保证
append()操作达到摊销常数时间复杂度 $O(1)$,Python 在列表空间耗尽时不会只增加 1 个槽位,而是按照特定的超额分配比例(Over-allocation)一次性申请额外的空闲指针位置。
# 示例代码:list 的动态修改与指针引用机制
fruits = ["apple", "banana"]
fruits.append("cherry")      # 尾部快速追加,摊销 O(1)
fruits[1] = "blueberry"      # 原地更新指定索引指针
print(fruits)2. tuple:定长紧凑的不可变元组
tuple 在表面上与 list 类似,但它在创建后其长度与指针内容便彻底固化,不可进行追加、删除或替换。这种设计带来了显著的工程优势:
- 内存紧凑无冗余:元组无需像列表那样预留扩容冗余槽位,内存开销比相同长度的列表更加轻量。
- 自由列表缓存优化:CPython 解释器为长度不超过 20 的空元组与小型元组维护了一个称为 Free List 的复用池。当这些元组被废弃回收时,其内存块并不会立即退还给操作系统,而是直接留给后续新建的同尺寸元组,极大减少了内存分配调用。
- 哈希可变性保证:只要元组内部包含的所有元素本身都是可哈希(Hashable)的,该元组整体即可计算哈希值,能安全地充当字典的复合键(Dictionary Key)或存入
set集合。
# 示例代码:tuple 的定长只读性与作为字典复合键
point_2d = (10, 25)
# point_2d[0] = 20  # 若执行将抛出 TypeError: 'tuple' object does not support item assignment

coordinate_map = {point_2d: "Target_A"}
print(coordinate_map[(10, 25)])3. range:恒定 O(1) 内存的惰性算术序列
许多初学者误以为 range 返回的是预先生成好的完整数字列表,但实际上 range 是一个纯粹的惰性求值(Lazy Evaluation)序列。一个 range 实例内部仅存储三个整数参数:start、stop 和 step。
- 恒定内存占用:无论
range(10)还是range(10**12),其在 64 位 CPython 解释器中均固定只占用 48 字节内存,绝不会因为序列范围扩大而导致内存溢出。 - 高效数学计算:当对
range对象执行索引查找(如r[500])或成员检查(如999 in r)时,解释器并非遍历比较,而是直接利用算术公式在 $O(1)$ 时间内计算出结果。
import sys

# 无论元素跨度多大,range 的内存消耗恒定不变
small_r = range(0, 10)
huge_r = range(0, 100000000)

print("small_r 内存字节数:", sys.getsizeof(small_r))
print("huge_r  内存字节数:", sys.getsizeof(huge_r))
print("直接利用公式命中判断:", 50000000 in huge_r)huge_r 内存字节数: 48
直接利用公式命中判断: True
三、文本与二进制序列:str、bytes、bytearray、memoryview 的字节模型
在涉及网络传输、文件存储、字符编码转换以及图像/音视频原始数据处理时,Python 区分了字符级文本序列与物理级二进制序列。
4. str:Unicode 文本字符串
str 是不可变的 Unicode 字符序列。在 Python 3 中,字符串脱离了具体物理编码(如 UTF-8/GBK)的直接绑定,而是在逻辑层面统一表现为由抽象 Unicode 码点(Code Points)构成的序列。
根据 PEP 393(灵活字符串表示,Flexible String Representation),CPython 为了兼顾跨国字符支持与内存节约,会根据字符串内部所有字符的最大码点,自动在底层采用四种紧凑存储结构之一:仅含 ASCII 字符时每个字符占用 1 字节;包含扩展拉丁字符时占用 1 字节(Latin-1);包含中文等平面的字符时采用 UCS-2(每字符 2 字节);出现 Emoji 表情或罕见汉字时采用 UCS-4(每字符 4 字节)。因此 str[i] 可以始终保持 $O(1)$ 复杂度的正向与反向随机字符访问。
5. bytes:不可变原生字节序列
bytes 是只读的单字节序列,序列中的每一个元素都是取值范围在 0 <= x <= 255 的非负整数。bytes 是磁盘文件读写、套接字网络数据包收发的最基础原生格式。
b"abc",但当对 bytes 对象进行单索引索引时,获取到的返回值是对应的整数 ASCII 码值,而非单个字符。例如 b"abc"[0] 的结果是整数 97,若要获取单字节切片则需写为 b"abc"[0:1](返回 b'a')。
6. bytearray:可变的原生字节数组
bytearray 是 bytes 的可变对等体。与 list 类似,它支持 append()、extend() 以及切片原地赋值;但与 list 不同的是,它的底层直接是平铺的 C 连续字节缓冲区(unsigned char[]),绝不存在多余的 Python 对象指针寻址损耗。
在网络通信协议组装、自定义加密解密算法或流式数据清洗场景中,若需要持续拼接或修改字节报文,使用 bytearray 原地修改能够彻底避免频繁新建不可变 bytes 对象产生的 GC 压力。
# 示例代码:bytearray 的原地字节修改
buffer = bytearray(b"Hello World")
buffer[0:5] = b"Quick"          # 原地替换前5个字节
buffer.append(33)               # 追加 ASCII 33 (!)
print("修改后缓冲区内容:", buffer.decode("utf-8"))7. memoryview:零拷贝缓冲区协议包装器
当处理数百兆甚至数千兆的巨型二进制数据(如加载大型科学数据集、读取高清视频帧或高吞吐 Socket 传输)时,普通切片操作 data[start:stop] 会在内存中完整复制一份对应尺寸的新对象,瞬间造成内存翻倍与 CPU 拷贝瓶颈。
memoryview 正是为此而生的内置序列类型。它基于 Python 的内部缓冲区协议(Buffer Protocol),允许你在不进行任何实际内存数据复制的前提下,直接对外暴露一个对象的底层内存切片。通过 memoryview 切出的新子序列仅仅是一个轻量的元数据结构(仅包含指向原缓冲区对应偏移量的指针、数据类型规格与长度信息),真正实现了毫秒级零拷贝(Zero-Copy)。
# 示例代码:memoryview 的零拷贝与原地写入
raw_data = bytearray(b"0123456789ABCDEF")
view = memoryview(raw_data)

# 切片截取:没有任何数据复制发生,仅仅是视窗偏移
sub_view = view[4:8]
print("子视图内容:", bytes(sub_view))

# 通过可写视图直接影响原始底层 bytearray
sub_view[0:2] = b"ZZ"
print("修改后底层原始数据:", raw_data)修改后底层原始数据: bytearray(b'0123ZZ6789ABCDEF')
四、序列类型工程选型决策流程
面对 7 种不同的内置序列类型,开发人员在实际编写业务逻辑时应遵循清晰的排他推导路径,避免因选型不当引入性能衰退或隐式数据篡改风险。
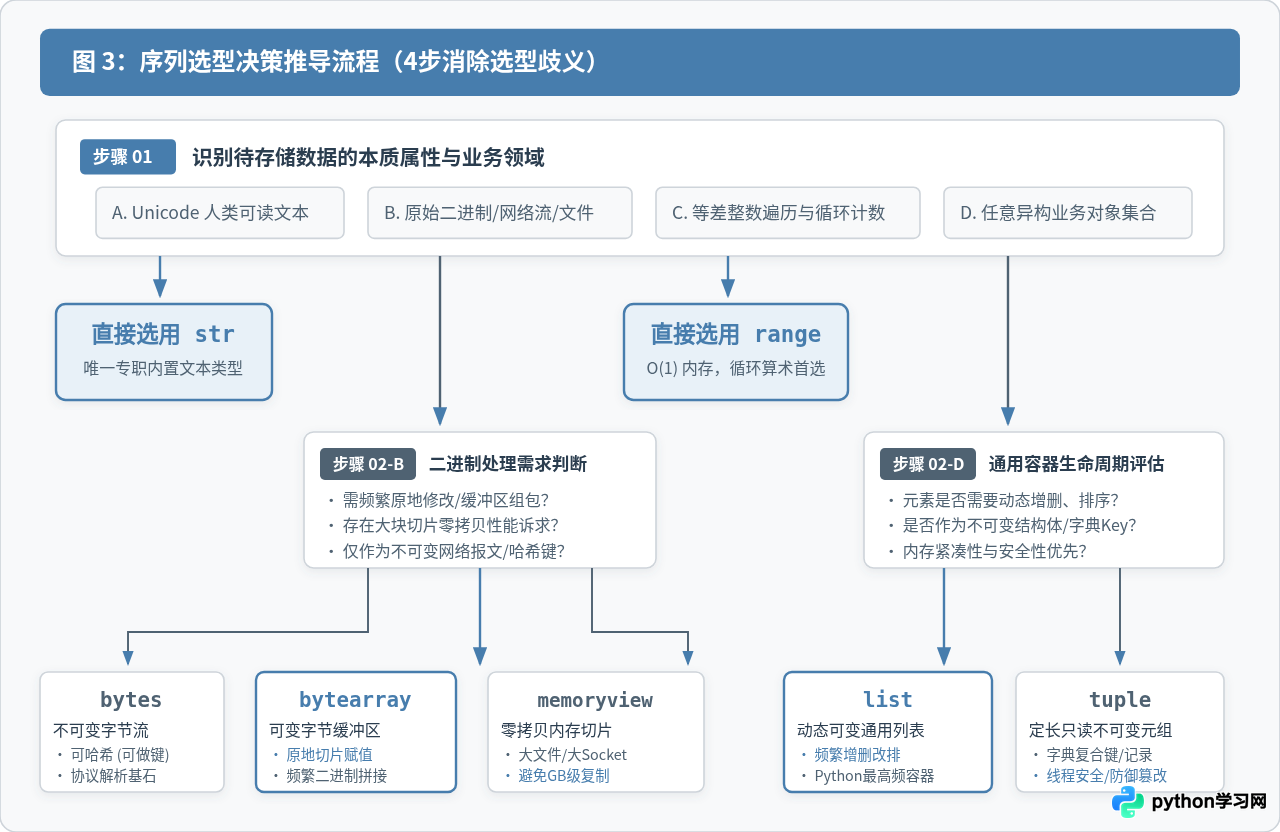
在工程实践中,可以依照以下 4 个连续步骤进行排查与选定:
- 步骤一:数据语义判定。
如果承载的是人类语言、配置文件、模板或通用字符串,直接选用
str;如果是纯数字的遍历计数或步长生成,毫不犹豫使用range。 - 步骤二:通用业务集合的可变性决策。
当元素是复杂对象时,如果业务流程需要动态调用
append、sort、pop增删过滤,选用list;若数据产生后仅作只读传递、解包或需要作为字典 Key、集合元素,务必选用tuple以保证防篡改安全性与内存整洁。 - 步骤三:二进制协议的改动频率考量。
对于固定报文解析、网络常量或协议头签名,选用只读且可哈希的
bytes;若在循环中频繁拼装拼接报文包,改用bytearray避免反复分配新内存。 - 步骤四:极端吞吐与零拷贝考量。
如果数据量达到数兆以上且需要截取切片交付给系统调用(如
socket.send()或file.write()),统一将目标封装为memoryview切片,杜绝内存复制。
五、7大内置序列核心属性对比与常见避坑指南
为了给代码审查与架构设计提供快速参考依据,下表与对比矩阵横向梳理了这 7 种内置类型在各项核心技术指标上的差异:
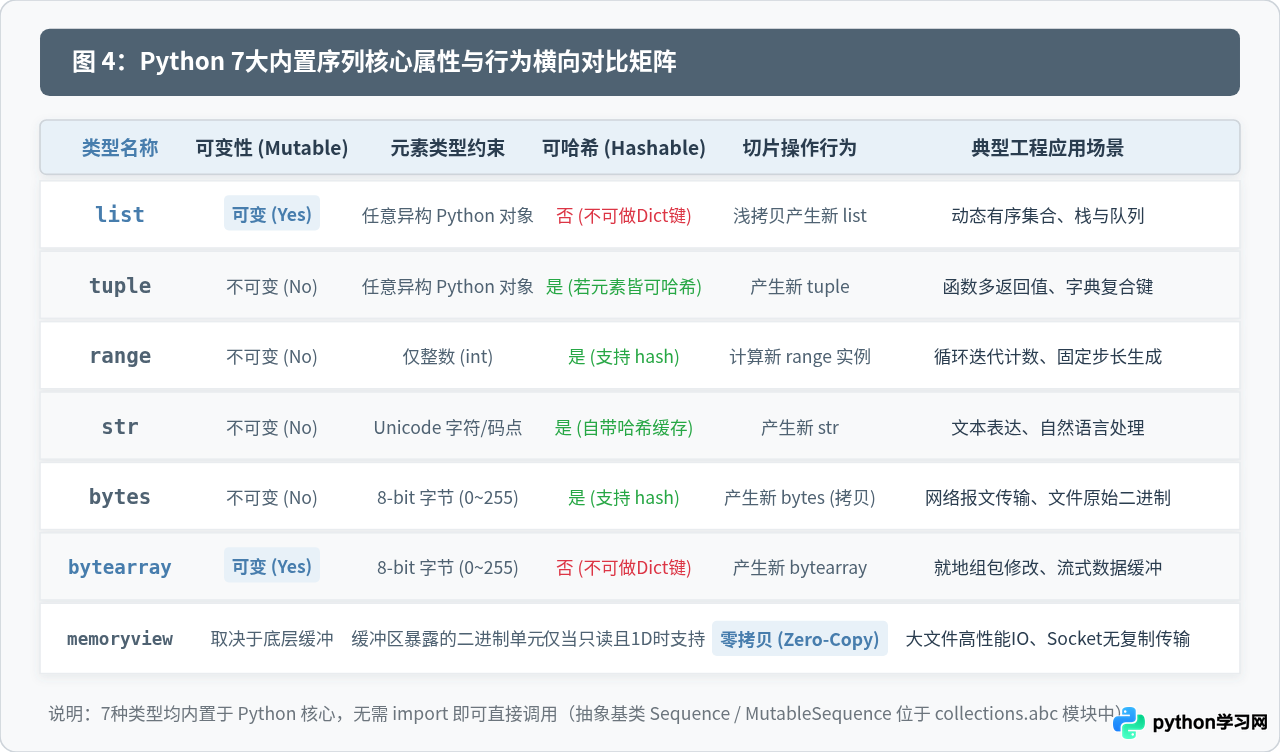
常见避坑要点:
新手常写出
grid = [[0] * 3] * 3 来初始化二维矩阵。然而乘法操作符 * 复制的仅仅是指向内部列表的指针引用!修改 grid[0][0] = 1 会导致三行同时被更改。正确做法是使用列表推导式独立创建:grid = [[0] * 3 for _ in range(3)]。
由于
str 和 bytes 是严格不可变的,在循环内部使用 s += chunk 会在每次循环时都在内存中申请一块新尺寸的连续区域并将旧数据完整拷贝过去,导致算法复杂度退化为 $O(N^2)$。处理大量片段时,应将其追加到列表中最后调用 "".join(chunks) 或使用 bytearray 原地扩容。
range 尽管完整实现了 Sequence 接口,但它不支持拼接操作符 +(如 range(3) + range(5) 会报错)也不支持重复操作符 *。这是因为拼接两个不同等差数列的结果通常已不再是一个连续等差序列,无法用单一 (start, stop, step) 参数表达。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









